
- 전체
- Python 일반
- Python 수학
- Python 그래픽
- Python 자료구조
- Python 인공지능
- Python 인터넷
- Python SAGE
- wxPython
- TkInter
- iPython
- wxPython
- pyQT
- Jython
- django
- flask
- blender python scripting
- python for minecraft
- Python 데이터 분석
- Python RPA
- cython
- PyCharm
- pySide
- kivy (python)
Python 자료구조 [python] 크롤링한 데이터 DB에 저장하기
2021.01.29 12:56
[python] 크롤링한 데이터 DB에 저장하기
크롤링한 데이터를 데이터 베이스에 저장하는 이유
먼저 크롤링한 데이터를 DB에 저장하는 이유는 데이터 분석에 사용하거나 웹 API를 만들어서 애플리케이션에서 활용하기 위해서 사용합니다. 또한 처리속도면에서도 데이터베이스를 사용하는것이 좋고 AWS나 AZURE과 같은 다양한 클라우드 내에 있는 데이터베이스를 활용하면 더욱더 좋게 사용할 수 있습니다.
MySQL사용하기
먼저 MySQL이 설치 되어있다고 가정하고 진행하겠습니다. MySQL은 아래 링크에서 다운로드 받을 수 있습니다.
그 후 다음과 같은 명령어로 mysql을 실행시키겠습니다.
mysql.server start
다음 mysql -u root -p 명령어를 통해 접속한 후 크롤링 데이터를 저장할 데이터베이스를 만들겠습니다.
CREATE DATABASE crawl_data DEFAULT CHARACTER SET utf8;
그 후 이 데이터베이스를 사용할 유저를 하나 생성하겠습니다.
CREATE USER crawl_usr IDENTIFIED BY 'Test001';
아이디는 crawl_user이고 비밀번호는 Test001이라는 뜻입니다.
다음 모든 권한을 crawl_user에게 주겠습니다. 명령어는 다음과 같습니다.
GRANT ALL ON crawl_data.* TO crawl_usr;
이제 권한 부여까지 끝났으면 exit를 통해 sql을 종료하겠습니다.
Python에 Mysql접속하기
먼저 python으로 Mysql에 연결하기위해 mysqlclient를 설치하겠습니다.
pip install mysqlclient
이제 파이썬으로 mysql에 접속하는 코드를 작성하겠습니다.
import MySQLdb

conn = MySQLdb.connect(
    user="crawl_usr",
    passwd="Test001",
    host="localhost",
    db="crawl_data"
    # charset="utf-8"
)
print(type(conn))
# <class 'MySQLdb.connections.Connection'>
cursor = conn.cursor()
print(type(cursor))
# <class 'MySQLdb.cursors.Cursor'>
cursor.execute("CREATE TABLE books (title text, url text)")
conn.commit()
conn 메서드에서 cursor를 통해 cursor를 생성할 수 있습니다.
excute 명령어를 통해 books라는 테이블을 만듭니다. 이제 테이블이 잘 생성 되었는지 터미널을 통해 확인하겠습니다.
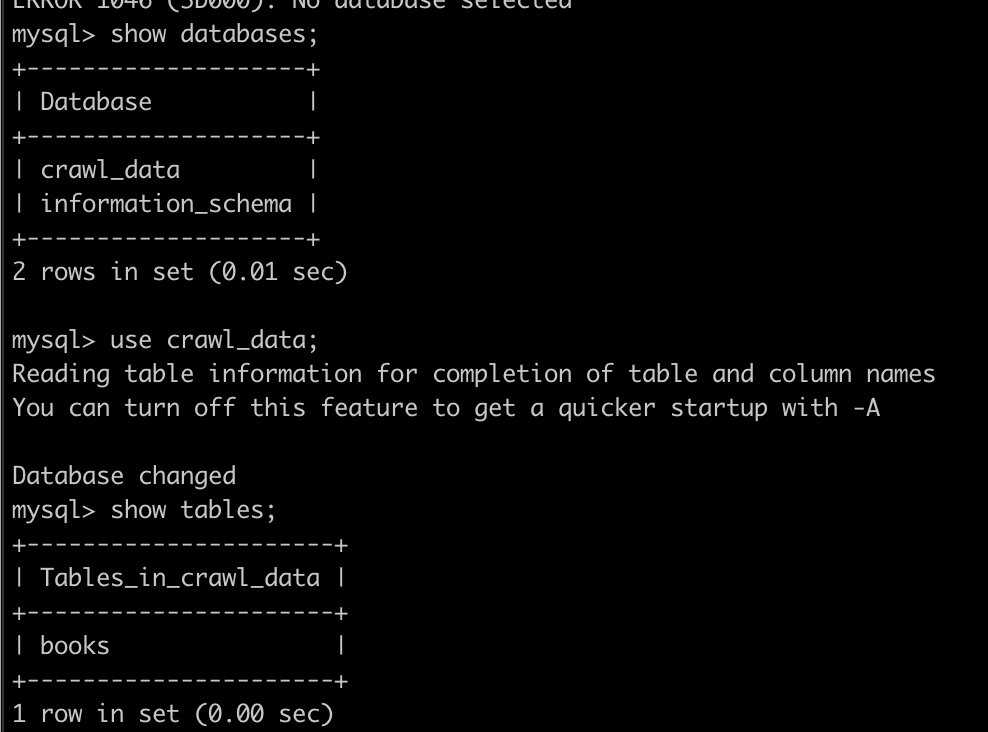
먼저 테이블이 잘 생성 된 것을 확인할 수 있습니다. 이제 컬럼도 잘 생성되었는지 확인하겠습니다.
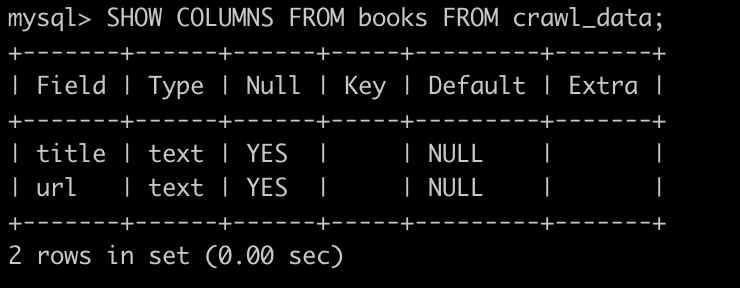


마찬가지로 테이블에 있는 컬럼들도 잘 만들어진것을 확인할 수 있습니다.
이제 execute를 이용해서 Insert구문을 통해 테이블에 값을 넣어보겠습니다.
import MySQLdb

conn = MySQLdb.connect(
    user="crawl_usr",
    passwd="Test001",
    host="localhost",
    db="crawl_data"
    # charset="utf-8"
)
cursor = conn.cursor()
bookname = "처음 시작하는 파이썬"
url_name = "www.wikibook.co.kr"
cursor.execute(f"INSERT INTO books VALUES(\"{bookname}\",\"{url_name}\")")
conn.commit()
그 후 파이썬 mysql에서 select * from books; 명령어를 통해 입력이 잘 되었는지 확인하겠습니다.
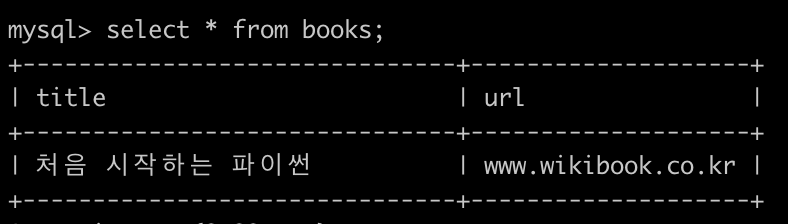
잘 들어가 있는것을 확인할 수 있습니다.
이제 실행할때 마다 다른 값이 나오지 않게 테이블을 제거하고 다시 생성하는 코드를 작성하겠습니다.
import MySQLdb

conn = MySQLdb.connect(
    user="crawl_usr",
    passwd="Test001",
    host="localhost",
    db="crawl_data"
    # charset="utf-8"
)
# 커서 생성하기
cursor = conn.cursor()

# 실행할 때마다 다른값이 나오지 않게 테이블을 제거해두기
cursor.excute("DROP TABLE IF EXISTS books")

# 테이블 생성하기
cursor.execute("CREATE TABLE books (title text, url text)")

# 데이터 저장하기
bookname = "처음 시작하는 파이썬"
url_name = "www.wikibook.co.kr"
cursor.execute(f"INSERT INTO books VALUES(\"{bookname}\",\"{url_name}\")")
# 커밋하기
conn.commit()
# 연결종료하기
conn.close()
크롤링한 값 DB에 저장하기
먼저 저는 멜론 사이트에 들어가서 멜론 차트 탑 100을 크롤링한 후 데이터 베이스에 넣어주는 코드를 작성했습니다. 먼저 코드는 아래와 같습니다.
import MySQLdb
import requests
from bs4 import BeautifulSoup

if __name__ == "__main__":
    RANK = 100  # 멜론 차트 순위가 1 ~ 100위까지 있음

    header = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 6.3; Trident/7.0; rv:11.0) like Gecko'}
    req = requests.get('https://www.melon.com/chart/week/index.htm',
                       headers=header)  # 주간 차트를 크롤링 할 것임
    html = req.text
    parse = BeautifulSoup(html, 'html.parser')

    titles = parse.find_all("div", {"class": "ellipsis rank01"})
    singers = parse.find_all("div", {"class": "ellipsis rank02"})

    title = []
    singer = []

    for t in titles:
        title.append(t.find('a').text)

    for s in singers:
        singer.append(s.find('span', {"class": "checkEllipsis"}).text)
    items = [item for item in zip(title, singer)]

conn = MySQLdb.connect(
    user="crawl_usr",
    passwd="Test001",
    host="localhost",
    db="crawl_data"
    # charset="utf-8"
)
# 커서 생성
cursor = conn.cursor()

# 실행할 때마다 다른값이 나오지 않게 테이블을 제거해두기
cursor.execute("DROP TABLE IF EXISTS melon")

# 테이블 생성하기
cursor.execute("CREATE TABLE melon (`rank` int, title text, url text)")
i = 1
# 데이터 저장하기
for item in items:
    cursor.execute(
        f"INSERT INTO melon VALUES({i},\"{item[0]}\",\"{item[1]}\")")
    i += 1

# 커밋하기
conn.commit()
# 연결종료하기
conn.close()
그 후 데이터 베이스에 접속하면 테이블이 잘 만들어 진 것을 확인할 수 있습니다.
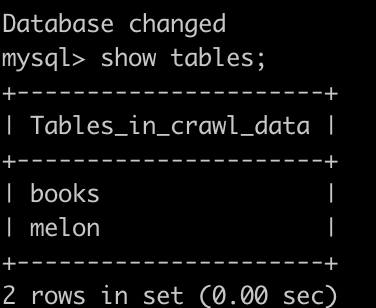
또한 select * from melon을 이용해서 안에 값들이 잘 들어갔는지 확인하겠습니다.
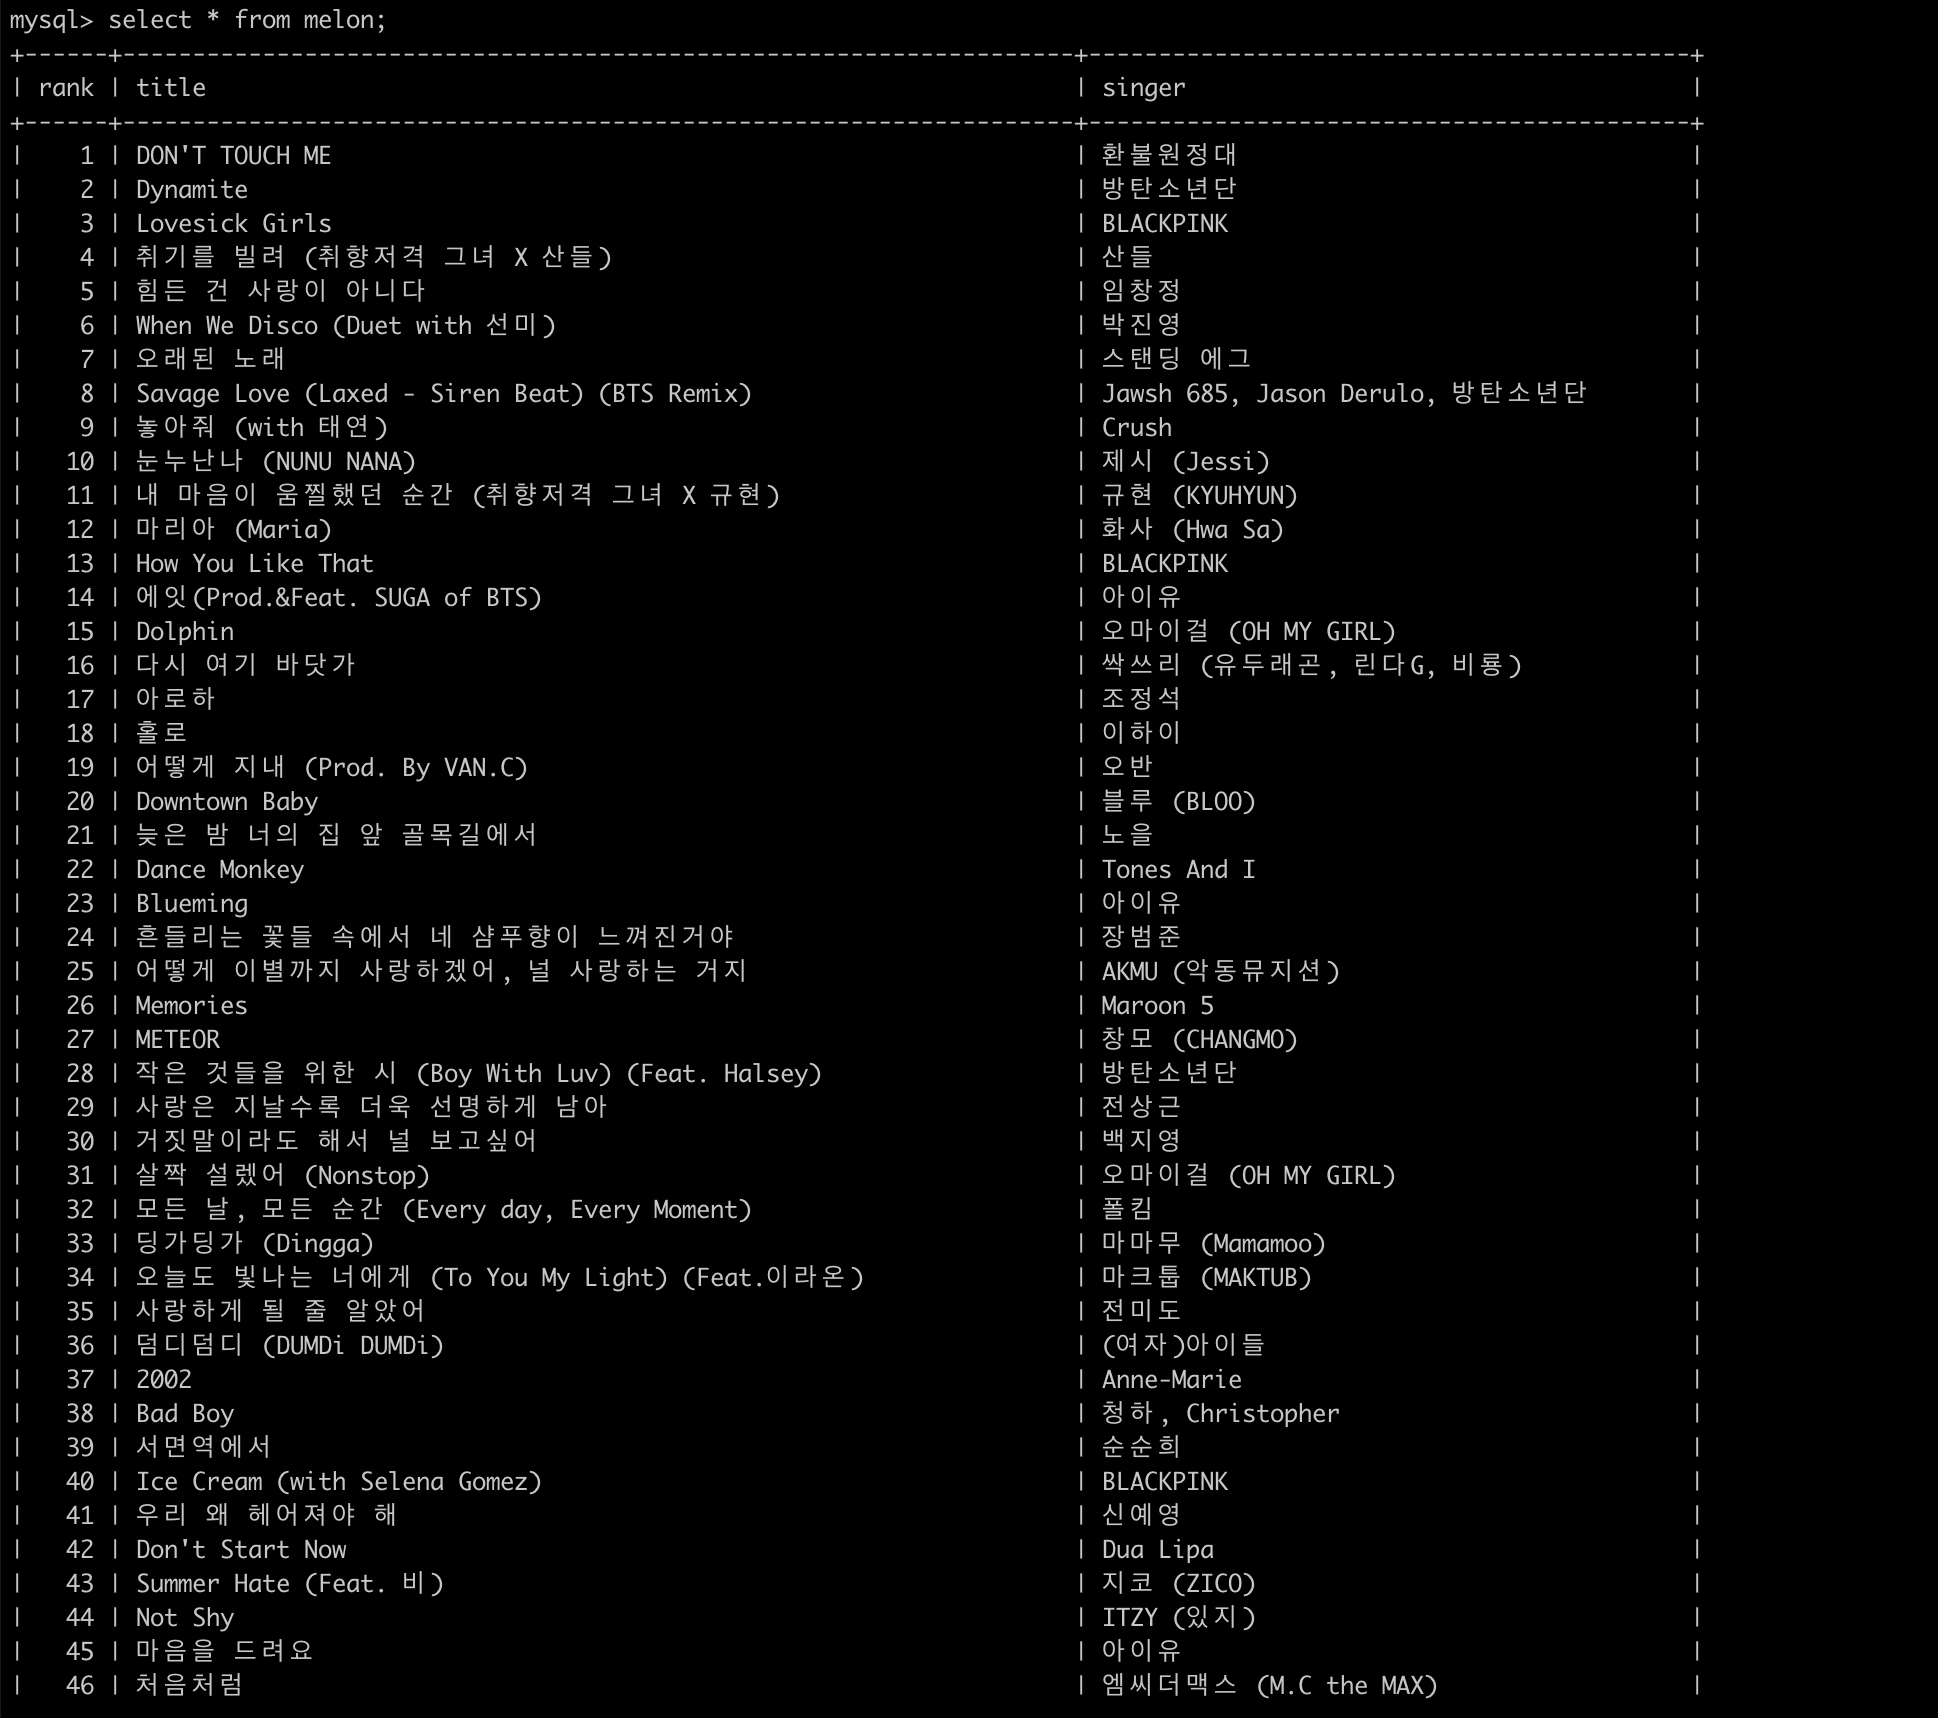
다음과 같이 값이 잘 들어간 것을 확인할 수 있습니다.
이 내용은 아래의 책을 참고 하여서 작성하였습니다.
링크 : wikibook.co.kr/python-crawler/
[출처] https://hyun-am-coding.tistory.com/entry/%ED%81%AC%EB%A1%A4%EB%A7%81%ED%95%9C-%EB%8D%B0%EC%9D%B4%ED%84%B0-DB%EC%97%90-%EC%A0%80%EC%9E%A5%ED%95%98%EA%B8%B0
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
