
- 전체
- Python 일반
- Python 수학
- Python 그래픽
- Python 자료구조
- Python 인공지능
- Python 인터넷
- Python SAGE
- wxPython
- TkInter
- iPython
- wxPython
- pyQT
- Jython
- django
- flask
- blender python scripting
- python for minecraft
- Python 데이터 분석
- Python RPA
- cython
- PyCharm
- pySide
- kivy (python)
Python 인터넷 [Scrapy] 웹사이트 크롤링해서 DB 저장 하기(분양정보수집사례)
2016.11.29 21:39
[Scrapy] 웹사이트 크롤링해서 DB 저장 하기(분양정보수집사례)
※ 주의 : 불법적인 크롤링에 대한 책임은 전적으로 본인에게 있습니다.
해당 포스팅 공유에 문제가 있다면 연락 부탁드립니다.
지난글([Scrapy] 웹사이트 크롤링해서 파일 저장 하기(분양정보수집사례))에서 크롤링 결과를
파일로 저장하는 방법을 소개해 드렸습니다.
파일로 남길 경우 I/F 등 송수신에는 유리 할 수 있으나, 데이터 분석 혹은 주기적 크롤링이
필요할 경우에는 DB에 저장해서 관리하는 것이 데이터를 다루기에 훨씬 수월합니다.
그래서 이번에는 크롤링 결과를 DB에 저장하는 방법을 소개해 드릴 예정입니다.
작업에 들어가기 전에 DB가 설치되어 있어야 하는데요. 해당 포스트에서는
비상업적/개인적 사용용도로 사용할 수 있는 MYSQL을 이용하도록 하겠습니다.
설치 방법은 지난글([DB] 윈도우7에 mysql 설치하기)을 참조 부탁 드립니다.
그럼 시작해 보겠습니다.
[작업 과정 요약]
0.DB설치 : MYSQL 설치
1.크롤링 목적 및 대상 확인 : 필요한 정보와 정보를 보유하고 있는 웹사이트 확인
2.Scrapy 프로젝트 생성
3.Item 파일 작성 : 수집할 데이터 구조 정의
4.Spider 파일 작성 : 데이터 수집을 위한 수행 코드를 정의
4-1.DB Table 생성 : 클롤링 데이터를 저장할 Table 생성
5.Pipelines 파일 작성 : 수집된 데이터 처리 방식 정의(파일저장/DB저장/이메일발송 등)
6.Settings 파일 작성 : 프로젝트 모듈간 연결 및 기본 설정 정의
7.프로젝트 실행 : 작성된 소스코드 컴파일 및 실행
8.추출결과 확인 : 프로젝트 최상위 폴더 내 신규 생성된 데이터 파일 확인
기본 과정은 지난글([Scrapy] 웹사이트 크롤링해서 파일 저장 하기(분양정보수집사례))과 동일합니다.
차이점은 Scrapy 프로젝트명을 "APT2U"에서 "APT2U_DB"로 바꾼것과 Pipelines 파일이
다른것 정도입니다.


다만, DB를 사용하는 것인 만큼 크롤링 결과를 저장할 Table을 생성해야 합니다.
이번 예시에서는 그림와 같은 구조로 만들었구요. Table 생성 스크립트도 올려드릴께요.
▲ "apt" Table 구조

▲ "apt" Table 생성 스크립트
|
1
2
3
4
5
6
7
|
CREATE TABLE `apt` ( `aptname` varchar(200) DEFAULT NULL, `link` varchar(500) DEFAULT NULL, `company` varchar(100) DEFAULT NULL, `receiptdate` varchar(500) DEFAULT NULL, `result_date` varchar(45) DEFAULT NULL) ENGINE=InnoDB DEFAULT CHARSET=utf8; |
Pipelines 파일 내용은 하기와 같이 변경되었구요.
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
|
# -*- coding: utf-8 -*-from __future__ import unicode_literals# Define your item pipelines here## Don't forget to add your pipeline to the ITEM_PIPELINES settingfrom twisted.enterprise import adbapiimport datetimeimport loggingimport MySQLdb.cursorsfrom scrapy.exceptions import DropItemfrom APT2U_DB.items import APT2U_DBItemclass APT2U_DBPipeline(object): def __init__(self): try: self.conn = MySQLdb.connect(user='root', passwd='비밀번호', db='apt2u', host='localhost', charset="utf8", use_unicode=True) #print("1") self.cursor = self.conn.cursor() #print("2") except MySQLdb.Error, e: print "Error %d: %s" % (e.args[0], e.args[1]) sys.exit(1) #log data to json file def process_item(self, item, spider): # create record if doesn't exist. self.cursor.execute("select * from apt2u.apt where aptname = %s and link = %s and company = %s and receiptdate = %s and result_date = %s", (item['aptname'][0].encode('utf-8'), "http://www.apt2you.com/houseSaleDetailInfo.do?manageNo="+item['link'][0].encode('utf-8'), item['company'][0].encode('utf-8'), item['receiptdate'][0].encode('utf-8'), item['result_date'][0].encode('utf-8'))) result = self.cursor.fetchone() # print "select * from apt2u.apt where aptname = '%s' and link = 'http://www.apt2you.com/houseSaleDetailInfo.do?manageNo=%s' and company = '%s' and receiptdate = '%s' and result_date = '%s'" % (item['aptname'][0].encode('utf-8'), item['link'][0].encode('utf-8'), item['company'][0].encode('utf-8'), item['receiptdate'][0].encode('utf-8'), item['result_date'][0].encode('utf-8')) if result: print("data already exist") else: try: self.cursor.execute("insert into apt2u.apt(aptname, link, company, receiptdate, result_date) values (%s, %s, %s, %s, %s)", (item['aptname'][0].encode('utf-8'), "http://www.apt2you.com/houseSaleDetailInfo.do?manageNo="+item['link'][0].encode('utf-8'), item['company'][0].encode('utf-8'), item['receiptdate'][0].encode('utf-8'), item['result_date'][0].encode('utf-8'))) self.conn.commit() except MySQLdb.Error, e: print "Error %d: %s" % (e.args[0], e.args[1]) return item |
작성 후 프로젝트를 하기와 같이 실행시켜 줍니다.

"에러" 등급 이상만 출력되게 만들어서, 정상 실행될 경우 그림과 같이 실행되며,
잘 실행될 경우 DB에 아래처럼 데이터가 들어갑니다.
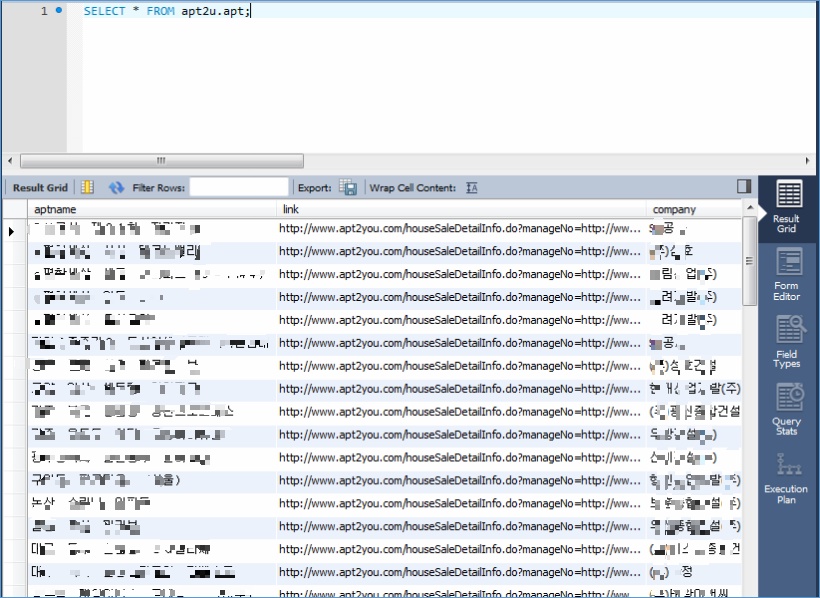
크롤링 결과 자료를 게시하는 것은 저작권 등 문제가 있을 수 있으므로 모자이크 처리하였습니다.
DB 저장 방식도 그리 복잡하지는 않지만, 한글처리등에 조금 애를 먹기는 했네요.
다음번 포스팅에서는 코드라인별로 어떤 의미가 있는지 살펴보도록 하겠습니다.
※ 전체 코드는 아래 첨부파일을 참조하시기 바랍니다.
APT2U_DB.zip
[출처] http://uslifelog.tistory.com/54
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
