[python][자료구조] 오픈 소스 Python PDF 파서 라이브러리

오픈 소스 Python PDF 파서 라이브러리

이 무료 오픈 소스 Python 라이브러리를 사용해 PDF 문서의 텍스트, 이미지, 표 및 기타 콘텐츠를 구문 분석하고 읽고 추출해 보세요.

PyMuPDF란 무엇입니까?

Fitz라고도 알려진 PyMuPDF는 PDF 파일 작업을 위한 포괄적인 도구 세트를 제공하는 오픈 소스 Python 라이브러리입니다. PyMuPDF를 사용하면 사용자는 PDF 열기, 텍스트, 이미지 및 표 추출, 회전 및 자르기와 같은 페이지 속성 조작, 새 PDF 문서 생성, PDF 페이지를 이미지로 변환과 같은 작업을 효율적으로 수행할 수 있습니다.

PyMuPDF는 아래 나열된 여러 기능을 지원합니다:

  • PDF 문서 읽기: PyMuPDF는 PDF 문서를 열고 읽을 수 있으므로 그 안에 있는 텍스트, 이미지 및 기타 콘텐츠에 액세스할 수 있습니다.
  • 텍스트 추출: 텍스트 내용, 글꼴, 레이아웃 정보를 포함하여 PDF 문서에서 텍스트를 추출할 수 있습니다.
  • 이미지 추출: PDF 문서에서 JPEG, PNG 등 다양한 형식의 이미지를 추출할 수 있습니다.
  • 표 추출: PDF 문서에서 표를 추출할 수도 있습니다.

이 검토에서는 라이브러리의 추출 및 구문 분석 기능에 중점을 둘 것입니다. 분할, 병합 및 페이지 관리 기능에 대한 심층적인 평가를 보려면 여기를 클릭하세요.

GitHub

GitHub 통계

이름: PyMuPDF
언어: Python
별: 4.6K
포크: 456
특허: GNU Affero General Public License v3.0
저장소가 마지막으로 업데이트된 시간: 2024-07-15

PyMuPDF 시작하기

PyMuPDF를 설치하고 사용하려면 Python 버전 3.8.0 이상이 필요합니다. 따라서 먼저 Python을 설치한 다음 아래 명령을 사용하여 pip 및 가상 환경.

리눅스


python -m venv pymupdf-venv
. pymupdf-venv/bin/activate
pip install pymupdf

맥 OS


python -m venv pymupdf-venv
. pymupdf-venv/bin/activate
pip install pymupdf

윈도우


python -m venv pymupdf-venv
.\pymupdf-venv\Scripts\activate
pip install pymupdf  

PDF에서 텍스트 추출

아래 코드와 같이 Python에서 PyMuPDF 라이브러리를 사용하여 PDF 문서에서 텍스트를 추출하고 라이브러리에서 제공되는 함수를 사용하여 단어 세기와 같은 텍스트 분석을 수행할 수 있습니다.

  # Import PyMuPDF
  import fitz
   
  # Open a PDF file
  pdf_document = "documentprocessing.pdf"
  doc = fitz.open(pdf_document)
   
  # Initialize an empty string to store extracted text
  extracted_text = ""
   
  # Iterate through each page and extract text
  for page_num in range(doc.page_count):
  page = doc[page_num]
  extracted_text += page.get_text()
   
  # Close the PDF document
  doc.close()
   
  # Perform text analysis (e.g., count words)
  word_count = len(extracted_text.split())
  print(f"The Extracted text is as follows:\n{extracted_text}")
  print(f"Total words in the document: {word_count}")

산출

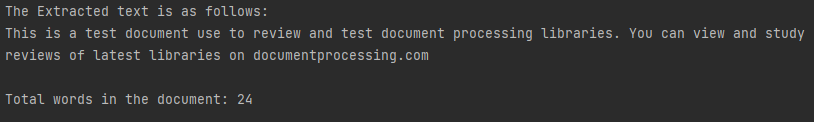
아래 이미지는 추출된 텍스트와 PDF 파일의 단어 수를 보여줍니다.
PDF에서 이미지 추출

PyMuPDF 라이브러리를 사용하여 Python의 PDF 문서에서 이미지를 추출할 수 있습니다. 아래 코드 조각은 지정된 PDF 파일을 열고 PDF에서 이미지를 추출하여 현재 작업 디렉터리에 저장합니다.

  # Import PyMuPDF
  import fitz
   
  # File path you want to extract images from
  file = "data.pdf"
   
  # Open the file
  pdf_file = fitz.open(file)
   
  # Iterate over PDF pages
  for page_index in range(len(pdf_file)):
  # Get the page itself
  page = pdf_file[page_index]
   
  # Get the image list for the page
  image_list = page.get_images(full=True)
   
  # Printing the number of images found on this page
  if image_list:
  print(f"[+] Found a total of {len(image_list)} images in page {page_index + 1}")
  else:
  print("[!] No images found on page", page_index + 1)
   
  # Extract images from the page
  for image_index, img in enumerate(image_list, start=1):
  xref = img[0]
  base_image = pdf_file.extract_image(xref)
  image_bytes = base_image["image"]
  image_ext = base_image["ext"]
   
  # Save the image to a file
  image_filename = f"page_{page_index + 1}_image_{image_index}.{image_ext}"
  with open(image_filename, "wb") as img_file:
  img_file.write(image_bytes)
   
  # Close the PDF document
  pdf_file.close()

산출

다음은 PDF 문서에서 추출한 PNG 이미지입니다.

PDF에서 테이블 추출

또한 PyMuPDF 라이브러리를 사용하여 PDF 문서를 처리하고 그 문서에서 테이블을 추출할 수도 있습니다. 지정된 PDF 파일을 열고 PDF 문서에서 테이블을 추출하는 아래 코드 조각을 확인하세요.

  # import package PyMuPDF
  import fitz
   
  # Open some document, for example a PDF (could also be EPUB, XPS, etc.)
  doc = fitz.open("table_handling_example.pdf")
   
  # Load a desired page. This works via 0-based numbers
  page = doc[0]
   
  # Look for tables on this page and display the table count
  tabs = page.find_tables()
  print(f"{len(tabs.tables)} table(s) on {page}")
   
  # Select the first table
  tab = tabs[0]
   
  df = tab.to_pandas()
  print("Table:")
  print(df)

산출

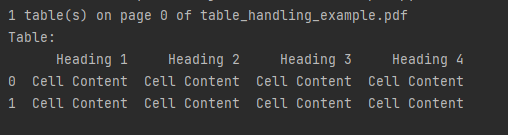
아래 스크린샷은 PDF 문서에서 추출된 테이블을 보여줍니다.

PDF에 텍스트 삽입

아래 Python 코드 조각은 PDF 파일에 텍스트를 삽입하고 수정된 PDF를 text.pdf로 저장하기 위해 PyMuPDF 라이브러리를 사용하는 방법을 보여줍니다.

  # Import PyMuPDF
  import fitz
   
  # Open a PDF file
  doc = fitz.open("documentprocessing.pdf")
  page = doc[0] # Access the first page
   
  # Define the starting point for the text
  p = fitz.Point(75, 150)
   
  # Define the text to be inserted
  text = "Some text,\nspread across\nseveral lines."
   
  # Insert the text on the page
  rc = page.insert_text(p, text)
   
  # Print the number of lines printed on the page
  print("%i lines printed on page %i." % (rc, page.number))
   
  # Save the modified PDF to a new file
  doc.save("text.pdf")

산출

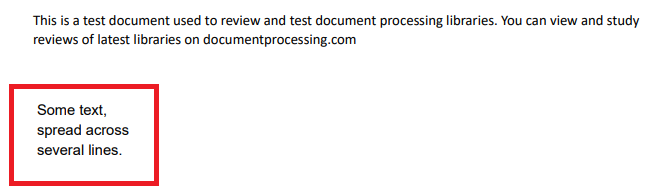
위 코드를 사용하여 삽입된 텍스트는 아래 빨간색 상자로 강조 표시됩니다.

경축! 아무것도 안하여 에스천사게임즈가 새로운 모습으로 재오픈 하였습니다.
어린이용이며, 설치가 필요없는 브라우저 게임입니다.
https://s1004games.com

PyMuPDF와 함께 OCR을 사용한 PDF 텍스트 인식

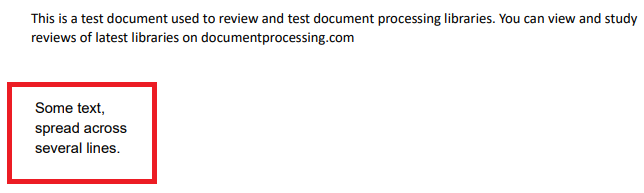
We will perform OCR on the PDF file containing the following image:
 

  # Import PyMuPDF
  import fitz
  import os
   
  # Set the TESSDATA_PREFIX environment variable to the folder containing the language file
  os.environ['TESSDATA_PREFIX'] = 'F://'
   
  # Open the PDF file
  pdf_document = fitz.open('data.pdf')
   
  # Get the page from the PDF document
  page_number = 1
  page = pdf_document[page_number - 1]
   
  # Perform OCR using get_textpage_ocr
  textpage_ocr = page.get_textpage_ocr(flags=3, language='eng', dpi=72, full=False, tessdata=None)
   
  # Extract text from the OCR result
  text = textpage_ocr.extractText()
   
  # Print the OCR result
  print(text)
   
  # Close the PDF document
  pdf_document.close()

산출

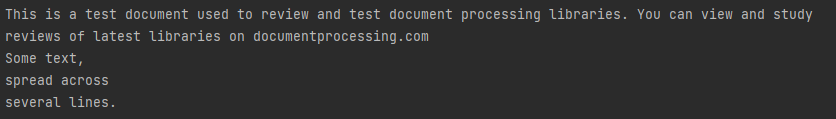
아래 이미지는 제공된 PDF 파일에 있는 이미지에서 추출된 텍스트를 보여줍니다.
결론

요약하자면, PyMuPDF는 분명한 장점과 단점을 지닌 전문 도구입니다. OCR 및 텍스트 추출과 같은 작업에 적합하므로 PDF에서 텍스트를 처리하는 데 유용합니다.

그러나 특히 PDF의 구조가 복잡하거나 페이지 수가 많은 경우에는 PDF에서 테이블을 추출하는 데 그다지 좋지 않아 일부 사용자에게는 단점이 될 수 있습니다. 또한 특정 상황에서는 Pandas 및 Tesseract OCR 언어 데이터 파일과 같은 추가 라이브러리가 필요할 수 있어 사용이 복잡해질 수 있습니다. 이러한 제한에도 불구하고 PyMuPDF는 PDF의 텍스트 작업을 위한 강력한 선택으로 남아 있습니다.

[출처] https://products.documentprocessing.com/ko/parser/python/pymupdf/


본 웹사이트는 광고를 포함하고 있습니다.
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
번호 제목 글쓴이 날짜 조회 수
64 [python][자료구조] "pdf 취소선 검출" How to identify strike-out text from PDF files using Python 졸리운_곰 2024.07.18 544
» [python][자료구조] 오픈 소스 Python PDF 파서 라이브러리 file 졸리운_곰 2024.07.16 444
62 [python][자료구조] 벡터화 | Vectorization file 졸리운_곰 2023.12.21 330
61 [python][자료구조] Python의 Loop? NO! , Python의 Vectorization? OK!!! file 졸리운_곰 2023.12.21 473
60 [python][자료구조] Python - MySQL 데이터 추가, 삭제, 업데이트 졸리운_곰 2023.05.13 488
59 [python][자료구조] Python의 JSON - 문자열을 JSON으로 변환하는 방법 졸리운_곰 2023.05.06 456
58 [python][자료구조] [Python] Logging to MongoDB (로그 남기기) file 졸리운_곰 2023.03.24 428
57 [python][자료구조] [스파르타 웹 개발 종합] 파이썬으로 크롤링하고 DB에 저장하기(request, bs4, mongoDB 패키지 사용) 졸리운_곰 2023.03.12 461
56 [python][자료구조] [MongoDB] Document Query(조회) – find() 메소드 졸리운_곰 2023.03.08 315
55 [python][자료구조] Python(flask)으로 mongoDB 제어하기 – pymongo file 졸리운_곰 2023.03.08 604
54 [python][자료구조] django sqlite3 MySQL로 전환하기 file 졸리운_곰 2023.03.02 409
53 [python][자료구조] django에서 db.sqlite3 데이터를 mysql로 옮기기 졸리운_곰 2023.03.02 427
52 [python][자료구조] Python - JSON 파일 읽고 쓰는 방법 졸리운_곰 2023.02.04 480
51 [python][자료구조] [인코딩] 유니코드 인코딩 처리 (특히 json 입출력 시) 졸리운_곰 2023.02.04 363
50 [python][자료구조] Dropbox API 사용하기 (with python) 졸리운_곰 2022.12.03 306
49 [Python][자료구조] SQLAlchemy Tutorial(한글) - 2 졸리운_곰 2022.12.03 393
48 [Python]][자료구조] SQLAlchemy Tutorial(한글) - 1 졸리운_곰 2022.12.03 275
47 [python][자료구조] python anaconda 에서 mysql 접속 졸리운_곰 2022.01.25 657
46 [python 자료구조] 림코딩의 파이썬으로 csv 다루기 강좌 (읽기,쓰기,수정,추가) 졸리운_곰 2022.01.16 521
45 python - 읽은 후 kafka 메시지를 삭제하는 방법 졸리운_곰 2021.07.13 900
대표 김성준 주소 : 경기 용인 분당수지 U타워 등록번호 : 142-07-27414
통신판매업 신고 : 제2012-용인수지-0185호 출판업 신고 : 수지구청 제 123호 개인정보보호최고책임자 : 김성준 sjkim70@stechstar.com
대표전화 : 010-4589-2193 [fax] 02-6280-1294 COPYRIGHT(C) stechstar.com ALL RIGHTS RESERVED