
- 전체
- Python 일반
- Python 수학
- Python 그래픽
- Python 자료구조
- Python 인공지능
- Python 인터넷
- Python SAGE
- wxPython
- TkInter
- iPython
- wxPython
- pyQT
- Jython
- django
- flask
- blender python scripting
- python for minecraft
- Python 데이터 분석
- Python RPA
- cython
- PyCharm
- pySide
- kivy (python)
flask Python + Flask - 사용자와 대화하는 방법(Database 연동).
2016.08.04 09:49
Python + Flask - 사용자와 대화하는 방법(Database 연동).
사용자가 누구인지 알아야 그에 필요한 정보를 보내줄 수 있다.
웹 서비스의 기본이라고 할 수 있다.
이번에는 사용자에게 받은 정보를 파이썬 Flask 서버에서 처리하고
그 정보를 Database와 연동하는 법을 알아본다.
내가 사용하는 Databse는 여러가지가 있지만
이번 실습에서는 Elasticsearch 를 이용해 보려고 한다.
기대해도 좋다.
우서 Elasticsearch는 내 블로그에서 환경설정에 관한 설명을 해놓았다.
설치가 완료되었다는 가정하에 시작한다.
간단하게 파이썬 Flask 서버에서 데이터를 가지고 와서 ... 1)
사용자에게 보여주는 것 ...2)
까지 해보겠다.
내가 만든 route 는 '/facebook' 이다.
미리 facebook 에서 crawling 한 데이터가 Elasticsearch 에 존재한다.
이 데이터를 가지고 화면에 보여주는 로직이다.
@app.route('/facebook', methods=['post', 'get'])
def facebook_data():
es = Elasticsearch();
#data = es.search(index='facebook', doc_type='fb')
sizes = 20 #data['hits']['total']
data = es.search(index='facebook', size=sizes)
g_list=[]
for hit in data['hits']['hits']:
g_list.append({'message':hit['_source']['message'], 'created_time':hit['_source']['created_time']})
return render_template('facebook.html', content = g_list)
매우 간단해 보이지만 이것은 Elasticsearch 와 연동을 통한 데이터 획득이다.
사용한 모듈은 아래와 같다.


from elasticsearch import Elasticsearch
HTML 파일에서 사용한 로직화면이다.
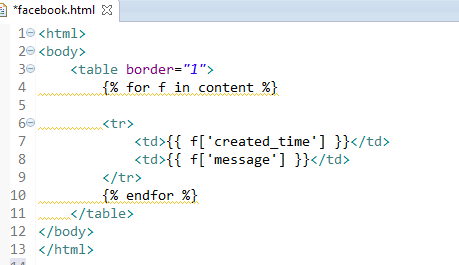
이 또한 너무... 간단해서 실망하지 않았으면 좋겠다.
이제 위의 URL로 접속 했을때, 가져온 데이터를 보여주겠다.
참고로 데이터는 Facebook 에 '대나무숲' 이라는 커뮤니티에 올라온 글이다.

내용은 알 필요가 없을것 같다.
위와 같이 table 형식에 데이터가 들어와 있는 것을 확인 할 수 있었다.
다른 관계형 데이터베이스(e.g MySQL, PostgreSQL, Oracle, etc,.) 와는 조금 다른
NoSQL을 사용하는 이유는 바로 빅데이터 처리와 관련이 있다.
어떻게 NoSQL에 필요한 정보를 가져오고 집어넣을 수 있는지는 차차 알아가자.
그럼 이제 어느정도 감이 온다.
사용자가 보낸 데이터(From form data)를 파이썬 Flask 서버에서 Database 와 연동을 통해
필요한 데이터를 가져올 수 있다.
이제 진짜 사용자에게 로그인을 허락해보자.
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
