[Python] 네이버 주식 종목별 일별 데이터 가져오기
이번에는 네이버 주식(http://finance.naver.com/) 데이터를 가져오는 방법을 해보도록 하겠습니다.
아래는 삼성전자(보통주)를 기준으로 일별시세 데이터 입니다.
크롬에서 표 안쪽에서 오른쪽 마우스를 누르면 "프레임 소스 보기" 선택하면 아래 표에 해당하는 주소를 얻어 올 수 있습니다.
삼성전자(보통주) 일별 시세 주소 : finance.naver.com/item/sise_day.nhn?code=005930
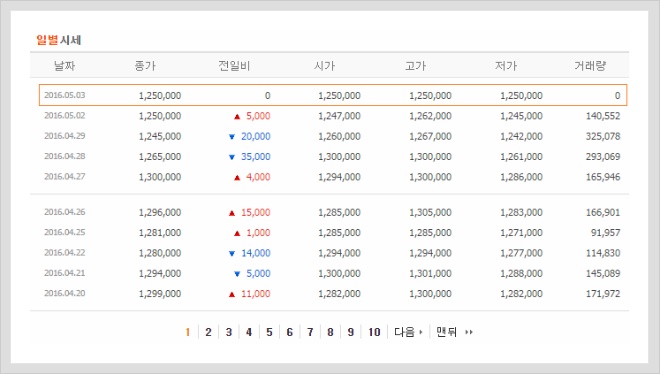
그 다음에 주요한 것은 각 페이지별로 데이터를 가져오는 방법입니다.
2번 페이지를 누를 경우 아래와 같은 주소를 얻게 됩니다.
삼성전자(보통주) 일별 시세 페이지 주소 : finance.naver.com/item/sise_day.nhn?code=005930&page=2
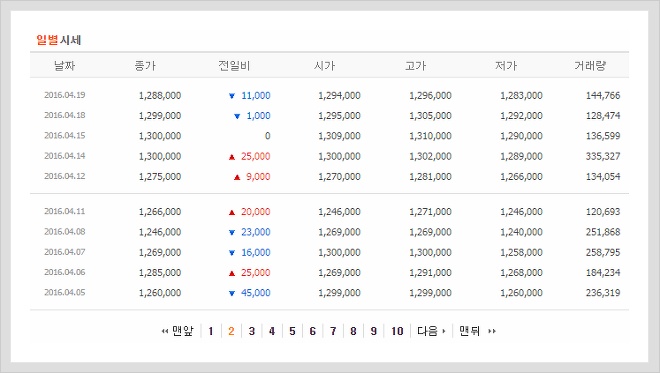
이러한 방법으로 데이터를 수집해보겠습니다.
1. 네이버 주식 일별시세(삼성전자) 데이터 가져오기
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
|
import urllib
import time
from urllib.request import urlopen
from bs4 import BeautifulSoup
stockItem = '005930'
url = 'http://finance.naver.com/item/sise_day.nhn?code='+ stockItem
html = urlopen(url)
source = BeautifulSoup(html.read(), "html.parser")
maxPage=source.find_all("table",align="center")
mp = maxPage[0].find_all("td",class_="pgRR")
mpNum = int(mp[0].a.get('href')[-3:])
for page in range(1, mpNum+1):
print (str(page) )
url = 'http://finance.naver.com/item/sise_day.nhn?code=' + stockItem +'&page='+ str(page)
html = urlopen(url)
source = BeautifulSoup(html.read(), "html.parser")
srlists=source.find_all("tr")
isCheckNone = None
if((page % 1) == 0):
time.sleep(1.50)
for i in range(1,len(srlists)-1):
if(srlists[i].span != isCheckNone):
srlists[i].td.text
print(srlists[i].find_all("td",align="center")[0].text, srlists[i].find_all("td",class_="num")[0].text )
|
2. 네이버 주식 일별시세(삼성전자) 데이터 결과
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
|
[python@localhost source]$ python get_naver_stock_prices.py
1
2016.05.03 1,258,000
2016.05.02 1,250,000
2016.04.29 1,245,000
2016.04.28 1,265,000
2016.04.27 1,300,000
2016.04.26 1,296,000
2016.04.25 1,281,000
2016.04.22 1,280,000
2016.04.21 1,294,000
2016.04.20 1,299,000
2
2016.04.19 1,288,000
2016.04.18 1,299,000
2016.04.15 1,300,000
2016.04.14 1,300,000
2016.04.12 1,275,000
2016.04.11 1,266,000
2016.04.08 1,246,000
2016.04.07 1,269,000
2016.04.06 1,285,000
2016.04.05 1,260,000
|
출처: http://estenpark.tistory.com/353 [전문가로가는길]
[Python] 네이버 주식 종목별 일별 데이터 가져오기
이번에는 네이버 주식(http://finance.naver.com/) 데이터를 가져오는 방법을 해보도록 하겠습니다.
아래는 삼성전자(보통주)를 기준으로 일별시세 데이터 입니다.
크롬에서 표 안쪽에서 오른쪽 마우스를 누르면 "프레임 소스 보기" 선택하면 아래 표에 해당하는 주소를 얻어 올 수 있습니다.
삼성전자(보통주) 일별 시세 주소 : finance.naver.com/item/sise_day.nhn?code=005930
그 다음에 주요한 것은 각 페이지별로 데이터를 가져오는 방법입니다.
2번 페이지를 누를 경우 아래와 같은 주소를 얻게 됩니다.
삼성전자(보통주) 일별 시세 페이지 주소 : finance.naver.com/item/sise_day.nhn?code=005930&page=2
이러한 방법으로 데이터를 수집해보겠습니다.
1. 네이버 주식 일별시세(삼성전자) 데이터 가져오기
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
|
import urllib
import time
from urllib.request import urlopen
from bs4 import BeautifulSoup
stockItem = '005930'
url = 'http://finance.naver.com/item/sise_day.nhn?code='+ stockItem
html = urlopen(url)
source = BeautifulSoup(html.read(), "html.parser")
maxPage=source.find_all("table",align="center")
mp = maxPage[0].find_all("td",class_="pgRR")
mpNum = int(mp[0].a.get('href')[-3:])
for page in range(1, mpNum+1):
print (str(page) )
url = 'http://finance.naver.com/item/sise_day.nhn?code=' + stockItem +'&page='+ str(page)
html = urlopen(url)
source = BeautifulSoup(html.read(), "html.parser")
srlists=source.find_all("tr")
isCheckNone = None
if((page % 1) == 0):
time.sleep(1.50)
for i in range(1,len(srlists)-1):
if(srlists[i].span != isCheckNone):
srlists[i].td.text
print(srlists[i].find_all("td",align="center")[0].text, srlists[i].find_all("td",class_="num")[0].text )
|
2. 네이버 주식 일별시세(삼성전자) 데이터 결과
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
|
[python@localhost source]$ python get_naver_stock_prices.py
1
2016.05.03 1,258,000
2016.05.02 1,250,000
2016.04.29 1,245,000
2016.04.28 1,265,000
2016.04.27 1,300,000
2016.04.26 1,296,000
2016.04.25 1,281,000
2016.04.22 1,280,000
2016.04.21 1,294,000
2016.04.20 1,299,000
2
2016.04.19 1,288,000
2016.04.18 1,299,000
2016.04.15 1,300,000
2016.04.14 1,300,000
2016.04.12 1,275,000
2016.04.11 1,266,000
2016.04.08 1,246,000
2016.04.07 1,269,000
2016.04.06 1,285,000
2016.04.05 1,260,000
|
출처: http://estenpark.tistory.com/353 [전문가로가는길]


