
- 전체
- Python 일반
- Python 수학
- Python 그래픽
- Python 자료구조
- Python 인공지능
- Python 인터넷
- Python SAGE
- wxPython
- TkInter
- iPython
- wxPython
- pyQT
- Jython
- django
- flask
- blender python scripting
- python for minecraft
- Python 데이터 분석
- Python RPA
- cython
- PyCharm
- pySide
- kivy (python)
Python 인터넷 네이버 실시간 검색어를 자동 추출하는 방법
2017.11.14 23:42
네이버 실시간 검색어를 자동 추출하는 방법
ㅇ 네이버에서 제공하는 실시간 인기 검색어를 프로그램에서 자동으로 가져오는 방법에 대해서 설명합니다.
- 여기서는 실시간 검색어 제공 페이지의 html을 간략히 분석하고,
- python 언어를 이용해서 검색어를 추출하는 방법을 설명합니다.
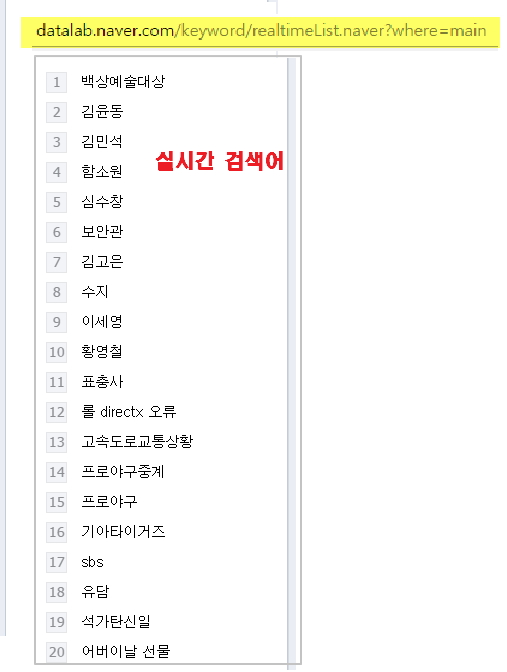
ㅇ 우선, 네이버에서 제공하는 실시간 인기검색어 URL과 웹브라우저에서 보이는 내용을 캡쳐해 보았습니다.
- 제공되는 형태는 아래와 같습니다만, 여기서는 일부분만 화면 캡쳐했기 때문에
- 실제로는 훨씬 더 많은 내용이 보여집니다.
|
|
ㅇ 주의할 점은
- 네이버 페이지 개편 작업 등을 하면 URL이 바뀔 수도 있고,
- URL은 맞아도, 내용이나 포맷이 변경될 수도 있습니다.
- 그 경우에는 여기서 설명하는 내용이 맞지 않을 수도 있습니다.
- 하지만, 여기서 설명하는 방법을 이해하면,
- 그러한 변경에 맞춰 추출하는 방법을 수정할 수 있습니다.
ㅇ HTML 분석: 추출하는 방법을 설명하기 전에,
- 실시간 검색어 순위 페이지의 HTML 코드를 볼 줄 알아야합니다.
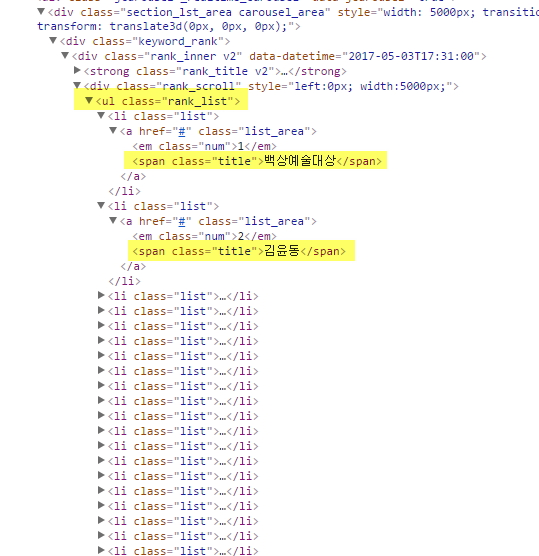
- 아래에는 검색어 순위에 해당하는 부분의 코드만 캡쳐해 놓았습니다.
- ul tag 들 중에서, class attribute가 'rank_list'를 가진 것이 실시간 검색어를 가지고 있습니다.
- 일단 이 ul tag를 찾기만 하면,
- 그 안에 span tag들이 여러 개 들어있는데, 이 tag의 값들이 모두 검색어에 해당합니다.
- span tag들은 모두 20개 있고,
- 이것은 실시간 상위 검색어 20에 해당합니다.
|
|


ㅇ Beautiful Soup
- python에서는 HTML 문서 파싱을 아주 쉽게 할 수 있는 beautiful soup 모듈을 제공합니다.
- 이 모듈은 html 문서를 tree구조로 만들에서,
- 손쉽게 원하는 영역을 찾고, 특정 값을 추출할 수 있도록 합니다.
- 이 프로그램도 beautifulsoup을 이용할 것입니다.
ㅇ 프로그램 구조
- 아주 간단합니다.
- 네이버 실시간 검색어 페이지를 다운로드 받고,
- 결과를 파싱해서, 실시간 검색어 20개를 찾아내어 출력합니다.
ㅇ 실시간 검색어 페이지 다운로드
- Python에서 제공하는 requests 모듈을 이용하면 1줄로 짤 수 있습니다.
- 아래 코드의 line 30에 해당하는 부분입니다.
ㅇ HTML 파싱
- 이제 Beautifulsoup이 등장할 순서입니다.
- 다운로드 받은 웹페이지를 파싱하는데,
- 이것도 1줄이면 됩니다.
- 아래 코드의 line 32에 해당합니다.
ㅇ 검색어 부분 추출
- 이것도 간단하게 생각하면 됩니다.
- 앞서 HTML 구조에서 설명했듯이, ul tag 들 중에서 class attribute가 'rank_list'인 것만 찾으면 된다.
- 이 과정은 line 37 ~ 48에 해당합니다.
ㅇ 검색어만 출력하기
- ul tag 안에 들어있는
- span tag 들을 모두 찾으면,
- 그 tag의 contents가 바로 실시간 검색어입니다.
- span tag는 모두 20개이고, 상위 20개 인기 검색어에 해당합니다.
- 이 과정은 line 50 ~ 55에 해당합니다.
ㅇ 파싱과정에서 다소 지저분한 디테일들과 한글처리 관련 주의사항이 있는데,
- 아래 코드의 comment에 설명해 놓았습니다.
- 코드는 바로 붙여넣기 한 후에 실행할 수 있습니다.
- 다만, Beautifulsoup이 없다면, 먼저 설치해야 합니다.
. 설치 방법에 대해서는 인터넷을 검색하면 됩니다.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 |
# -*- coding: utf-8 -*- # 네이버 실시간 검색어 크롤링 # # 네이버에서 제공하는 실시간 인기 검색어 상위 20개를 # 자동추출하는 프로그램 # # 크롤이 대상 웹페이지: 아래 주소에서 실시간 검색어 정보를 얻을 수 있다. # URL: http://datalab.naver.com/keyword/realtimeList.naver?where=main # # 찾는 방법: 읽어 온 문서를 파싱해서 검색어를 찾는 과정은 다음과 같다. # ul tag를 모두 찾고, # class attribute가 rank_list인 것을 찾고, # span tag안에 들어있는 실시간 검색어를 추출 # # # 사용모듈 # requests: HTTP request와 response, 네트워크를 통해웹페이지 접속 # BeautifulSoup: 웹페이지를 파싱 # # 주의사항: # Beautiful soup이 반환하는 값은 배열 안에 들어가 있음 # index[0]이 맨 앞에 들어 있는 값임. # # import requests from bs4 import BeautifulSoup # 실시간 검색어를 제공하는 웹이지를 읽음 response = requests.get('http://datalab.naver.com/keyword/realtimeList.naver?where=main') # 웹페이즈를 파싱 dom = BeautifulSoup(response.text, 'html.parser') #print(response.text) # for debugging # ul tag를 모두 찾음 result = dom.find_all('ul') #print result # for debugging for res in result: #print(str(res['class'])) # for debugging #print "-------------------------\n" # for debugging # 실시간 검색어를 출력한다. # class attribute의 값이 rank_list인 경우에, if res['class'][0] == 'rank_list': # 검색어가 들어있는 span tag를 모두 찾아서, keywords = res.find_all('span') # span tag의 contents 중 첫번째 [0] 요소를 출력하면 된다. # 한글을 올바르게 출력하기 위해서는 # 이 파일의 맨 위에 utf-8 coding임을 코멘트로 명시 for key in keywords: # 상위 20개의 실시간 검색어가 들어있다. print key.contents[0] break |
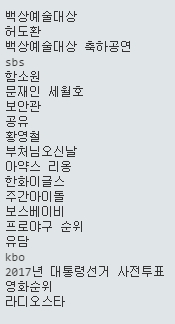
ㅇ 위의 Python 코드를 실행한 결과입니다.
- 20개의 실시간 인기 검색어가 나온 것을 볼 수 있습니다.
|
|
naver4.py
출처: http://swprog.tistory.com/entry/네이버-실시간-검색어를-자동-추출하는-방법 [소프트웨어 개구리]
본 웹사이트는 광고를 포함하고 있습니다.
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
