
- 전체
- Python 일반
- Python 수학
- Python 그래픽
- Python 자료구조
- Python 인공지능
- Python 인터넷
- Python SAGE
- wxPython
- TkInter
- iPython
- wxPython
- pyQT
- Jython
- django
- flask
- blender python scripting
- python for minecraft
- Python 데이터 분석
- Python RPA
- cython
- PyCharm
- pySide
- kivy (python)
Python 인터넷 파이썬 네이버 실시간 검색어 스크래핑(크롤링)
2020.05.09 18:30
파이썬 네이버 실시간 검색어 스크래핑(크롤링)
지난번에 간략하게 파이썬 스크래핑 크롤링에 대해 설명을 하면서 예제로 네이버 실시간 검색어 가져오기를 했습니다. 네이버 실시간 검색어를 가져오는 것은 간단 하지만 스크래핑하는 데 있어 기초가 되지 않을까 생각되어 몇 가지 예제 소스를 더 만들어 보았습니다.
이전 글 보기: https://wonderbout.tistory.com/31
개발자 도구를 이용해 네이버 소스를 보면 실시간 검색어에 대한 코드가 두 군데 있습니다. 하나는 클래스 명이 ah_roll로 시작하고 나머지 하나는 ah_list로 시작합니다. 만약 제목을 뽑기 위해서 제목에 해당하는 요소인 <span class="ah_k"> 만을 선택해 출력해 보면 1위부터 20위까지 20개가 나와야 하지만 40개의 중복된 제목이 출력됩니다. 1위부터 20위까지 20개만 출력하려면 부모 또는 조상의 클래스 명을 선택해야 합니다.
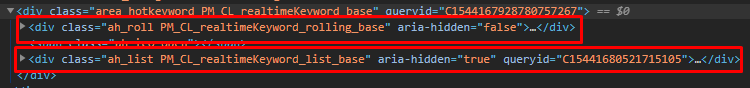
여기서는 클래스명이 ah_list의 내용을 가져 오도록 하겠습니다.
간단하게 제목만 뽑아 오기
실행 환경


- OS : 윈도우 10
- IDE : VScode
- Python : 3.7
- beautifulsoup4 : 4.6.3
- requests : 2.19.1
간단하게 제목만 뽑아서 출력하는 소스입니다.
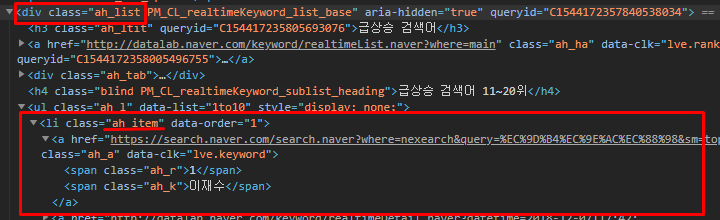
클래스명 ah_list의 자손 요소에 제목에 해당하는 클래스명 ah_k가 있습니다.
import requests
from bs4 import BeautifulSoup

resp = requests.get('https://www.naver.com/')
soup = BeautifulSoup(resp.text, 'html.parser')
titles = soup.select('.ah_list .ah_k')

for title in titles:
    print(title.get_text())
뽑아온 제목 앞에 임의로 순위을 넣기
위 예제 코드에서 for 문을 지우고 아래 코드로 대체 한다.
for i, title in enumerate(titles, 1):
    print(f'{i}위 {title.get_text()}')
제목과 순위 그리고 링크 주소 까지 가져오기
html코드를 보면 ah_list 클래스 밑에 ah_item 클래스 자식요소에 링크주소가 있습니다. a 태그를 이용해서 가져올 수도 있지만 여기서는 클래스 명(ah_a)으로 가져 옵니다. 그리고 그 자식클래스인 순위(ah_r)와 제목(ah_k)이 보입니다. 우선 모든 ah_item 요소들을 담고 그 자손들을 하나하나 선택해서 출력합니다.
참고로 select_one는 find와 같고 select는 find_all과 같습니다.
import requests
from bs4 import BeautifulSoup

resp = requests.get('https://www.naver.com/')
soup = BeautifulSoup(resp.text, 'html.parser')
hotkeywords = soup.select('.ah_list .ah_item')

for hotkey in hotkeywords:
    print(f'{hotkey.select_one(".ah_r").get_text()}위 '
          f'{hotkey.select_one(".ah_k").get_text()} '
          f'{hotkey.select_one(".ah_a").get("href")}')
다음 편에는 스크랩해온 데이터를 엑셀 또는 데이터베이스에 저장하는 것까지 해서 스크래핑을 완성하도록 하겠습니다.
출처: https://wonderbout.tistory.com/32 [원더바웃]
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
