
[인공지능 기술] Ollama(올라마) 집중분석
2024.12.25 23:16
[인공지능 기술] Ollama(올라마) 집중분석
올라마는 대규모 언어 모델(LLM)을 로컬 머신 상에서 실행하기 위한 강력한 도구입니다.
이번시간에는 올라마에 대해서 집중적으로 알아보겠습니다.
Ollama(올라마)
아직 설치를 안 하신 분들이 계실까봐 설치하는 법부터 차근차근 나아가겠습니다. 아래 실습할 내용이 많아서 설치를 꼭 해 보시길 바랍니다.
0. Ollama 설치
ollama 설치방법은 아래 글을 참고 바랍니다.
https://brunch.co.kr/@b2439ea8fc654b8/28
1. LLM 모델 설치
Ollama를 실제로 사용함에 있어서 Ollama의 어플리케이션을 실행한 후에 아래와 같은 명령어를 실행하면 LLM 모델을 설치 할 수 있습니다.
$ ollama run phi3
이를 실행하면 로컬에 Phi-3-Mini의 모델 파일이 없는 경우 자동으로 설치해 줍니다. 그래서, 처음 실행시에는 대략 몇 GB의 데이터 통신이 필요하게 됩니다.
만약, llama3 를 설치하고 싶다면, 아래처럼 실행하면 합니다. (설치가 참 쉽죠 ^^)
$ ollama run llama3
그러면 LLM이 다운로드되고 프롬프트가 표시됩니다. 아래와 같이 표시됩니다.
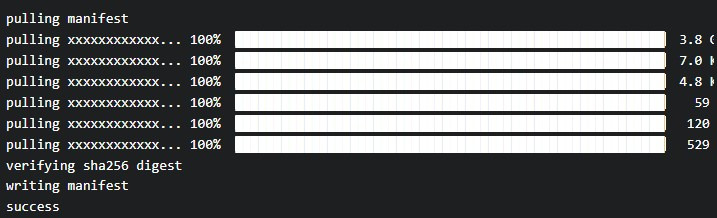 로컬에 LLM 다운로드 모습
다운 받은 모델의 위치는 아래와 같습니다.
macOS: ~/.ollama/models
Linux: /usr/share/ollama/.ollama/models
Windows: C:\Users\%username%\.ollama\models
2. Ollama Python Library의 메소드
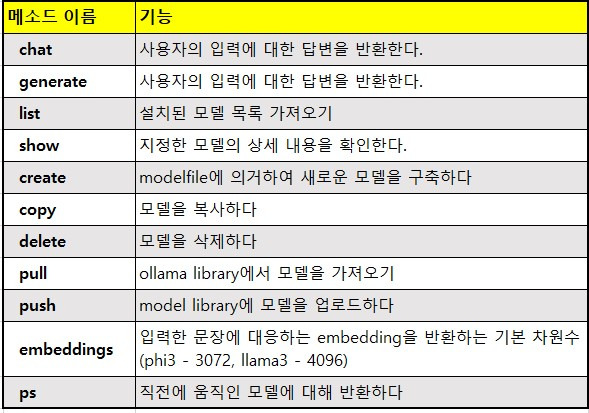 ollama 메소드 종류
메소드기능 어떤 것인지 몇 가지를 예시를 보이겠습니다.
[ Chat ]
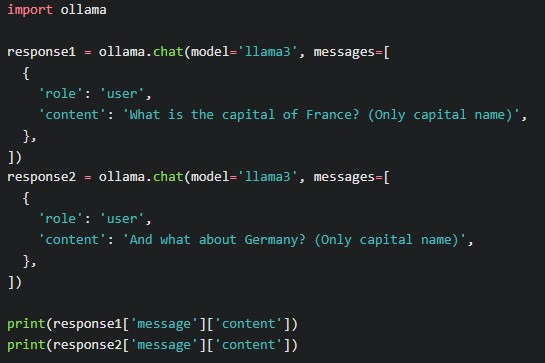
결과 >>>
Paris
Berlin
[ generate ]
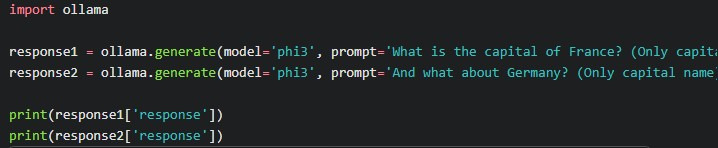
결과 >>>
Paris
Berlin
결과만 놓고 보면, Chat 과 generate 같습니다. 그렇지만 조금의 차이가 있습니다.
다시 말하면, chat과 generate 메서드는 둘 다 텍스트 생성을 목적으로 하지만, 사용 방식과 응용 범위에서 차이가 있습니다.
Chat 은 지속적인 대화를 통해 문맥을 유지하면서 여러 번의 요청과 응답을 주고받을 때 사용됩니다. 이전 대화 내용을 기억하며, 대화가 진행됨에 따라 문맥을 반영한 응답을 제공합니다. (ex. 챗봇 )
generate 은 명시된 프롬프트에 대해 한 번의 응답을 생성할 때 사용됩니다. 대화를 지속하지 않고, 입력에 따른 단일 응답을 바로 생성하는 데 적합합니다. (ex. 검색이나 QA 시스템)


[ list ]
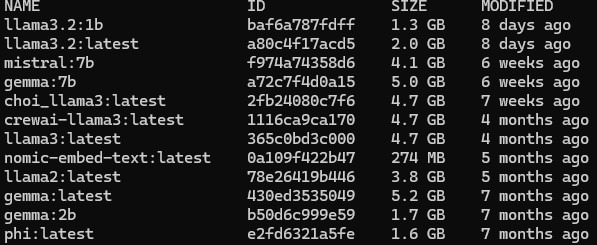 로컬에 설치된 LLM 모델
List 는 현재는 ollama 에 설치된 모델들의 목록을 볼 수 있습니다.
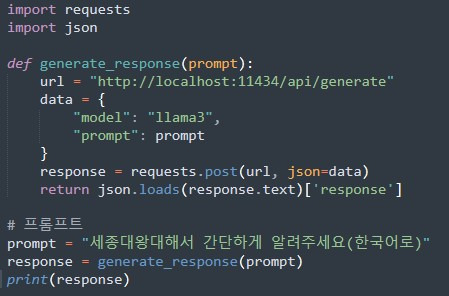
3. REST API를 사용한 Ollama 사용
Ollama는 다른 어플리케이션과 통합하는 데 사용할 수 있는 REST API를 제공하고 있습니다. Python의 requests 라이브러리를 사용한 예는 다음과 같습니다. (*로컬에 11434 port 로 구동되고 있습니다.)
4. Ollama를 사용한 간단한 챗봇 만들기
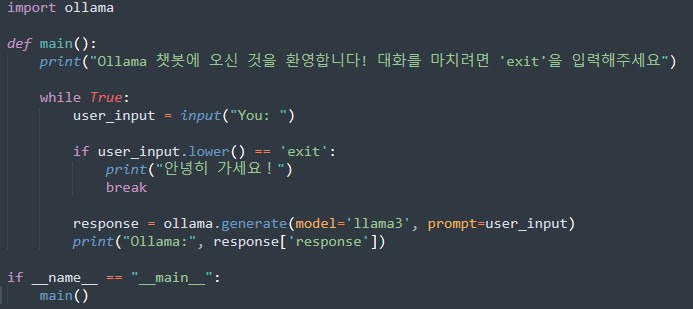
실행결과
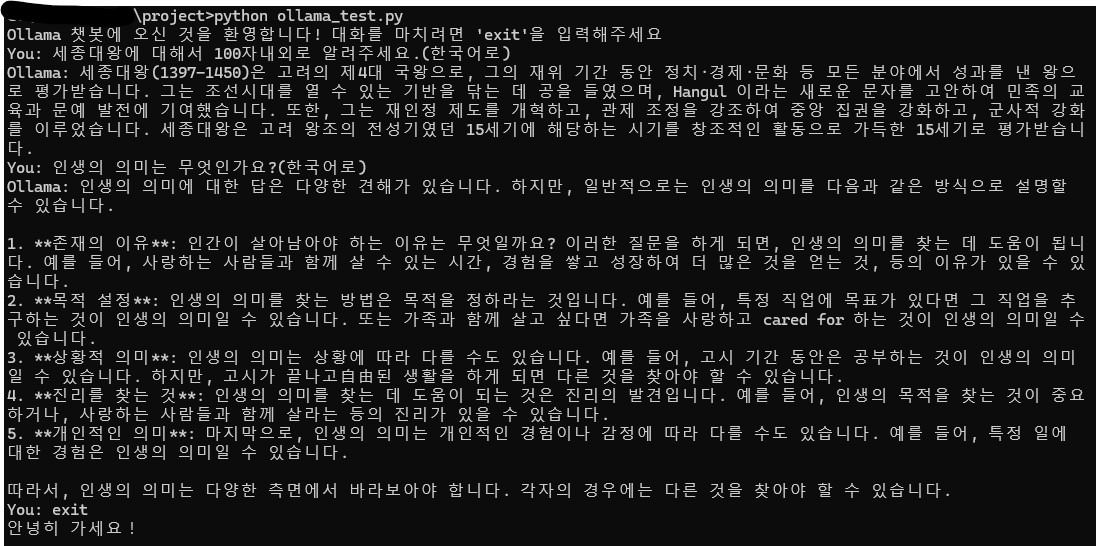
몇 줄만으로 로컬에 간단한 QA 챗봇이 완성되었습니다. llama3 는 한국어를 지원하지만, 프롬프트에 한국어로 답변 달라고 하지 않으면 가끔씩 영어로 답변을 할 때가 있습니다.
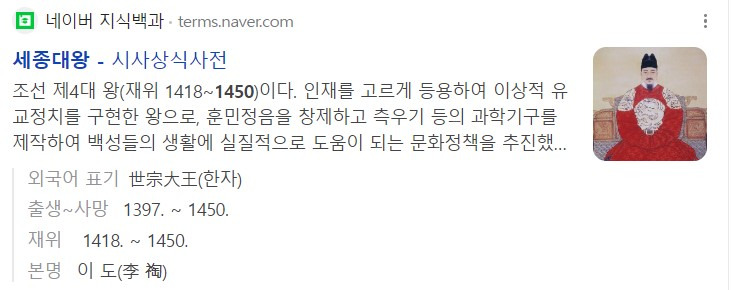 출처: 네이버
사용한 llama3 경우 세종대왕에 대해서 정확하게 답변을 하는 것을 볼 수 있습니다.
Ollama의 성능 향상을 위한 하드웨어 업그레이드
올라마의 성능을 향상시키는 가장 간단한 방법 중 하나는 하드웨어 업그레이드입니다.
■ CPU의 파워 업
올라마는 CPU로 실행할 수도 있기에, 당연한 이야기이지만 최신 CPU를 탑재하면 성능이 크게 향상됩니다.
예를 들어 인텔 코어 i9 또는 AMD 라이젠 9 프로세서는 올라마의 성능을 크게 향상시킬 수 있습니다.
■ 효율 향상을 위한 RAM 증가
RAM은 특히 큰 모델을 다룰 때 Ollama의 성능에 중요한 역할을 합니다.
16GB 이상(7B 파라미터가 작은 모델에 대해서)
32GB 이상(13B 파라미터의 중간 정도의 모델에 대하여)
64GB 이상(30B+ 파라미터의 큰 모델에 대하여)
■ GPU 액셀러레이션 활용
GPU는 특히 큰 모델에 대해 올라마의 성능을 극적으로 향상시킬 수 있습니다.
GPU 액셀러레이션을 활성화하십시오(이용 가능한 경우) --> $ export OLLAMA_CUDA=1
CUDA 지원을 갖춘 엔비디아 GPU(예: RTX3080, RTX4090 등)
작은 모델에는 최소 8GB의 VRAM을, 큰 모델에는 16GB 이상의 VRAM을 탑재한 GPU
마치며
올라마는 대량의 언어 모델을 로컬 머신에서 사용할 수 있는 강력한 도구입니다.이 가이드에 따라 Ollama 설치, 모델 실행, Python과의 통합 및 그 능력을 활용한 어플리케이션을 구축할 수 있게 됩니다. 특정 사용 케이스에 최적인 설정을 찾기 위해 다른 모델이나 설정으로 실험해 보세요. 올라마가 계속 진화함에 따라 공식 문서에서 새로운 기능과 개선점에 주목하세요.
■ Ollama API
https://github.com/ollama/ollama/blob/main/docs/api.md
■ Ollama Python Library
https://github.com/ollama/ollama-python
$ ollama run llama3d$ ollama run llama3
[출처] https://brunch.co.kr/@b2439ea8fc654b8/69
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
