
[인공지능 개발자] LLM을 서빙하는 프레임워크, vLLM 사용법
2026.04.14 22:11
[인공지능 개발자] LLM을 서빙하는 프레임워크, vLLM 사용법
개요
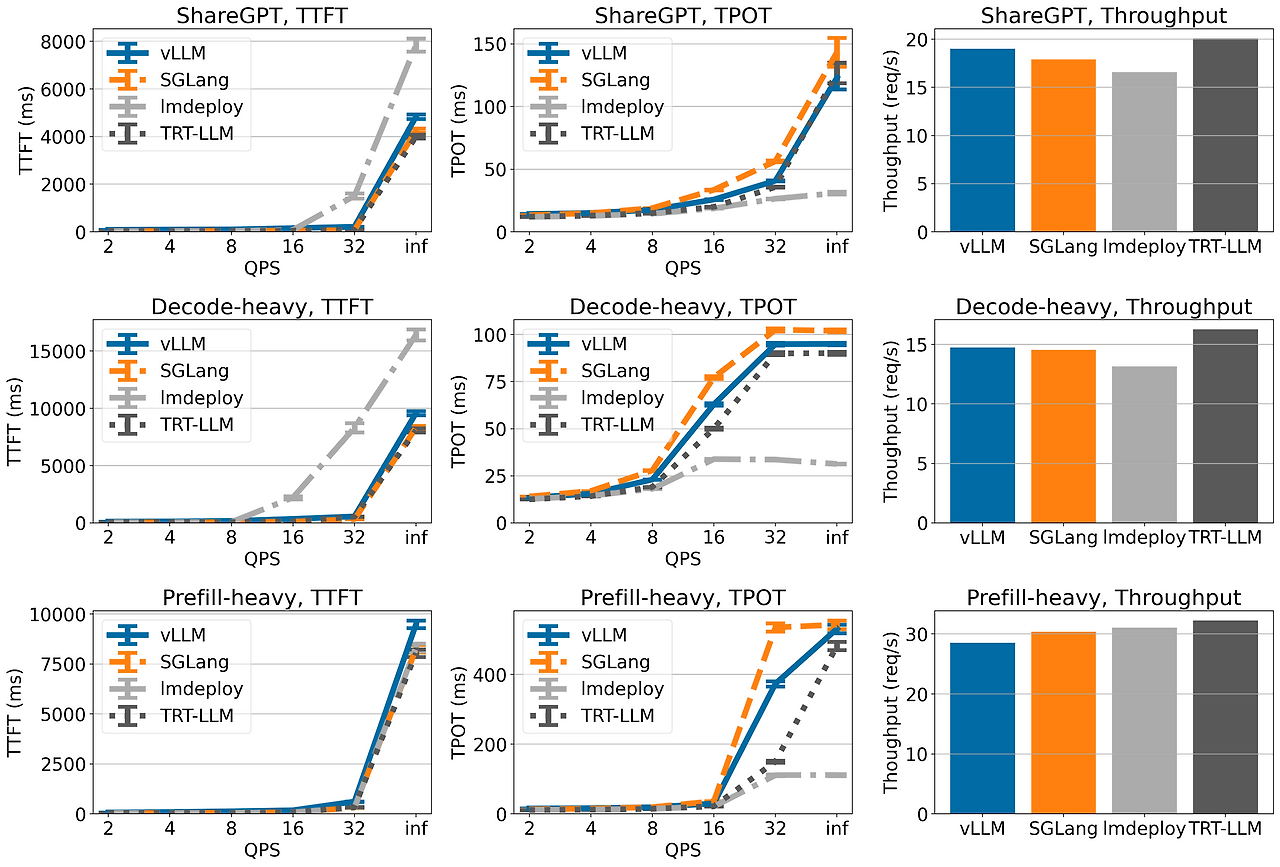
최근 대형 언어 모델(LLM)을 실제 서비스에 적용하려는 수요가 증가하면서, LLM을 효율적으로 서빙하는 기술의 중요성도 커지고 있습니다. 대표적인 서빙 프레임워크로는 SGLang, TensorRT-LLM, vLLM 등이 있으며, 이들 각각은 성능 특성에 차이를 보입니다.
이 중 vLLM은 초기부터 속도와 메모리 효율성 면에서 안정적인 구조를 갖춘 프레임워크로 주목을 받았고, 현재 가장 널리 활용되고 있는 LLM 서빙 솔루션 중 하나입니다
vLLM의 특징
- PagedAttention: 기존 시퀀스 기반 Attention 방식 대신 페이지 기반의 유연한 메모리 할당 전략을 도입하여 배치 효율 극대화
- 비동기 엔진 구조: 추론 요청을 효율적으로 처리하기 위한 비동기 처리 구조로 높은 처리량 유지
- OpenAI 호환 API 지원: 기존 OpenAI API 방식으로도 쉽게 서빙 가능
속도 비교
vLLM Quick Start
Offline Batched Inference
설치
pip install vllm
모델 로딩 및 추론
from vllm import LLM, SamplingParams

model_name =  "kakaocorp/kanana-nano-2.1b-base" # 원하는 모델 이름

llm = LLM(model=model_name)

prompts = [
    "한국의 수도는 어디인가요?",
    "서울 여행지 3곳을 소개해주세요."
]

sampling_params = SamplingParams(temperature=0.7, top_p=0.9, max_tokens=100)

# 답변 생성
outputs = llm.generate(prompts, sampling_params)

# 답변 출력
for output in outputs:
    prompt = output.prompt
    generated_text = output.outputs[0].text
    print(f"Prompt: {prompt!r}, Generated text: {generated_text!r}")
로컬에서 모델을 직접 로드해 사용할 수 있으며, SamplingParams로 디코딩 전략을 조절할 수 있습니다.
OpenAI Completions API with vLLM
vLLM은 OpenAI API 스타일의 서버도 제공합니다. 이를 통해 기존 코드 변경 없이도 쉽게 서빙 인프라에 연결할 수 있습니다.
서버 실행
vllm serve Qwen/Qwen3-1.7B-Instruct
클라이언트 예제(curl)
curl http://localhost:8000/v1/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "Qwen/Qwen3-1.7B-Instruct",
        "prompt": "한국의 수도는 어디인가요?",
        "max_tokens": 7,
        "temperature": 0
    }'
클라이언트 예제 (python)
import openai

openai.api_base = "http://localhost:8000/v1"

response = openai.ChatCompletion.create(
    model="Qwen/Qwen3-1.7B-Instruct",
    messages=[
        {"role": "user", "content": "Tell me a joke about AI."}
    ],
    temperature=0.7,
    max_tokens=100
)

print(response['choices'][0]['message']['content'])
실제 OpenAI와 거의 동일한 인터페이스를 제공하므로, API 전환이 간편합니다.


vLLM 주요 파라미터
엔진 초기화 파라미터
| 파라미터 | 설명 |
|---|---|
gpu_memory_utilization |
GPU 메모리 사용 비율. 기본값은 0.9로, GPU 메모리 90%까지만 사용하여 안정성 확보 |
max_model_len |
하나의 입력 시퀀스에서 처리할 수 있는 최대 토큰 길이. (ex: 2048, 4096 등) |
tensor_parallel_size |
모델을 여러 GPU에 나눠서 병렬화할 때 사용. ex) 2로 설정하면 2개 GPU 사용 |
추론 파라미터
| 파라미터 | 설명 |
|---|---|
temperature |
샘플링의 무작위성 정도. 낮을수록 일정하고, 높을수록 무작위적(창의력이 높아짐) |
top_p |
상위 p%의 토큰만 고려하여 샘플링 |
top_k |
확률 상위 k개의 후보만 고려하여 샘플링 |
max_tokens |
생성할 최대 토큰 수 |
마무리
vLLM은 간단한 설치와 높은 성능, 그리고 OpenAI API와의 호환성 덕분에 LLM 서빙의 진입 장벽을 크게 낮춰주는 도구입니다. 특히 서빙 효율과 메모리 최적화가 중요한 실시간 애플리케이션에서 큰 강점을 발휘합니다.
Reference
- https://docs.vllm.ai/en/v0.7.1/getting_started/quickstart.html
- https://blog.vllm.ai/2024/09/05/perf-update.html?utm_source=chatgpt.com#appendix
[출처] https://ariz1623.tistory.com/375
본 웹사이트는 광고를 포함하고 있습니다.
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
