
- 전체
- Sample DB
- database modeling
- [표준 SQL] Standard SQL
- G-SQL
- 10-Min
- ORACLE
- MS SQLserver
- MySQL
- SQLite
- postgreSQL
- 데이터아키텍처전문가 - 국가공인자격
- 데이터 분석 전문가 [ADP]
- [국가공인] SQL 개발자/전문가
- NoSQL
- hadoop
- hadoop eco system
- big data (빅데이터)
- stat(통계) R 언어
- XML DB & XQuery
- spark
- DataBase Tool
- 데이터분석 & 데이터사이언스
- Engineer Quality Management
- [기계학습] machine learning
- 데이터 수집 및 전처리
- 국가기술자격 빅데이터분석기사
- 암호화폐 (비트코인, cryptocurrency, bitcoin)
[기계학습] machine learning 한국어 뉴스 데이터로 딥러닝 시작하기 - 5. 한국어 word2vec 데모 사이트 만들기
2020.01.04 00:46
한국어 뉴스 데이터로 딥러닝 시작하기 - 5. 한국어 word2vec 데모 사이트 만들기
한국어 뉴스 데이터로 딥러닝 시작하기
5. 한국어 word2vec 데모 만들기
아래 doc2vec 모델 훈련하기 포스팅에서 훈련시킨
doc2vec model (word2vec 포멧으로 저장버전)을 이용해서
한국어 word2vec 데모 페이지를 만들었습니다.
위키 뉴스와 경제 신문으로 훈련을 시켰고
데모 사이트는 flask 를 사용하여 제작했습니다.
(참고사이트 바로가기: https://github.com/3Top/word2vec-api)
현재 지원하는 기능은 단어를 입력하면
벡터 공간에서 제일 가까이 있는 (제일 유사한) 단어들을 보여주는 것입니다.
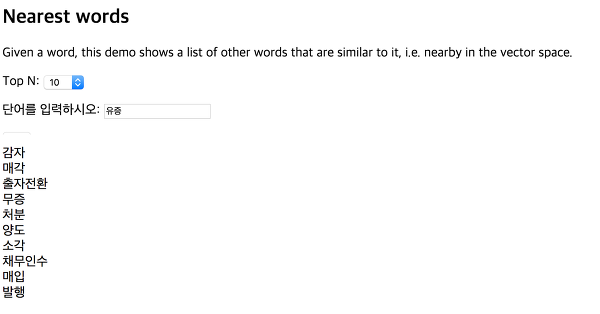


그 외 word2vec 함수들과 디자인은 향후 개선 예정이며
doc2vec 데모 사이트도 이어서 만들어볼 생각입니다 ㅋ
참고로 이 데모 사이트에서 사용한 한국어 word2vec web embedding api는
아래 github에서 다운로드 가능합니다.
# install dependencies
pip2 install -r requirements.txt
# word2vec web api 서비스 시작하기
python /home/stock/public_html/word2vec/word2vec-api.py --model wiki_dmpv_100_no_taginfo_user_dic_word2vec_format.bin --binary BINARY --path /word2vec --host 0.0.0.0 --port 4000
# Example call
curl http://127.0.0.1:4000/word2vec/most_similar?positive=무증
["\uac10\uc790", "\u318d\ubb34\uc0c1\uc99d\uc790", "\uc720\uc99d", "\ucc44\ubb34\uc778\uc218", "\ubb34\uc704\ubc95", "\ud589\uc815\uccad", "\uc6cc\ud06c\uc544\uc6c3", "\ub9e4\ub3c4\uc778", "\ubc30\uc218\uc9c4", "\uc785\ubc95\uad8c"]
출처: https://kugancity.tistory.com/entry/한국어-뉴스-데이터로-딥러닝-시작하기-5-한국어-word2vec-데모-사이트-만들기 [you've got to find what you love.]
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
