스파크 Spark - 윈도우10에서 빅데이터 실습 세팅 및 시작하기

해당 게시글은 BetterThanWholwas 블로그를 참조해서 다시 정리한 게시글입니다.

스파크와 스칼라에 관심이 있다면, 메뉴얼 등을 업데이트 중인 저의 사이트를 참조해주세요

​

윈도우에서 빅데이터 실습을 해야하는 이유는 다음과같습니다.

1. 하둡을 세팅하기엔 너무 어렵습니다.

2. 리눅스도 마찬가지입니다.

​

빅데이터는 뭔지 해보고싶은데, 설치나 플랫폼에 따라 에러 등에 이리 치이고 저리 치여서 실습조차 못하게될수있습니다.

스칼라나 파이썬 자바 등을 이용해서, 윈도우 싱글 클러스터 환경으로 재밌게 실습을 해봅시다.

​

스파크(SPark)란?

클러스터용 연산플랫폼이다.
맵리듀스 모델을 대화형 명령어 쿼리와 스트리밍 처리 등이 가능하도록 확장한것이다 연산은 메모리에서 수행하기떄문에,
속도가 빠르며,
하둡 클러스터 위에서도 실행가능하다 카산드라를 포함한 어떤 하둡데이터 소스에도 접근이가능하다. -
Source from, O'REILLY, Learning Spark -

Window Spark 실습환경

​

실습환경
1. OS Window 10
2. Other java 1.8.0_201 spark-2.4.6 hadoop 2.6
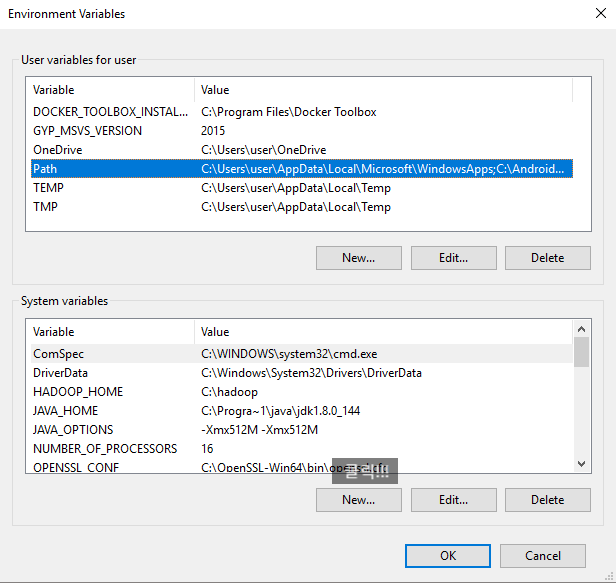
3. 환경변수(시스템 변수)
SPARK_HOME (C:\spark-2.4\bin)
SCALA_HOME (C:\scala\bin)
JAVA_HOME (C:\Progra~1\java\jdk1.8.0_144)
HADOOP_HOME (C:\hadoop)
JAVA_OPTIONS (-Xmx512M -Xmx512M)

Window Spark 세팅(자바, 스칼라, 스파크, 하둡 등)

1. java 설치 1.8 이상 버전 JDK 설치 (왜냐하면 람다식을 지원해야된다. 그래서 무조건 1.8이상)
(https://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html)
2. Scala 설치 c:\scala 로 경로설정해서 설치하기 (중간에 경로 띄어쓰기 있으면 에러남)
(https://www.scala-lang.org/download/)
3. Spark 설치
3.1. hadoop 2.6에 맞춰서 download
(http://spark.apache.org/downloads.html) 3.2. c:\spark-2.4 (중간에 경로 띄어쓰기 있으면 에러남)
4. Hadoop (하둡을 사용안하기때문에, 이 작업이 필요함)
4.1. 해당 사이트를 방문 (https://github.com/steveloughran/winutils)
4.2. 원하는폴더
  (예 : 다운로드)에 가서 git clone https://github.com/steveloughran/winutils.git
*** git 설치가 안되있으면 수동으로 사이트에서 압축파일 다운 후 해제 ***
4.3. 다운받거나 압축해제 후 winutils\hadoop-2.6.4\bin 폴더에 있는 winutils.exe 복사하기
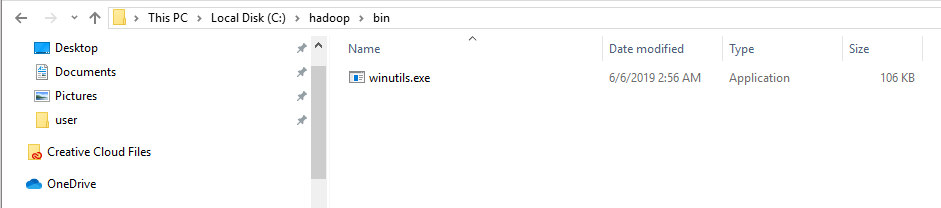
4.4. C:\hadoop\bin 폴더만들고, 위에 복사한 winutils.exe 붙여넣기
5. 환경변수 설정 (시스템 변수 클릭 후 추가)
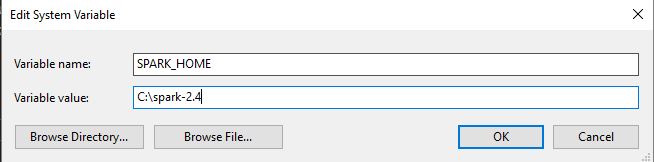
SPARK_HOME C:\spark-2.4\bin
SCALA_HOME C:\scala\bin
JAVA_HOME C:\Progra~1\java\jdk1.8.0_144
(스파크는 중간에 띄어쓰기경로 있으면 에러남, 본인 버전에 맞게)
HADOOP_HOME C:\hadoop
JAVA_OPTIONS -Xmx512M -Xmx512M
6. spark-shell
6.1 cmd(명령프롬프트)창을 연다
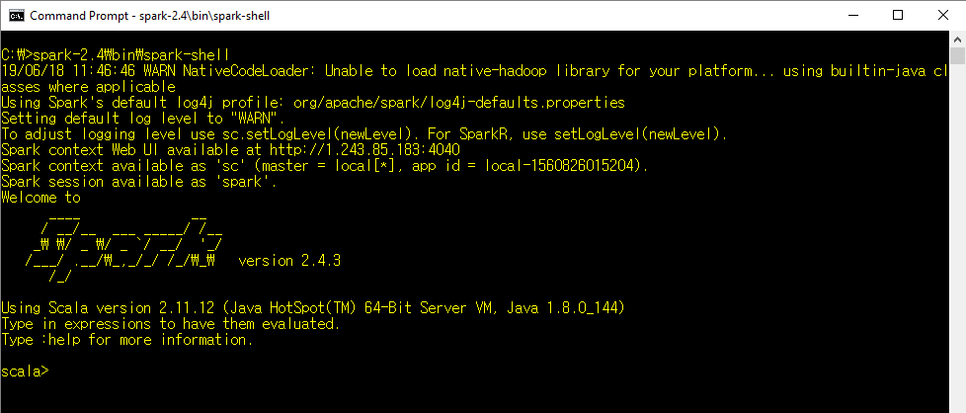
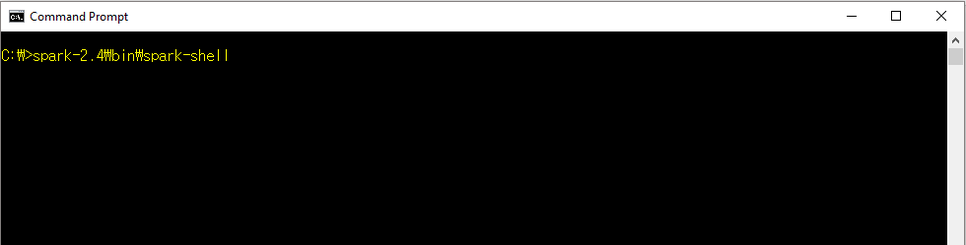
6.2 c:\로 이동한뒤, spark-2.4\bin\spark-shell 기입후 Enter
(또는 c:\spark-2.4\bin\로 이동한뒤, spark-shell 기입후 Enter)
(에러 발생시 100% 경로문제) 4.5으로 돌아가서
SPARK_HOME, SCALA_HOME 경로에 bin을 제거 혹은 추가(C:\scala, C:\spark-2.4 변경)
기존 자바 사용자는 시스템 변수가 아닌 사용자 변수에 등록된 path 경로 확인후 bin 추가 혹은 제거
(예 : C:\Progra~1\java\jdk1.8.0_144, C:\Progra~1\java\jdk1.8.0_144\bin)

​

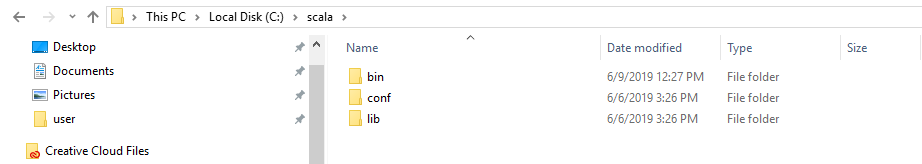
설치완료시 폴더 구성

​

c:\scala

경축! 아무것도 안하여 에스천사게임즈가 새로운 모습으로 재오픈 하였습니다.
어린이용이며, 설치가 필요없는 브라우저 게임입니다.
https://s1004games.com

c:\spark-2.4

c:\hadoop\bin

설정완료 후 환경변수 화면

*** 초기설정 후 spark-shell이 안되면, 재부팅해보고 안되는경우, 경로에 bin을 제거하거나 추가하고 cmd창을 껐다키면됨

*** spark-shell이 잘되다가 컴퓨터를 재부팅했는대 안되는경우, 경로에 bin을 제거하거나 추가하고 cmd창을 껐다키면됨

*** 그래도 잘 안되는경우, 사용자변수 Path에 등록된 자바도 하단의 JAVA_HOME과 동일하게 해주던지, 삭제
스파크 Spark 실행 (spark-shell)

​

아래 세팅이 완료되면 명령프롬프트로 c:\spark-2.4\bin\로 이동한뒤, spark-shell 로 진행하면됩니다.
​

​

웹브라우저(localhost:4040) 확인가능


본 웹사이트는 광고를 포함하고 있습니다.
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
번호 제목 글쓴이 날짜 조회 수
공지 오라클 기본 샘플 데이터베이스 졸리운_곰 2014.01.02 90568
공지 [SQL컨셉] 서적 "SQL컨셉"의 샘플 데이타 베이스 SAMPLE DATABASE of ORACLE 가을의 곰을... 2013.02.10 82233
공지 [G_SQL] Sample Database 가을의 곰을... 2012.05.20 98896
905 [spark] Spark RDDs vs DataFrames vs SparkSQL file 졸리운_곰 2021.03.06 1543
904 [spark] Spark 튜닝하기 file 졸리운_곰 2021.03.06 1350
903 [spark] PySpark와 pandas 데이터 프레임 간의 변환 최적화 file 졸리운_곰 2021.03.04 1754
902 [데이터사이언스] 데이터 과학자를위한 3 가지 훌륭한 디자인 패턴, 3 Great Design Patterns for Data Scientists file 졸리운_곰 2021.03.04 803
901 [hadoop] Python으로 Hive 연결하기 졸리운_곰 2021.03.04 1512
900 Data Engineering - Apache Spark Dataframe 10분만에 훑어보기 졸리운_곰 2021.03.04 1935
899 [데이터분석] 시계열 데이터에 AI를 사용하는 이유는 무엇입니까? file 졸리운_곰 2021.02.28 1255
898 [데이터분석] AI 예측 및 이상 탐지를위한 시계열 데이터 전처리 file 졸리운_곰 2021.02.28 1098
897 [hadoop][java][MapReduce] 맵리듀스 원리와 그 과정 졸리운_곰 2021.02.28 1676
896 [데이터분석] bitcoin analysis 비트 코인 시계열 데이터에 대한 AI 이상 탐지 file 졸리운_곰 2021.02.27 1684
895 [spark] pyspark 설치하기 (windows 10) file 졸리운_곰 2021.02.26 1718
894 [hadoop][mapreduce][csv file] [Reference] : Hadoop MapReduce Join & Counter with Example file 졸리운_곰 2021.02.23 1566
893 [hadoop][mapreduce][csv file] Hadoop & Mapreduce Examples: Create First Program in Java file 졸리운_곰 2021.02.23 1870
892 [mongodb , 몽고디비] How to Use MongoDB Comparison Query Operators in Java 졸리운_곰 2021.02.19 1528
891 Apache Spark란? 졸리운_곰 2021.02.19 1596
890 [apache spark] [Spark Programming]1. Apache Spark 개요 및 설치 file 졸리운_곰 2021.02.19 19679
889 [Oracle, 오라클 데이터베이스] java.sql.SQLException: ORA-00911: 문자가 부적합합니다. file 졸리운_곰 2021.02.19 1070
888 [mongodb, 몽고디비] How do you query for “is not null” in Mongo? 졸리운_곰 2021.02.19 1302
» 스파크 Spark - 윈도우10에서 빅데이터 실습 세팅 및 시작하기 file 졸리운_곰 2021.02.17 1361
886 스파크(Spark) 3.0.0 설치 on Windows 10 file 졸리운_곰 2021.02.17 1660
대표 김성준 주소 : 경기 용인 분당수지 U타워 등록번호 : 142-07-27414
통신판매업 신고 : 제2012-용인수지-0185호 출판업 신고 : 수지구청 제 123호 개인정보보호최고책임자 : 김성준 sjkim70@stechstar.com
대표전화 : 010-4589-2193 [fax] 02-6280-1294 COPYRIGHT(C) stechstar.com ALL RIGHTS RESERVED