
[ 一日30分 인생승리의 학습법] 당신이 알아두어야 할 10가지 머신러닝 알고리즘
2023.11.24 02:53
[ 一日30分 인생승리의 학습법] 당신이 알아두어야 할 10가지 머신러닝 알고리즘
우리는 빠르게 변하는 세상에 살고 있습니다. 이런 빠른 혁신을 이뤄낼 수 있었던 것은 컴퓨터와 그 활용에 대한 발전이 있었기 때문이라는 것을 부정할 수 없습니다. 최근에는 발전된 컴퓨터의 성능을 바탕으로 빅데이터 분석, 클라우드 컴퓨팅 등 여러 산업계에도 변화를 주고 있다는 것을 몸소 체감할 수 있습니다. 특히 머신러닝과 인공지능은 세간의 주목을 받으며 빠르게 발전하고 있습니다. 이번 포스팅에서는, 머신 러닝이 사람의 뇌를 모방하고, 더 앞서가기 위해서 만들어진 최신 알고리즘들에 대해서 알아보고자 합니다.
우선, 머신러닝 알고리즘은 크게 세 가지로 분류할 수 있습니다.
1. 지도학습 알고리즘(Supervised Algorithms)
의도하는 결과가 있을 때 사용합니다. 학습을 하는 동안 모델은 입력으로 들어온 값으로 변수를 조정해서 출력에 매핑합니다.
2. 비지도학습 알고리즘(Unsupervised Algorithms)
의도하는 결과가 없을 때 사용합니다. 입력 데이터 집합을 비슷한 유형의 집합으로 분류합니다.
3. 강화학습 알고리즘(Reinforcement Algorithms)
결정을 내리도록 할 때 사용합니다. 결정을 했을 때의 성공/실패에 따라 주어진 입력값에 대한 결정이 점차 달라집니다. 학습을 할수록 입력에 대한 결과 예측이 가능하게 됩니다.
알고리즘의 큰 분류 체계를 정리했으니, 이제부터는 세부적인 알고리즘들로 넘어가보겠습니다. 예제로 주어지는 코드들은 모두 파이썬으로 작성되었습니다.
1. 선형 회귀(Linear Regression)
선형 회귀 알고리즘은 데이터 모델에 가장 적합한 선을 찾기 위해 데이터의 점들을 사용합니다.
이 선은 y = mx + c라는 방정식으로 나타낼 수 있는데, 여기서 y는 종속변수dependent variable를 나타내며, x는 독립변수independent variable를 나타냅니다. m과 c은 주어진 데이터셋을 기초적인 미적분을 사용해서 찾습니다.
선형회귀는 두 가지 종류로 분류할 수 있는데, 독립변수가 하나만 사용되는 단순 선형회귀simple linear regression와 독립변수가 여러개 사용되는 다중 선형회귀multiple linear regression로 분류할 수 있습니다.
파이썬으로 머신러닝을 할 때 간단하고 효과적으로 사용할 수 있는 도구로 "scikit-learn"이라는 프로그램이 있습니다. 다음 코드는 scikit-learn을 사용해 선형회귀를 구현해 놓은 것입니다.
2. SVM(Support Vector Machine)
SVM은 분류 알고리즘의 한 종류입니다. SVM은 각 데이터의 점들을 선을 사용해서 구분지으며, 이 선은 데이터의 범주를 구분지을 수 있는 가장 가까운 2개의 데이터의 점을 기준으로 만들어집니다.
이 그래프에서는 빨간 선(H3)이 가장 가까운 데이터의 점이 알맞은 거리에 있기 때문에 두 개의 범주를 구분짓는 가장 확실한 선이라고 할 수 있습니다.
3. KNN(K-Nearest Neighbors)
데이터가 무작위로 주어졌을 때, 인접한 k개의 영역에서 데이터의 종류를 예측하는 간단한 알고리즘입니다. k값은 예측의 정확도에 대한 중요한 인자입니다. 유클리드 거리 공식처럼 가까운 거리를 구하는 함수를 사용하여 가장 가까운 데이터의 집합을 판단합니다.
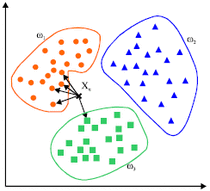
하지만 이 알고리즘은 모든 데이터 지점을 동일한 범위로 가져가기 위해 데이터를 초기에 표준화해야 하며, 이에 따라 계산이 많이 필요하기 때문에 컴퓨터의 성능이 좋아야 합니다.
4. 로지스틱 회귀(Logistic Regression)
조심스럽고 신중한 결정이 필요할 때 사용합니다. 일반적으로 로지스틱 회귀는 손실이 최소화되도록 특정 집합으로 값을 맞추기 위해 일정한 함수를 사용합니다.
시그모이드 함수는 둘 중 하나의 값을 결정하며, S자 곡선 모양을 가지는 곡선 함수 중 하나입니다. 이는 발생한 사건의 확률을 0부터 1까지의 범위로 표현해야 할때 값을 변환하기 위한 함수로 사용합니다.
y = eb0 + b1x / 1 + eb0 + b1x


이 수식은 b0와 b1이 상수일 때의 간단한 로지스틱 회귀 방정식입니다. 학습 값은 예측과 실제 값 사이의 오차가 최소가 되도록 계산됩니다.
5. 의사결정 트리(Decision Tree)
이 알고리즘은 개체군에서 선택된 속성(독립 변수)을 기반으로 여러 집합에 대한 개체군을 분류합니다. 대개 이 알고리즘은 지니Gini, 카이-제곱Chi-square, 엔트로피entropy 등과 같은 방법을 사용하여 분류 문제를 해결합니다.
의사 결정 트리 알고리즘을 사용하여 누가 신용 카드를 갖고 싶은지 알아보고 개체군을 나눠보도록 하겠습니다. 예시로 연령과 결혼 상태를 기준으로 개체군의 속성을 고려해서 개체군을 분류해 보겠습니다. 나이가 30세 이상이거나 결혼을 한 경우에는 신용 카드를 더 선호하는 경향이 있습니다.
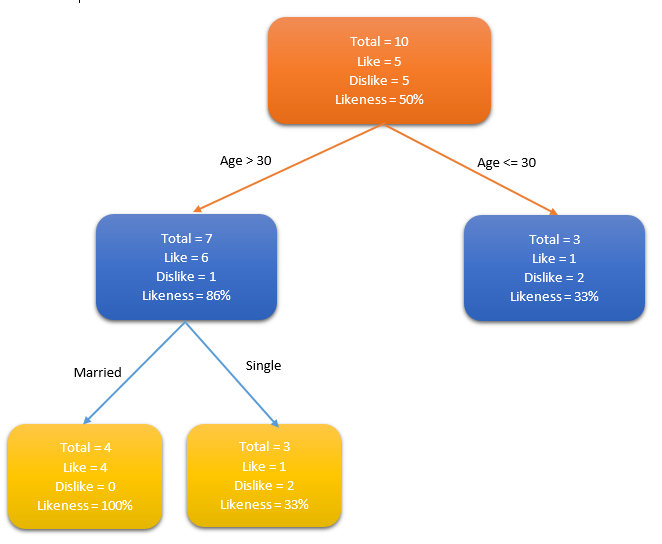
의사결정 트리는 더 많은 개체군을 분류하기 위해서 다른 특성을 가지고 더 확장해 나갈 수 있습니다. 이 예시에서, 결혼을 했으며 30세가 넘으면 신용 카드를 가질 확률이 높습니다(100% 선호). 테스트 데이터는 이 의사결정 트리를 만드는데 사용됩니다.
6. K-평균(K-Means)
클러스터링 문제에 대한 솔루션을 제공하는 비지도학습 알고리즘입니다. 이 알고리즘은 동일한 종류의 데이터 지점들homogeneous data points이 포함된 클러스터를 형성하는 절차를 따릅니다.
이 절차에 대해서 하나씩 다뤄보자면, 우선 k개의 중심점들centroids를 선택해서 이웃하는 데이터가 중심점을 가리키면 중심점과 결합하여 클러스터를 만듭니다. 결합을 후에는 각 클러스터 내에 새로운 중심이 생성됩니다. 그러면 새로운 중심에 가까운 데이터 중심점이 다시 결합하어 클러스터가 확장됩니다. 이 과정은 중심점이 바뀌지 않을 때까지 계속됩니다.

7. Random Forest
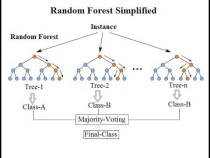
이 알고리즘은 의사결정 트리의 한 종류로 구분될 수 있습니다. 각각의 트리는 개별적으로 종류를 추정하며 이를 투표vote라고 합니다. 이상적으로는, 모든 트리의 각 선택를 고려해서 가장 많이 선택된 분류를 고릅니다.
8. Naive Bayes
이 알고리즘은 베이즈 정리Bayes' Theorem에서의 확률을 기반으로 합니다. Naive Bayes는 베이즈 정리의 요구 사항이기 때문에 각 기능이 서로 독립적인 경우에만 적용 할 수 있습니다. 예를 들자면, 꽃잎의 길이와 너비로 꽃의 종류를 예측하려고하면 두 가지 특징이 모두 독립적이기 때문에 Naive Bayes 방식을 사용할 수 있습니다.

Naive Bayes 또한 비지도학습 알고리즘에 속하며, 문제를 풀면서 많은 클래스가 필요할 때 주로 사용됩니다.
9. Dimensional Reduction Algorithrm
일부 데이터셋은 처리하기 어려울 정도로 변수를 많이 포함하고 있을 수 있습니다. 특히 최근에 시스템으로부터 발생하는 데이터들은 너무 세부적인 수준까지 수집합니다. 이 경우 수집된 데이터셋에는 수천 개의 변수가 포함될 수 있으며 그 중 대부분은 불필요합니다.
하지만 이 경우 예측에 가장 큰 영향을 미치는 변수를 식별하는 것은 거의 불가능합니다. 차원 축소 알고리즘은 이런 상황에서 사용할 수 있습니다. 이 때는 Random Forest, 의사결정 트리와 같은 다른 알고리즘을 활용하여 가장 중요한 변수를 식별할 수도 있습니다.
10. Gradient Boosting Algorithm
Gradient Boosting Algorithm은 여러 가지 약한 알고리즘을 사용하여 더욱 강력한 알고리즘을 만듭니다. 하나의 알고리즘을 사용하는 대신 여러 개를 사용하면보다 보다 안정적이고 강력한 알고리즘을 만들 수 있습니다.
Gradient Boosting Algorithms은 여러 가지 종류가 있습니다. 그 중 일부를 소개하자면, 다음과 같은 것들이 있습니다.
XGBoost - 선형 알고리즘과 트리 알고리즘 모두 사용
LightGBM - 트리 기반 알고리즘만 사용
Gradient Boosting Algorithms은 더 정확한 결과를 보여주며, LightGBM과 같은 알고리즘은 엄청난 성능을 보장합니다.
참고자료
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
