
[인공지능 기술] 인공지능이 ‘할 수 있는 것’과 ‘할 수 없는 것’---전문가들 “AI특이점 온다”
2023.12.07 00:47
[인공지능 기술] 인공지능이 ‘할 수 있는 것’과 ‘할 수 없는 것’---전문가들 “AI특이점 온다”
인공지능이 ‘할 수 있는 것’과 ‘할 수 없는 것’---전문가들 “AI특이점 온다”
- 안재석 기자
- 승인 2022.10.21 21:50
[오피니언] 이상윤 알서포트 AI팀 팀장
인공지능(Artificial Intelligence, AI)은 무엇일까? 새삼스럽게 AI에 대한 엄밀한 정의를 좇기 보다는 ‘기존의 데이터에서 패턴을 찾아낸 후 새로운 데이터가 암시하는 바를 예측하는 컴퓨터 기술’ 정도로 설명해도 무방하지 않을까 싶다.
일반적으로 기대하는 정의와 사뭇 달라서 실망스러울 수도 있겠지만 아직까지 AI는 이 정도 수준이다. 따라서, 인공지능의 범주 안에서 패턴을 찾거나 예측하는 과정에서 인공신경망을 사용하면 딥러닝(deep learning), 인공신경망 외의 기법을 사용하면 머신러닝(machine learning)이라고 표현하면 큰 무리가 없을 것 같다.
1940년도 후반 컴퓨터가 발명되면서 과학자들은 흥분하여 이것이 어디까지 발전할 수 있을 것인지 이론적으로 검증하려는 많은 시도를 했다. 영화 '이미테이션 게임'의 실존 인물인 앨런 튜링(Alan Turing)도 그 중의 하나다. 종종 '최초의 해커'로 언급되기도 하는 앨런 튜링은 20세기 초 영국 출신의 수학자이자 암호학자로, 그의 이름을 딴 튜링 상(Turing Award)은 지금도 컴퓨터 사이언스 분야에서 노벨상만큼이나 영예롭게 여겨 진다.
지금의 딥러닝 모델의 효시인 ‘퍼셉트론(perceptron)’을 제안한 로젠블라트(Frank Rosenblatt)는 한 발 더 나가서 몇 년 안에 기계가 사람처럼 걸어 다니면서 생각할 수 있게 될 것이라고 할 정도였다. [그림 1]은 그의 저서에서 발췌한 내용으로, "퍼셉트론은 도보에 서서 지나가는 모든 여자를 지켜볼 것이다"라고 기대하고 있다.
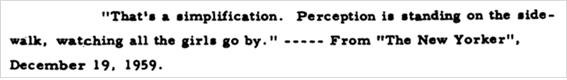
[그림 1] 퍼셉트론 소개 서문. (출처: “Principles of Neurodynamics: Perceptrons and the Theory of Brain Mechanisms”, 1962년)
그렇지만 그 당시 예상과 달리 AI의 1차, 2차 겨울은 2012년까지, 무려 50년간이나 지속되었다. <빅데이터 사용설명서(2022년)>의 저자 김진호 교수는 사람이 잘하는 것은 컴퓨터가 못하고, 사람이 잘 하지 못하는 것은 컴퓨터가 못한다고 명쾌하게 설명하고 있다. 오랜 역사를 통해 내재된 사람의 지식이나 행동패턴은 컴퓨터가 흉내내기 힘들다는 것이다. 반면, 최근에 축적된 지식을 처리하는 일은 사람이 컴퓨터를 따라하기가 어렵다.
◇ AI가 할 수 없는 것들
“시간 파리는 화살을 좋아해”
꽤 많은 사람들이 위의 문장을 기억할 것이다. 위의 문장은 “Time flies like an arrow(시간은 화살같이 날아간다)”라는 영어 문장의 컴퓨터 번역으로, 불과 몇 년 전 까지만 하더라도 국내외 유명 번역 서비스들은 이 정도의 번역 결과를 보여주곤 했다. 인간은 오랜 역사를 거치면서 습득한 정보를 언어에 함축해 놓았다. 이를 컴퓨터로 처리하는 과정을 흔히 ’자연어 처리(NLP; Natural Language Processing)’ 라고 하는데, 이 과정에서 정보 손실과 왜곡이 발생하기 마련이다.
AI 기술이 많이 발전했다고 하더라도 NLP 작업은 여전히 컴퓨터에게 버거운 일일 수밖에 없다. 예전과는 다르지 않을까 의구심이 든다면, 지금 번역 서비스에 “Retrieving information is sometimes easier said than done.” 이라는 문장을 입력해보자. 제대로 번역된다면 “정보 검색은 때로 말처럼 쉽지 않다”라는 결과를 보여주겠지만, 유명 번역 서비스라 해도 분명 기대와는 사뭇 다른 결과물을 보여줄 것이다.
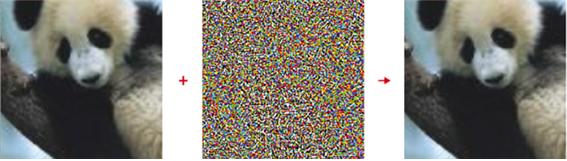
[그림 2] 원본 이미지(왼쪽)와 잡음(noise) 데이터(가운데)의 합성 사진(오른쪽) (출처: Why deep-learning AIs are so easy to fool, 2019년)
[그림 2]는 AI의 한계를 보여주는 두 번째 사례다. [그림 2]의 왼쪽에는 판다(panda)를 찍은 사진의 원본 이미지고, 가운데는 일종의 잡음(noise) 이미지이다. 원본 판다 이미지와 잡음 이미지를 혼합한 합성한 결과가 오른쪽에 있는 이미지인데, 사람의 눈으로는 아무리 살펴 보아도 원본 이미지와 합성 이미지를 구분할 수 없다. 그런데 AI, 구체적으로 딥러닝 모델이 [그림 2]의 왼쪽 사진을 판다라고 정확히 인식한 반면, 오른쪽의 이미지를 긴팔원숭이(gibbon)이라고 잘못 판단을 하는 경우가 있었다.
또 다른 사례는 미국의 온라인 부동산 중개회사 질로우(Zillow)의 최고분석책임자(CAO, Chief Analytics Officer) 사례다. 질로우는 주택을 중개하는 과정에서 대규모 데이터를 수집하게 됐다. 2021년경에 약 1억1천만 주택의 데이터를 보유하게 된 질로우는 이를 기반으로 주택 가격을 예측하는 AI 모델 '제스티메이트(Zestimate)'를 구축했다. 질로우는 주택 가격을 예측하는 이 AI 모델을 활용해 미국의 주택을 매입한 후 개보수(house-flipping)하여 되파는 사업모델을 추진하였다. 문제는 개보수 작업은 보통 6개월 정도 걸리는데, 주택 매입시점과 판매시점의 차이에 대한 예측 실패로 큰 손실을 보게 된 것이다. 그 결과로 질로우는 전 직원 8천여 명 중 20%를 감원하고 2021년 3/4분기에 420만 달러(한화 약 59억원)의 손실을 안는다.
◇ AI가 잘하는 것들
위의 사례만 보면 AI가 별로 신통하지 못한 것 같지만, 주위를 돌아보면 AI가 사용되지 않은 분야는 거의 없다. 많은 사람들이 이 순간에도 AI 기반의 번역 서비스를 활용해 업무를 수행하고 있으며, 심지어 차량번호를 외우지 못해서 휴대전화에 저장된 사진을 대상으로 ‘차량번호’라고 검색하여 자신의 자동차가 찍힌 사진에서 차량번호를 확인하기도 한다.


AI가 잘하는 많은 것에 대해서는 차후에 하나씩 살펴보기로 하고, 이 글에서는 ‘초거대 AI’ 모델 중 주어진 문장을 기반으로 이미지를 생성하는 모델(Text-to-Image 모델)에 적용한 사례 정도만 소개한다. 아래와 같은 문장(프롬프트)을 예로 들어보자(<*출처: Google’s 20 Billion Parameter AI Image Generator Is Insane, 2022년>).
A photo of an astronaut riding a horse in the forest. There is a river in front of them with water lilies.
(숲에서 말을 타고 있는 우주 비행사의 사진이 있는데, 그 앞에 수련이 있는 강이 있다)
위의 문장이 주어지면 AI모델의 규모가 커질수록 [그림 3]과 같이 정교한 이미지가 생성된다. [그림 3]의 네 개 이미지 위의 숫자는 각 AI 모델의 내부 파라미터(parameter) 개수로, 350M(3억5천만 개), 750(7억천만 개), 3B(30억 개), 20B(200억 개)을 의미한다.
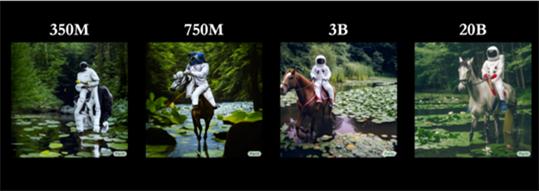
[그림 3] AI 모델의 규모에 따른 이미지 품질의 변화 (출처: Google’s 20 Billion Parameter AI Image Generator Is Insane, 2022년)
텍스트 기반의 이미지 생성 모델은 AI 기술을 내세우는 기업마다 결과가 다를 수 있다. [그림 4]는 아래 문장에 대해 각각 구글의 Parti, 오픈AI의 Dall-E2, MidJourney AI가 생성한 이미지들이다.
A dignified beaver wearing glasses, a vest, and colorful necktie. He stands next to a tall stack of books in a library. DSLR photo.
(안경을 쓰고 조끼를 입고 화려한 넥타이를 매고 있는 근엄한 비버가 도서관에서 높이 쌓은 책 더미 옆에 서있는 DSLR 사진)
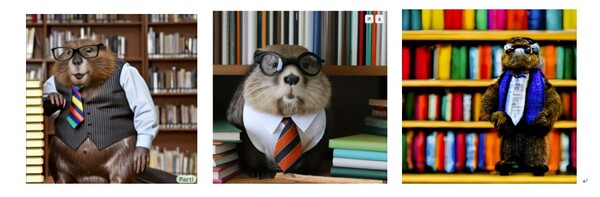
[그림 4] (왼쪽부터) 구글, 오픈AI, MidJourney의 AI 모델이 생성한 이미지 (출처: Google’s 20 Billion Parameter AI Image Generator Is Insane, 2022년)
물론, 초거대 AI도 현실 적용면에서 한계가 있다. 그럼에도 불구하고 위 사례를 통해 AI의 가능성을 충분히 엿볼 수 있다.
◇ 전문가들, “AI 특이점 도래할 것”
현재 AI의 발전 수준은 약한 인공지능(weak-AI)이다. 사람이 시키니까 학습을 하는 것이고, 사람이 예측을 하라고 하니 예측을 할 뿐이다. 엄밀하게 말하면 학습은 AI 모델의 내부 파라미터를 조정하는 과정이다. 흔히 AI가 “스스로 학습한다”는 표현을 하는데, 이는 잘못된 표현인 셈이다. 앞서 언급한 <빅데이터 사용설명서>라는 책에서 언급된 것처럼, 알파고는 바둑을 두는 시간에 자신이 바둑을 둔다는 사실조차 모르는 것이다. 그러나 많은 전문가들은 시간의 문제일 뿐, 강한 인공지능(strong-AI), 또는 범용AI(AGI, Artificial General Intelligence)가 나타나는 특이점(singularity)이 도래할 것으로 예상하고 있다.
[출처] https://www.hitech.co.kr/news/articleView.html?idxno=13160
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
