[C++ 인공지능] C ++을 이용한 단순 MLP 역 전파 인공 신경망 (단계 별)


C ++를 사용한

f (x) = sin (x) 를 근사화하는 매우 간단한 역 전파 신경망 알고리즘 구현

​

소개

​

신경망은 기계 학습 방법에서 가장 유행하는 솔루션 중 하나입니다.

​

이 방법은 정확한 솔루션이없는 문제에 매우 유용합니다.

​

최근에는 이러한 메소드의 인기가 높아지면서 Matlab, Python, C ++ 등에서 많은 라이브러리가 개발되었습니다.

​

훈련 세트를 입력으로 받고 가정 된 문제에 적합한 신경망을 자동으로 구축합니다.

​

또한 고속 CPU와 GPU, 그리고 심층 신경망과 신경망 계산에 정확히 최적화 된 NPU가 더 많이 개발됨으로써 매일 성장하고 있습니다.

​

그러나 이러한 라이브러리를 사용함으로써 때때로 우리는 정확히 무슨 일이 일어 났는지, 그리고 네트워크이 어떻게 최적화 되는 지에 대해서 정확히 이해하지 못합니다.

​

솔루션의 기본을 아는 것은 고전적인 방법들을 개발하는 데 매우 중요합니다.

​

따라서이 기사에서는 f (x)) (= sin (x)를 근사화하기위한 신경망 알고리즘의 매우 간단한 구조를 설명하면서 C ++로 차근차근 구현 해 봅시다.

​

배경

​

가장 성공적이고 유용한 신경망 중 하나는

Feed Forward Supervised Neural Networks 또는 Multi-Layer Perceptron Neural Networks (MLP)라고 합니다.

​

이러한 종류의 신경망에는 다음과 같은 세 부분이 포함됩니다.

​

1. Input Layer(입력 레이어)

2. Hidden Layers(은닉 레이어)

3. Output Layer(출력 레이어)

​

각 계층에는 네트워크의 다른 뉴런에 연결되는 뉴런이라는 여러 노드가 있습니다. 모든 신경망에는 다음과 같은 5 가지 중요한 속성이 있습니다.

​

1. Number of input nodes(입력 노드 수)

2. Number of nodes per hidden layer(은닉층 당 노드 수)

3. Number of output nodes(출력 노드 수)

4. Number of hidden layers(은닉 레이어 수)

5. The learning rate(학습률)

​

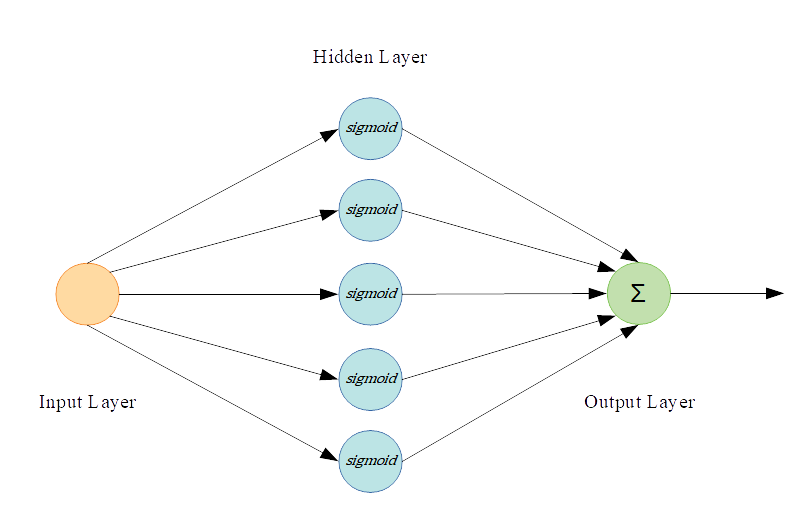
이 예에서는 은닉레이어 1 개와 은닉레이어에 5 개의 뉴런이있는 MLP 신경망을 사용합니다. 다음의 식으로 정의 된 \ (sigmoid \) 함수를 각 노드 활성화 함수로 사용할 것입니다.


다음 그림은 사용 된 신경망 구조를 보여줍니다.

여기서 x는 입력 벡터,


는 은닉레이어의 출력이며,


는 이 예제에서


의 근사치가되는 신경망의 주요 출력입니다.
이 고전적인 예제의 손실 함수는 다음과 같이 제곱 오차 일 수 있습니다.

​

그리고 훈련 함수는 다음과 같습니다.

여기서


는 t 번째 훈련 입력입니다.

경축! 아무것도 안하여 에스천사게임즈가 새로운 모습으로 재오픈 하였습니다.
어린이용이며, 설치가 필요없는 브라우저 게임입니다.
https://s1004games.com

​

신경망의 주요 목표는 W, V, b, c 매개 변수를 업데이트하여 이 비용 함수를 최소화하는 것입니다.

​

마지막으로 이 예제의 고전적인 훈련 절차는 경사 하강 법으로,

다음과 같이 매개 변수 W, V, b, c를 반복적으로 업데이트합니다.

​

코드 만들기

​

제안 된 신경망을 훈련하려면 데이터가 필요합니다.

훈련 세트는 매우 중요하며, 일반 훈련 세트는 더 나은 근사치로 이어집니다.

예를 들어, 여기서는 범위 [0, 2π]를 Train_Set_Size 부분으로 나누고 신경망에 훈련 세트로 제공합니다.

#define Train_Set_Size 20 #define PI 3.141592653589793238463 ... vector<pair<double, double>> trainSet; trainSet.resize(Train_Set_Size); for (int i = 0; i < Train_Set_Size; i++) { trainSet[i] = make_pair(i * 2 * PI / Train_Set_Size, sin(i * 2 * PI / Train_Set_Size)); } ...

​

시그 모이 드 함수는 C ++ 표준 함수가 아니므로 시그 모이 드를 계산하는 함수를 정의해야만 합니다.

 
... double sigmoid(double x) { return (1.0f / (1.0f + std::exp(-x))); } ...

​

또, 우리는 각 반복 마다,


를 계산하는 함수가 필요 합니다.

 
... double f_theta(double x) { double result = b; for (int i = 0; i < N; i++) { result += V[i] * sigmoid(c[i] + W[i] * x); } return result; } ...

여기서

x는 1x1 입력 트레인 값,

W는 1x1 (벡터 포함),

c는 각 뉴런의 오프셋에 대한 스케일러 값이지만

단순성을 위해 모든 노드 오프셋 값을 1x5 배열에 저장하고 마지막으로 b는 출력 노드 오프셋입니다.

코드 시작 부분에 이러한 변수를 다음과 같이 정의합니다.

#define N 5 ... double c[N] = {}; double W[N] = {}; double V[N] = {}; double b = 0; ...

앞서 언급했듯이 각 반복에서 W, V, b, c 매개 변수를 업데이트해야합니다. W에 대한 기울기를 계산하여 매개 변수 W의 경우 다음과 같이됩니다.

... for (int i = 0; i < N; i++) { W[i] = W[i] - epsilon * 2 * (f_theta(x) - y) * V[i] * x * (1 - sigmoid(c[i] + W[i] * x)) * sigmoid(c[i] + W[i] * x); } ...

나머지 매개 변수는 다음과 같이 계산할 수 있습니다.

V:

... for (int i = 0; i < N; i++) { V[i] = V[i] - epsilon * (f_theta(x) - y) * sigmoid(c[i] + W[i] * x); } ...

b:

... b = b - epsilon * (f_theta(x) - y); ...

c:

... for (int i = 0; i < N; i++) { c[i] = c[i] - epsilon * (f_theta(x) - y) * V[i] * (1 - sigmoid(c[i] + W[i] * x)) * sigmoid(c[i] + W[i] * x); } ...

이제 각 훈련 데이터에 대해 신경망 매개 변수를 업데이트해야하지만 대부분의 경우 좋은 결과를 수렴하기 위해 모든 훈련 쌍을 신경망에 여러 번 제공해야합니다.

"Epoch"라 불리는 신경망에 모든 훈련 데이터를 제공 합니다 :

... for (int j = 0; j > epoch; j++) { for (int i = 0; i < Train_Set_Size; i++) { train(trainSet[i].first, trainSet[i].second); } std::cout << j << "\r"; } ...

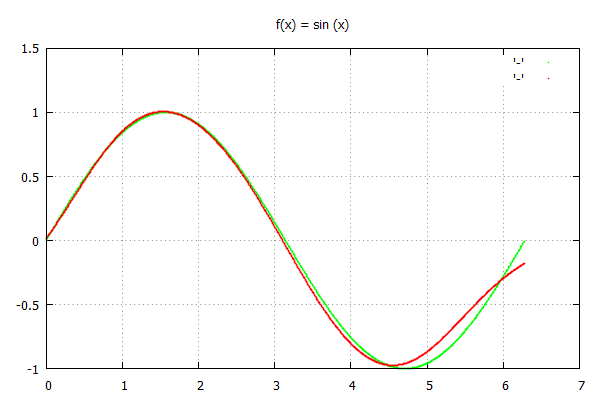
마지막으로 우리는 gnuplot으로 해당 결과를 그려 낼 수 있습니다.

​

전체 소스

#include <iostream> #include <vector> #include <math.h> #include <time.h> using namespace std; #define Train_Set_Size 20 #define PI 3.141592653589793238463 #define N 5 #define epsilon 0.05 #define epoch 50000 double c[N] = {}; double W[N] = {}; double V[N] = {}; double b = 0; double sigmoid(double x) { return (1.0f / (1.0f + std::exp(-x))); } double f_theta(double x) { double result = b; for (int i = 0; i < N; i++) { result += V[i] * sigmoid(c[i] + W[i] * x); } return result; } void train(double x, double y) { for (int i = 0; i < N; i++) { W[i] = W[i] - epsilon * 2 * (f_theta(x) - y) * V[i] * x * (1 - sigmoid(c[i] + W[i] * x)) * sigmoid(c[i] + W[i] * x); } for (int i = 0; i < N; i++) { V[i] = V[i] - epsilon * 2 * (f_theta(x) - y) * sigmoid(c[i] + W[i] * x); } b = b - epsilon * 2 * (f_theta(x) - y); for (int i = 0; i < N; i++) { c[i] = c[i] - epsilon * 2 * (f_theta(x) - y) * V[i] * (1 - sigmoid(c[i] + W[i] * x)) * sigmoid(c[i] + W[i] * x); } } int main() { srand(time(NULL)); for (int i = 0; i < N; i++) { W[i] = 2 * rand() / RAND_MAX -1; V[i] = 2 * rand() / RAND_MAX -1; c[i] = 2 * rand() / RAND_MAX -1; } vector<pair<double, double>> trainSet; trainSet.resize(Train_Set_Size); for (int i = 0; i < Train_Set_Size; i++) { trainSet[i] = make_pair(i * 2 * PI / Train_Set_Size, sin(i * 2 * PI / Train_Set_Size)); } for (int j = 0; j < epoch; j++) { for (int i = 0; i < Train_Set_Size; i++) { train(trainSet[i].first, trainSet[i].second); } std::cout << j << "\r"; } //Plot the results vector<float> x; vector<float> y1, y2; for (int i = 0; i < 1000; i++) { x.push_back(i * 2 * PI / 1000); y1.push_back(sin(i * 2 * PI / 1000)); y2.push_back(f_theta(i * 2 * PI / 1000)); } FILE * gp = _popen("gnuplot", "w"); fprintf(gp, "set terminal wxt size 600,400 \n"); fprintf(gp, "set grid \n"); fprintf(gp, "set title '%s' \n", "f(x) = sin (x)"); fprintf(gp, "set style line 1 lt 3 pt 7 ps 0.1 lc rgb 'green' lw 1 \n"); fprintf(gp, "set style line 2 lt 3 pt 7 ps 0.1 lc rgb 'red' lw 1 \n"); fprintf(gp, "plot '-' w p ls 1, '-' w p ls 2 \n"); //Exact f(x) = sin(x) -> Green Graph for (int k = 0; k < x.size(); k++) { fprintf(gp, "%f %f \n", x[k], y1[k]); } fprintf(gp, "e\n"); //Neural Network Approximate f(x) = sin(x) -> Red Graph for (int k = 0; k < x.size(); k++) { fprintf(gp, "%f %f \n", x[k], y2[k]); } fprintf(gp, "e\n"); fflush(gp); system("pause"); _pclose(gp); return 0; }

주요 요점들

​

1. Epoch의 효과. Epoch를 늘리면 우리는 더 나은 오류 최소화를 수행 할 수 있습니다.

2. 신경망 매개 변수의 초기 값 효과. 경험했듯이 매개 변수의 초기 값으로 0을 선택하면 단순 경사 하강 법이 국소 최소값으로 수렴되므로 언급 된 코드에서 임의의 값이 초기 값으로 선택됩니다.

엡실론 값은 수렴 률에서 매우 중요합니다.

3.작은 엡실론은 조기 수렴을 일으키고 큰 엡실론은 매개 변수를 발산시킵니다.

4. 단순 경사 하강 법은 전역 최소값을 찾는 강력한 방법이 아닙니다.

​

위 그림에서 알 수 있듯이 신경망은 좋은 근사치를 충족하지 않습니다.

​

참고 문헌

[1] Neural networks by Simon Haykin

[2] Deep Learning by Yoshua Bengio-Ian, J. Goodfellow and Aaron Courville (March 30, 2015)

​

이상.

[출처] https://m.blog.naver.com/tommybee/222074665249


본 웹사이트는 광고를 포함하고 있습니다.
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
번호 제목 글쓴이 날짜 조회 수
234 [C/C++ 에서 다른 언어간 연계/호출] Making C++ Talk to Other Languages with SWIG file 졸리운_곰 2022.07.18 375
233 [C 프로그래밍] 파일 출력 함수_3.연결 리스트 저장, 불러오기 졸리운_곰 2022.06.17 328
232 [UBUNTU] 우분투 20.04 USB 스틱에 설치 How to Install Ubuntu on a USB Flash Drive file 졸리운_곰 2022.06.02 482
231 [인공지능] 추론 기법 file 졸리운_곰 2022.05.05 527
230 [C/C++] Modern C++ micro-service implementation + REST API file 졸리운_곰 2022.04.15 277
» [C++ 인공지능] C ++을 이용한 단순 MLP 역 전파 인공 신경망 (단계 별) file 졸리운_곰 2022.04.11 383
228 [linux mater] Linux passwd : 인증 토큰 수정 오류 졸리운_곰 2022.03.04 353
227 [C/C++인공지능] An Introduction to Machine Learning Libraries for C++ file 졸리운_곰 2021.12.06 367
226 [C/C++][tensorflow 1.x] windows C lib : [Tensorflow] How to Install Tensorflow for C API file 졸리운_곰 2021.11.19 403
225 [C/C++][tensorflow] tensorflovw 1.x version 텐서플로우 C 예제 file 졸리운_곰 2021.11.19 546
224 [Visual Studio][boost c++] [C++] boost 설치 및 visual studio 설정 file 졸리운_곰 2021.11.18 470
223 [리눅스 마스터][linux, UNIX] 전설의 라인 에디트 Man page — ED 사용법 졸리운_곰 2021.11.18 357
222 [리눅스 마스터][linux, UNIX] [편집][shell] ed (line editer) 사용예 졸리운_곰 2021.11.17 285
221 [C/C++][gnuplot][수학][MFC] Windows 환경의 C++ 언어에서 gnuplot을 사용한 그래프 출력 2 file 졸리운_곰 2021.11.12 735
220 [C/C++][gnuplot][수학][MFC] Windows 환경의 C++ 언어에서 gnuplot을 사용한 그래프 출력 file 졸리운_곰 2021.11.12 1835
219 [C/C++ 인공지능][linux][cuda] flashlight file 졸리운_곰 2021.11.09 506
218 [C/C++] C++ Basic Input/Output 졸리운_곰 2021.11.06 398
217 [C/C++] Console Input/Output Functions in C file 졸리운_곰 2021.11.05 392
216 [C/C++ 프로그래밍] CMake 예제 졸리운_곰 2021.11.04 241
215 C/C++의 만년, 패키지 매니저 file 졸리운_곰 2021.11.04 295
대표 김성준 주소 : 경기 용인 분당수지 U타워 등록번호 : 142-07-27414
통신판매업 신고 : 제2012-용인수지-0185호 출판업 신고 : 수지구청 제 123호 개인정보보호최고책임자 : 김성준 sjkim70@stechstar.com
대표전화 : 010-4589-2193 [fax] 02-6280-1294 COPYRIGHT(C) stechstar.com ALL RIGHTS RESERVED