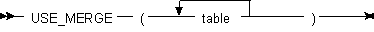SQL HINT 를 이용하여 SQL Tunning 을 하는 방법

SQL 힌트의 사용 방법

●  DBA는 특정 데이터에 대하여 optimizer가 알 수 없는 정보를 가질 수 있음.
●  DBA
는 optimizer보다 더 좋은 execution plan을 선택할 수 있음.
●  DBA
는 힌트를 사용하여 강제적으로 사용자가 선택한 execution plan을 생성하도록                 optimizer에게 지시 가능.


∮ 힌트의 사용


●  힌트의 사용범위

―  SQL문을 위한 Optimization approach
―  SQL
문에 대한 Cost-based approach의 goal(best throughput, best response time)
―  SQL
문에 의해 접근되는 table에 대한 access path
―  join
문에 대한 join순서
―  join
문을 처리하기 위한 join operation


●  Statement Block

― 
간단한 SELECT, UPDATE, DELETE SQL문
― 
한 parent SQL문나 complex SQL문 내의 subquery
― 
한 compound query중의 한 부분


· UNION operator에 의해 조합된 두 개의 component query로 구성한 한 compound query는 두 개의 SQL문 block을 가짐. (각 component query를 위해 하나의 SQL문 block이 생김.)
·
첫 번째 component query에 있는 힌트는 첫 번째 component의 optimizer에만 적용
·
두 번째 component query에 대한 optimizer에는 적용되지 않는다.


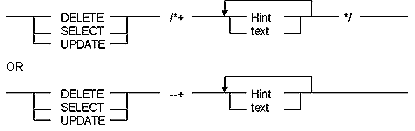
●  힌트를 포함하는 Syntax


·DELETE, SELECT, UPDATE : SQL문 block을 시작하는 DELETE, SELECT, UPDATE 키워드입니다. 힌트를 포함하는 comments는 이 키워드들이 나타난 후에 써야합니다.
·+ :
오라클이 그 comment를 해석할 수 있게 해주는 기능을 합니다. 이 ' + '는 comment 표시 후에 빈칸(blank)이 없이 즉시 따라와야만 합니다.
·
힌트 : 이절에서 언급되는 힌트중의 하나입니다. 만약 comment가 여러 힌트를 가진다면 그 힌트들은 최소한 하나의 공간으로서 분리되어 있어야만 합니다.
·text :
힌트에 대한 설명


●  힌트를 무시하는 경우

―  힌트가 쓰인 comment가 DELETE, SELECT, UPDATE 키워드 뒤에 오지 않고, 다른 곳에 쓰여 있는 경우
―  힌트가 Syntax error를 가진 경우
     (
동일한 comment내에 error를 가지지 않고 올바로 표현된 다른 힌트들은 인정)
― 
충돌한 힌트의 조합들은 무시(한 comment내에 두 개 이상의 힌트가 있을 경우, Optimizer가 어떤 힌트를 먼저 써야하는지 모르는 경우)
      (
동일한 comment내에 충돌한 힌트외에 다른 힌트는 인정.)

·
오라클은 SQL*Forms Version 3 Trigger와 같은 PL/SQL Version1을 사용하는 환경에서는 모든 SQL 문에 있는 힌트들을 무시.
· Optimizer
는 cost-based approach를 사용하는 경우에 힌트를 인식.
·
한 SQL문 block에 RULE 힌트를 제외한 어떤 힌트들이 포함되어 있으면, optimizer 는 자동적으로 cost-based approach를 사용.


옵티마이저를 위한 힌트와 사용 목표

―  힌트는 cost-based approach와 rule-based optimization approach 중에 하나를 선택
―  cost-based approach
를 선택한 경우에는 best throughput와 best reponse time사이에 하나를 선택
―  SQL
문이 optimization approach 와 goal을 기술한 한개의 힌트를 가진다면, optimizer는 statistics의 존재여부와 ALTER SESSSION명령에 있는

OPTIMIZER_GOAL와 OPIMIZER_MODE 초기 파라메타의 값과는 상관없이 기술된 approach를 사용.


∮ ALL_ROWS

―  ALL_ROWS 힌트는 best throughput(minimum total resource consumption)을 목적으로 SQL문 block을 최적화하기 위해 cost-based approach를 선택
―  optimizer는 best throughput을 목적으로 SQL문를 최적화    하려면


SELECT /*+ ALL_ROWS */ empno, ename, sal, job
              FROM emp
              WHERE empno = 7566;


∮ FIRST_ROWS

―  FIRST_ROWS 힌트는 best response time을 목적으로 SQL문 block을 최적화하기 위해 cost-based approach를 선택.(minimum resource usage to return first row)
― 
이 힌트는 아래 내용을 이행할 수 있는 optimizer를 생성


· Index scan을 쓸수 있다면, optimizer는 full table scan보다는 Index scan을 사용.
· Index scan
을 쓸수 있다면, optimizer는 연관된 table이 nested loop의 inner table일 때마다, sort-merge join보다는 nested loops join을선택.
· Index scan
이 ORDER BY절에 의해 쓰여지면, optimizer는 sort operation을 피하기 위해 index scan을 선택.

―  optimizer
는 best response time을 목적으로 아래 SQL문를 최적화하려면.


SELECT /*+ FIRST_ROWS */ empno, ename, sal, job
              FROM emp
              WHERE empno = 7566;


―  Optimizer
는 아래 Syntax를 가지는 DELETE와 UPDATE SQL문 blocks과 SELECT SQL문 block 에 있는 힌트는 무시.
· set operators(UNION, INTERSECT, MINUS, UNION ALL)
· GROUP BY
절
·FOR UPDATE 절
·group functions
·DISTINCT operator
― 
이들 SQL문는 best response를 목적으로 최적화될 수 없습니다.
― 
위의 경우 첫 번째 row를 반환하기 전에 SQL문에 접근되는 모든 행들을 retrieve해야만 함.
― 
이런 SQL문에 대해 힌트를 쓰면 optimizer는 cost-based approach를 사용하고, best throughput을 목적으로 최적화.

―  SQL
문에 ALL_ROWS나 FIRST_ROWS 힌트를 기술하고, data dictionary가 그 SQL문에 의해 접근되는 table에 대해 어떤 statistics도 포함하지 않는다면, optimizer는 내부적으로 execution plan을 선택하고, missing statistics를 추정할 default statistics 값을 사용.
― 
이 추정치(estimates)는 ANALYZE명령에 의해 생성되어진 것만큼 정확하지는 않음.
―  ANALYZE
명령을 사용하여 Cost-based optimization을 사용하는 SQL문에 의해 접근되는 모든 table에 대한 statistics를 생성해야 함.
―  Access path
를 위한 힌트 또는 ALL_ROWS나 FIRST_ROWS 힌트를 가지는 join operation을 기술합니다면, optimizer는 힌트에 의해 기술된 join operation들과 access paths를 우선적으로 취함.


∮ CHOOSE

―  CHOOSE 힌트는 statistics가 존재하고, SQL문에 의해 접근된 table에 대해 rule-based approach나 cost-based approach중 어떤 것을 쓸 것인지 optimizer가 선택.
―  data dictionary
가 이 table들 중 최소한 하나에 대한 statistics를 가진다면 optimizer는cost-based approach를 사용.
―  data dictionary
가 이 table들 중 어떤 것에 대해서도 statistics를 가지지 않는다면 optimizer는 rule-based approach를 사용.
― 
아래 SQL문에서 만약 EMP table에 대해 statistics가 있다면 optimizer는 cost-based approach를 사용.
―  data dictionary
에 EMP table에 대해 어떤 statistics도 존재하지 않는다면 optimizer는 rule-based approach를 사용.


SELECT /*+ CHOOSE */ empno, ename, sal, job
              FROM emp
              WHERE empno = 7566;


∮ RULE

―  RULE 힌트는 한 SQL문 block에 대해 rule-based optimization을 선택.
― 
이 힌트는 optimizer가 SQL문 block에 대해 기술한 다른 힌트들을 무시.
―  Optimizer
는 아래 SQL문를 위해서 rule-based approach를 사용.


SELECT --+ RULE
               empno, ename, sal, job
              FROM emp
              WHERE empno = 7566;


―  rule-based approach를 쓰는 RULE 힌트는 오라클의 다음 버전에서는 사용하지 않는다.


실행 순서 방법을 위한 SQL 힌트

―  각 힌트들은 table에 대한 access method를 제안
―  힌트중의 하나를 기술하는 것은 access path가 index나 클러스터와 SQL문의 의미구조의 존재를 기본적으로 이용할수 있다면 기술된 access path를 선택
― 
힌트가 access path를 이용할수 없다면 optimizer는 그것을 무시.
―  SQL
문에서 정확하게 access되는 table을 기술
―  SQL문이 table에 대한 alias를 사용하면, 힌트에서 table의 이름보다는 alias를 사용.
―  table
의 이름이나 alias 는 local database에 있는 한 table에 대한 하나의 synonym이나 하나의 table을 의미함.


∮ FULL

―  FULL 힌트는 table에 대해 full table scan을 선택
―  FULL 힌트의 문법은 FULL(table)
―  (table)
에는 full table scan을 수행하는 table의 alias나 name을 기술합니다.
― 
예 : ACCOUNT table에 WHERE절의 조건에 의해 사용가능한 ACCNO 칼럼에 대한 index가있음에도 불구하고, 오라클은 이 SQL 문을 실행할 ACCOUNTS table에 full table scan을 수행.


SELECT /*+ FULL(a) Don't use the index on ACCNO */ accno, bal
              FROM accounts a
              WHERE accno = 7086854;


■ NOTE
      ·  ACCONTStable
이 alias A를 가지기 때문에 힌트는 table의 이름이 아닌 alias로 table을표현.
      ·  FROM
절에 table의 이름이 기술되었음에도 불구하고, 힌트에서 는 schema names을 기술하지 않는다.


∮ ROWID

―  ROWID 힌트는 table에 대해 ROWID에 의한 table scan을 선택
―  ROWID 힌트의 문법은 ROWID(table)
―  (table)
에는 ROWID에 의한 table scan이 이행되어지는 table의 alias나 이름을 기술.


∮ CLUSTER

―  CLUSTER 힌트는 table에 대해 cluster scan을 선택
―  CLUSTER 힌트의 문법은 CLUSTER(table)
―  (table)
에는 cluster scan에 의해 접근되는 table의 이름이나 alias를 기술.

SELECT --+ CLUSTER emp, ename, deptno
              FROM emp, dept
              WHERE deptno = 10 AND emp.deptno = dept.deptno;


∮ HASH

―  HASH 힌트는 table에 대해 HASH scan을 선택
―  HASH 힌트의 문법은 HASH(table)
―  (table)
에는 hash scan에 의해 접근되는 table의 이름이나 alias를 기술


∮ INDEX

―  INDEX 힌트는 table에 대해 index scan을 선택
―  INDEX 힌트의 문법은


table : scan될 index와 관련있는 table의 이름이나 alias를 기술
index : index scan이 수행될 index를 기술


―  힌트는 하나이상의 indexes들을 기술


· 힌트가 하나의 사용가능한 index를 기술합니다면, optimizer는 index에서 한개의 scan을 수행.
· optimizer
는 full table scan이나 table에 있는 다른 index에 대한 scan은 수행하지 않음.
·
힌트가 사용가능한 index의 리스트를 기술합니다면, optimizer는 리스트에 있는 각각의 index에 대한 scan을 하는데 드는 비용을 고려한 후에가장 적은 비용이 드는 index scan을 이행
· 이 access path가 최저의 비용을 가진다면 optimizer는 이 리스트로부터 여러 index를 scan하고 그 결과들을 merge.
· optimizer
는 full table scan이나 힌트에 있지 않은 index scan은 고려하지 않음.
·
힌트가 어떤 index도 기술하지 않았다면, optimizer는 table에 있는 사용가능한 index를 각각 scan한 비용을 고려한 후에 lowest cost를 가진 index scan을 수행.
·
이 access path가 최저비용을 가진다면 optimizer는 muliple index를 scan하고 그 결과값을 merge.


SELECT name, height, weight
              FROM patients
              WHERE sex='M'


·  sex
의 열은 index되어 있고, 이 칼럼은 'M'과 'F'의 값을 가짐.
· 
병원에 남자의 수와 여자의 수가 동일하다면, 이 질의는 연관된 table의 행의 최다 퍼센트를 반환하고, full table scan이 index scan보다는 더 빠르게 됩니다.
· 
병원의 환자 중 남자의 비율이 매우 적다면, 질의는 관련된 table의 행에 대해 적은 비율을 반환하고, 이 경우에는 index scan이 full table scan보다 더 빠릅니다.
― 
각 disinct column value의 발생수는 optimizer에게 별로 유용하지 않다(도움이 되지 않는다.)
― cost-based approach
는 각각의 값들이 각각의 행에서 나타나는 빈도수가 동일하다고 가정을 합니다.
― 
한 칼럼이 단 2개의 다른 값들(distinct values)을 가진다면 optimizer는 그 두 값들이 각각 row의 50%로정도 나타난다고 가정합니다 그래서 cost-based approcah는 index scan보다는 full table scan을 선택하곤 합니다.
―  WHERE
절에 있는 값이 모든 row에 대해 매우 적은 퍼센트를 가진다면, 힌트에 index scan을 사용하여 optimizer가 강제로 index scan을 사용하게 할수 있습니다.
― 
아래 문장에서 INDEX 힌트는 SEX_INDEX에 대해 index scan을 선택합니다.

· SELECT /*+ INDEX(patients sex_index) Use SEX_INDEX, since there are few male patients */
              name, height, weight
              FROM patients
              WHERE sex = 'M';


∮ FULL 힌트와 INDEX 힌트의 비교 예제

―  1. EMPtable의 총건수는 10,000건, DEPTtable의 총건수는 2400건.
―  2. EMPtable
에서 empno, ename, sal을 select
―  3. WHERE
절의 조건은 JOB 필드의 'SALESMAN'값을 검사
―  4. JOB_INDEX 존재.
―  5. JOB
필드에는 2개의 값이 존재(MANAGER-(9,751건/10,000건), SALESMAN-(249건/10,000건))


·  EMP, DEPT table을 ANALYZE함.
·  sql_trace
를 true로


·  OPTIMIZER_GOAL 은 ALL_ROWS로


―  예제 1

analyze table emp estimate statistics;
analyze table dept estimate statistics;

alter session set sql_trace = true;
alter session set optimizer_goal = all_rows;

select empno, ename, sal
from emp
where job = 'SALESMAN';

select /*+ full(emp) */ empno, ename, sal
from emp
where job = 'SALESMAN';

select /*+ index(emp job_index) */ empno, ename, sal
from emp
where job = 'SALESMAN';


·  OPTIMIZER_GOAL 은 FIRST_ROWS로


―  예제 2

analyze table emp estimate statistics;
analyze table dept estimate statistics;

alter session set sql_trace = true;
alter session set optimizer_goal = first_rows;

select empno, ename, sal
from emp
where job = 'SALESMAN';

select /*+ full(emp) */ empno, ename, sal
from emp
where job = 'SALESMAN';

select /*+ index(emp job_index) */ empno, ename, sal
from emp
where job = 'SALESMAN';


∮ INDEX_ASC

―  INDEX_ASC 힌트는 table에 대한 index scan을 선택
―  이 SQL문이 index range scan을 사용합니다면, Oracle은 index된 값들을 오름차순으로 정렬한 index entry들을 scan.
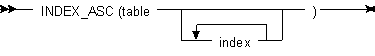
―  INDEX_ASC
힌트의 문법은


―  각 파라메타는 INDEX 힌트에서와 같은 목적을 의미.
―  range scan
에 대해서 오라클의 default behavior는 index된 값에 대해 오름차순으로 정렬하고 그 index entry들을 scan하는 것이므로 이 힌트는 일반적으로 index 힌트보다 더 나은 점은없습니다.


∮ INDEX_DESC

―  INDEX_DESC 힌트는 table에 대해 index scan을 선택
―  만약 SQL 문이 index range scan을 사용합니다면, 오라클은 index된 값들을 내림차순으로 정렬한 index entry들을 scan.
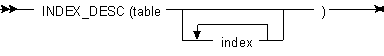
―  INDEX_desc
힌트의 문법은


―  각 파라메타는 INDEX 힌트에서와 같은 목적을 의미.
― 
이 힌트는 table보다 INDEX를 더 많이 접근하므로 SQL문에 영향을 주지 않음.
― 
아래의 SQL문은 index된 값에 대해서 항상 오름차순으로 정렬된 index range scan을 수행


CREATE TABLE tank_readings (
              time DATE CONSTAINT un_time UNIQUE,
               temperature NUMBER);


―  table
의 각 행들은 한 시점에서 시간과 온도를 저장.
―  TIME
칼럼에 대해 UNIQUE 제약을 주면 table이 동일한 시점에서 한번만 내용을 읽도록 합니다.
― 
오라클은 TIME 칼럼에 강제로 index를 수행.
― 
특별한 T시간에 대해서 읽은 가장 최근의 온도를 SELECT하는 complex query를 생각해보자.
―  Subquery
는 온도를 읽는 시점 T나 T이전의 가장 최근시간의 값을 반환.
―  Parent query
는 그 시간에 대한 온도를 찾는다.


SELECT temperature
              FROM tank_readings
              WHERE time = (SELECT MAX(time)

경축! 아무것도 안하여 에스천사게임즈가 새로운 모습으로 재오픈 하였습니다.
어린이용이며, 설치가 필요없는 브라우저 게임입니다.
https://s1004games.com

              FROM tank_readings
              WEHRE time <= TO_DATE(:t) );


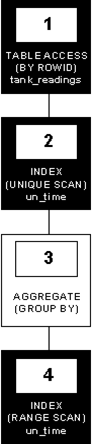
―  위 SQL문에 대한 execution plan은 아래그림과 같습니다.


―  위 SQL문장을 실행시키면, 오라클은 아래와 같은 operations를 실행.


· step 4와 3은 subquery를 실행.

- step 4는 시간 T와 같거나 더 적은 모든 TIME 값들을 반환할 UN_TIME index의 range scan을 수행.
- step 3
는 step 4로부터 최대 TIME값을 선택하고 그 값을 반환.


·step 2 와 1은 parent query를 실행.

- step 2는 step 3에 의해 반환된 TIME 값에 맞는 UN_TIME index의 unique scan을 수행하고 관련된 ROWID를 반환.
- step 1
은 step 2에 의해 반환된 ROWID를 사용하여 TANK_READING table을 접근하고 TEMPERATURE 값을 반환.


― Step 4에서 오라클은 오름차순으로 정렬된 index에 있는 TIME 값을 scan.
― 
오라클은 첫 번째 TIME값이 T보다 더 큰 경우에 scaning을 중지하고 그후에 step 3에서 T값과 같거나 더 적은 모든 값을 반환.
―  INDEX_DESC
힌트를 사용하면 index로부터 단 하나의 TIME값을 읽어오는 질의 사용 가능.


SELECT /*+ INDEX_DESC(tank_readings un_time) */ temperature
              FROM tank_readings
              WHERE time <= TO_DATE(:t)
              AND ROWNUM = 1;
              ORDER BY time DESC;


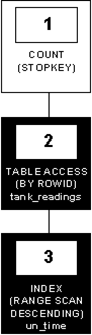
―  이것의 execution plan을 아래 그림과 같습니다.


· step 3은 T와 동일하거나 더 적은 TIME값을 찾기위해 UN_TIME index를 range scan하고 그와 관련된 ROWID를 반환.
· step 2
는 step 3에 의해 반환된 ROWID값들로서 TANK_READING table에 접근.
· step 1
은 step 2로부터 단 하나의 행을 요구함으로 ROWNUM=1이라는 조건을 수행.


―  INDEX_DESC 힌트 때문에 step 3은 T값부터 시작하는 내림차순으로 정렬된 index에서 TIME값을 scan.
―  scan
된 첫 번째 TIME값은 T이거나 T값보다는 적은 최대 TIME값 입니다.
―  step 1
은 단 하나의 행을 요구한 후부터는 , step 3은 첫 번째 TIME값 이후의 index entry에 대해 더 이상 scan하지 않는다.
―  default
행동이 오름차순 index scan이므로 INDEX_DESC 힌트없이 이 질의를 수행하면 오라클은 table에서 T와 같거나 그 보다 적은 최대 시간을 처음 scaning하는 것보다

최초의 시간을 scaning함으로서 시작하게 됨. step1은 최초의 시간에대한 온도를 반환하게 됩니다.
― 
위 질의에서 좀 더 빨리 이 복합 질의에서 요구하는 온도를 반환하려면 INDEX_DESC 힌트를 사용해야만 합니다.


∮ AND_EQUAL

―  AND_EQUAL 힌트는 몇몇의 single-column index에대한 scan을 merge하는 access path를 사용하는 execution plan을 선택
―  이 AND_EQUAL 힌트의 문법은


table : merge할 index와 연관된 table의 이름이나 alias를 기술.
index : index scan
을 수행하는 index를 기술

― 최소 2개 이상 최대 5개 이하의 index를 기술해야 합니다.


∮ USE_CONCAT

―  USE_CONCAT 힌트는 OR 조건을 UNION ALL set operator를 사용하는 compound query로 변환
―  이 변환은 UNION ALL set operations을 사용하는 질의가 이를 사용하지 않을 때보다 비용이더 적을 경우에만 발생


조인 순서를 위한 SQL 힌트

ORDERED 힌트는 join order를 제안


∮ ORDERED

―  ORDERED 힌트는 FROM절에 table이 나타나는 순서대로 table을 join시킨다.
― 
예를들어, 아래 SQL문은 table TAB1과 table TAB2를 조인한 후에 그 결과와 table TAB3을조인합니다.

SELECT /*+ ORDERED */ tab1.col1, tab2.col2, tab3.col3
              FROM tab1, tab2, tab3
              WHERE tab1.col1 = tab2.col1 AND tab2.col1 = tab3.col1;


―  SQL
문에서 ORDERED 힌트를 생략하고 join를 수행하면, optimizer가 table을 join할 순서를 선택
―  각 table에서 select해 오는 행의 수에대해 알고 있다면 join 순서를 기술하는 ORDERED 힌트를 사용하는 것이 좋다.
― 
사용자가 inner 와 outer table을 선택하는 것이 optimizer가 할수 있는 것보다 나을 수도 있습니다.


Table 조인 방법 SQL 힌트

● SQL문에서 나타나는 조인된 table을 정확하게 기술해야만 합니다.
● SQL
문이 table의 alias를 사용합니다면 힌트에서도 table의 이름보다는 alias를 사용해야만 합니다.
● table
의 이름이나 alias는 local database에 table의 synonym이나 table을 가지고 있어야만 합니다.
● USE_NL
과 USE_MERGE 힌트는 ORDERED 힌트를 사용해야만 합니다.
● 
오라클은 참조된 table이 조인에서 강제로 innertable이 될 때 이 힌트를 사용해야만 합니다.
● 
참조된 table이 outer table이라면 이 힌트들을 무시합니다.


∮ USE_NL

―  USE_NL 힌트는 table을 적는 부분에 table 기술된 table은 inner table로서 사용하여 nested loops로서 다른 table의 row source와 기술된 table을 join하게 합니다.
―  USE_NL
힌트의 문법은


table : nested loops join의 inner table로서 사용될 table의 이름과 alias입니다.

―  예를 들어서, ACCOUNTS와 CUSTOMERS table을 조인하는 SQL문이 있다고 생각해보자. 이들 table들은 cluster에 함께 저장되지 않았다고 가정합니다.

SELECT accounts.balance, customers.last_name, customers.first_name
              FROM accounts, customers
              WHERE accounts.custno = customers.custo;


―  cost-based approach의 default 목적은 best throughput이므로 이 optimizer는 좀 더 빨리 질의에 의해 select된 모든 행들을 반환하기위해 nested loops operation이나 sort-merge operation중 하나를 선택합니다.
― 
그러나 질의에 의해 선택된 첫 번째 행만 반환할 때 필요시간이 매우 적어야 할 경우에는 best throughput보다 best response time으로 SQL문을 최적화하는 것이 더 낫다.
― 
그렇게 하려면 USE_NL 힌트를 사용함으로서 optimizer가 nested loops join을 강제로 선택하게 할 수 있습니다.
―  SQL
문에서 USE_NL 힌트는 CUSTOMERStable을 inner table로 가지는 nested loop를 선택


SELECT /*+ ORDERED USE_NL(customers) Use N-L to get first row faster */
              accounts.balance, customers.last_name, customers.first_name
              FROM accounts, customers
              WHERE accounts.custno = customers.custno;


― 
많은 경우에 nested loops join은 sort-merge join보다는 더빨리 첫 번째 행을 반환합니다.
―  Nested loop join
은 한 table로부터 첫 번빼 select한 행을 읽은 후에 첫 번째 행을 반환할 수있고, 다른 table에서 첫 번째로 일치하는 행을 찾고 그것들을 결합합니다.
― 
반면에 sort-merge join은 양 table에서 select한 모든 row들을 읽고 정렬한 후 각각의 저장된 row source의 첫 번째 행들을 결합할 때까지 첫 번째 행을 반환할 수 없습니다.


∮ USE_MERGE

―  USE_MERGE 힌트는 오라클이 sort-merge join으로 각 table을 조인하게끔 하는 방법입니다.
―  USE_MERGE
힌트의 문법은


병렬 쿼리 실행을 위한 SQL 힌트


∮ CACHE

―  CACHE 힌트는 full table scan이 수행됐을 때 힌트에 있는 table에 대해 retrieve된 블록들은 버퍼 캐시에 있는 LRU list의 가장최근(most recently)에 사용되어진 것의 끝에 위치
―  이 option은 small lookup table에 유용하다. CACHE 힌트는 table의 default caching specification을 무시


SELECT/*+ FULL (scoot_emp) CACHE(scott_emp) */ ename
              FROM scott.emp scott_emp;


∮ NOCACHE

―  NOCACHE 힌트는 full table scan이 수행됐을 때 힌트에 있는 table에 대해 retrieve된 블록들은 버퍼 캐시에 있는 LRU list의 가장 오래전(least recently)에 사용되어진 것의 끝에 위치
―  버퍼캐수에 blocks의 일반적인 행동


SELECT/*+ FULL (scoot_emp) NOCACHE(scott_emp) */ ename
              FROM scott.emp scott_emp;


구문 연계를 고려하는 SQL 힌트

●  SQL이 융통성이 있는 언어이기 때문에 하나 이상의 SQL문이 Application을 필요로 할 것입니다.
●  2
개의 SQL문이 동일한 결과를 산출함에도 불구하고, 오라클은 2중의 하나가 더 처리속도가 빠릅니다.
●  execution plans
을 비교하기 위해 EXPLAIN PLAN SQL문의 결과와 두 SQL문의 비용들을 사용할 수 있습니다.


∮ 두 SQL문에 대한 execution plan 비교

●  첫 번째 SQL문과 그것에 대한 execution plan


SELECT dname, deptno
              FROM dept
              WHERE deptno NOT IN
              (SELECT deptno FROM emp);


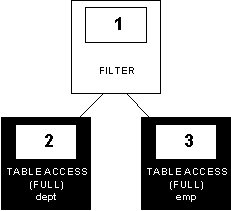
― Execution Plan with Two Full Table Scans


― step3을 통해 오라클은 DEPTNO 칼럼에 index가 있음에도 불구하고 EMPtable을 full table scan함으로서 위 SQL문을 실행합니다는 것을 알수 있습니다.
― full table scan
은 time-consuming operation을 할 수 있습니다.
― EMPtable
을 찾는 subquery에 index사용이 가능한 WHERE절이 없기 때문에 오라클은 index를 사용할 수 없습니다.

― 
그러나, 아래의 SQL문은 index에 접근함으로서 동일한 행을 SELECT합니다.


SELECT dname, deptno
              FROM dept
              WHERE NOT EXISTS
              (SELECT deptno
              FROM emp
              WHERE dept.deptno = emp.deptno);


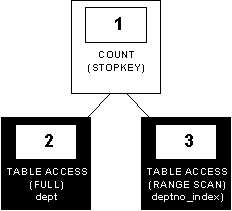
― Execution Plan with a Full Table Scan and an Index Scan


― subquery의 WHERE절이 EMPtable의 DEPTNO칼럼을 사용하므로 DEPTNO_INDEX를 사용할 수 있습니다.
― index
의 사용은 execution plan의 step3에서 하게됩니다
―  DEPTNO_INDEX의 index range scan은 첫 번째 문장에서 EMP table의 full scan하는 것보다 시간이 더 적게 걸린다.
― 
첫 번째 query는 DEPT table에서 모든 DEPTNO를 가져오기 위해 EMP table을 한번 full scan합니다.
― 
이런 이유로 두 번째 SQL 문은 첫 번째보다는 더 빠릅니다.
― Application
에 NOT IN operator를 사용하는 SQL문를 가진다면 NOT EXISTS operator를사용해서 그것들을 다시 써라. 이것은 index가 있다면 그 index를 사용할 수 있게 해줄 것입니다.


기존 SQL문을 튜닝하는 방법

●  존재하는 application에서 SQL 문을 튜닝하는 것은 새로운 문장을 기록하는 것과는 다른 작업(task)입니다.
● 
비록 요구된 지식이 같을지라도 프로세스는 다르다.
● 
튜닝하기 위한 application에서 특별한 문장을 다음과 같이함으로써 분리해야 합니다.
· application
에 익숙하라.
· SQL trace
를 이용하여 특별한 문제 문장을 분리하라.
● 
이전 절에서 논의했던 새로운 SQL 문장을 기록하고, index, 클러스터, 해싱, 힌트를 하기 위한 지침을 이용하여 문장을 튜닝할 수 있습니다.


∮ Know the Application

―  application과 SQL 문장과 data에 익숙해져야 합니다.
― 
만약 당신이 application을 설계하고 개발하지 않았다면 그것을 한 사람에게 의견을 물어보라.
―  application
이 하는 것을 기록하라.


· application을 이용하는 SQL 문은 무엇인가?
· application
이 처리하는 데이타는 무엇인가?
·
데이타의 특징과 distribution은 무엇인가?
· applicatin
의 무슨 operation이 data를 실행하는가?


―  application 사용자들과 성능에 대해 이야기 해보라.
―  application
의 어떤 부분을 식별하기 위 해서 그들이 성능향상의 필요를 느끼는지를 물어보라.
― 
가능하면 개인적인 SQL 문장을 위해서 이 부분들이 적어질 때까지 좁혀라.


∮ Use the SQl Trace Facility

―  오라클은 성능을 측정하기 위하여 진단에 도움이 되는 tool을 몇가지 제공합니다
―  appllicatin을 튜닝하는데 특별히 도움이 되는 tool중에 하나는 SQL trace 입니다.
―  SQL trace facililty
는 오라클에 의해 처리된 각 SQL 문장을 위한 통계를 생성합니다.
― 
통계는 다음을 나타낸다.


· SQL 문장이 파싱, 실행, 페치된 횟수
·
각 SQL 문장을 처리하는데 필요한 시간
·
각 SQL 문장과 관련된 메모리와 디스크 access
·
각 SQL 문장을 처리하는 row의 수


―  SQL trace facility는 또한 EXPLAIN PLAN 명령을 이용하여 execution plan을 생성할수 있습니다.


∮ Tuning Individual SQL statements

―  사용중인 사용자 응용을 수정하지 않고 SQL문의 변경된 문법을 탐색할 수 있음을 명심하라.
― 
사용자가 존재하는 SQL문의 비용과 실행계획을 비교하고 고려하는 문장을 변경하는 것은 단순히 EXPLIAN PLAN을 이용합니다.
― 
만약 사용자가 SQL문의 tune을 위해 새로운 index를 생성하면 사용자는 optimizer가 응용이실행될 때마다 index를 사용할 것인지를 결정하기 위해 EXPLAIN PLAN 명령을 사용할 수 있습니다.
― 
만약 사용자가 현재 parse된 문장을 tune하기 위해 새로운 index를 생성하면 Oracle은 SQL 문에서 이 index를 사용하지 않는다.
―  SQL
문장이 다시 실행되면 optimizer는 자동적으로 새로 생성된 index를 사용하기 위해 새로운 실행계획을 선택합니다.
― 
만약 사용자가 분산 SQL 문을 tune 하기 위해 원격 데이타베이스의 index를 생성하면 optimizer는 SQL문이 다시 실행될 때 이 index를 고려합니다.
― 
또한 사용자는 SQL 문장에 대한 실행계획이 optimizer 보다 더 효과적으로 사용할 수 있도록 tune합니다는 것을 명심하라.
― 
예를 들어 사용자가 하나의 SQL문을 사용하기 위해 index를 생성하면 optimizer는 사용자의응용에서 다른 문장을 실행하기 위해 그 index를 선택합니다.

[출처] http://otsteam.tistory.com/138


본 웹사이트는 광고를 포함하고 있습니다.
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
번호 제목 글쓴이 날짜 조회 수
공지 오라클 기본 샘플 데이터베이스 졸리운_곰 2014.01.02 96360
공지 [SQL컨셉] 서적 "SQL컨셉"의 샘플 데이타 베이스 SAMPLE DATABASE of ORACLE 가을의 곰을... 2013.02.10 87110
공지 [G_SQL] Sample Database 가을의 곰을... 2012.05.20 103923
286 오라클 컬럼명 찾기 졸리운_곰 2017.04.17 2226
285 [MS-SQL] 테이블명, 컬럼명 검색 졸리운_곰 2017.04.17 2248
284 DB의 모든 테이블에서 데이터 검색 졸리운_곰 2017.04.17 1915
283 [칼퇴족 김대리는 알고 나만 모르는 SQL 예제, mysql 변경 Sample DB SQL 책밥 출판 file 졸리운_곰 2017.04.04 2073
282 [칼퇴족 김대리는 알고 나만 모르는 SQL 예제, Oracle Sample DB SQL 책밥 출판 졸리운_곰 2017.04.04 1904
281 빅데이터 단지 몇퍼센트의 예측 정확성을 위하여 장애로 가득찬 빅데이터 시스템을 도입하여야 하는가에 대한 의문! file 졸리운_곰 2017.03.20 1878
280 빅데이터: 플럼(Flume) 토폴로지 설계 file 졸리운_곰 2017.03.20 1652
279 Transfer from sqlite to MySQL/ sqlite에서 mysql로 변환 졸리운_곰 2017.03.18 1379
278 범용 커넥션 풀 라이브러리 : connection pool Libzdb file 졸리운_곰 2017.03.17 993
277 [Oracle | 오라클] DB 덤프/임포트 하기 졸리운_곰 2017.03.17 1333
276 Oracle Data pump 실전 사용 졸리운_곰 2017.03.17 900
275 오라클 덤프 export / import file 졸리운_곰 2017.03.17 1521
274 오라클 DB 백업과 복원 졸리운_곰 2017.03.17 1892
273 [MySQL] 힌트설정 / 쿼리캐시 졸리운_곰 2017.03.15 1724
272 [MySQL힌트 정리] 졸리운_곰 2017.03.15 2059
271 [mysql]Hint 사용방법 졸리운_곰 2017.03.15 1625
270 MySQL Ver. 5.1 힌트를 이용한 실행계획 제어 file 졸리운_곰 2017.03.15 1323
» SQL HINT 를 이용하여 SQL Tunning 을 하는 방법 file 졸리운_곰 2017.03.15 1460
268 <운바-DB> Oracle HINT(기초) file 졸리운_곰 2017.03.15 1607
267 조인 순서 조정을 위한 힌트(ordered, leading) 졸리운_곰 2017.03.15 1552
대표 김성준 주소 : 경기 용인 분당수지 U타워 등록번호 : 142-07-27414
통신판매업 신고 : 제2012-용인수지-0185호 출판업 신고 : 수지구청 제 123호 개인정보보호최고책임자 : 김성준 sjkim70@stechstar.com
대표전화 : 010-4589-2193 [fax] 02-6280-1294 COPYRIGHT(C) stechstar.com ALL RIGHTS RESERVED