
[인공지능기술] llama.cpp 설치 방법 및 사용방법 with LoRA
2024.12.10 03:03
[인공지능기술] llama.cpp 설치 방법 및 사용방법 with LoRA
llama.cpp는 LLM 모델을 quantization을 통하여 필요한 메모리의 양을 크게 감소시켜
고성능 GPU가 없는 환경(m1 mac 등)에서도 동작하며 빠른 추론 결과를 얻을 수 있게 해주는 packege이다.
cpp를 이용하면 cpu 만으로도 동작하지만 GPU를 함께 사용하면 더 빠른 결과를 얻을 수 있다.
모델을 cpp로 이용하는 순서는 다음과 같다.
- llama.cpp 환경 구축
- llama.cpp code clone
- packege install
- 사용할 LLM 모델 다운로드
- LLM 모델 convert (ggml, gguf 파일로 만들기)
- python packege llama_cpp를 이용하여 모델 로드
- 모델 추론
각 단계별 자세한 내용은 다음과 같다.
1. llama.cpp 환경 구축
모델을 convert 하기 위해서 llama.cpp 코드를 가져와야 한다.
git clone 후 해당 폴더로 이동 후에 make 명령어를 입력하면 설치가 완료된다.(다른 방법들은 README에 잘 나와있다.)
https://github.com/ggerganov/llama.cpp
convert 된 모델을 이용하기 위한 packege llama-cpp-python을 설치해야 한다.
1. cuda(nvidia GPU)가 설치된 환경인 경우
CMAKE_ARGS=-DLLAMA_CUBLAS=on FORCE_CMAKE=1 pip install llama-cpp-python --force-reinstall --upgrade --no-cache-dir
2. M1 mac 에서 MPS를 사용할 경우
CMAKE_ARGS=-DLLAMA_METAL=on FORCE_CMAKE=1 pip install llama-cpp-python --force-reinstall --upgrade --no-cache-dir
3. CPU만 사용할 경우
FORCE_CMAKE=1 pip install llama-cpp-python --force-reinstall --upgrade --no-cache-dir
2. 사용할 LLM 모델 다운로드
모델을 다운로드 받는 방법은 다양하다. 내가 추천하는 방법은 맨 마지막 방법이다.
- hugging face 페이지에서 UI를 이용하여 다운로드
- hugging face cli를 이용하여 다운로드
- git clone을 이용하는 방법 (git lfs)
- transfomers를 이용하는 방법
추천하는 이유는 가장 빠르게 받을 수 있는 방법이다. 모델의 크기에 따라 다운로드가 12시간 이상 걸리는 경우도 많다. transformers를 이용하면 5~6시간 안에 저장할 수 있으며 이미 사용해 보았던 모델(cache에 있는)의 경우 더 빠르게 저장할 수 있다. 저장하는 코드는 다음과 같다.
from transformers import AutoTokenizer, AutoModelForCausalLM

# 모델 로드
model_path = "다운받을 모델 path(hugging_face 등)"
tokenizer = AutoTokenizer.from_pretrained(model_path)
model = AutoModelForCausalLM.from_pretrained(model_path)

# 모델 저장
save_dir = "저장할 폴더"
tokenizer.save_pretrained(save_dir)
model.save_pretrained(save_dir)
3. LLM 모델 convert (ggml, gguf 파일로 만들기)
llama.cpp 폴더에 들어가면 다음과 같은 파일들이 존재한다. 다음 중 내가 사용한 파일은 2개
1. convert.py (다운로드한 모델을 cpp quantization 하여 gguf 파일로 만든다.)
2. convert-lora-to-ggml (lora로 학습시킨 adapter 모델을 ggml 파일로 만든다.)
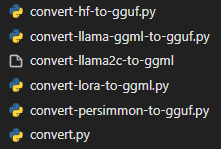
사용 명령어는 다음과 같다.


1. 다운받은 모델 convert
quantiazaion option은 다양하게 있지만 (f16, q8_0 등) code가 업데이트될 때마다 달라지는 것 같아 확인하고 사용하는 것이 좋아 보인다.
-> 생성된 모델 명 : ggml-model-q8_0.gguf
python convert.py [model_path] --outtype [quantization_type]
2. lora 모델(adapter) convert
별다른 옵션은 없어 보인다.
-> 생성된 모델 명 : ggml-adapter-model.bin
*lora로 학습시킨 모델을 cpp로 이용하기 위해서는 base모델을 cpp convert (위 1번) 해서 함께 사용해야 한다.
python convert-lora-to-ggml.py [model_path]
4. python packege llama_cpp를 이용하여 모델 로드
llama2 base 모델
from llama_cpp import Llama

model_path = "base_model"
lora_path = "lora adapter 그냥 모델이면 안넣어도 됨"
llm = Llama(model_path=my_model_path,
            lora_path=lora_path,
            n_gpu_layers=0)
n_gpu_layers : gpu에서 사용할 layer 수
아래 사진에서 예시로 로드한 모델은 33개 layer 중에 0개를 사용 중이다. 로드한 모델에 따라 수치를 정한다.
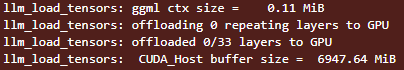
아래 BLAS=1이면 GPU 가속이 사용가능 한 상태이다.

5. 모델 추론
def gen(text):
    prompt = "사용할 프롬프트"
    answer = llm(prompt.format(text),
                 max_tokens=256,
                 stop=['<\s>'],
                 echo=True,
                 temperature=0.3,
                 frequency_penalty = 0.9,
                 repeat_penalty=1.1,
                 top_p=0.98)
    result = answer['choices'][0]['text'].replace(prompt.format(text),'')
    return result
위와 같은 코드로 모델을 동작할 수 있다. 여러 hyper parameter는 상황에 맞게 조정한다.
LLAMA 7B 모델 기준 cpp + GPU 가속(6G memory)을 이용한 경우 6~10초 만에 결과를 얻을 수 있었다.
[출처] https://avocadaon.tistory.com/50
광고 클릭에서 발생하는 수익금은 모두 웹사이트 서버의 유지 및 관리, 그리고 기술 콘텐츠 향상을 위해 쓰여집니다.
