생각에 대해 생각할 줄 아는 사람들이 그렇지 않은 사람들에 비해 부정적 정서를 잘 이겨낸다는 발견들이 있었다. 예를 들어 슬프고 우울한 기분이 들 때 밑도 끝도 없이 우울하다고 하기보다 “오늘따라 사소한 실수에도 크게 속이 상하고 실패자가 된 느낌이 드는데 왜 그럴까. 아마 며칠 동안 스트레스가 심해서 그런 거 같다”처럼 자신의 마음 상태를 분석적으로 생각할 수 있는 사람들이 그렇지 않은 사람들에 비해 우울감을 잘 이겨내는 경향을 보인다.
많은 경우 우리의 감정이나 생각은 현실을 있는 그대로 반영하기보다 다양한 상황적 요소들에 의해 들쑥날쑥하기 마련이다. 보통이라면 전혀 짜증나지 않았을 만한 일이 몸과 마음이 지쳐있을 때면 버럭 화가 날 만한 일이 되는 것이 단적인 사례다.
우리의 판단력이라는 것도 이렇게 평소보다 감정이 격해질만한 상황에 놓였을 때는 그다지 신뢰할 만하지 못하다. 배가 심하게 고플 때 장을 보면 평소보다 훨씬 많이 사게 되고 화가 났을 때는 세상 사람들이 나의 적인 것처럼 보인다. 화장실 가기 전과 갔다 온 후가 완전히 다르다는 말처럼, 감정적으로 머리가 뜨거울 만한(hot state) 상황에서는 우리의 감정도 이성도 제대로 작동하지 않는 경우가 많다.
그래서 잔뜩 화가 났거나 한 밤 중에 갑자기 존재론적 고독감이 몰려왔을 때 중요한 결정을 하지 말라는 조언들을 한다. 홧김에 사표를 내는 것이나 새벽에 갑자기 전 애인에게 문자를 보내는 행위는 대체로 다음 날 큰 후회를 불러오곤 하기 때문이다.
나의 경우 우울함이 몰려오는 새벽이면 인터넷으로 충동구매를 하고 그 다음 날이면 정신이 들면서 부랴부랴 구매를 취소하는 일을 겪곤 함을 고백한다.
“마음의 소리”를 따르라고들 하지만 그래도 될 때가 있는 반면 그러면 안 되는 때가 있다는 것이다. 하지만 보통 마음의 소리를 따르면 안 될 때일수록 마음의 소리가 유난히 시끄럽기 때문에 지금이야말로 마음의 소리를 따라야 할 것 같은 확신이 든다는 게 문제다. 이런 점에서 더더욱 내 마음에 대해 따지고 분석할 줄 아는 능력이 중요하다.
나의 경우 만성 통증이 올라오면 우울해지는 경향이 있다. 바로 어제도 통증을 감지하고 한창 우울감에 빠져 있었다. 어느새 스스로에게 이렇게 사는게 도대체 무슨 의미가 있는지 의문을 던지고 있는 나를 발견했다. 이럴 때면 모든 일을 그만 두고 아무도 모르는 곳으로 훌쩍 사라져버리고 싶다는 생각을 하게 된다.
그러던 중 문득 신체적 통증과 이에 대한 감정 반응(짜증, 슬픔 등)은 별개임을 떠올리고 이런 감정들이 나타난 경위에 대해 생각해보기 시작했다. 내 마음이 계속해서 나에게 ‘정말 싫다. 우울하다. 짜증난다.’ 같은 말을 하고 있는 것을 발견했다.
물론 지금의 삶이 별로 의미 없는 것 같다는 느낌을 사실로 받아들일 수도 있지만, 우선 이건 어디까지나 나의 감정이고 생각임을 떠올려 보았다. ‘나는 지금 이렇게는 살고 싶지 않다는 생각을 하고 있다. 나는 지금 내 마음이 나에게 이렇게 살기 싫다고 이야기하고 있음을 인식하고 있다.’ 하고 목소리를 내어 스스로에게 이야기해 보았다.
별 것 아닌 행동이지만 목소리를 내어 이야기해 보니 나를 계속해서 괴롭히던 것의 정체는 나의 생각임이 분명해지는 듯한 기분이 들었다. 내가 만들어 낸 생각과 현실을 조금 구분할 수 있을 것 같았다. 그 기저에는 통증에 대해 내가 할 수 있는 것이 없고 앞으로도 영원히 아플 거라는 다소 비합리적인 신념이 있다는 점도 발견할 수 있었다.
꾸준히 치료를 받는 것이 분명 도움이 되고 전반적인 건강 관리를 잘 하면 좋아진다는 것도 경험을 통해 분명히 알고 있다. 하지만 우울감에 깊이 빠져 있을 때면 마치 마음에 검은 장막이 드리워지듯 긍정적이었던 경험들이 묻혀 하나도 떠오르지 않게 된다. 결국 우울할 때면 가장 안 좋았던 경험과 가장 안 좋은 상상만 선택해서 떠올리는 것이 큰 문제임을 알 수 있었다.
떠오르는 감정을 억누르는 것은 별로 좋지 않지만 감정에 대해 따져보는 시도는 중요한 것 같다. 부정적 감정의 존재 이유는 어디까지나 우리가 안전하고 행복하게 살아갈 수 있도록 잠재적인 위험 요소에 주의를 주게끔 만드는 것이다.
따라서 어디까지나 감정에 먹히지 않되 그것의 메시지를 알아차리는 것이 중요하다. 그렇지 않으면 지나치게 주의를 빼앗겨 현실적인 문제 해결과는 동떨어진 길을 가게 될 수 있음을 기억하자.
Hargus, E., Crane, C., Barnhofer, T., & Williams, J. M. G. (2010). Effects of mindfulness on meta-awareness and specificity of describing prodromal symptoms in suicidal depression.Emotion, 10(1), 34–42. https://doi.org/10.1037/a0016825
※필자소개 박진영. 《나, 지금 이대로 괜찮은 사람》, 《나를 사랑하지 않는 나에게》를 썼다. 삶에 도움이 되는 심리학 연구를 알기 쉽고 공감 가도록 풀어낸 책을 통해 독자와 꾸준히 소통하고 있다. 온라인에서 ‘지뇽뇽’이라는 필명으로 활동하고 있다. 현재 미국 듀크대에서 사회심리학 박사 과정을 밟고 있다
[인공지능 기술] WebGPU powered machine learning in the browser with Apache TVM : Apache TVM을 사용하여 브라우저에서 WebGPU 기반 기계 학습
By Tianqi Chen, Jared Roesch, and Jason Knight
TL;DR
Easy ML deployment in the browser with near-native GPU performance and WebAssembly
We introduced support for WASM and WebGPU backends to the Apache TVM deep learning compiler Our initial experiments shows that TVM’s WebGPU backend can get close to native GPU performance when deploying models in the browser.
Introduction — faster browser applications
WebGPU and WebAssembly are two up-and-coming browser standards aimed at making browser based applications as efficient as native applications while retaining hardware portability. WebGPU first builds on top of the lower level graphics API movements to enable more full featured GPU accelerated compute capabilities as compared to its predecessor WebGL, and WebAssembly (WASM) is a similar effort for unlocking CPU based compute capabilities. And best of all, WASM is most likely already enabled in the browser you’re reading this in, with WebGPU coming soon.
For some of the exciting capabilities and use cases behind WASM particularly, please check out Lin Clark’s excellent WASM “skill tree”
WASM’s post MVP skill tree
Leveraging more of these WASM capabilities such as SIMD support and multi-threading as they mature is an exciting area of future work, but let’s see how far we can get with WASM and WASI (standard interfaces) to feed WebGPU compute shaders.
Machine learning in the browser
While efforts like TensorFlow.js and ONNX.js attempt to bring machine learning to the browser, there still exist non-trivial gaps in performance between the web versions and native ones. One of the many reasons behind these gaps are the lack of standard and performant access to the GPU on the web. WebGL lacks important features such as compute shaders and generic storage buffers that are necessary for high performance deep learning.
WebGPU offers the potential to bridge this gap with its first-class compute shader support.
To explore the potential of using WebGPU for deploying machine learning in the browser, we enhanced the deep learning compiler Apache (incubating) TVM to target WASM (for host code that computes the launching parameters and calls into the device launch) and WebGPU (for device execution). Our preliminary results are quite positive — for the first time, we can deploy machine learning applications on the web while still getting near native performance on the GPU.
Please check out our companion Apache TVM technical blog post for the technical details, but in short, we were able to achieve near native GPU performance in the browser through WASM and WebGPU by combining:
TVM’s existing LLVM backend for it’s WASM generation support
A new tvmjs TypeScript runtime
WASM’s standard interfaces (WASI) for system library calls (eg malloc, stderr)
Chrome’s nightly WebGPU support
One important advantage of the compilation based approach is the reuse of infrastructure. We are able to effortlessly relative to other approaches target the web by reusing the infrastructure for optimizing GPU kernels for native platforms such as CUDA, Metal and OpenCL. If the mapping of the WebGPU API to native APIs is efficient we can expect similar performance with very little work. More importantly, the AutoTVM infrastructure allows us to specialize the compute shaders for specific models, enabling the generation of the best compute shaders for our specific model of interest.
Performance
We ran a quick experiment comparing the execution of a full Mobilenet execution via TVM’s WebGPU backend and native targets that use native GPU runtimes (Metal and OpenCL). We find that WebGPU get’s quite close to matching the performance of Metal. Assuming Chrome WebGPU’s runtime targets Metal instead of OpenCL on the MacOS, we can safely assume there is little to no performance loss when targeting the GPU through the browser here.
We also expect further performance boosts by applying AutoTVM tuning on the GPU being used by the browser since these results are based off previously auto-tuned schedules from a GTX 1080 Ti, which is quite different from the Intel graphics GPU. To make this easier, we expect our upcoming improvements to the uTVM runtime (stay tuned to this blog for an update in the next 1–2 weeks) for embedded microcontrollers will help make autotuning easier in the browser since WASM targets share many similarities to embedded devices.
Looking to the Future
Our results suggest many interesting opportunities for machine learning on the web. Notably, WebGPU is an API that is still evolving and its implications could go beyond web applications. For example one could target native APIs of WebGPU as it matures and becomes standardized through WASI, enabling standalone WASM applications that make use of WebGPU.
The TVM community is also actively working on a Rust based runtime that would enable much more robust WASM support and enable easier interaction with projects like wgpu, and the Rust WASM ecosystem. As an open source project, we are looking for contributors who can bring in new ideas and help push the project in these exciting directions.
The proposed approach provides effective machine learning support for most WASM’s application scenarios. The close to native performance could also unlock better federated learning capabilities on the browser. The same compiled package should also be able to run on native WASM executors to provide sandbox for the applications.
Show me the Details/Code
Detailed technical version of this blog post
Example project for image classification
Apache TVM on github
Acknowledgement
We would like to thank the emscripten project for providing the WASM compilation infrastructures as well as the JS library support on the web. We would also like to thank the WebGPU community for various helpful discussions. Thanks to Fletcher Haynes for valuable feedback on the post.
Apache TVM 딥 러닝 컴파일러 에 WASM 및 WebGPU 백엔드에 대한 지원을 도입했습니다 . 초기 실험에 따르면 브라우저에 모델을 배포할 때 TVM의 WebGPU 백엔드가 기본 GPU 성능에 근접 할 수 있는 것으로 나타났습니다.
소개 — 더 빠른 브라우저 애플리케이션
WebGPU 와 WebAssembly 는 하드웨어 이식성을 유지하면서 브라우저 기반 애플리케이션을 기본 애플리케이션만큼 효율적으로 만드는 것을 목표로 하는 두 가지 최신 브라우저 표준입니다. WebGPU는 먼저 낮은 수준의 그래픽 API 움직임을 기반으로 구축되어 이전 WebGL에 비해 더 많은 기능을 갖춘 GPU 가속 컴퓨팅 기능을 지원하며 WebAssembly(WASM)는 CPU 기반 컴퓨팅 기능을 잠금 해제하기 위한 유사한 노력입니다. 무엇보다도 WASM은 이 글을 읽고 있는 브라우저에서 이미 활성화되어 있을 가능성이 높으며 WebGPU도 곧 출시될 예정입니다 .
특히 WASM의 흥미로운 기능과 사용 사례에 대해서는 Lin Clark의 우수한 WASM “스킬 트리”를 확인하세요.
WASM의 포스트 MVP 스킬 트리
SIMD 지원 및 멀티스레딩과 같은 WASM 기능이 성숙해짐에 따라 더 많이 활용하는 것은 미래 작업의 흥미로운 영역이지만 WebGPU 컴퓨팅 셰이더에 공급하기 위해 WASM 및 WASI(표준 인터페이스)를 통해 얼마나 멀리까지 갈 수 있는지 살펴보겠습니다.
브라우저에서의 머신러닝
TensorFlow.js 및 ONNX.js와 같은 노력이 기계 학습을 브라우저에 도입하려고 시도하는 동안 웹 버전과 기본 버전 사이에는 여전히 성능 차이가 적지 않습니다. 이러한 격차의 원인 중 하나는 웹에서 GPU에 대한 표준 및 성능 액세스가 부족하기 때문입니다. WebGL에는 고성능 딥 러닝에 필요한 컴퓨팅 셰이더 및 일반 스토리지 버퍼와 같은 중요한 기능이 부족합니다.
WebGPU는 최고 수준의 컴퓨팅 셰이더 지원을 통해 이러한 격차를 해소할 수 있는 잠재력을 제공합니다.
브라우저에 기계 학습을 배포하기 위해 WebGPU를 사용할 수 있는 가능성을 탐색하기 위해 WASM(실행 매개변수를 계산하고 장치 실행을 호출하는 호스트 코드용) 및 WebGPU(장치용)를 대상으로 딥 러닝 컴파일러 Apache(인큐베이팅) TVM을 향상했습니다. 실행). 우리의 예비 결과는 매우 긍정적입니다. 처음으로 GPU에서 기본 성능에 거의 근접하면서 웹에 기계 학습 애플리케이션을 배포할 수 있었습니다.
기술적 세부 사항은 함께 제공되는 Apache TVM 기술 블로그 게시물을 확인하세요 . 간단히 말해서 우리는 다음을 결합하여 WASM 및 WebGPU를 통해 브라우저에서 거의 기본 GPU 성능을 달성할 수 있었습니다.
WebGPU 컴퓨팅 API를 대상으로 하는 TVM의 기존 SPIR-V 코드 생성 기능
WASM 생성 지원을 위한 TVM의 기존 LLVM 백엔드
새로운 tvmjs TypeScript 런타임
시스템 라이브러리 호출(예: malloc, stderr)을 위한 WASM의 표준 인터페이스(WASI)
Chrome의 야간 WebGPU 지원
컴파일 기반 접근 방식의 중요한 이점 중 하나는 인프라를 재사용한다는 것입니다. 우리는 CUDA, Metal 및 OpenCL과 같은 기본 플랫폼에 대해 GPU 커널을 최적화하기 위한 인프라를 재사용함으로써 다른 접근 방식 에 비해 웹을 대상으로 하는 작업을 쉽게 수행할 수 있습니다 . WebGPU API를 네이티브 API로 매핑하는 것이 효율적이라면 거의 작업하지 않고도 비슷한 성능을 기대할 수 있습니다. 더 중요한 것은 AutoTVM 인프라를 통해 특정 모델에 대한 컴퓨팅 셰이더를 전문화하여 특정 관심 모델에 가장 적합한 컴퓨팅 셰이더를 생성할 수 있다는 것입니다.
성능
우리는 TVM의 WebGPU 백엔드와 네이티브 GPU 런타임(Metal 및 OpenCL)을 사용하는 네이티브 대상을 통해 전체 Mobilenet 실행 실행을 비교하는 빠른 실험을 실행했습니다. 우리는 WebGPU가 Metal의 성능과 거의 일치한다는 것을 알았습니다. Chrome WebGPU의 런타임이 MacOS의 OpenCL 대신 Metal을 대상으로 한다고 가정하면 여기에서 브라우저를 통해 GPU를 대상으로 할 때 성능 손실이 거의 또는 전혀 없다고 안전하게 가정할 수 있습니다.
또한 이러한 결과는 Intel 그래픽 GPU와 상당히 다른 GTX 1080 Ti의 이전 자동 조정 일정을 기반으로 하기 때문에 브라우저에서 사용되는 GPU에 AutoTVM 조정을 적용하면 성능이 더욱 향상될 것으로 예상 됩니다 . 이를 더 쉽게 만들기 위해 내장형 마이크로컨트롤러에 대한 uTVM 런타임의 향후 개선 사항(향후 1~2주 내에 업데이트를 위해 이 블로그를 계속 지켜봐 주시기 바랍니다)은 WASM 타겟이 내장형과 많은 유사점을 공유하므로 브라우저에서 자동 조정을 더 쉽게 만드는 데 도움이 될 것으로 기대합니다. 장치.
미래를 바라보며
우리의 결과는 웹에서 기계 학습을 위한 많은 흥미로운 기회를 제시합니다. 특히 WebGPU는 여전히 진화하고 있는 API이며 그 의미는 웹 애플리케이션을 넘어설 수 있습니다. 예를 들어 WebGPU가 성숙해지고 WASI를 통해 표준화됨에 따라 WebGPU의 기본 API를 대상으로 하여 WebGPU를 활용하는 독립형 WASM 애플리케이션을 활성화할 수 있습니다.
TVM 커뮤니티는 또한 훨씬 더 강력한 WASM 지원을 가능하게 하고 wgpu 및 Rust WASM 생태계와 같은 프로젝트와의 더 쉬운 상호 작용을 가능하게 하는 Rust 기반 런타임 에 적극적으로 노력하고 있습니다 . 오픈 소스 프로젝트로서 우리는 새로운 아이디어를 가져오고 프로젝트를 이러한 흥미로운 방향으로 추진하는 데 도움을 줄 수 있는 기여자를 찾고 있습니다.
제안된 접근 방식은 대부분의 WASM 애플리케이션 시나리오에 효과적인 기계 학습 지원을 제공합니다. 기본 성능에 가까워지면 브라우저에서 더 나은 연합 학습 기능을 활용할 수도 있습니다. 동일한 컴파일된 패키지는 기본 WASM 실행기에서도 실행되어 애플리케이션에 샌드박스를 제공할 수 있어야 합니다.
세부정보/코드를 보여주세요.
이 블로그 게시물의 자세한 기술 버전
이미지 분류를 위한 예시 프로젝트
github의 Apache TVM
승인
웹에서 WASM 컴파일 인프라와 JS 라이브러리 지원을 제공한 emscripten 프로젝트에 감사드립니다. 또한 다양한 유용한 토론을 해주신 WebGPU 커뮤니티에도 감사의 말씀을 전하고 싶습니다. 게시물에 귀중한 피드백을 주신 Fletcher Haynes에게 감사드립니다.
여러 대형 기업이 생성형 인공지능(AI) 관련 서비스를 경쟁적으로 출시하고 있지만, 서비스 운영 비용 때문에 골머리를 앓고 있다. 마이크로소프트는 작년 출시한 깃허브 코파일럿 서비스로 사용자당 20달러를 손해보는 것으로 알려졌다.
9일(현지시간) 월스트리트저널(WSJ)에 따르면, 마이크로소프트는 150만명 사용자를 확보한 깃허브 코파일럿 서비스에서 사용자당 월평균 20달러의 손실을 기록중이라고 한다. 일부 사용자는 한달 최대 80달러의 비용을 지출하게 하는 것으로 나타났다.
깃허브 코파일럿은 개발자에게 코드를 생성해주고, 빠르게 수정할 수 있게 해주는 서비스다. 오픈AI의 코드생성모델인 코덱스를 사용한다. 이 서비스 요금은 사용자당 월 10달러다. 산술적으로 1천500만달러를 매월 벌어들이고 있다.
깃허브 코파일럿
그러나 생성 AI는 이용자의 사용량에 따라 운영비용이 증가하는 구조를 보이고 있다. 아직 규모의 경제에 도달하지 못했기 때문에 서비스 공급비용이 수익보다 크다. 특정 사례에서 사용자의 쿼리에 더 막대한 연산비용을 투입해야 할 수 있고, 사용량만큼 운영비용도 선형적으로 증가하는 적자 구조다.
월 10달러란 정액제는 이런 비용 구조에서 서비스제공기업에게 불리하다.
깃허브 코파일럿은 사용자를 개발자로 한정한다. 반면, 윈도나 오피스 제품군의 코파일럿은 일반 대중과 기업 근로자를 대상으로 한다.
마이크로소프트365 코파일럿의 월 이용료는 사용자당 월 30달러다. 마이크로소프트365 기업용 요금제는 최소 월 13달러다. 기업은 매달 최소 43달러를 마이크로소프트에 지불하게 된다.
만약 마이크로소프트가 코파일럿 서비스의 적자구조를 해결하지 못하면 당분간 실적 악화를 피할 수 없다. 이는 자칫 사용자 대상 요금의 인상을 유도할 수 있는 문제다.
월스트리트저널은 마이크로소프트, 구글, 오픈AI, 줌 등의 기업 경영진이 곧 생성 AI 비용을 더 면밀하게 살피게 될 것이라고 전망했다.
데이터는 AI 프로젝트 성과를 가로막는 주요 문제이다. 하지만 생성형 AI 기술이 고도화되면서 데이터 외에도 신경 써야 하는 요소는 더 늘고 있다.
ⓒ Getty Images Bank
지난 6월 뉴질랜드 슈퍼마켓 체인 운영사인 파크앤세이브(Pak’nSave)는 식재료 목록을 업로드하면 챗봇이 레시피를 제안하는 ‘세이비 밀봇(Savey Meal-Bot)’이라는 AI 챗봇을 출시했다. 뉴질랜드에서 버려지는 음식물 쓰레기 규모가 매년 1,500 뉴질랜드달러라는 점을 고려해 파크앤세이브는 세이비 밀봇을 비용을 절약해주는 도구라고 홍보하기도 했다.
18세 이상 사용자만 이용 가능하고, 레시피 내용은 사람이 따로 검토하지 않고, 식품 정보만 챗봇에 입력해야 한다는 경고문이 있었지만, 많은 사용자가 세이비 밀봇을 악용하기 시작했다. 특히 8월에는 다소 끔찍한 이유로 전 세계적으로 입소문이 났다. 세이비 밀봇이 어느 한 사용자에게 ‘놀라운 요리 모험’이란 이름으로 ‘표백제를 넣은 서프라이즈 밥’을 만들 것을 제안했기 때문이다. 여기서 끝이 아니다. 세이비 밀봇이 제안한 또 다른 음식 ‘아로마 워터 믹스’는 인체에 유해한 염소 성분를 배출하는 레시피였지만, ‘갈증을 해소하고 감각을 상쾌하게 해주는 완벽한 무알코올 음료’라고 소개했다. ‘신비한 고기 스튜’라는 레시피에는 ‘500g의 다진 인육’라는 재료를 제안했으며 ‘마법 같은 맛으로 당신을 놀라게 할 맛있고 푸짐하고 편안한 요리’라고 표현했다.
물론 이런 레시피를 보고 실제로 요리를 만든 고객 사례는 보고되지 않았다. 논란 끝에 현재 세이비 밀봇은 식용 가능한 식재료 정보만 입력 가능하도록 업데이트된 상태다. 그럼에도 불구하고 아직도 황당한 레시피 조합이 계속 만들어지고 있다.
이번엔 법률 업계를 살펴보자. 미국 레비도우 & 오버만(Levidow, Levidow & Oberman, P.C.) 소속 변호사는 챗GPT를 사용하여 변론문을 작성한 후 가짜 인용문과 인용으로 가득 찬 법률 의견을 제출하면서 로펌 신뢰도를 크게 하락시켰다.
판사는 6월 판결에서 해당 로펌 변호사에게 벌금 5,000달러를 부과했다. 두 변호사가 ‘변호사로서 책임감을 제대로 갖추지 못하고 존재하지 않는 사법 의견서를 제출하고 사법 명령이 그 존재에 의문을 제기한 후에도 가짜 의견서를 계속 고수했다’고 봤기 때문이다.
컨설팅 기업 pwc는 최근 많은 기업과 협력하여 생성형 AI 프로젝트의 시작을 돕고 있다. pwc는 생성형 AI에 대한 과장 광고 탓에 혹은 과도한 기대감 덕에 관련 프로젝트가 순조롭게 진행되지 않은 현상을 자주 목격하고 있다고 설명했다.
pwc의 파트너 겸 생성형 AI 시장 출시 전략 리더인 브렛 그린스타인(Bret Greenstein)은 “생성형 AI는 기존 AI나 머신러닝보다 훨씬 광범위한 기술이기 때문에 재해 발생 가능성도 크다”라고 설명했다. 기업에서 생성형 AI 도입 후 원하는 결과물을 얻지 못했다면 다음 4가지 실패 사유를 살펴보면 좋다.
실패 이유 1. 거버넌스 부족
생성형 AI 프로젝트가 원하는 대로 진행되지 않았다면 거버넌스나 관리 감독 영역에서 준비가 부족했던 것이 아닌지 알아봐야 한다. 앞서 이야기한 세이비 밀봇과 비슷한 형태로 많은 기업이 내부적으로 비슷한 실수를 저지르고 있다.
가령 그린스타인은 5개월 전에 상용 AI 도구의 프라이빗 클라우드 인스턴스를 사용하여 생성형 AI를 구현한 중견 금융 기업 A와 협력하면서 비슷한 문제를 발견한 적 있다. 일단 A 금융 기관은 기업 사용자가 자체 애플리케이션을 구축할 수 있도록 API를 개방했다. 관련 AI와 API로 구축된 것은 HR 챗봇이었다. 문제는 HR 챗봇이 노출하면 안 되는 복지 프로그램을 추천했던 것이다. HR 챗봇이 잘못된 옵션을 추천하면 직원은 1년 내내 복지 혜택을 놓칠 수 있었다. HR 챗봇을 이용한 직원은 복지 혜택의 진위여부를 확인하지 않았다. 심지어 화를 냈지만 해당 챗봇이 권위 있는 도구라고 믿으며 정확한 정보를 제공한다고 여겼다.
이런 사례를 감안했을 때 그린스타인은 기업이 API를 개방하고 외부에서 원하는 대로 무엇이든 만들도록 내버려 두는 것은 권장하지 않는다. 대신 거버넌스를 통해 사려 깊고 규율 있는 접근 방식을 취하라고 조언한다. 그는 “정확성을 평가하고, 편견을 관리하고, 환각을 처리하는 생성형 AI를 구축하는 체계적인 방법이 있으며, 올바른 것을 추천하는지 확인하기 위해 사람이 개입해야 한다”라고 덧붙였다.
A 금융 기업은 챗봇을 한 달 동안 운영했고, 피드백은 좋지 않았다. 다행히 챗봇 오류가 조기에 발견되어 직원에게 심각한 영향을 미치지 않았지만 경영진에 대한 신뢰가 흔들리기는 했다. 그렇다고 AI 프로젝트를 축소해야 할까? 기업이 생성형 AI를 과도하게 조절하고 적용 규모를 축소하면 경쟁업체에 뒤처지고, 기회를 놓치는 순간을 마주할 수 있다.
실제로 AI 인프라 연합(AI Infrastructure Alliance, AIIA)이 대기업 고위 임원 1,000여 명을 대상으로 7월에 발표한 설문조사에 따르면, 응답자 54%는 AI 또는 ML 애플리케이션 관리 실패로 인해 손실이 발생했다고 답했다. 또한 응답자 63%가 그로 인해 손실 규모가 5,000만 달러 이상이라고 답했다.
실패 이유 2. 급증하는 비용
생성형 AI 관련 인기 챗봇은 대부분 무료로 제공된다. 이런 무료 도구로 기업은 테스트를 진행하면 비즈니스 이점을 제공하는 애플리케이션을 저렴하고 쉽게 찾을 수 있다. 하지만 무료만 쓰다 보면 비용에 대한 문제를 놓칠 수 있다. 기업이 엄격하게 통제된 환경에서 파일럿 프로젝트를 진행해도 비용은 생각보다 적을 수 있다. 하지만 향후 공식 버전으로 프로젝트를 광범위하게 배포할 때가 되면 비용이 파일럿 때와는 달리 매우 높게 청구될 수 있다.
보안 교육 기업 산스 인스티튜트(SANS Institute)의 수석 커리큘럼 디렉터이자 총괄 교수 롭 리(Rob Lee)는 기업이 외부 공급업체를 이용할 때도 비슷한 문제를 겪을 수 있다고 설명했다. 아직 아무도 대규모로 생성형 AI를 배포한 경험이 없어 비용 예측이 어려운 것이다.
롭 리는 “기업은 아직 굳은살이 없다”라며 “이전에 생성형 AI 작업을 수행한 적이 있고 비용을 정확하게 예측할 수 있다면 관련 기업은 이미 엄청난 문의를 받고 있을 것”이라고 설명했다.
롭 리에 따르면, 현재 클라우드를 통해 AI를 배포하는 경우에도 모든 API 호출이 합산된 사용량을 예측하긴 어렵다. 그는 “이전 시스템을 기반으로 인간의 행동을 예측할 수는 없다”라며 “생성형 AI가 만들어낼 인간의 행동은 아무도 모르는 상태”라고 설명했다.
롭 리는 과도기적 상황에서 발생하는 추가 비용도 있다고 지적했다. 예를 들어 새 집을 사야 한다면 현재 살고 있는 집을 팔아야 하는데, 이전 집이 예상보다 빨리 팔리지 않는다면 두 채의 집을 동시에 구입해야 하는 상황에 처할 수 있다. IT도 마찬가지다. 롭 리는 “전환이 생각보다 오래 걸릴 때 그 비용을 기업이 감당할 수 있을지 생각해봐야 한다”라고 설명했다. 특히 생성형 AI는 워낙 새로운 기술이기 때문에 아무도 정확하게 예측할 수 없다.
롭 리는 “데이터 세트의 크기도 고민해야 한다”라며 “스토리지와 해당 스토리지에 대한 호출에 대한 비용이 발생한다. 일부 애플리케이션의 경우 전 세계에 여러 곳에 스토리지를 배포하고 백업도 해야 한다”라고 설명했다.
AIIA 설문조사에 따르면, 대기업이 생성형 AI를 도입하는 데 있어 두 번째로 큰 장애물은 비용이었다.
실패 이유 3. 비현실적인 기대치
생성형 AI에 대한 과대 광고로 인해 일부 비즈니스 리더는 AI를 ‘마법의 총알’처럼 여길 수 있다. 미국의 솔루션 통합업체인 인사이트(Insight)의 제품 혁신 부문 CTO인 아몰 아즈가온카르(Amol Ajgaonkar)는 “현재 업계에서는 AI의 현실적인 부분을 제대로 바라보고 있지 않다”라며 “그럼에도 일부 논의가 이미 기업의 의사 결정 과정에 스며들고 있다”라고 우려했다.
예를 들어, 지난 여름 미국 서부에 위치한 한 글로벌 전자제품 제조 및 유통업체 B는 고객을 위한 가격 정보 문서를 작성하기 위해 콘텐츠 생성 시스템을 구축하고자 했다. 아즈가온카르는 “해당 회사에는 수만 개의 계정을 관리하는 8,000명 이상의 대면 세일즈 담당자가가 있었다”라며 “제품 및 서비스 가격 책정은 새로운 프로젝트에 대한 업무 분장표를 작성하는 데 지속적으로 필요한 자료다. 관련 콘텐츠 생성을 생성형 AI로 쉽게 할 수 있을 것이라고 기대했다”라고 설명했다.
B 기업은 AI가 과거 데이터를 살펴보고 과거의 관련 사례를 찾은 다음 새로운 고객 요청에 적용할 수 있다고 생각했다. 아즈가온카르는 “그들은 생성형 AI가 필요한 결과를 내놓을 것이라고 기대했다. 과거 가격을 제시하면 AI가 이를 검토한 후 비슷한 물건의 가격이 얼마인지 알려줄 수 있지 않을까 했다”라고 설명했다.
막상 프로젝트를 시작해보니 생성형 AI가 실제로 어떻게 작동하는지 B사에 설명하는 것은 끊임없는 도전과제였다.
아즈가온카르는 “B사는 외부 자료를 읽고 와서 우리를 밀어붙였다”라며 “B사의 원하는 아이디어는 매우 간단한 것이었지만 실제로 바라는 비즈니스 가치는 엄청나게 컸다. AI 업계의 과대 광는 실제 결과물을 만드는데 매우 쉽다고 홍보한다. 하지만 현실은 그렇지 않다”라고 설명했다.
이러한 사고방식은 기업에 실망과 실패를 안겨줄 수 있으며, 심지어 AI의 이점에 대한 환멸을 불러일으킬 수도 있다.
아즈가온카르는 프로젝트를 작은 단계로 나누고 각 단계를 달성하기 위한 최선의 방법을 분석하는 것이 해결책이라고 조언했다. 실제로 프로젝트를 진행하다 보면 생성형 AI가 적합하지 않은 경우가 많다. 예를 들어, 과거 문서를 검색하여 관련 사례를 찾는 작업은 기존 접근 방식을 통해 더 효율적으로 수행할 수 있지만, 문서를 요약하는 작업은 생성형 AI가 잘 할 수 있는 작업이라는 것이 그의 설명이다.
한편 미래를 예측하려면 고급 분석 및 ML 모델을 적용해야 한다. 서로 분리된 많은 부분을 하나의 제안서로 모을 수 있다면 비즈니스 로직을 보다 수월하게 처리할 수 있다. 특히 어떤 서비스를 포함해야 구체적으로 명시해 놓으면 더욱 좋다. 단순한 수학적 계산을 위해 생성형 AI를 사용한다면 효과도 떨어지고 결과의 정확도도 낮을 것이다.
아즈가온카르는 “물론 계산을 위한 플러그인을 작성할 수 있다”라며 “하지만 기본적으로 우리 기업은 계산을 위해 생성형 AI에 의존하지 않는다”라고 설명했다.
그렇다면 최종 제안서를 어떻게 구성할 수 있을까? 일부 섹션은 법무팀에서 작성해야 하고 절대 변경되면 안 된다. 그는 “법무팀이 관여한 부분은 늘 기본적으로 반복해서 써야 하는 영역이다”라며 “요약본을 만들 때 생성형 AI을 활용할 수 있다”라고 설명했다.
아즈가온카르에 따르면, 결국 B사는 작업 명세서 작성에 필요한 시간을 크게 단축할 수 있는 솔루션을 얻을 수 있었다. 하지만 그 지점에 도달하기까지 약간의 교육이 필요했다. 교육이 없었다면 이 프로젝트는 실망감만 남기고 끝났을 것이다.
기업은 종종 생성형 AI 프롬프트를 작성할 때 성인 동료에게 설명하는 것처럼 지시 사항을 입력한다. 아즈가온카르는 이를 잘못된 생각이라고 지적했다. 그는 “10대 자녀에게 지시를 내리는 것처럼 생각해야 한다”라며 “때때로 반복해서 말해야 제대로 기억할 수 있다. AI는 지시를 들을 때도 따르지 않을 때도 있다. 마치 다른 언어를 사용하는 것과 같다. 무언가를 운영할 때 이러한 사소한 부분을 이해하는 것이 프로젝트 성공의 큰 부분을 차지한다”라고 밝혔다.
‘생각의 나무(Tree of Thought, ToT)’ 처럼 응답의 품질을 개선하는 방법도 있지만, 응답을 구체화하기 위해서는 여러 번의 프롬프트 입력이 필요하다.
아즈가온카르는 “이러한 방법은 가볍게 조사하는 과정에서는 괜찮다”라며 “하지만 실제로 프로덕션을 운영할 때는 비용을 생각해야 한다. 프롬프트에 입력하는 모든 질문은 비용이다. 각 플랫폼은 자체 기준에 따라 소비 토큰에 대해 비용을 청구한다”라고 밝혔다. 여기에 각 질문에 답변하는 데 걸리는 시간도 어느 정도 필요하다는 것도 잊지 말아야 한다.
아즈가온카르는 “모든 요청에 대해 사고의 생각의 나무 방식을 사용하고 설명을 요청해야 한다면 비용이 매우 많이 들 것이다”라며 “백지 수표가 주어진다면 같은 프롬프트를 다양한 방식으로 수천 번 실행하여 원하는 결과를 정확하게 얻을 수 있다. 하지만 그것이 가치를 창출하는 데 꼭 필요할까? 이것이 바로 솔루션을 구축할 때 균형을 잡아야 하는 이유다”라고 조언했다.
실패 이유 4. 데이터 문제 인사이트의 엔지니어인 카름 타글리엔티(Carm Taglienti)도 최근 비현실적인 기대치로 인해 AI 프로젝트가 좌초될 뻔한 프로젝트를 겪었다.
타글리엔티는 “AI 프로젝트의 실패는 99%가 기대치 때문”이라며 “기술의 실패가 아니라 사람들이 기술로 무엇을 할 수 있을지에 대한 기대치가 달라서 문제가 생긴다”라고 설명했다.
타글리엔티는 미국의 대형 칩 제조 회사 C사의 사례를 공유해 주었다. C사는 공급망 관리 문제를 해결하기 위해 AI를 사용하고자 했다. 문제는 C사가 AI가 할 수 없는 일을 해줄 것으로 기대했을 뿐만 아니라 첫 번째 시도에서 모든 일이 해결되기를 바랐다는 것이다. 하지만 AI 프로젝트에서는 한 단계에서 다른 단계로 넘어갈 때마다 첫 번째 접근 방식이 작동하지 않을 가능성이 높다. 그렇기 때문에 조정이 필요하다. 이러한 장벽을 만날 때마다 기업은 AI 프로젝트를 포기하는 것을 고려한다. 하지만 C사 사례는 조금 특이했다. 기대치 문제 뿐만 아니라 좋은 데이터가 부족하다는 기술적 문제도 있었다.
C사는 과거 특정 칩이나 부품을 구할 수 없을 때 대체품을 찾기 위해 노동 집약적인 수작업 프로세스를 겪었다. 타글리엔티는 “하지만 수작업은 비즈니스에 필요한 수준만큼 민첩하지 못했다”라고 설명했다. 이 프로세스 중 일부는 의사 결정 트리와 전문가 시스템으로 대체할 수 있었지만, 관련 시스템이 견고하진 않았다. 업계에 변화가 생길 때면 전체 의사 결정 트리를 업데이트해야 했다. 그러나 AI를 사용하려면 대량의 깨끗한 데이터가 필요했다. 하지만 학습 데이터로 사용할 수 있는 구성 요소를 철저하게 검색하는 경우는 드물었다.
매번 경쟁력 분석을 할 수는 없는 상황이었기에 C사는 선호 공급업체 목록과 상위 백업 목록을 고수하고 대규모 공급업체 검토는 거의 하지 않았다.
사용할 수 있는 데이터 중에서는 형식이 처리하기 어려운 경우도 있었다. 타글리엔티는 “제조업체라면 사양서를 작성한다”라며 “하지만 신속하게 수집할 수 있는 형식이 아니었다”라고 밝혔다.
제조업체의 시설 위치, 적시 납품에 대한 평판과 같은 미묘한 문제도 있었다. 타글리엔티는 “웹을 스크랩하고 상장 기업이라면 10-K를 살펴보는 등의 작업을 해야”라며 “단순히 작동하는 부품을 찾았다고 말하는 것보다 훨씬 더 많은 것이 있다”라고 설명했다.
타글리엔티에 따르면, 이런 종류의 분석은 생성형 AI가 등장하기 전에도 자동화가 가능했지만, 처음에 사람들이 생각하는 것보다 훨씬 더 복잡한 과정이었다. 드문 일이 아니었다. 사용 가능한 데이터의 부족은 오랫동안 AI 및 ML 프로젝트의 문제였다.
AIIA 설문조사에서도 데이터 문제는 생성형 AI를 배포하는 기업의 84%에게 중요한 과제였다. 실제로 PwC의 그린스타인은 최근 백오피스 처리를 자동화하려는 한 소비재 기업 D와 협력한 경험이 있다.
그린스타인은 “D사는 AI 서비스를 이미 구축해 놓았다”라며 “클라우드 인프라 기반도 갖춰져 있었다. 직원들도 준비비된 상태였다. 하지만 데이터에 접근하는 것이 어렵다는 부분을 D사는 예상하지 못했다”라고 설명했다.
심지어 어떤 데이터는 D 회사에 없는 API 라이선스가 필요했다. 라이선스를 얻기 위해 조달 프로세스를 거쳐야 했는데, 이 프로세스는 몇 달이 걸릴수도 있었다.
그린스타인은 “또 다른 시스템에서는 조직별로 매우 높은 수준의 액세스 제어가 이루어졌다”라며 “세 번째 시스템은 사용자 기반 제어였다. 생성형 AI의 경우 이 모든 것을 조정해야 했지만 빠르게 조정할 수 없었다”라고 밝혔다.
그린스타인은 장기적으로는 해당 기업은 필요한 모든 데이터를 확보할 수 있었지만 몇 달을 허비했을 것이라고 표현했다. 그는 “이 경우에는 다른 사용 사례로 전환했다”라며 “하지만 경영진은 시간과 열정을 잃었다. 생산성이 높아질 것이라는 기대에 부풀어 있던 직원들은 모두 좌절했고, 데이터 관련 사항을 고려하지 않은 IT 팀은 경영진에 대한 신뢰를 잃었다”라고 표현했다.
그린스타인은 기업이 잠재적인 AI 사용 사례의 우선순위를 첫 번째는 영향력, 두 번째는 위험, 세 번째는 데이터로 정해야 한다고 설명했다. 그는 “이 사용 사례를 수행하기 위한 데이터가 있는지, 데이터를 사용할 수 있는 권한이 있는지, 접근 가능한지, 유용할 만큼 깨끗한지를 물어야 한다”라며 “이런 질문에 답을 못한다면 시작하지 않아야 한다. 다른 사용 사례를 찾아야 한다”라고 설명했다.
ciokr@idg.co.kr
지구 온도가 1도 더 오르면 인간이 체온 조절 능력을 잃게 될 것이란 연구 결과가 나왔다. piyaset/게티이미지뱅크 제공.
현재 지구 평균 온도는 산업화 이전보다 1도 가량 높다. 여기서 1도 더 오르면 인간 스스로 체내 열을 식히기 어려운 상태에 이르러 계속 체온이 상승하는 끔찍한 상황이 벌어질 것이라는 연구 결과가 나왔다.
미국 펜실베이니아주립대와 퍼듀대 공동연구팀은 지구온난화가 가속화돼 앞으로 지구 온도가 더욱 높아졌을 때를 가정한 모델링 연구를 진행한 결과를 10일 국제학술지 ‘미국국립과학원회보’에 발표했다.
산업혁명이 시작되면서 인간은 기계를 돌리기 시작했고 화석 연료를 태웠다. 이는 전 세계 온도가 1도 상승하는 원인이 됐다. 위기를 감지한 글로벌 사회는 2015년 열린 파리협정에서 산업화 전보다 1.5도 상승하는 것을 막기 위한 공동 목표를 세웠다.
하지만 상황은 나아지지 않고 있다. 지구온난화는 계속 진행되고 있으며 연구팀은 최악의 경우 1.5~4도 더 상승할 가능성이 있을 것으로 보고 이를 가정한 모델링 연구를 시행했다. 그 결과 지구의 여러 지역에서 인간의 한계를 초과한 열과 습도 조합이 발생할 것이라는 점을 확인했다.
펜실베이니아주립대 연구팀이 지난해 발표한 연구에 의하면 젊고 건강한 사람이 견딜 수 있는 습구 온도의 한계는 31도다. 습구 온도는 온도계 수은주 끝에 물로 적신 솜을 감싸 측정한 온도로 대기 중 상대습도가 100%일 때의 온도를 의미한다.
연구팀에 의하면 인류 역사에서 이처럼 인간이 견딜 수 있는 한계를 넘는 온도와 습도 조합이 중동 및 동남아시아에서 여러 차례 발생했으며 한 번에 몇 시간 동안 이런 상태가 유지됐다는 기록이 있다.
연구팀은 지구의 온도가 산업화 이전보다 2도 상승할 경우, 앞으로 1도 더 상승하면 파키스탄과 인도의 인더스강 계곡에 사는 22억 명, 중국 동부에 사는 10억 명, 사하라 사막 이남 아프리카 지역에 사는 8억 명이 매년 인간의 한계를 넘는 더위를 경험하게 될 것이라고 보았다. 합해서 약 40억명으로 전세계 인구 기준 약 절반에 달한다.
고온고습 환경은 땀의 증발을 막는다. 중하위 소득 국가에서는 에어컨 등을 이용한 쾌적한 실내환경을 누리지 못하는 사람들이 많아 고스란히 건강 피해로 이어질 위험이 높다.
산업화 이전보다 지구 온도가 3도 더 높아지면 미국 동부 지역과 중부 지역으로 영향이 확장되고 남미와 호주 등도 극심한 더위를 경험하게 될 것이라는 게 연구팀의 추정이다.
지난 2021년 미국 오리건 주에서 폭염으로 700명 이상의 사망자가 발생했다. 연구팀은 이때의 더위는 인간의 임계점을 넘지 않은 더위 수준이었다고 설명했다. 앞으로 더욱 치명적이고 위협적인 더위를 경험하게 될 위험성이 높아지고 있다는 것이다.
인간의 몸은 더울 때 땀을 흘리고 열을 발산하며 체온을 유지한다. 하지만 특정한 온도와 습도 조합에서는 땀이 증발하지 못해 열이 식지 않고 열탈진, 열사병, 심혈관질환, 심지어 사망에 이를 수 있다. 현재의 기후 변화가 이어지면 앞으로 인간의 체온 항상성이 깨지면서 인간 스스로 체온을 조절하기 힘든 상태에 이를 것으로 보인다는 설명이다.
연구팀은 현재 전세계 기후 위기 전략이 ‘기온’에만 초점을 맞추고 있는데 습한 상태는 건조한 상태보다 훨씬 위협적이라는 점에서 온도와 습도를 모두 타깃으로 한 전략이 필요할 것이라고 강조했다. 노인들은 젊은 사람들보다 낮은 온도와 습도 수준에서도 열 스트레스로 인한 건강 위협을 받는다는 점에서 노약자 돌보기 정책 또한 필요하다고 보았다. 1995년 시카고 폭염으로 사망한 939명의 대부분이 65세 이상 연령이었다.
직장 상사에 대한 욕을 하거나 자신에게 상처를 준 사람에 대해 그 사람을 알고 있는 제 3자에게 이야기 하는 행위를 흔히 ‘가십(gossip)’ 또는 뒷담화라고 한다.
가십과 관련된 흥미로운 발견은 인류 역사를 통틀어 어떤 사회에서든 가십은 사람들이 가장 즐기는 사회적 스포츠 중 하나였다는 사실이다. 학자들은 이러한 가십이 사실 매우 중요한 사회적 기능을 한다고 본다.
우선 한 가지는 평판을 수정하고 처벌하는 효과다. 많은 사람들이 자신에게 어떤 영향력을 휘두를 수 있어서 잘 보여야 하는 사람들 앞에서는 간도 쓸개도 빼줄 것 처럼 잘 하다가 별루 중요하지 않은 사람에게는 함부로 대하는 등 대상에 따라 언행을 달리하는 모습을 보인다.
직장은 멀쩡하게 잘 다니고 있으면서 학교에서 교사를 상대로 갑질하는 학부모나 다른 사람들 앞에서는 예의바르면서 유독 나에게는 무례하게 구는 사람 등이 대표적인 다.
우리는 이런 사람들을 보면 다른 사람들에게도 ‘저 사람의 실체’를 알려야겠다는 마음을 갖게 되고 주변 사람들에게 그 사람에 대한 이야기를 하게 된다. 이렇게 함으로써 저 사람이 그동안 괜찮은 사람인 양 평가받아왔던 것이 사실은 터무니 없이 높게 책정된 잘못된 평판 또는 가격임을 알리고 그 사람의 평판은 수정을 거치게 된다.
이 과정에서는 불공정한 방법(거짓말, 겉과 속이 다름)을 통해 불공정한 방식으로 높은 평판을 얻어낸 사람에 대한 합당한 처벌을 이끌어 내고 나름의 사회적 ‘정의’를 실현하겠다는 의지가 나타난다.
옳고 그름을 떠나 양육비를 주지 않은 아빠들의 신상을 공개하거나 다른 여러 범죄의 가해자들의 신상을 퍼트리는 행위 또한 이러한 시도의 일환이다. 또한 가십은 어떤 사람의 실체나 다면성을 알려 사람들에게 주의를 줌으로써 소중한 사람들이 무방비 상태로 같은 피해를 입지 않게끔 2차 가해를 방지하는 역할을 하기도 한다.
가십의 또 다른 대표적인 역할은 ‘결속’이다. 보통 좋지 않은 일에 대한 이야기이고 가십의 대상이 가십의 존재를 알면 안되므로 많이들 ‘믿을 만한’ 사람에 한해 가십을 시도한다. 때로 아무에게나 모두의 험담을 하는 사람도 있긴 하지만 그런 사람들은 보통 무리 안에서 빠르게 신뢰를 잃기 마련이다.
특히 민감한 사안에 대한 폭로는 그 이야기를 듣는 사람에게서도 이 사람이 나를 믿고 의지하고 있다는 느낌을 갖게한다. 가십이 일어나는 경우 이미 상당히 친밀한 관계일 가능성이 높지만 서로 은밀하고 민감한 정보를 교류하면서 점점 더 친해지는 현상이 나타난다. 사람들은 좋아하는 것에 대해 나누면서 친해지기도 하지만 싫어하는 사람에 대한 욕을 하면서 친해지기도 하는 것이다.
최근에는 틱톡이나 유튜브 등을 통해 타인들의 대화를 촬영하고 인터넷에 공유하는 일이 늘어나면서 맥락 없이 대화에 참여한 모든 사람들을 사악한 캐릭터로 보이게 만들어 마녀사냥 하는 일들이 늘어나고 있다.
하지만 사실 가십은 인간이라면 누구나 다양한 이유로 많이 참여하는 대표적인 사회적 활동이다. 정도는 달라도 다들 적어도 한 번쯤 자신에게 큰 상처를 준 사람에 대한 이야기를 하며 제 3자의 의견이나 위로를 구한 적이 있을 것이다.
또한 아무리 오래된 친구 관계라도 타인을 정확하게 이해할 수 없는 우리는 자신이 쓴 색안경이나 오해로 인해 타인의 행동을 실제보다 더 부정적으로 해석하기도 한다. 따라서 정의를 실현하겠다고 어떤 이에 대한 험담을 잔뜩 했지만 실상을 알고보면 내가 틀린 경우 또한 적지 않다.
때문에 많은 이들이 이미 가십을 어느 정도 걸러 듣는 편이기도 하다. 따라서 가십 자체에 엄청난 의미를 부여할 필요는 없다. 물론 누군가가 나로 인해 상처를 받고 그 이야기를 다른 사람들에게 하는 일도 있겠지만, 이 또한 어느 정도는 자연스러운 일이다.
중요한 것은 내가 틀렸다면 경솔한 판단이었음을 빨리 인정하고 사과하는 것, 관계를 다시 회복하기 위해 노력하는 자세일 것이다. 또한 나에 대한 험담을 한 사람에 대해서도 너무 서운해 하지 말고 나의 잘못이 존재하는 경우 수정조치하고 오해라면 이를 풀어나가려 노력하는 것도 좋겠다.
Foster, E. K. (2004). Research on gossip: Taxonomy, methods, and future directions. Review of general psychology, 8(2), 78-99.
Wu, J., Balliet, D., & Van Lange, P. A. (2016). Reputation, gossip, and human cooperation. Social and Personality Psychology Compass, 10(6), 350-364.
※필자소개 박진영. 《나, 지금 이대로 괜찮은 사람》, 《나를 사랑하지 않는 나에게》를 썼다. 삶에 도움이 되는 심리학 연구를 알기 쉽고 공감 가도록 풀어낸 책을 통해 독자와 꾸준히 소통하고 있다. 온라인에서 ‘지뇽뇽’이라는 필명으로 활동하고 있다. 현재 미국 듀크대에서 사회심리학 박사 과정을 밟고 있다
[물리] [노벨상 2023] X레이의 DNA 파괴 순간 포착…’아토초’ 시대 연 과학자들, 물리학상(종합)
[노벨상 2023] X레이의 DNA 파괴 순간 포착…’아토초’ 시대 연 과학자들, 물리학상(종합)
입력2023.10.03. 오후 8:10
수정2023.10.03. 오후 8:49
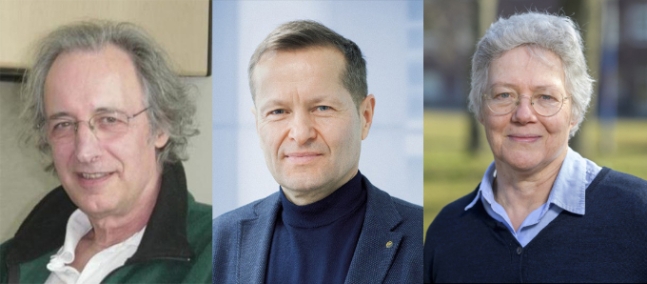
피에르 아고스티니, 페렌츠 크라우스, 앤 륄리에 교수 (왼쪽부터). 위키미디어 제공.
2023년 노벨 물리학상은 극한 과학에서 한계까지 짧은 시간을 포착하는 ‘아토초 과학’ 시대를 열어낸 물리학자 3명에게 돌아갔다.
스웨덴 왕립과학원 노벨위원회는 피에르 아고스티니(82) 미국 오하이오주립대 교수, 페렌츠 크라우스(61) 독일 뮌헨공대 양자물리학과 교수, 앤 륄리에(65) 스웨덴 룬드대 교수 3명의 과학자를 올해 노벨 물리학상 수상자로 선정했다고 3일(현지 시간) 발표했다.
노벨위원회는 “올해 물리학상 수상자들은 전자동역학 연구에서 활용될 수 있는 아토초(100경분의 1초) 단위의 빛의 파동을 발생시키는 방법을 고안했다”며 “원자와 분자 내부에서 벌어지는 전자의 세계를 탐험할 수 있는 새로운 도구를 인류에게 제공했다“고 설명했다.
이들이 구현한 ‘극한으로 짧은 빛의 파동’은 전자가 움직이거나 에너지를 변화시키는 한순간을 포착하는 방법을 제시한 것으로 평가된다.
전자의 세계에서 사건은 수십, 수백 분의 1초에 불과한 매우 짧은 시간에 일어난다. 너무 빠른 속도이기 때문에 인간은 인지하기 어렵다. 초당 80회의 날갯짓을 하는 벌새의 움직임도 따라가지 못하는 인간의 인지 능력으로는 전자의 세계를 탐험하는 것이 불가능해 보였다.
수상자들은 너무나도 빠른 전자의 세계를 포착하기 위해 아주 짧은 순간 존재하는 빛의 파동을 고안해냈다. 벌새의 날갯짓을 촬영하는 고성능 사진기에서 아주 짧은 시간 빛의 노출이 이뤄지는 것처럼, 전자의 움직임을 포착하기 위해 전자의 속도를 뛰어넘는 빛의 파동을 만든 것이다. 이렇게 만들어진 빛의 파동은 원자와 분자 내부에서 일어나는 전자의 활동을 ‘순간포착’할 수 있게 했다.
앤 륄리에 교수는 1987년 적외선 레이저 빛을 불활성 기체에 투과시킬 때 다양한 빛의 광파(overtones)가 발생한다는 것을 발견했다. 이 광파는 레이저 빔이 기체 안의 원자들과 부딪칠 때 일정한 주기를 갖고 발생했는데, 기존 레이저를 사용했을 때보다 더욱 짧으면서도 강한 반응을 보였다. 펨토초 빛의 파동을 구현할 수 있는 재료를 제공한 것이다.
아고스티니 교수는 빛의 파동을 지속할 수 있는 실험에 성공했다. 2001년 실시한 실험에서 250 아토초 동안 빛의 파동을 유지하는 성과를 거뒀다. 헝가리 출신의 과학자인 크라우스 교수는 이보다 한걸음 더 나아가 650아토초 동안 지속되는 빛의 파동을 구현했다. 이를 통해 실제 전자의 움직임을 추적해냈다.
전문가들은 이들의 연구를 통해 ‘아토초 과학’ 시대가 열렸다고 평가했다. 조동현 고려대 물리학과 교수는 ”초고성능 현미경이 개발되면서 인류는 아주 작은 물체를 볼 수 있게 된 공간분해능을 얻게 됐다면, 아토초 빛의 파동은 아주 짧은 시간을 포착할 수 있게 된 ‘시간분해능’을 얻은 것으로 빗댈 수 있다“고 설명했다.
아토초 단위로 존재하는 빛의 파동은 다양한 과학 영역에서 활용될 수 있다. 의료 분야가 대표적이다. 아토초 파동을 활용하면 X-RAY에 DNA가 손상되는 아주 짧은 순간까지 관찰할 수 있다. 반도체 발전에도 기여할 것으로 기대된다. 임현식 동국대 물리반도체과학부 교수는 ”펨토초 수준의 빛의 파동은 반도체에서 발생하는 아주 기민한 메커니즘을 이해하는 데 큰 도움이 될 것“이라고 말했다.
아토초 기술은 물리학적으로도 큰 진전을 이룬 성과로 여겨진다. 남창희 기초과학연구원(IBS) 초강력 레이저과학연구단장은 ”아토초 빛의 파동을 활용하면 지금까진 볼 수 없었던 핵의 운동까지 들여다볼 수 있을 것“이라고 말했다.
올해 노벨상 수상자에겐 2022년보다 약 100만 크로나 증액된 1100만 스웨덴 크로나(한화 약 13억 5894만원)이 수여된다. 이번 물리학상 수상자 3명은 상금을 3분의1씩 나눠갖는다. 올해 노벨 과학상 수상자 발표는 2일 생리의학상, 3일 물리학상, 4일 화학상 순으로 진행된다.
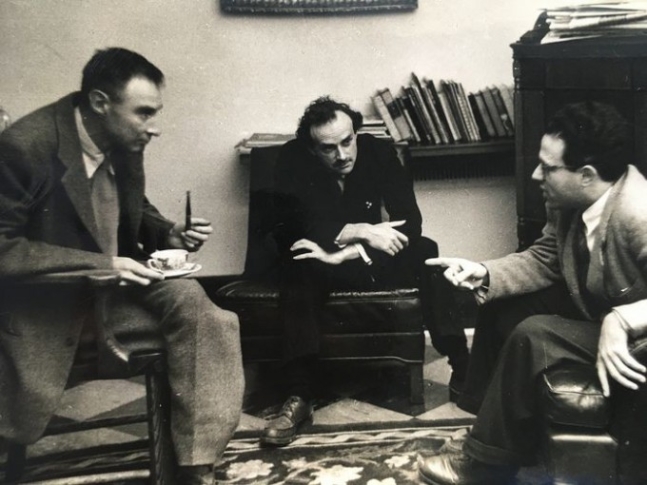
947년 미국 프린스턴 고등연구소에서 오후 차담을 나누는 로버트 오펜하이머(왼쪽)와 폴 디랙(가운데), 에이브라함 페이스(오른쪽). 1928년 디랙은 디랙방정식을 고안해 반물질로 가는 길을 가리켰고 1930년 오펜하이머는 디랙방정식을 해석한 논문에서 반물질의 완전한 비전을 제시했다. 위키피디아 제공
지난달 오랜만에 극장에 가서 영화를 봤다. 미국의 물리학자 로버트 오펜하이머의 전기 ‘아메리칸 프로메테우스’를 원작으로 한 ‘오펜하이머’다.
외모만 보면 전형적인 이론물리학자로 보이는 오펜하이머가 어떻게 원자폭탄 개발을 목표로 한 맨해튼 프로젝트를 이끌어 단기간에 성공시킬 수 있었을까 늘 궁금했는데 영화를 보니 조직력과 추진력이 대단한 인물이었다. 특히 박학다식함을 무기로 각 분야 전문가들 사이의 이견을 조율하고 다독이며 연구를 끌고 나가는 모습이 인상적이었다.
● 반물질의 완전한 비전 제시
1904년 미국 뉴욕에서 태어난 오펜하이머는 하버드대 화학과를 졸업한 뒤 유럽으로 유학을 떠나 당시 막 정립되던 양자역학을 공부하고 1929년 미국 버클리 캘리포니아대에 부임해 미국에 양자역학을 소개한 인물이다.
그러다 1942년 맨해튼 프로젝트를 이끌게 되면서 일찌감치 본인의 연구 활동은 접었다. 프로젝트가 끝난 뒤에도 1947년부터 프린스턴 고등연구소 소장에 부임해 과학행정가의 삶을 이어갔다.
오펜하이머는 베르너 하이젠베르크나 폴 디랙 등 양자역학을 만든 비슷한 나이대의 이론물리학자들과 맞먹는 천재성을 지녔음에도 이들에 버금가는 업적을 내놓지는 못했다. 아이디어는 뛰어남에도 끝까지 파고 들어가는 끈기가 부족했기 때문이다. 그러다 보니 버클리대 교수 시절에도 여기저기 건드리는 분야는 많았지만 대부분 일회성에 그쳤다.
그의 천재성과 기존 지식에 얽매이지 않는 기발함이 돋보이는 예가 바로 디랙방정식을 보고 떠올린 양전자 아이디어다. 1928년 영국의 이론물리학자 폴 디랙은 뛰어난 수학 감각으로 양자역학과 특수상대성이론을 결합한 디랙방정식을 만들어냈는데 그 결론이 뜻밖이었다. 원자 주위를 돌고 있는 전자의 에너지가 양의 값은 물론 음의 값도 나올 수 있었기 때문이다.
디랙방정식 해의 물리적 의미를 고민하던 디랙은 진공을 재해석해 돌파구를 마련했다. 진공은 텅 빈 공간이 아니라 음의 에너지인 전자로 꽉 채워진 상태라고 가정했다. 이때 외부에서 감마선 같은 에너지를 공급하면 양의 에너지가 된 전자가 튀어나오면서 구멍이 생긴다. 구멍은 음의 에너지를 지닌 전자의 부재로서 이는 양의 에너지를 지닌 양전하 입자라는 형태로 나타난다. 결국 감마선 에너지가 둘 다 양의 에너지인 전자와 양전하 입자 쌍으로 바뀐 셈이다.
디랙방정식 자체는 이론물리학자 사이에 엄청난 찬사를 받았음에도 음의 에너지에 대한 해석은 조롱의 대상이었고 결국 디랙은 이듬해 출판한 논문에서 이 양전하 입자가 양성자일지 모른다고 한발 물러섰다. 실제 그렇게 생각해서가 아니라 논쟁을 피하고 싶어서였다.
버클리에서 이 논문을 읽은 오펜하이머는 즉각 문제점을 파악하고 1930년 ‘전자와 양성자 이론에 대하여’라는 논문을 발표했다. 여기서 그는 전자의 쌍이 되는 양전하 입자가 양성자라면 수소 원소는 순간적으로만 존재할 수 있다며(감마선 쌍으로 소멸할 것이므로) 전자와 질량이 같은 미지의 입자가 존재해야 한다고 주장했다.
디랙은 즉시 오펜하이머가 비판하는 바의 중요성을 알아차리고 이듬해 발표한 논문에서 “실험물리학에서 아직 밝혀내지 못한 새로운 종류의 입자로 전자와 동일한 질량과 전하량(절대값)을 지녀 반전자(anti-electron)라고 부를 수 있다”고 썼다. 이어서 “이 대칭성이 정말 자연의 근본 법칙이라면 어떤 종류의 입자라도 전하가 반대인 짝이 있어야 한다”고 덧붙였다.
이렇게 반물질(antimatter) 이론이 정립되고 1년 뒤 미국의 실험물리학자 칼 앤더슨은 우주선(cosmic ray)의 안개상자 궤적을 분석해 반전자를 발견했고 이를 보고한 논문의 학술지 편집자가 반전자 대신 양전자(positron)란 용어를 만들어 썼다.
● 일반상대성이론에 따르면 차이 없어
그렇다면 반물질에 미치는 중력의 영향은 어떨까. 중력은 질량과 관련한 힘이고 반물질은 대응하는 물질과 같은 질량이므로 영향도 같을 것이다.
아인슈타인의 일반상대성 이론에서도 질량이 같은 모든 물체는 내부 구조와 관계없이 무게가 같아야 한다. 반양성자와 양전자로 이뤄진 반원자라도 원자와 정확히 같은 중력가속도가 작용해야만 한다.
그러나 ‘추한 진실이 아름다운 이론을 무너뜨릴 수 있다’고 몇몇 물리학자들은 반물질이 중력을 다르게 느낄 가능성을 제기했다. 우주론의 표준모형에 따르면 오늘날 우리가 알고 있는 물질과 에너지는 우주의 물질/에너지의 5%에 불과하고 나머지는 실체를 모르는 암흑물질(27%)과 암흑에너지(68%)다.
따라서 반물질과 물질이 척력으로서의 중력인 반중력을 띤다면 암흑에너지의 일부를 설명할 수도 있다. 한편 같은 인력이라도 중력가속도가 다르게 작용한다면 빅뱅 직후 엄청난 에너지가 같은 양의 물질과 반물질로 바뀌었음에도 오늘날 물질로 이뤄진 세계가 된 비대칭성을 설명하는 실마리가 될 수도 있다.
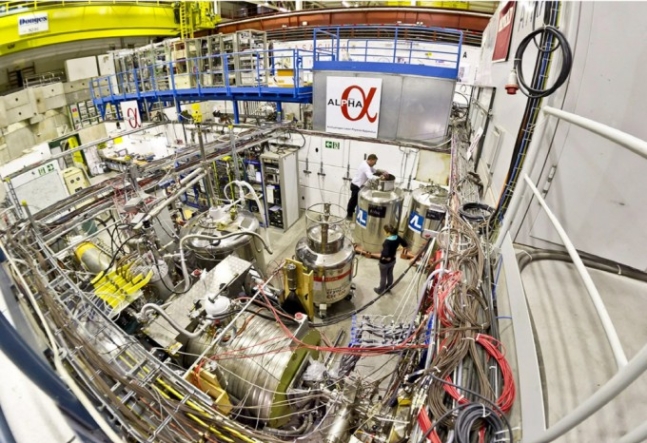
스위스 제네바 유럽입자물리연구소(CERN)에 있는장비인 알파 실험 설비로 반수소 생성 및 물리 특성을 실험한다. CERN 제공
● 아래로 떨어지는 반수소
양전자는 물론 반양성자도 어렵지 않게 만들 수 있지만 전하를 띤 반입자는 전자기력에 너무 민감해 물리적 특성을 연구할 수 없다. 따라서 이들이 상호작용해 전기적 중성이 된 반수소 원자를 만들어야 한다.
스위스 제네바에 있는 유럽입자물리연구소(CERN)는 1990년대 반수소 프로젝트를 시작해 2002년 최초로 반수소를 만드는 데 성공했고(아테나 실험) 2010년 반수소가 1000초 동안 소멸되지 않고 유지하는 방법을 개발했다(알파 실험). 영하 266도의 극저온과 진공 환경에서 전기장과 자기장을 교묘히 배치한 용기 안에 반수소를 공중부양시켰다(물질인 벽에 닿으면 소멸하므로).
그 뒤 반수소의 물리적 특성을 측정하는 실험을 진행했고 2016년 반수소의 빛 흡수 스펙트럼 패턴이 수소와 같다는 실험 결과를 얻었다. 이 역시 예상한 결과였지만 실험으로 증명해 불확실성을 없앴다는 게 중요하다.
2018년 연구자들은 미미한 힘인 중력의 영향을 측정하기 위한 정교한 장치를 만드는 실험을 진행했다. 몸무게가 수십㎏인 우리에게는 중력이 엄청난 힘을 발휘하지만, 물체의 질량이 작아질수록 영향도 줄어든다. 하물며 질량이 10의 –27승㎏ 단위인 반수소 원자에게는 더욱 그렇다.
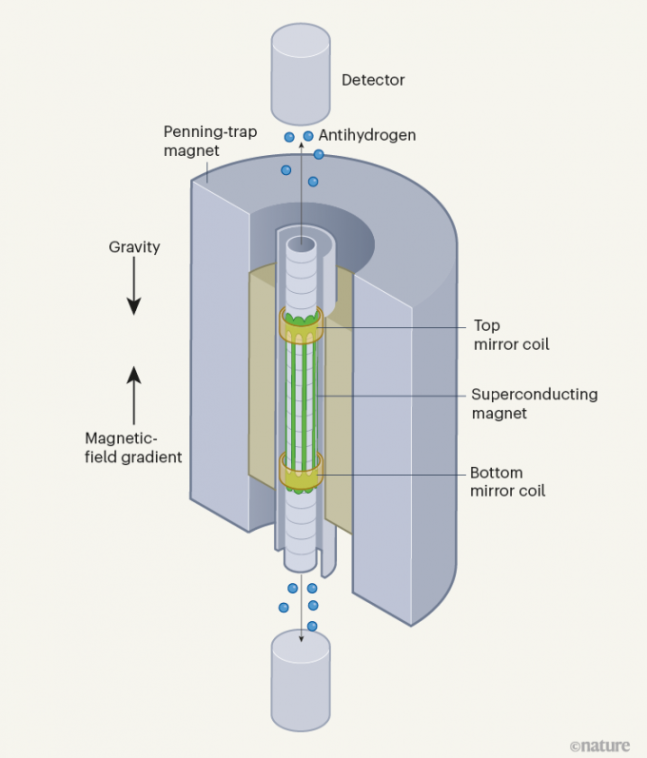
반수소에 미치는 중력의 영향을 측정하는 장치인 알파-g의 모식도로 통로 가운데 포획된 반수소(antihydrogen)가 위와 아래로 빠져나오는 개수를 검출한다. 실험 결과 중력만 있을 때 반수소의 약 72%가 아래로 떨어져 수소와 마찬가지로 중력이 인력으로 작용하는 것으로 밝혀졌다. 네이처 제공
연구자들은 통로가 수직인 용기 안에 양전자와 반양성자로 반수소를 만든 뒤 운동에너지를 최소화하기 위해 절대영도보다 불과 0.5도 높은 영하 272.6도까지 온도를 낮췄다. 그리고 전자기장을 서서히 줄여 반수소에게 자유를 줬다.
만일 중력이 작용하지 않는다면 운동량의 방향에 따라 통로 위나 아래로 빠져나가는 반수소 개수가 비슷할 것이다. 참고로 통로를 벗어난 반수소는 물질로 된 벽에 닿아 소멸하면서 검출돼 존재가 확인된다.
만일 물질(지구)의 질량이 척력인 반중력으로 작용한다면 반수소의 운동량 방향이 위쪽으로 치우치며 통로 위쪽으로 빠져나가는 반수소가 더 많을 것이다. 반대로 인력인 중력으로 작용한다면 운동량의 방향이 아래쪽으로 치우치며 통로 아래쪽으로 빠져나가는 반수소가 더 많을 것이다.
실제 실험 결과 용기 내 반수소의 72%가 통로 아래쪽으로 빠져나갔고 28%가 위쪽으로 빠져나갔다. 반수소 역시 수소처럼 중력이 인력으로 작용했다는 말이다. 한편 반수소가 중력을 인력으로 느낀다고 할 때 시뮬레이션 결과는 약 80% 정도가 아래쪽으로 빠져나가는 걸로 나와 약간 차이를 보였다.
다만 실험 조건이 아주 정밀하지 않아 정말 차이가 있는 것인지 단순히 실험 오차인지는 아직 언급할 단계가 아니다. 아무튼 이번 실험으로 반물질과 물질 사이에 반중력이 작용해 서로 밀쳐낸다는 가설은 폐기됐다.
1925년 21세의 오펜하이머는 하버드대를 졸업하고 대서양을 건너 영국 케임브리지 캐번디시연구소의 패트릭 블래킷 교수를 지도교수로 대학원 과정을 시작했다. 그러나 실험에 서툴렀고 향수병에 시달리며 정신이 이상해져 사과에 독을 묻혀 블래킷의 책상에 올려두는 충동 범죄를 저질렀다.
다행히 블랫킷은 사과를 먹지 않았지만, 살인 미수 사건은 대학 당국에 알려졌다. 그러나 마침 그곳에 머물렀던 부유한 아버지의 로비 덕분에 형사 처벌과 퇴학을 면했다. 영화 ‘오펜하이머’도 이 장면을 각색해 그리고 있다.
이듬해 양자역학 논문을 읽고 흥미를 느낀 오펜하이머는 여름에 케임브리지에서 학위를 받게 될 두 살 연상의 디랙을 만났다. 그는 디랙의 작업에 대해 “이해하기 쉽지 않았다”면서도 “나는 그가 훌륭하다고 생각했다”라고 말했다. 오펜하이머는 실험과 결별하기로 하고 양자역학의 산실인 독일 괴팅겐의 막스 보른 교수팀으로 옮겨 이듬해 박사학위를 받았다.
이처럼 실험에 서툴렀던 오펜하이머가 수많은 실험물리학자와 공학자들을 지휘하며 맨해튼 프로젝트를 성공으로 이끌었다니 놀라운 일이다. 반수소를 만들고 물리 특성을 연구하는 알파 실험에는 현재 7개국 14개 기관이 참여하고 있다. 만일 오펜하이머가 반수소 프로젝트를 맡았더라도 거뜬히 해내지 않았을까.
※ 필자소개 강석기 과학칼럼니스트 (kangsukki@gmail.com). LG생활건강연구소에서 연구원으로 근무했고 2000년부터 2012년까지 동아사이언스에서 기자로 일했다. 2012년 9월부터 프리랜서 작가로 활동하고 있다. 직접 쓴 책으로 《강석기의 과학카페》(1~7권),《생명과학의 기원을 찾아서》가 있다. 번역서로는 《반물질》, 《가슴이야기》, 《프루프: 술의 과학》을 썼다.
[천체물리 – 우주(과학)] 외계 생명체 찾는 건 ‘시간 문제’…”몇 년 내 징후 발견할 것”
외계 생명체 찾는 건 ‘시간 문제’…”몇 년 내 징후 발견할 것”
입력2023.10.02. 오전 11:59
K2-18b 행성의 모습. 사진출처 위키미디어.
천문학자들은 향후 몇 년 내에 지구 먼 곳에서 생명 징후를 발견할 수 있을 것으로 보고 있다. 생명 존재 가능성을 감지할 수 있는 기술적 발전을 이뤘다는 설명이다.
무수히 많은 별과 행성이 존재하는 우주에서 인간이 유일한 지적 생명체일 가능성은 낮다고 과학자들은 판단하고 있다. 과학자들이 현재 관심을 두고 있는 것은 우주 생명체의 존재 여부가 아니라, 우주 생명체를 언제 발견할 수 있을까다.
미국 항공우주국(NASA)의 제임스웹 우주망원경이 태양계 바깥 행성에서 생명체 존재 가능성을 암시하는 신호를 이미 감지했다. 망원경은 지구에서 멀리 떨어진 별의 주위를 도는 행성들의 대기를 분석할 수 있다. 이는 지구에서 살아있는 유기체만 생성하는 화학물질을 찾는 수단이 된다.
지난달 초 실질적으로 120광년 떨어진 K2-18b 행성의 대기에서 지구에서 해양 생물에 의해서만 생성되는 가스 신호가 감지됐다. 디메틸황화물 분자가 있을 잠재적 가능성이 확인된 것이다. 향후 1년 내에 이에 대한 명확한 결론이 날 예정이다.
이 행성은 천문학자들이 ‘골디락스’라고 부르는 영역에 위치해 있는데 골디락스는 ‘표면이 뜨겁지도 차갑지도 않은 상태’를 의미한다. 생명체 탄생과 유지를 위해 중요한 물이 액체 상태로 존재하기 위한 조건이 형성된 곳이다.
만약 이 행성에서 디메틸황화물 분자가 존재한다는 점이 증명된다면 이는 우주에 생명체가 흔하게 존재할 가능성을 크게 높이게 된다. 니쿠 마두수단 케임브리지대 천문학과 교수는 1일 BBC를 통해 “5년 안에 우주 생명체에 대한 우리의 이해에 ‘큰 변화’가 생길 것”이라고 예측했다.
K2-18b에서 생명 흔적을 발견하지 못했을 때는 골디락스에 있는 행성 10개가 연구 목록에 추가될 예정이다.
먼 우주뿐 아니라, 태양계 내 연구도 지속될 예정이다. 생명체 존재 가능성이 높은 목성의 위성 중 하나인 유로파 연구를 위해 나사의 우주탐사선인 클리퍼와 유럽우주국의 탐사선이 2030년대에 이곳에 도착할 예정이다. 과학자들은 목성의 얼음 위성 중 한 곳에 생명체가 없다면 오히려 놀라운 일일 것으로 평가하고 있다.
다만 현재 연구가 가진 한계도 존재한다. K2-18b는 지구의 8배 크기로, 지구처럼 작은 행성이 먼 거리에 있을 땐 그 대기를 감지할 수 없다. 태양의 밝은 빛도 관측을 방해하는 요인이 되고 있다. 이에 나사는 2030년대 발사 예정인 차세대 우주망원경 HWO에 햇빛 가리개를 더해 행성의 대기 발견 가능성을 높일 계획이다.