24 8월 2024

[사회과학] [박진영의 사회심리학] 소속 욕구가 강할수록 상처받는다

[사회과학] [박진영의 사회심리학] 소속 욕구가 강할수록 상처받는다

[박진영의 사회심리학] 소속 욕구가 강할수록 상처받는다
입력
게티이미지뱅크 제공

게티이미지뱅크 제공

● 어떤 사람이 갈등을 잘 풀어갈까

어떤 관계에서든 아무리 좋은 사람을 만나더라도 적어도 한 번 이상 부딪힐 일이 반드시 생기기 때문에 인간관계에서는 어떤 사람을 만나느냐 하는 ‘선택’의 문제 못지않게 어떻게 관계를 ‘유지’해 나갈 것인가가 중요한 문제가 된다.

비슷한 갈등을 마주하게 되어도 어떤 사람들은 인간관계에서 갈등은 자연스러운 일이며 잘 얘기해서 풀어나가면 된다고 담담하게 받아들이는 반면 어떤 사람은 “어떻게 이런 일이!”라며 갈등은 결코 존재해선 안 되는 양 호들갑을 떨고 상대의 가벼운 실수에도 ‘나를 해치려고 일부러’ 그랬다거나 ‘원래 저것밖에 안 되는 사람’이라며 파괴적인 해석을 내려 결국 다른 사람들보다 더 쉽게 파국을 맞이하곤 한다. 이 차이는 어디서 나오는 걸까.

우선 연구들에 의하면 기본적인 성격 특성(높은 신경증)과 애착 유형(불안정 애착), 사람은 (따라서 관계 또한) 잘 변하지 않는다는 믿음(관계에 대한 성장적 관점과 운명론적 관점), 자기 자신이나 타인을 향한 비판적 완벽주의, 또 여러 상황적 요소(많은 스트레스와 걱정거리로 인해 정신적 소모가 심한 상태, 소외감) 등이 한몫하는 걸로 알려져 있다. 이들은 지금까지의 글에서 함께 살펴본 것들이기도 하다.

인격과 사회심리학 공보(Personality and Social Psychology Bulletin)에 실린 한 연구에 의하면 지나치게 강한 ‘소속 욕구’ 또한 너그럽지 않은 모습과 관련을 보인다고 한다.

● 소속 욕구가 강할수록 쉽게 상처받고 상처가 오래간다

“다른 사람들이 나를 받아들여 줬으면 좋겠다”, “나는 소속되고 인정받고자 하는 욕구가 강하다”, “사람들이 나를 받아들여 주지 않으면 나는 쉽게 상처받는다”, “사람들이 나를 빼고 뭔가를 하는 것이 싫다” 이는 소속 욕구(need to belong)를 묻는 문항들이다.

사회적 동물인 이상 인간은 누구나 어느 정도 애정과 인정을 갈구하기 마련이다. 다만 그 ‘정도’가 사람마다 달라서 위의 문항들에 높은 점수를 기록하는 사람이 있는 반면 비교적 그렇지 않은 사람이 있다.

모리시오 카발로 등의 연구자들은 사람들에게 지난 3개월 사이에 가족, 친구, 연인, 직장 동료 등에 의해 상처받거나 화가 났던 일에 대해 적어보라고 했다. 그런 뒤 상대에게 얼마나 보복하고 싶은지, 상대가 얼마나 망했으면 좋겠는지, 앞으로도 계속 볼 것인지 아니면 피해 다닐 것인지 등에 대해 물었다.

그 결과 소속 욕구가 강한 사람들이 그렇지 않은 사람에 비해 상대에게 화가 많이 났고 사건의 심각성을 크게 지각하며 그 사람을 용서할 수 없다고 응답하는 경향을 보였다. 소속 욕구가 강한 사람들은 그렇지 않은 사람들에 비해 이 사람과 계속 관계를 유지하면 미래에 비슷한 일이 또 일어날 것이라고 예상하는 것으로 나타났다.

● ‘내가’ 채워지는 것이 목적일 때 나타나는 보상 심리

언뜻 생각해 보면 사람들에게 사랑받고 인정받고자 하는 욕구가 강하면 상대가 잘못을 저질렀더라도 더 잘 포용하고 관계를 다시 제자리로 돌려놓기 위해 많은 노력을 할 것 같다. 하지만 정반대의 현상이 나타난 이유는 무엇일까.

일반적으로 목표가 간절할수록 많은 애를 쓰기 때문에 목표 달성률이 높아질 것으로 예상할 수 있다. 하지만 간과되는 점은 간절할수록 그것이 좌절되었을 때의 ‘실망’이 크며 때로는 자신의 실패를 받아들이지 못해 ‘이게 다 xx 때문’이라고 외부에 책임을 돌리는 현상도 나타난다는 것이다(Mauss et al., 2011).

인간관계 또한 그렇다. 적당히 애를 쓰는 것은 좋지만 강박적으로 애를 쓰는 경우 자연스러운 갈등과 내리막에도 필요 이상의 충격을 받으며 자신 외에 비난할 무언가를 찾으러 다닐 수 있다는 것이다.

또한 (나의) 소속 욕구를 채우고 싶다거나 (내가) 외로운 게 싫다는 다소 자기중심적인 이유가 관계의 핵심 동기가 되면 관계에 과한 노력을 쏟고서도 정작 상대는 요청한 적 없는 ‘필요 없는 오지랖’이나 ‘부담스러운 친절’이라는 결과를 낳게 되기도 한다(Feeney & Collins, 2001).

이 과정에서 나는 이만큼 했는데 상대가 하나도 알아주지 않는다던가 되려 나를 피한다는 사실에 큰 배신감을 느끼기도 한다. 더 많이 받고자 할수록 보상 심리도, 서운함도 커지는 법이다.

관계를 위한 노력과 자신의 희생에 주로 억울함을 먼저 느끼는 사람이 있는 반면 애초에 내가 좋아서 하는 것이고 사랑을 주는 것 자체가 내게는 기쁨이라고 하는 사람이 있다. 나 역시 서운함이 컸던 관계를 돌아보면 그 중의 상당수가 상대에게 주기보다 내가 받아내고자 하는 욕구가 더 컸던 관계들이다.

내 안의 결핍은 내가 알아서 채워야 한다. 누가 시켜서 또는 외로워지기 싫다는 수동적 이유가 아니라 내가 주길 원해서 내가 주고 싶은 만큼 맘껏 주고 그 자체로 기뻐할 수 있는 성숙한 사랑을 할 것을 기억해 보자.

Amitay, O. A., Mongrain, M., & Fazaa, N. (2008). Love and control: Self-criticism in parents and daughters and perceptions of relationship partners. Personality and Individual Differences, 44, 75-85.
Feeney, B. C., & Collins, N. L. (2001). Predictors of caregiving in adult intimate relationships: An attachment theoretical perspective. Journal of Personality and Social Psychology, 80, 972-994.
Jensen-Campbell, L. A., Knack, J. M., & Rex-Lear, M. (2009). Personality and social interactions. In P.J. Corr & G. Matthews (Eds.), The Cambridge handbook of personality psychology (pp. 506–523). Cambridge: Cambridge University Press.
Knee, C. R. (1998). Implicit theories of relationships: Assessment and prediction of romantic relationship initiation, coping, and longevity. Journal of Personality and Social Psychology, 74, 360-370.
Mauss, I. B., Tamir, M., Anderson, C. L., & Savino, N. S. (2011). Can seeking happiness make people unhappy? Paradoxical effects of valuing happiness. Emotion, 11, 807-815.
Shaver, P. R., Mikulincer, M., Sahdra, B. K., & Gross, J. T. (2016). Attachment security as a foundation for kindness towards self and others. In K. W. Brown & M. R. Leary (Eds.), The Oxford handbook of hypo-egoic phenomena (p. p223-242). New York, NY: Oxford University Press.

※필자소개
박진영. 《나, 지금 이대로 괜찮은 사람》, 《나를 사랑하지 않는 나에게》를 썼다. 삶에 도움이 되는 심리학 연구를 알기 쉽고 공감 가도록 풀어낸 책을 통해 독자와 꾸준히 소통하고 있다. 온라인에서 ‘지뇽뇽’이라는 필명으로 활동하고 있다. 현재 미국 듀크대에서 사회심리학 박사 과정을 밟고 있다

Loading

23 8월 2024

[물리] 韓 과학자들, 암흑물질 유력 후보 ‘액시온’ 수사망 좁혔다

[물리] 韓 과학자들, 암흑물질 유력 후보 ‘액시온’ 수사망 좁혔다

韓 과학자들, 암흑물질 유력 후보 ‘액시온’ 수사망 좁혔다

입력
물리학에서 우주를 설명하는 표준 모델에 따르면 우주의 구성 성분 중에 우리가 이해할 수 있는 물질은 약 5%뿐이다. 26.8%는 암흑물질이, 나머지는 암흑에너지가 차지한다. 게티이미지뱅크 제공

물리학에서 우주를 설명하는 표준 모델에 따르면 우주의 구성 성분 중에 우리가 이해할 수 있는 물질은 약 5%뿐이다. 26.8%는 암흑물질이, 나머지는 암흑에너지가 차지한다. 게티이미지뱅크 제공

표준 우주론 모델에 따르면 우주의 26.8%는 암흑물질이 차지하지만 암흑물질의 정체는 명확히 밝혀지지 않았다. 과학자들은 이론으로 예측된 범위에서 암흑물질이 존재하지 않는 영역을 배제하는 식으로 암흑물질을 찾는다.

특히 액시온(Axion)은 유력한 암흑물질 후보다. 질량이 매우 작으며 다른 입자와 상호작용을 거의 하지 않는 것으로 추정되는 입자다. 최근 기초과학연구원(IBS) 액시온 및 극한상호작용연구단은 액시온 존재 여부를 판단할 수 있는 범위를 좁힌 연구 결과를 최근 잇따라 공개해 주목을 받고 있다.

일반적으로 과학자들은 강력한 자석을 사용해 액시온의 존재 여부를 판단한다. 이론에 따르면 액시온은 자기장과 만나면 질량에 따른 주파수를 나타내는 광자(빛의 입자)로 변환된다. 이때 공진기를 이용해 주파수를 증폭하고 검출하면 해당 관찰 영역의 액시온 존재 여부를 파악할 수 있다.

핵심은 액시온의 질량과 질량이 변환된 주파수를 알지 못한다는 점이다. 이론에서 예측한 넓은 주파수 영역에서 라디오 주파수를 맞추듯 조금씩 탐색해야 한다.

● 자체 장비 개발해 액시온 탐색

액시온에 대한 이론적 모델로 ‘DFSZ’와 ‘KSVZ’가 있다. ‘DFSZ 액시온’ 모델에서 예측한 액시온은 KSVZ에서 제시한 것보다 다른 입자와의 상호작용이 작아 실험에서 탐지하기 더 어렵지만 기존 우주론의 한계를 극복한 ‘대통일 모델(GUT)’의 근거를 확보할 수 있다.

이런 이유로 IBS 연구단은 ‘DFSZ 액시온’ 탐색에 초점을 맞춰 장비를 개발하고 특정 범위에서 액시온의 존재 여부를 확인하는 데 성공했다. 연구 결과는 12일(현지 시간) 국제학술지 ‘피지컬 리뷰 X’에 공개됐다.

액시온 검출 확률은 자기장이 클수록 높아진다. 연구팀은 초전도체로 지구자기장 세기의 24만 배에 달하는 12테슬라(T)의 자석을 구현했다. 연구팀은 개발한 장비를 활용해 1.025~1.185기가헤르츠(GHz) 주파수 범위에서 질량이 4.24~4.91µeV(마이크로전자볼트)인 액시온을 세계 최고 감도로 탐색하는 데 성공했다. 전자볼트(eV)는 주로 입자물리학에서 사용되는 매우 작은 에너지·질량 단위다. 멈춰 있는 전자의 질량이 약 511킬로전자볼트(keV)로 알려졌다.

정우현 IBS 연구단 연구위원은 “DFSZ 액시온을 탐색할 수 있는 연구팀은 전 세계에서 두 곳뿐”이라며 “1GHz 이상 주파수에서 고감도로 액시온 탐색에 성공한 건 현재까지 IBS 연구팀이 유일하다”고 설명했다.

● 고주파수 영역에서도 최고 수준 성과

연구단은 고주파수 영역에서도 최고 수준의 연구성과를 냈다. KSVZ 이론에 따른 최근 연구들은 액시온의 질량이 20~30µeV, 주파수로는 4.8~7.25GHz 영역에 있을 것으로 예측한다. 연구단은 기존 실험보다 더 높은 고주파에 주목했다.

고주파 신호를 탐색하려면 주파수를 증폭하는 공진기의 부피를 줄여야 한다. 부피가 줄면 데이터를 얻는 데 시간이 오래 걸린다. 연구팀은 원통형 공진기를 피자 조각처럼 나눈 ‘다중방 공진기’를 고안했다. 실험 결과 액시온이 질량 21.86~22.00µeV 범위에서 존재하지 않는다는 사실이 확인됐다. 신뢰도는 90% 수준으로 해당 범위에서는 현재까지 가장 민감도가 높은 결과다. 연구결과는 지난달 31일(현지 시간) ‘피지컬 리뷰 레터스’에 게재됐다.

윤성우 IBS 연구단 연구위원은 “액시온 탐색은 건초더미에서 바늘을 찾는 일과 비슷하다”며 “차세대 액시온 탐색 실험의 방향성을 제시하는 연구”라고 밝혔다.

<참고 자료>
– doi.org/10.1103/PhysRevX.14.031023
– doi.org/10.1103/PhysRevLett.133.051802

Loading

17 8월 2024

[사회과학] [박진영의 사회심리학] ‘나’를 이해하는 사람과의 관계는 ‘나의 일부’가 된다

[사회과학] [박진영의 사회심리학] ‘나’를 이해하는 사람과의 관계는 ‘나의 일부’가 된다

[박진영의 사회심리학] ‘나’를 이해하는 사람과의 관계는 ‘나의 일부’가 된다

입력
게티이미지뱅크 제공

게티이미지뱅크 제공

외로움의 실제 모습은 우리가 상상하는 것과는 꽤 다르다. 예를 들어 친구가 많고 항상 사람들에게 둘러싸여 있는 사람이 외롭지 않을 것 같지만 실제로 관계의 ‘양’은 외로움과 큰 상관이 없다.

이보다는 관계의 ‘질’이 더 중요해서 한 두 명일지라도 내가 믿고 의지할 수 있는 사람이 있는지 또 나를 잘 이해해주는 사람이 있는지 여부에 따라 외로움을 느끼는 정도가 크게 달라진다. 외로움을 ‘사회적 배고픔’이라고 보는 시선에 따르면 적어도 우리가 존재론적인 수준에서 갈구하는 관계란 서로 깊이 ‘이해하는 관계’라는 것이다.

최근 애밀리 오거 캐나다 맥길대 교수의 연구에 따르면 서로 이해하는 관계는 우리의 외로움을 충족하는 것에서 더 나아가 내가 나를 정의할 때 사용하는 요소 ‘나의 일부’가 된다고 한다.

연구자들은 참가자들에게 가상의 연인 제인과 마이크의 이야기를 들려준다. 한 그룹의 사람들에게는 마이크가 제인에게 항상 따뜻하고 상냥한 모습을 보이는 것은 아니지만 제인의 목표들과 깊은 두려움들을 잘 이해하고 있다는 이야기를 해주고 (높은 이해, 낮은 따뜻함), 다른 그룹의 사람들에게는 마이크가 제인의 목표와 두려움들을 잘 이해하지는 못하지만 항상 따뜻하고 상냥한 모습을 보인다는 이야기를 해주었다 (낮은 이해, 높은 따뜻함). 그런 뒤 제인에게 마이크와의 관계가 얼마나 중요한 것 같냐고 물었다.

그 결과 마이크가 항상 따뜻하지는 않아도 제인을 정말 잘 알고 이해하고 있다는 이야기를 들은 그룹의 사람들이 반대로 마이크가 항상 따뜻하지만 제인을 잘 모르고 있다는 이야기를 들은 그룹의 사람들보다 마이크와의 관계가 제인에게 매우 소중하고 중요할 것이라고 평가했다. 물론 친밀한 관계라면 따뜻함과 이해가 모두 있어야겠지만 굳이 하나를 꼽으라고 한다면 이해라는 것이다.

또 다른 연구에서는 실제 연인 및 친구들을 대상으로 연인 또는 친구가 자신을 다른 사람들보다 잘 이해하고 있거나 잘 못 이해하고 있다고 여기게 만들고 해당 관계가 자신이라는 사람을 얼마나 잘 말해주는지에 대해 물었다. 그 결과 친구나 연인이 자기 자신이 진정으로 어떤 사람인지 잘 알고 있다고 여긴 사람들이 그렇지 않은 사람들에 비해 관계를 자신을 정의하는 중요한 요소로 생각하는 경향을 보였다.

생각해보면 영혼의 동반자 같은 친구나 연인의 특징이란 성격이나 자라온 배경이 같다는 것보다도 다른 점이 많지만 대화가 잘 되고 웃음코드가 비슷하다는 사소한 요소들이었던 것 같다. 어쩌면 대화가 잘 되고 코드가 비슷하다는 것이 상호 이해의 전제 조건이어서 그런 것일지도 모르겠다.

지나온 곳은 다르더라도 바라보는 곳이 같고 생각이나 감정은 달라도 대화가 잘 돼서 얼마든지 다른 경험을 함께 공유할 수 있고 내가 재미있어 하는 것을 이 사람도 재미있어 하겠다고 생각할 수 있는 그런 사람들이 나의 이해자인 것은 아닐까.

친밀한 관계를 유지하는 데 무엇보다 이해가 중요하다는 것은 어느 정도 위안이 되기도 한다. 어떤 관계든지 항상 감정적으로 뜨겁고 좋을 수만은 없기 때문이다. 하지만 이해는 좋을 때도 나쁠 때도 상대방을 향해 한 쪽 귀를 열고 있는 한 얼마든지 쌓을 수 있기 때문이다. 결국 모든 관계는 오랜 친구로 수렴한다는 것이 이런 현상을 말하는 것일 수도 있겠다.

어찌되었든 친구이든 연인이든 누군가가 나의 세상을 정의할 수 있고 반대로 내가 타인의 세상을 정의할 수 있다는 것은 멋진 일이다.

Auger, E., Thai, S., Birnie-Porter, C., & Lydon, J. E. (in press). On creating deeper relationship bonds: Felt understanding enhances relationship identification. Personality and Social Psychology Bulletin. Advance online publication. https://doi.org/10.1177/01461672241233419

※필자소개
박진영. 《나, 지금 이대로 괜찮은 사람》, 《나를 사랑하지 않는 나에게》를 썼다. 삶에 도움이 되는 심리학 연구를 알기 쉽고 공감 가도록 풀어낸 책을 통해 독자와 꾸준히 소통하고 있다. 온라인에서 ‘지뇽뇽’이라는 필명으로 활동하고 있다. 현재 미국 듀크대에서 사회심리학 박사 과정을 밟고 있다
Loading

13 8월 2024

[인공지능 기술] AI 기반 물리 정보 신경망을 이용한 시뮬레이션

[인공지능 기술] AI 기반 물리 정보 신경망을 이용한 시뮬레이션

AI 기반 물리 정보 신경망을

이용한 시뮬레이션

AI 기반 물리 정보 신경망을 이용한 시뮬레이션

이번 글에서는 시뮬레이션에서 최근 화두가 되고 있는 물리 정보 신경망(Physics-Informed Neural Network, 이하 PINN)에 대해서 다루어 보겠습니다. 여기서 시뮬레이션이라는 것은 유체역학, 전자기학 등 공학 문제를 슈퍼컴퓨터를 이용한 수학적인 방법으로 푸는 것을 말합니다. 자동차 형상, 휴대폰 열설계, 반도체 소자 시뮬레이션 등이 있습니다.

전통적으로 시뮬레이션은 유한차분법(Finite Difference Method), 유한요소법(Finite Element Method), 그리고 유한체적법(Finite Volume Method)이라고 하는 전체 도메인을 작은 요소로 나누어 근사적인 해를 구하는 수치해석적인 방법을 사용하여 시뮬레이션을 하였으며 이 과정에서 엄청난 양의 계산을 위해 슈퍼컴퓨터를 사용하였습니다.

하지만 최근 AI의 발전으로 인해 시뮬레이션 분야에도 AI를 접목시킨 물리 정보 신경망이라는 방법이 연구되기 시작하였습니다. 이 방법은 Inverse 문제와 Ill-posed 문제 등 전통적인 수치해석 기법의 한계를 극복하기 위해 대두되었습니다.

전통적인 수치해석 방법

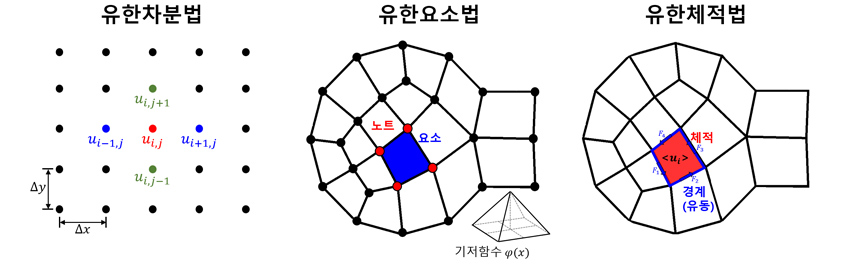
통상적으로 전통적인 수치해석 방법이라 함은 유한차분법, 유한요소법, 그리고 유한체적법이라고 할 수 있습니다. 이 세 가지 방법은 모두 도메인을 잘게 요소(Element)로 나누어 각 요소에서 수치해석적인 방법을 적용하여 계산합니다. 이렇게 각 요소에서 계산한 값을 모아서 시뮬레이션을 수행합니다.

유한차분법

  • Ui,j+1
  • Ui-1,j / Ui,j / Ui+1,j
  • △y / Ui,j-1
  • △x

유한요소법

  • 노트
  • 요소
  • 기저함수 ∮(x)

유한체적법

  • 체적
  • ⁢Ui >
  • 경계(유동)

[그림 1] 유한차분법, 유한요소법, 유한체적법의 차이

유한차분법의 경우 함숫값의 차이를 이용한 미분계수를 근사하여 편미분 방정식을 푸는 방법입니다. 전방(forward), 후방(backward), 중앙(central) 차분법 등 세 가지로 나눌 수 있으며 테일러 급수 전개를 통해 유도합니다. 직사각격자에 적합하고 알고리즘이 직관적이어서 사용하기 쉽고 병렬계산에 적합하여 학술적인 연구나 간단한 시뮬레이션을 할 경우에 효과적입니다. 선형 문제뿐만 아니라 비선형 문제에도 쉽게 적용 가능하며 특히 유체역학 시뮬레이션에 많이 사용됩니다.

유한요소법의 경우 풀고자 하는 편미분방정식을 적분형으로 표현한 뒤 최종적으로 Ax=b 형태의 선형시스템으로 변환하여 근사해를 구하는 방법입니다. 주로 고체역학이나 전자기학 시뮬레이션 등에 사용되며 GPU 가속 효과가 가장 크고 불규칙한 물체 시뮬레이션에 적합합니다. 유한차분법에 비해 해의 연속성을 유지할 수 있기 때문에 물리적으로 타당한 해를 얻을 가능성이 높습니다.

유한체적법의 경우 보존 법칙을 만족하는 문제를 푸는데 적합하기 때문에 주로 유체역학 시뮬레이션에 사용됩니다. 유한체적의 면을 지나는 유동의 양을 기준으로 유도되며 시뮬레이션 형상에 대해 유연하게 계산을 적용할 수 있습니다. 유한차분법과 마찬가지로 불규칙한 물체를 시뮬레이션하는 데 적합합니다.

물리 정보 신경망의 특징

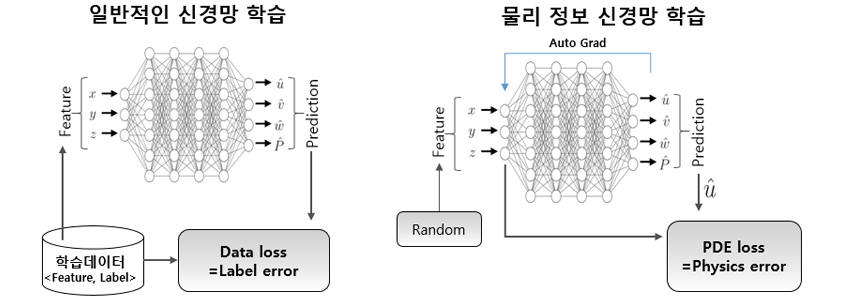
일반적인 신경망이 물리적 법칙을 고려하지 않고 데이터에 전적으로 의존하는 반면, 물리 정보 신경망은 지배방정식(물리방정식)을 만족하도록 식에 내제되어 있는 물리 정보를 신경망에 도입하는 방법입니다.

일반적인 신경망 학습

  • -> Feature
  • x, y, z ->
  • -> u, v, w, p
  • Prediction ->
  • ⁢ – 학습데이터(feature, label) ->
  • Data loss=label error ⁢ –

물리 정보 신경망 학습

  • -> Feature
  • x, y, z ->
  • Auto Grad
  • -> u, v, w, p
  • Prediction -> (u)
  • ⁢ – Random
  • PDE loss=Physics error ⁢ –

[그림 2] 일반적인 신경망과 물리 정보 신경망의 학습 방법

일반적인 신경망은 학습 데이터만을 사용하여 학습하며 손실 함수는 원본 데이터와 학습 모델에서 예측한 데이터에서의 레이블의 불일치 정도를 최소화하도록 학습하는 반면, 물리 정보 신경망은 물리 방정식 자체를 손실 함수에 사용하여 샘플링한 데이터가 물리 법칙을 만족하도록 학습을 진행합니다.

전통적인 시뮬레이션 방법은 도메인을 작은 요소로 나누어 각각에 대해서 계산합니다. 이 과정에서 도메인을 작은 요소로 나누는 Meshing 기법을 사용하지만 물리 정보 신경망을 사용하면 데이터를 단지 샘플링만 하기 때문에 도메인을 작은 요소로 나누는 등 추가적인 계산이 필요 없어지게 되는 장점이 있습니다. 실제 시뮬레이션은 학습(Train)을 진행한 후 추론(Inference)을 통하여 진행하게 됩니다. 이 과정에서 물리적인 법칙을 만족하는 신경망을 찾았기 때문에 물리 법칙을 만족하는 시뮬레이션이 가능하게 됩니다. 학습에 비해 추론하는 시간은 매우 작기 때문에 시뮬레이션하려는 도메인에 대해 한 번 학습을 진행하면 추론을 통한 반복 시뮬레이션을 매우 빠른 시간에 할 수 있다는 장점이 있습니다.

이러한 장점에도 불구하고 현재 물리 정보 신경망은 학습의 수렴성 문제, 전통적인 시뮬레이션 방법에 비하면 아직은 높지 않은 정확도 등의 단점이 존재하여 최근에는 전통적인 시뮬레이션 방법과 물리 정보 신경망을 이용한 방법을 합친 하이브리드 시뮬레이션에 대한 연구가 시작되고 있습니다.

하이브리드 시뮬레이션

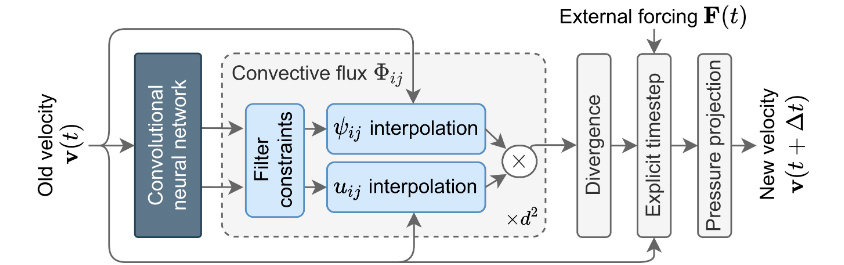
하이브리드 시뮬레이션이란 전통적인 시뮬레이션과 물리 정보 신경망을 이용한 시뮬레이션을 혼합한 방법입니다. 혼합하는 방법에 따라 크게 두 가지 방법이 존재하며 먼저 전통적인 시뮬레이션 방법에 계산시간이 큰 부분을 신경망으로 대체하는 방법에 대해 살펴보겠습니다.

  • old velocity v(t)
  • convolutional neural network ->

convective flux ∮ij / ×d2

  • filter constraints ->uij interpolation / uij interpolation ->
  • x ->

External forcing F(t) ->

  • divergence ->
  • explict timestep ->
  • pressure projection ->
  • New velocity v(t + △t)

[그림 3] 시간이 많이 걸리는 계산을 물리 정보 신경망으로 대체[1]

전통적인 방법이 물리 정보 신경망에 비해 정확도가 높기 때문에 전체적인 프레임워크는 전통적인 수치해석 방법으로 진행하나 시간이 많이 걸리는 계산을 신경망으로 대체하였습니다. 유체해석을 위한 Navier-Stokes 방정식을 푸는 것으로, 단일 Time Step에 대한 흐름도를 보여준 것으로 Convective Flow 계산 시 기존 Standard Numerical Solver를 Convolutional Neural Network을 사용하여 대체하였습니다. 이렇게 하였을 때 전통적인 방법에 비해 상당한 정도의 속도 향상을 이루었다고 합니다.

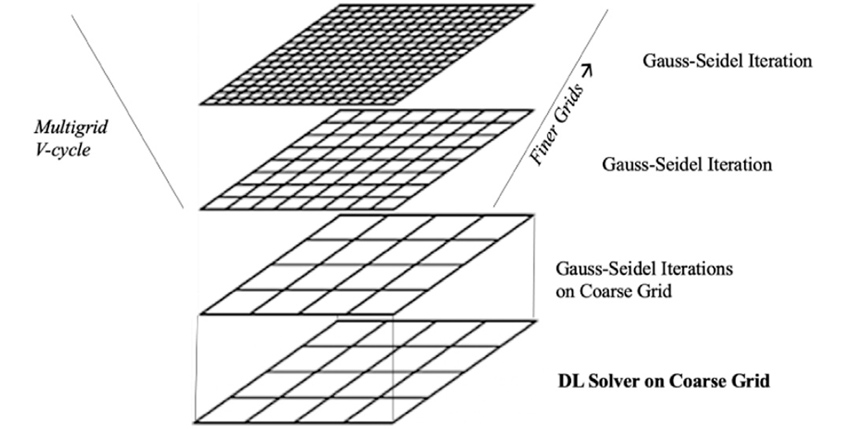
다른 한 가지 방법으로는 물리 정보 신경망의 빠른 시뮬레이션 속도를 이용하여 근사치까지 신경망으로 계산한 후 더 정확한 계산을 위해 전통적인 수치해석 방법을 사용하는 것입니다.

  • Multogrid V-cycle
  • Finer Grids->

DL Solver on Coarse Grid

  • Gauss-Seidel Iteration / Gauss-Seidel Iteration / Gauss-Seidel Iteration on Coarse Grid

[그림 4] 물리 정보 신경망으로 계산 시간을 줄인 후 전통적인 방법으로 정확도를 보정[2]

도메인의 Mesh를 크게 하여 물리 정보 신경망(Deep Learning Solver 사용)으로 시뮬레이션하여 대략적인 값을 얻은 후 더 정확한 계산을 위해 Gauss-Seidel(Standard Solver)을 사용하는 방법으로 전통적인 수치해석 기반 시뮬레이션에 비해 큰 속도 향상을 얻을 수 있습니다.

결론

최근 화두가 되고 있는 AI 기법을 도입한 물리 정보 신경망에 대해 알아보았습니다. AI의 발전에 따라 시뮬레이션 분야에서도 AI가 도입됨은 어찌 보면 당연한 처사입니다. 또한 AI를 구동할 수 있는 GPU와 같은 가속기의 발전에 따라 물리 정보 신경망은 계속해서 발전할 것으로 예상되며 빠른 시뮬레이션 속도로 인한 실시간 시뮬레이션이 가능하기 때문에 Digital Twin 등 응용 분야가 많은 것이 예상됩니다.

References
[1] Machine learning–accelerated computational fluid dynamics, D Kochkova, JA Smitha, A Alieva, Q Wanga, MP Brenner, and S Hoyera, Proceedings of the National Academy of Sciences, 2021
[2] The Old and the New: Can Physics-Informed Deep-Learning Replace Traditional Linear Solvers?, S Markidis, Frontiers in Big Data, 2021

[출처] https://www.samsungsds.com/kr/insights/physics_informed_neural_network.html

문기효
문기효 인공지능/애널리틱스 전문가

삼성SDS 고성능컴퓨팅연구Lab

슈퍼컴퓨터를 이용한 수치해석 분야를 연구하여 박사학위를 취득하였습니다. LLM 추론 및 HPC 시뮬레이션 가속을 연구하고 있으며 양자 컴퓨팅 등 미래 컴퓨팅 기술에 관심이 많습니다.

Loading

12 8월 2024

[알아봅시다] 인터넷 커뮤니티 ‘짤방’, 전력 낭비 주범 될까

[알아봅시다] 인터넷 커뮤니티 ‘짤방’, 전력 낭비 주범 될까

인터넷 커뮤니티 ‘짤방’, 전력 낭비 주범 될까

입력
온라인에서 이뤄지는 다양한 콘텐츠 생성 활동을 표현한 이미지. 게티이미지뱅크

온라인에서 이뤄지는 다양한 콘텐츠 생성 활동을 표현한 이미지. 게티이미지뱅크

디지털 기기에서 한 번 쓰고 다시는 사용하지 않는 ‘정크(쓰레기) 데이터’를 저장하는 데 많은 전력 에너지가 소모되고 있다는 지적이 나왔다. 온라인 커뮤니티 이용이 활발해지면서 개인이 생성하는 사소한 게시글들이 방대한 저장공간을 차지하게 됐다는 것이다.

전문가들은 이같은 정크 데이터를 저장하기 위해 낭비되는 전력이 당장 걱정할 수준은 아니라고 말하면서도 장기적인 탄소 배출 저감을 위해 쓸모없는 데이터는 곧바로 삭제하는 습관을 가질 것을 권고했다.

12일 영국 가디언에 따르면 에너지회사 내셔널그리드는 2030년까지 디지털 데이터를 저장하기 위한 데이터 저장소가 영국 전체 전력소비량의 6%를 차지할 것이란 분석을 최근 내놨다.

기후 위기 전문가들은 앞으로 디지털 데이터 저장소가 기후 위기를 위협하는 요인 중 하나로 주목받을 것이라 전망했다. 더 이상 사용되지 않는 정크 데이터가 기후에 미치는 영향을 조사해온 이안 호지킨슨 영국 러프버러대 교수는 “디지털 데이터는 굉장히 복합한 방식으로 환경에 영향을 미친다”고 말했다.

호지킨슨 교수에 따르면 기업에서 사용되는 데이터의 68%는 다시는 사용되지 않는다. 개인의 데이터 또한 이와 비슷한 수준으로 생성된 이후 다시는 쓰이지 않은 채 잠들어 있는 것으로 추정됐다.

그는 “개인 사용자들이 만드는 이미지, 인스타그램 게시물 등 모든 디지털 데이터를 온라인 상에 보관하기 위해선 에너지가 필요하다”며 “사소한 데이터라도 생성과 보관 과정에서 일정한 탄소가 배출되는 것”이라고 설명했다.

앞선 연구에 따르면 일반적인 업무용 이메일을 1개 발송하는 데는 4g의 탄소가 배출된다. 인터넷 커뮤니티에 글을 올리거나 재밌는 이미지를 저장하기 위해 스마트폰을 전기로 충전하는 행위 등이 모두 탄소 배출로 이어질 수 있다는 것이다. 개인이 생성하는 디지털 데이터 양이 쌓이면 상당한 수준의 에너지 소모 요인이 될 수 있다고 전문가들은 꼬집었다.

호지킨슨 교수는 “하나의 온라인 커뮤니티 게시글이 기후에 급격한 영향을 미치진 않겠지만 이러한 디지털 데이터 생성과 보관 양상은 에너지 소비 측면에서 눈여겨 볼 필요가 있다”고 말했다.

그는 이어 “데이터가 더 많이 저장될수록 저장 시스템을 사용하기 위해 더 많은 비용을 지불해야 한다”며 한번 소비된 후에 아무도 열람하지 않는 휘발성 데이터를 관리할 필요성을 제기했다.

Loading

4 8월 2024

[생물 및 의학(건강)] 잠 부족하면 학습능력·기억력 떨어지는 원인 찾았다

[생물 및 의학(건강)] 잠 부족하면 학습능력·기억력 떨어지는 원인 찾았다

잠 부족하면 학습능력·기억력 떨어지는 원인 찾았다

입력
영국 에든버러대, 미국 워싱턴주립대 등 공동연구팀이 쥐 실험을 통해 수면 부족으로 인해 학습과 기억과 관련된 뇌 신경세포(뉴런)가 만나는 곳의 시냅스 종류가 줄어드는 현상을 규명했다. 게티이미지뱅크 제공

영국 에든버러대, 미국 워싱턴주립대 등 공동연구팀이 쥐 실험을 통해 수면 부족으로 인해 학습과 기억과 관련된 뇌 신경세포(뉴런)가 만나는 곳의 시냅스 종류가 줄어드는 현상을 규명했다. 게티이미지뱅크 제공

수면 부족은 뇌에 영향을 미쳐 학습력과 기억력을 저하시키는 것으로 알려져 있다. 수면 부족으로 인한 뇌 기능 저하 원인이 수면 부족시 뇌 세포가 서로 연결되는 방식의 다양성을 줄이기 때문이라는 연구결과가 나왔다.

영국 에든버러대, 미국 워싱턴주립대 등 공동연구팀이 쥐 실험을 통해 수면 부족으로 인해 학습과 기억과 관련된 뇌 신경세포(뉴런)가 만나는 곳의 시냅스 종류가 줄어드는 현상을 규명한 연구 결과를 2일 ‘커런트 바이올로지’에 실었다.

뉴런은 시냅스를 통해 전기 신호를 다른 뉴런으로 전달해 신경계를 통과할 수 있도록 한다. 2000년대 초반에는 수면 시 뇌의 시냅스 움직임이 감소함으로써 에너지를 보존하고 다음 날 새로운 정보를 입력하기 위해 준비하며 이는 기억력 향상에 중요한 역할을 한다고 알려졌다.

세스 그랜트 에든버러대 교수는 “시냅스가 신호를 보내는 데 사용하는 화학물질, 신경전달물질 종류가 다양하며 뉴런 주변 단백질의 구조와 구성도 다채롭다”며 “연구팀은 뇌의 이같은 다양성을 스냅샷으로 찍는 기술을 개발했다”고 말했다. 이 기술을 통해 연구팀은 정상적으로 잠을 잔 쥐와 하루 중 6시간만 잠을 잔 쥐의 뇌를 촬영했다.

촬영한 사진을 분석한 결과 두 집단의 시냅스 연결 총 개수는 비슷했다. 하지만 수면이 부족한 집단에서 시냅스 연결의 종류가 줄어들어 다양성이 떨어졌다. 특히 시냅스 연결 종류는 학습과 기억과 관련된 뇌의 두 영역인 피질과 해마에서 크게 감소했다.

연구팀은 “수면 부족이 어떻게 이같은 변화를 일으키는지는 불분명하지만 수면 부족이 뉴런의 단백질 합성을 늦출 수 있다는 것을 보인 이전 연구 결과를 참고할 수 있다”면서 “이번 연구 결과는 수면이 뇌의 기억 관련 영역에서 시냅스 다양성을 보존하는 데 중요한 역할을 한다는 것을 시사한다”고 말했다.

<참고자료>
doi: 10.1126/science.z7g5myx

Loading

4 8월 2024

[사회과학] [박진영의 사회심리학] 불필요한 관심사 ‘가지치기’

[사회과학] [박진영의 사회심리학] 불필요한 관심사 ‘가지치기’

[박진영의 사회심리학] 불필요한 관심사 ‘가지치기’

입력
게티이미지뱅크 제공

게티이미지뱅크 제공

“우리는 무엇이 정말 중요하고 중요하지 않은지, 무엇에 관심을 두고 무엇에 대해 이야기 해야 할지, 반대로 어떤 것들에 대해 관심을 줄이고 이야기하지 말아야 할지를 잘 따져봐야 해.” 몇 해 전 들었지만 시간이 갈수록 고개를 끄덕이게 되는 조언이다.

예를 들어 우리가 평소에 불평불만인 것들, 친구들 또는 가족들과 하루 종일 이야기하는 대화의 주제들, 어떤 유명인이 무슨 일을 했다더라 또 요즘 무엇이 유행이더라 하는 정보들, 카더라 식의 별다른 근거 없는 주장들, 주변에서 흔히 들을 수 있고 쉽게 귀를 기울이게 되는 흥미로운 이야기들 중 우리가 쓴 시간과 에너지에 정말 걸맞는 진짜 중요한 것들이 몇 개나 되는지 따져볼 필요가 있다는 것이다.

우리가 고민하는 것들의 대다수가 아직 일어나지 않았거나 앞으로도 일어날 일이 없는 부질없는 일들인 것처럼 안타깝지만 우리가 평소 개인적으로 또는 타인과의 관계 속에서 관심을 쏟는 많은 것들 또한 그다지 중요하지 않을 때가 많다. 어떤 자극 또는 소재, 정보가 흥미롭다고 느끼는 것, 마음을 사로잡는 정도와 그것들의 진위나 중요성은 별개의 문제이기 때문이다.

하지만 연구들에 의하면 사람들은 ‘감정은 곧 정보’로 착각하기 십상이다. 예를들어 평소 전문가들의 조언은 귀찮아 하면서도 아는 사람의 아는 사람이 뭘 먹고 건강해졌다더라는 류의 이야기에는 귀가 솔깃해져서 비싼 돈을 주고서라도 구해 먹는다.

자신이 사는 지역에 화재가 나타날 확률보다 타지역에 사는 친구 집에 불이 났다는 소식이 화재 보험 가입률에 더 큰 영향을 준다. 똑같은 주장을 해도 정치 성향이 같은 사람이 한 주장이라면 맞장구를 치지만 다른 사람이 한 주장이라면 반대부터 하고 본다. 무엇이 유행이라고 하면 일단 무조건 대세에 탑승한다.

단순히 심심하거나 귀찮아서, 있을리 만무한 ‘만병통치약’을 바라는 허황된 마음 때문에, 관계에서의 친밀감, 우리 편이 이기길 바라는 마음 때문에, 유행을 좇지 않으면 뒤쳐질 것 같다는 불안감 때문에 등 다양한 이유로 우리는 잘못되었거나 중요하지 않은 정보나 가치관에 큰 관심을 가지고 삶의 많은 시간을 소모한다.

안타깝게도 가짜뉴스나 타인에 대한 밑도 끝도 없는 비방 등 감정을 자극해서 중요하지 않은 것들을 중요한 것처럼 포장해서 판매하는 자극판매상들은 점점 늘어나고 있고 우리가 중요하지 않은 것들에 소모하는 시간들도 점점 늘어만 간다.

현실이 이런 탓에 가짜뉴스에 대한 연구를 하는 학자들은 감정을 지나치게 자극하는 정보들은 일단 걸러서 듣고 신뢰할만한 출처를 통해 진위를 확인할 것을 강조한다. 물론 이렇게 새로 접하는 정보에 대해 팩트체크를 하는 것은 중요한 일이나 문제는 너무 많은 정보들이 빠르게 쏟아진다는 것이다.

일일이 사실 여부를 확인하기에는 시간도 에너지도 충분하지 않기 때문에 우선 정보의 소용돌이에서 한 발짝 물러나 쏟아지는 이야기들이 “과연 정말 중요한지, 관심을 가질만한 일인지” 따져볼 필요가 있다.

어떤 정보나 주장이 나와 직접적인 상관이 있는 것인지, 아니면 크게 상관 없는 것인지 (유명인의 사생활, 조직 내에서의 가십거리, 타인에 대한 험담 등), 정말 중요하고 사실이어서 관심을 갖는 것인지 아니면 내가 사실이라고 믿고 싶은 것인지 (잘못된 건강 정보, 일확천금에 관한 정보들), 역시 중요해서 따라하는 것인지 아니면 단지 대세에 편승하는 것일 뿐인지 (자기계발 트렌드) 따져볼 필요가 있다.

특히 많은 에너지를 쏟고 있지만 정작 진짜로 중요한 일에 에너지를 쏟고 있는 것 같지 않다면 불필요한 에너지 소모를 줄이고 밤에 잠이라도 편하게 자도록 관심사에 있어 가지치기를 할 필요가 있다. 단순한 정보나 관심사 뿐 아니라 목표나 인간관계 등도 가지치기가 필요하다. 솎아 내고 나면 언제나 쭉정이가 상당히 많았다는 것을 깨닫게 되기 때문이다.

안타깝지만 내가 중요하다고 생각하는 것들과 실제 중요한 것은 다르다. “이게 정말 중요한가?”라는 질문을 자주 던져야 하는 이유다.

※필자소개
박진영. 《나, 지금 이대로 괜찮은 사람》, 《나를 사랑하지 않는 나에게》를 썼다. 삶에 도움이 되는 심리학 연구를 알기 쉽고 공감 가도록 풀어낸 책을 통해 독자와 꾸준히 소통하고 있다. 온라인에서 ‘지뇽뇽’이라는 필명으로 활동하고 있다. 현재 미국 듀크대에서 사회심리학 박사 과정을 밟고 있다
Loading

2 8월 2024

[알아봅시다] “지구 최후의 날 대비, 달에 ‘생물 저장고’ 설치해야”

[알아봅시다] “지구 최후의 날 대비, 달에 ‘생물 저장고’ 설치해야”

“지구 최후의 날 대비, 달에 ‘생물 저장고’ 설치해야”

입력
달. 위키미디어/그레고리 H. 레베라 제공

달. 위키미디어/그레고리 H. 레베라 제공

북극점에 가까운 노르웨이령 스발바르제도에는 ‘최후의 날 저장고’라는 장소가 있다. 바로 ‘스발바르 국제종자저장고’다. 핵전쟁이나 기상이변, 예측할 수 없는 재난으로 식물 자원이 고갈될 경우를 대비해 식물 종자를 차곡차곡 모으는 곳이다. 이같은 저장고를 달에도 만들자는 과학자들의 주장이 나왔다.

지난달 31일 미국 스미소니언 국립 동물원 및 보존 생물학 연구소 연구팀은 지구에서 중요하고 멸종 위기에 처한 식물의 종자, 동물의 세포를 보존하는 저장고를 달에 설치해야 한다는 주장을 담은 논문을 국제학술지 ‘바이오 사이언스’에 발표했다.

최근 기후변화로 북극 지역 온도가 빠르게 상승하며 학계에서 스발바르 국제종자저장고도 안전하지 않다는 의견이 나오고 있다. 이번 연구를 이끄는 메리 하게돈 스미소니언 국립 동물원 및 보존 생물학 연구소 연구원은 “전쟁으로 인해 2022년 우크라이나의 종자 은행이 파괴됐다”면서 “전쟁도 지구 최후의 생물 저장고에 위협이 되기 때문에 가장 안전한 곳에 저장고를 두어야 한다”고 말했다.

연구팀은 달의 추운 환경이 인간의 개입이나 추가적인 에너지원 필요 없이 생물을 낮은 온도에서 안전하게 보존해줄 것이라고 했다. 달 표면은 낮에 섭씨 127도까지 올라갔다가 밤에는 영하 173도까지 떨어진다. 특히 태양에 거의 노출되지 않는 달의 극지방 근처 분화구는 초저온이 유지된다.

하게돈 연구원은 현재 청별망둑 지느러미에서 채취한 세포를 대상으로 초저온에서 살아 있는 상태로 보존하는 방법을 연구하고 있다. 그는 멸종위기에 처해 있거나 먹이사슬에서 중요한 역할을 하는 생물을 먼저 달에 보관해야 한다고 주장하고 있다. 달 생물 저장고는 멸종된 주요 생물을 복원하거나 인류가 ‘테라포밍’을 할 때 활용될 것이라고도 언급했다. 테라포밍은 지구 외 다른 천체에 지구의 환경과 생태계를 인위적으로 조성해 지구 생물이 원활하게 살 수 있도록 만드는 것이다.

연구팀은 “달 생물 저장고 계획이 마련되면 우주 환경을 견디고 생물을 보존할 수 있는 포장재를 개발하고 생물을 달까지 운반하는 데 필요한 물류 기술을 개발하는 것이 중요하다”고 설명했다.

<참고자료>
doi.org/10.1093/biosci/biae058

Loading

30 7월 2024

[인공지능 기술] ‘집컴’으로 실행한 일기예보 AI, 슈퍼컴 이겼다

[인공지능 기술] ‘집컴’으로 실행한 일기예보 AI, 슈퍼컴 이겼다

‘집컴’으로 실행한 일기예보 AI, 슈퍼컴 이겼다

입력
“허리케인 경로 정확히 예측”

8일(현지시간) 허리케인 베릴이 휩쓸고 간 미국 텍사스 베이시티의 한 집 앞에 나무가 뿌리채 뽑혀 쓰러져 있다. AP/연합뉴스 제공

8일(현지시간) 허리케인 베릴이 휩쓸고 간 미국 텍사스 베이시티의 한 집 앞에 나무가 뿌리채 뽑혀 쓰러져 있다. AP/연합뉴스 제공

일반 가정용 컴퓨터나 노트북 수준의 사양으로 실행할 수 있는 인공지능(AI) 프로그램이 슈퍼컴퓨터보다 허리케인 경로를 정확히 예측해 화제다.

미국 뉴욕타임스(NYT)는 29일(현지시간) 보도를 통해 7월 초 미국을 강타한 허리케인 ‘베릴’의 경로를 예측한 AI와 슈퍼컴퓨터를 비교하며 미래 기상예보에서 AI의 역할에 대해 조명했다.

7월 초 유럽 중기기상예보센터(ECMWF)와 미국 국립허리케인센터는 허리케인 베릴의 최종 상륙 위치가 멕시코 부근일 가능성이 가장 높을 것이라고 예측했다. 비행기, 부표, 우주선 등을 통해 모은 전 세계 관측 자료를 바탕으로 거대 슈퍼컴퓨터의 계산을 통해 만든 예보였다.

같은 시기 구글 딥마인드가 만든 일기예보 AI인 그래프캐스트(GraphCast)는 베릴이 텍사스에 상륙할 것으로 예측했다. 기상기관의 슈퍼컴퓨터보다 훨씬 작은 컴퓨터에서 구동된 AI 프로그램은 지구 대기에 대해 학습한 내용만을 바탕으로 예보했다.

7월 8일 베릴은 텍사스를 강타해 최소 36명이 사망하고 수백만 명의 주민들이 정전 피해를 입었다. AI 프로그램이 거대 슈퍼컴퓨터보다 더 정확하게 허리케인의 경로를 예측한 것이다.

지구의 날씨는 여러 가지 요인이 복합적으로 작용해 예측이 매우 어렵다. 지구 기울기, 흔들림, 바람, 비, 구름, 기온과 기압 등 변수가 많아 앞으로의 날씨를 예측하기 위해 거대한 크기의 슈퍼컴퓨터의 계산 능력이 필요하다. 그럼에도 일기예보는 며칠 후나 몇 시간 뒤 날씨 예측에 실패할 정도로 쉽지 않은 영역이다.

인간의 학습 방식을 모방하는 AI는 특히 ‘패턴 인식’에 강점을 보인다. 측정값과 예측값의 수많은 계산을 수행하는 대신 복잡한 데이터 속에서 인간이 식별하기 어려운 패턴을 찾아내 빠르게 날씨를 예측하는 것이다.

그래프캐스트 연구팀의 수석 과학자인 레미 램은 뉴욕타임스에 “유럽 예보 센터에서 수집한 40년간의 전 세계 기상 관측 자료를 바탕으로 AI를 훈련시켰다”며 “슈퍼컴퓨터에서 한 시간 이상 걸리는 10일 예보를 단 몇 초 만에 만들어낼 수 있다”고 말했다.

그는 “그래프캐스트는 AI용으로 설계된 컴퓨터에서 가장 잘 작동하지만 일반 데스크톱 컴퓨터나 노트북에서도 작동할 수 있다”고 덧붙였다. 예보를 생성하는 데 더 이상 거대 슈퍼컴퓨터가 필요하지 않을 수도 있다는 뜻이다.

AI는 허리케인 진로를 성공적으로 예측했지만 해일이나 바람 등 다른 기상 요소도 정확히 예측하려면 아직 발전이 더 필요하다는 분석이다.

각국 기상 전문가들은 AI 시스템이 슈퍼컴퓨터의 접근방식을 보완할 수 있을 것으로 보고 적극적인 움직임을 보이고 있다. 유럽 ECMWF는 그래프캐스트뿐 아니라 미국 엔비디아, 중국 화웨이 등 IT 기업에서 만든 AI 예측 프로그램도 도입하는 것으로 알려졌다. 미국 국립허리케인센터도 새로운 AI 프로그램을 평가해 활용할 수 있을 것이라는 입장을 밝혔다.

Loading

28 7월 2024

[인공지능 기술] [표지로 읽는 과학] AI가 생성한 데이터 학습한 AI, 오염된 정보 낳는다

[인공지능 기술] [표지로 읽는 과학] AI가 생성한 데이터 학습한 AI, 오염된 정보 낳는다

[표지로 읽는 과학] AI가 생성한 데이터 학습한 AI, 오염된 정보 낳는다

입력
네이처 제공

네이처 제공

국제학술지 ‘네이처’는 이번주 표지로 입에서 오물을 토해내는 로봇의 이미지를 실었다. 로봇이 흘린 오물에는 작은 로봇들이 달라붙어 있다. 큰 로봇이 생산한 오물이 다시 다른 로봇에게 전해지는 모습을 표현한 것이다.

대형언어모델(ILL)과 같은 생성형 인공지능(AI) 도구의 비약적인 발전은 이 같은 도구가 인간이 오랜 세월 생성한 방대한 데이터를 학습했기 때문이다. 하지만 AI가 만들어낸 정보가 온라인을 통해 빠르게 확산되면서 상황이 변했다. AI가 학습하는 데이터가 인간이 아닌 AI가 생성한 정보로 대체되기 시작한 것이다.

일라일 슈마일로프 영국 옥스퍼드대 교수 연구팀은 AI가 인간이 생산한 정보가 아닌 정보로 학습하기 시작하면서 생성하는 정보의 질이 급격히 저하된다는 연구 결과를 24일(현지시간) 네이처에 발표했다.

이번 연구에선 AI가 생산하는 정보의 질이 급격하게 저하된 사례가 소개됐다. 중세 건축물에 대한 글을 학습한 대형언어모델이 9번에 걸쳐 AI가 생성한 새로운 정보를 학습한 뒤 생성한 텍스트에는 엉뚱하게도 북미산 토끼에 대한 이야기가 담겼다.

TV 예능 프로그램 등에서 소음이 심한 헤드셋을 낀 여러 명의 참가자가 차례대로 단어를 전하는 게임을 할 때와 비슷한 상황이다. 이런 게임에서 마지막 참가자는 종종 처음 제시어와 전혀 다른 단어를 정답으로 제시하곤 한다.

연구팀은 이같은 현상을 ‘모델 붕괴(models collapse)’라 명명했다. AI가 생성한 질이 저하된 정보가 다음 세대의 AI를 퇴행시키는 현상을 가리킨다. 연구팀은 “오염된 데이터로 학습한 AI는 현실 자체를 잘못 인식하게 된다”고 말했다.

모델 붕괴는 초기 붕괴와 후기 붕괴로 나뉜다. 초기 붕괴는 전체 데이터 중 말단 정보가 손상된다. 후기 붕괴는 전체 데이터 분포가 전반적으로 초기 데이터와 유사하지 않은 분포를 보이게 된다.

연구팀은 이러한 데이터 손상이 발생하는 원인으로 ‘근사치의 오류’를 지목했다. 정보가 재생산되는 과정에서 AI 모델은 근사치로 추정을 하게 되는데 이렇게 누적된 오차가 결국 데이터를 오염시킨다는 것이다.

연구팀은 “AI가 생성한 데이터를 사용해 대형언어모델을 훈련하는 것이 불가능한 것은 아니지만 이러한 데이터를 정제하는 데 많은 주의를 기울여야 한다”면서 “데이터의 질 측면에선 인간이 생성한 데이터가 여전히 우위에 있을 것”이라고 강조했다.

Loading