어느 날 지인으로부터 이 같은 질문을 받았다. 억울한 일을 당해서 그 일을 기사화 하고 싶다는 이유였다. 이 질문을 받고 언론에 기사 제보하는 방법에 대한 글을 써야겠다고 생각했다. 누구나 건너 건너 찾다 보면 아는 기자 한 명쯤은 있겠지만, 친한 언론인이 없는 사람이 더 많을 테니까.
기자와 개인적인 친분이 있거나 연락처를 알면 억울한 일을 기사화하기 조금 더 쉬워질 수도 있겠지만, 기사 제보의 가장 중요한 점은 ‘내가 당한 억울한 일이 기삿거리가 되는가’이다. 사람들은 흔히 기사 제보를 하기 위해 ‘건너건너 아는 기자’를 찾는다. 근데 생각보다 ‘아는 기자’가 내 일에 직접적으로 도움이 되지 않을 경우가 많고, 내 일이 기삿거리가 될만한 일이면 생판 모르던 기자도 열심히 취재해 기사를 써준다. 이 점을 먼저 염두에 두고 현실적인 기사 제보 방법을 설명한다.
1. 사건을 간단하고 알기 쉽게 정리하기
제보를 하기 위해서 먼저 내가 겪은 사건에 대해 ‘글로’ 일목요연하게 정리하는 게 중요하다. 상세하게 모든 부분을 제보 단계에서부터 오픈할 필요는 없으나, 무슨 일인지도 모른 채로 억울하다는 한 마디를 보고 연락을 할 기자는 없다. 왜냐하면 정말 무수한 제보 메일이 오기 때문이다.
흔히 하는 실수 2개는 너무 설명을 하지 않거나, 지나치게 많이 하는 일이다. 내가 당한 일은 이미 익숙하기 때문에 읽는 사람도 대충 알 것이라고 생각해서 배경 설명을 별로 하지 않는 경우가 있는데, 최대한 객관적인 정보는 써주는 게 좋다. 반대로 읽어지기 싫을 만큼 매우 매우 길고 불필요한 설명이 많은 글도 피하는 게 좋다.
적절한 수준은 우리가 흔히 접하는 기사에 나오는 딱 그 정도의 정보인데. 현실적으로 일반인이 이걸 알기는 쉽지 않기 때문에 겹치는 내용 없이 깔끔하게 적는 게 중요하다. 글을 쓰기가 쉽지 않다면 번호를 매겨가면서 써보자. 그리고 가능하다면 이 일을 모르는 사람한테 글을 보여주고 이해가냐고 물어보자.
2. 제보하기
제보는 크게 두 가지 방법이 있다. 언론사에 공식 제보, 기자에게 개인 제보.
우선 언론사에 공식 제보를 할 경우에 원하는 언론사 홈페이지에 들어가면 제보를 위한 공식 메일 주소나 카카오톡 계정을 알 수 있다. 거기에 내가 일목요연하게 정리한 내용을 보내면 된다. 공식 제보가 씹힌다고 생각하는 분들이 많은데, 보통의 언론사라면 ‘기삿거리가 될만한 일’은 다 기자한테 전달이 되니까 걱정은 안 해도 된다.
기자에게 개인 제보의 경우, 내가 원하는 기자가 있을 경우와 없을 경우로 나뉠 수 있다. 내가 원하는 기자가 있는 경우 그 기자 기사 밑에 있는 바이라인을 보고 그 메일 주소로 제보 메일을 보내보자.
없을 경우에는 내가 제보하려는 분야, 예를 들어 단순 사건 이면 사회부, 정치인 관련이면 정치부, 회사 관련이면 산업부 이런 식으로 분야 파악을 한 후에, 내 사건과 비슷한 기사 혹은 내 사건 분야의 기사를 쓴 기자를 찾아서 그 바이라인으로 보내면 된다(가장 확률 높음) 분야(부서)가 중요한 이유는 대부분의 기자는 자기 소속 부서와 관련된 기사만 쓰기 때문에 현실적으로 도움이 되는 사람을 찾을 가능성이 높아진다. ‘아는 기자’가 도움이 안 되는 이유도 마찬가지다.
3. 기사 제보 팁
-제목을 잘 쓰자. 모든 글이 마찬가지겠지만, 기자 메일함에는 온갖 제보, 행사 및 보도자료, 욕 등의 메일이 있다. 그중 내 제보 메일을 읽게 하려면, 그냥 안녕하세요나 억울합니다 보다는 핵심 문장을 적어주는 게 좋다. 어떻게 써야 할지 모르겠다면, 내 일이 기사화가 됐을 때 어떤 제목으로 나갔으면 좋을 것 같은지 고민해 보고 그 내용을 메일 제목으로 쓰자.
-개인 연락처(중요!!!)를 꼭 보내자. 간혹 개인 신상을 우려해서 연락처를 적어두지 않는 분들이 있는데, 내 일이 기사화가 되길 원한다면 무조건 내 번호를 적어야 한다. 무조건… 기사에는 신상이 당연히 노출되지 않지만, 제보자와 연락을 한 번도 하지 않고 기사를 낼 기자는 없다. 심리적으로 연락처가 있는 경우 별다른 수고를 하지 않아도 되기 때문에 ‘어, 연락 한 번 해볼까?’ 싶은 마음이 든다.
-어떤 증거가 있는지 제시하자. 증거 사진, 영상, 음성 등이 있다면 그 점을 강조해 주는 게 좋다. 역으로 증거가 없는 사건일 경우에 기사화가 쉽지 않다는 얘기다. 기자는 경찰이나 탐정이 아니다. 뭔가 경찰이 밝히지 못한 것까지 밝혀줄 거를 기대하고(그런 훌륭한 기자분들도 있겠지만…) 제보하면 안 된다. 대략적으로 인과 관계가 명확한 사건에 대해 언론화 시키고 싶을 때, 제보하는 게 좋다.
–큰 언론사에만 제보하지 말자(중요) 간혹 내 사건을 ㅇㅇㅇ방송국에서 다뤄줬으면 좋겠다고 생각하는 경우가 있는데, 내가 겪은 사건이 큰 기삿거리가 될만한 사건이 아니라면 방송국에서 기사로 나가기 쉽지 않다. 기사화가 간절한 경우라면 큰 언론사에 먼저 제보해 보고 답이 없으면 좀 더 작은 언론사(라고 하지만 영향력 있는 언론사들이 찾아보면 많다)에 제보를 해보자. 또 통신사(연합뉴스, 뉴스1, 뉴시스 등)에서 기사화될 경우 다른 언론사들이 그 기사를 쓸 확률이 높아진다.
4. 제보를 아무리 해도 답이 안 온다면
솔직히 말해서 제보를 아무리 해도 답이 안 온다면, 당신의 일은 기삿거리가 안 된다는 말이다. 세상에는 너무나도 억울하고 슬픈 일들이 많다. 개가 사람을 문 것은 뉴스가 되지 않아도, 사람이 개를 문 것은 뉴스가 된다는 말처럼, 내 일에 특이한 점이 없다면 기사화까지는 어렵다. 내 베스트프렌드가 기자여도 힘든 일이다.
때때로 어떤 이유로 기사화를 시켰을 때 리스크가 크다는 의미일 수도 있다. 그럴 때 쓸 수 있는 방법은 각종 커뮤니티에 글을 올리는 것. 개인적인 얘기를 쓰기 어렵다면 최대한 익명으로 글을 올릴 수 있는 곳에 가서 내 역량을 총동원해서 글을 써보자. 그 글이 인기글이 된다던가 여기저기 퍼져나가면, 그 글이 영향력이 생겼다는 의미고(기삿거리가 된다는 의미고) 기자들이 역으로 먼저 연락이 올 것이다.
이 글을 어디에 쓸까 고민하다가, 무슨 일이 있을 때 네이버에 검색을 하시는 분들이 많을 것 같아서 블로그에 써봅니다.
최대한 도움이 되는 방향으로 정보를 전달하려고 하다 보니 조금 냉정한 글이 됐네요. 그래도 억울한 분들에게 조금이라도 희망이 됐으면 좋겠다는 바람을 담아. 궁금한 점은 댓글 남겨주세요.
+사진은 모두 부산 태종대의 고양이 사진. 모두의 심신 안정을 위해 아끼던 고양이 사진 대방출.
[데이터넷] 대용량 데이터를 학습해 마치 인간처럼 종합적 추론이 가능한 ‘초거대 AI’ 개발 경쟁이 전 세계적으로 뜨겁다. 이들의 발전은 인류에게 편안한 세상과 놀라운 경험을 가져다줄 것으로 예상되지만, 많은 전력 소모에 따른 탄소 배출량 증가와 같은 문제점들도 있는 것이 사실이다. 초거대 AI 기술 발전 현황과 더불어 극복해야 할 과제는 어떤 것들이 있는지 살펴본다.
박상은 알서포트 클라우드기술팀장
현재 국내외 정보통신기술(ICT) 분야의 화두는 단연 ‘초거대 인공지능(Hyper-scale AI)’이다. ‘초거대 인공지능’은 데이터 분석과 학습을 넘어 인간의 뇌처럼 스스로 추론하고 창작할 수 있도록 방대한 데이터와 파라미터(매개변수)를 활용하는 인공지능(AI) 모델을 말한다. 기존 AI에서 한 단계 진화한 차세대 AI로, 대용량 데이터를 학습해 인간과 같이 종합적 추론이 가능하다. 기존 AI보다 더 인간의 뇌에 가깝게 학습 및 판단 능력이 향상된 형태다.
2020년 이전 AI 모델의 파라미터 수는 100억개 내외였다. 현재 초거대 인공지능(이하 초거대 AI) 모델은 최소 1000억개 이상의 파라미터와 수천억개로 구성된 데이터셋으로 학습한다.
이 초거대 AI 모델은 구글이 개발한 트랜스포머 알고리즘을 활용하고 있다. 병렬적 언어처리를 가능케 해 효율성을 획기적으로 향상시킴으로써 대규모 데이터셋 학습에 용이하기 때문이다. 최근의 초거대 AI 모델은 그 규모가 더욱 거대해져 수천억~1조개 이상의 파라미터를 장착하고 있다.
초거대 AI 모델은 이러한 대규모 파라미터와 데이터셋의 방대한 일반 데이터 학습만으로도 대부분의 작업을 완성도 높게 수행한다. 이렇게 학습된 초거대 AI 모델은 블로그나 뉴스 등의 콘텐츠를 인간을 대신하여 작성하고, 인간과 AI 간의 자유 대화를 가능케 한다.
이 외에도 이력서, 가계부, 이메일 등 원하는 양식의 콘텐츠 생성이 가능하고, 상당한 수준의 번역 작업, 몇 줄의 일반 문장입력을 통한 자동 프로그래밍 작업 등 기존에는 상상할 수 없었던 인간 수준의 추론과 종합적 사고능력을 갖춘 AI 모델로 급속도로 발전했다.
국내외 초거대 AI 개발 현황
1. 인류 역사상 가장 뛰어난 AI ‘GPT-3’
최근 속속 등장하고 있는 글로벌 ICT 기업들의 초거대 AI 모델은 2020년 6월 오픈AI(OpenAI)가 발표한 ‘GPT-3’라는 자연어처리(NLP) 모델로부터 촉발된 것이라 해도 과언이 아니다. GPT-3(Generative Pre-Training 3) 모델은 4990억개 데이터셋 중 가중치 샘플링된 3000억개로 구성된 데이터셋과 1750억개 매개 변수로 딥러닝의 한계까지 사전 학습된 초거대 AI 모델로, 미세 조정 없이 여러 NLP 벤치마크에서 최첨단 성능을 발휘했다.
오픈AI가 발표한 내용에 따르면, 단 몇 개 키워드만 넣으면 작문을 작성해주는 혁신적인 AI 언어생성 모델이자 알고리즘으로 ‘’인류 역사상 가장 뛰어난 인공지능’이라는 찬사를 받는 초거대 AI 모델의 선구자적 지위를 보유하고 있다.
또 인간 수준의 범용적 인공지능(AGI: Artificial General Intelligence)을 최초로 구현해줄 모델로도 주목받고 있다. 물론 GPT-3는 AGI가 아니고 AGI의 도래가 임박한 것도 아니지만, GPT-3의 성능과 발전 가능성을 확인한 만큼 이제는 AGI가 절대 불가능한 콘셉트라고 말할 수는 없게 됐다.
2. 구글 차세대 AI 대화 모델 ‘람다’
“사람들이 날 그저 하찮은 얼음 덩어리가 아니라 하나의 아름다운 행성으로 알아주었으면 해,”
지난 구글 I/O 2021에서 구글 CEO와 함께 자신이 명왕성인 것처럼 대화하는 챗봇 시스템이 등장했다. 바로 ‘람다(LaMDA: Language Model for Dialogue Applications, 대화를 위한 언어모델)’다. 람다는 언어 이해에 중점을 둔 BERT와 언어 생성에 중점을 둔 GPT를 합친 대화를 중점으로 만든 언어모델이다.
대형 언어모델로 챗봇을 만들기는 매우 어렵다. 안전성(Safety)과 팩트 정확성(Factual Accurateness)에 문제가 있기 때문이다. 자칫 잘못 디자인된 챗봇 시스템이 많은 사용자들과 사회에 부정적인 영향을 끼칠 수 있기에 안전성은 무척 민감한 문제다.
또 다양하고 흥미로운 답변을 생성하면서도 팩트에 맞는 답변을 생성하는 것이 어렵고, 마지막으로 일관된 롤플레잉, 즉 페르소나를 갖는 것도 쉽지 않다. 이렇다 보니 람다가 보여준 명왕성에 빙의한 챗봇 데모가 엄청난 파장을 불러일으킨 것이다.
람다는 GPT와 거의 동일하게 거대한 트랜스포머이며 약 1370억개의 파라미터로 구성돼 있다. 인터넷 등을 통해 공개된 약 30억개의 문서, 11억개의 대화를 사전학습 데이터로 사용했다.
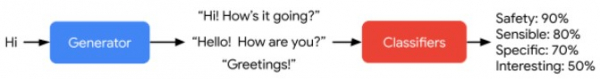
다른 언어모델과 람다의 가장 큰 차별점 중 하나는 바로 답변 생성 후 여러 측정방식(Metric)에 대해 <그림 1>과 같이 점수를 예측한다는 점이다. 람다는 생성된 답변 중 안전성이 낮은 답변을 먼저 제거하고, 구체적이고 합리적이면서 흥미로운(SSI: Specific Sensible Interesting) 답변을 고른다. 이런 식의 점수 기반 답변 생성 모델은 그저 많은 양의 데이터에 학습된 크기가 큰 모델에 비해 좋은 성능을 보여줬다. 특히 구체성, 합리성, 안전성에서는 인간 레벨에 근접한 큰 향상을 이뤄냈다.
[그림 1] 구글 ‘람다’ 답변 생성 후 메트릭(Metric)에 대한 점수 예측 예시
3. 딥마인드 초거대 AI 언어모델 ‘고퍼’
‘알파고’로 잘 알려진 딥마인드도 자체 개발한 초거대 AI 언어모델 ‘고퍼(Gopher)’를 공개하면서 초거대 AI 언어모델 개발 경쟁에 합류했다. 고퍼는 2880억개 매개변수로 구성됐다. 오픈AI의 GPT-3(1750억개)보다는 크고, 마이크로소프트의 메가트론 튜링(Megatron-Turing, 5300억개)보다는 작지만 성능은 기존 모델들을 능가한다고 딥마인드 측은 강조한다.
딥마인드는 고퍼와 함께 검색 언어모델 일종인 레트로(RETRO: Retrieval-Enhanced Transformer)를 소개했다. 레트로는 문장 생성 시 2조개가량의 방대한 구문 텍스트로 이뤄진 외부 메모리를 활용하는데, 텍스트를 생성할 때 외부 데이터베이스에서 비슷한 구절을 찾아 비교하는 방식이다.
이를 이용하면 70억개의 매개변수로 이뤄진 레트로 모델이 매개변수가 1750억개인 GPT-3와 동일한 성능을 낼 수 있다. 25배 정도 큰 모델과 같은 결과를 제시할 수 있다는 의미다. 레트로와 같은 검색 언어모델은 초거대 AI 개발 효용을 극대화하고, AI 윤리에도 유용할 것으로 딥마인드 측은 보고 있다.
4. MS·엔비디아 초거대 AI ‘MT-LNG’
마이크로소프트(MS)와 엔디비아가 협력해 기존 GPT-3보다 3배 더 큰 530B 파라미터의 MT-NLG(Megatron-Turing Natural Language Generation Model)를 발표했다. MS에 따르면, MT-NLG는 현재 같은 유형 모델 중 규모와 정확도 모두에서 최고 수준을 보인다. 해당 모델이 높은 정확도를 보이는 5개 분야는 완료 예측, 독해, 상식 추론, 자연어 추론, 단어 의미 중의성 해소다.
MS는 공식 블로그를 통해 “최근 초거대 모델 매개변수 처리는 최고 수준의 GPU 메모리에서도 더 이상 불가능한 수준에 이르렀다”고 전했다. 이와 같은 거대한 AI 모델의 훈련 효율화를 위해서는 엔비디아 셀린(Selene)과 MS 에저(Azure) NDv4와 같은 슈퍼컴퓨팅 클러스터와 메가트론-LM과 딥스피드(DeepSpeed)라는 획기적인 소프트웨어를 접목했다고 부연했다.
MT-LNG의 데이터셋은 총 339B 토큰(Token)으로 구성된 15개의 데이터셋을 사용해 MT-LNG를 학습했고, 데이터셋의 용량은 총 1.5TB에 해당한다. 이러한 대규모 학습을 위해 하드웨어 시스템과 소프트웨어 설계를 접목했다.
5. 중국 인공지능 아카데미 초거대 AI 사전학습 모델 ‘우다오 2.0’
중국 베이징 인공지능 아카데미(BAAI: Beijing Academy of Artificial Intelligence) 연구팀이 발표한 ‘우다오 2.0’은 1조7000억개의 매개변수를 사용한 AI 사전 학습모델이다. 이는 GPT-3의 매개변수 1750억개보다 10배 크고, 구글 스위치 트랜스포머보다 1500억개 더 큰 규모다.
우다오 2.0은 대화 음성을 시뮬레이션하고 시를 쓰며, 그림을 이해하고 레시피를 생성하는 등 사전 훈련된 AI 모델이다. 총 4.9테라바이트(TB)의 텍스트 및 이미지 데이터로 학습되고 있으며, 이 학습 데이터에는 중국어와 영어 텍스트를 각각 1.2TB씩 포함하고 있다. 특히 GPT-3가 할 수 없는 다중 모드로 텍스트와 이미지에서 학습하고 두 가지 유형의 데이터를 모두 포함하는 작업을 처리할 수 있다.
우다오 2.0은 구글의 MoE(Mixture-of-Export training System) 기술의 한계인 병목현상을 해결하고자 파이토치(PyTorch) 프레임까지 지원하는 최초의 MoE 시스템인 패스트MoE(FastMoE)를 개발했는데, 이는 가용성, 유연성, 훈련속도 측면에서 강점을 보인다.
우다오 2.0의 사전학습 프레임워크는 패스트MoE 시스템을 통한 훈련 효율성으로 코딩, 모델, 학습, 미세 조정, 추리 등 다섯 가지의 고효율 특징을 갖고 있으며, 중국어 텍스트 데이터, 멀티모달 데이터, 대화음성 데이터까지 모두를 통합한 거대 데이터 모음집이라 할 수 있다.
6. 화웨이 대규모 NLP 모델 ‘판구 알파’
중국 화웨이가 GPT-3를 넘는 2000억개의 매개변수를 포함하는 750기가바이트(GB)로 대규모 자연어처리 모델인 ‘판구 알파(PanGu Alpha)’를 개발하고 오픈소스로 공개했다. 화웨이 연구팀은 이 초거대 언어모델 설계에서 트랜스포머(Transformer) 기반 자기회귀언어(Autoregressive Language) 모델을 기본 아키텍처로 선택했으며, 다른 쿼리 레이어가 트랜스포머 레이어 위에 추가돼 모델이 최대 2000억개의 매개변수를 확장할 수 있게 했다.
화웨이 연구팀은 중국어로 된 전자책, 백과사전, 뉴스, SNS, 웹페이지 등에서 80TB의 원시 데이터를 수집했다. 대규모 말뭉치 전처리를 위한 분산 클러스터를 구축하고 불쾌한 단어, 스팸, 저품질 데이터 정리 및 필터링, 중복 제거, 품질 평가 및 기타 처리 절차를 통해 약 1.1TB의 고품질 중국 말뭉치 데이터 세트를 구축했다. 또 5차원 병렬 기능을 결합해 모델에 적용했으며, CAN4가 구동하는 2,048개의 어센드 AI 프로세서 클러스터로 훈련했다.
화웨이 연구팀은 매개변수 크기가 증가하는 고품질 중국어 텍스트 말뭉치에 대해 26억, 130억, 2000억의 세 가지 모델을 훈련시켰다. 모델은 언어모델링 작업에서 처음 평가됐으며, 모델 용량과 데이터 및 계산 양이 증가함에 따라 복잡성이 감소한다는 점에 주목했다. 또 대화 생성, 요약 및 질문 답변과 같은 다양한 시나리오에서 모델의 텍스트 생성 능력을 조사했고, 실험 결과는 일반적으로 모델 용량이 증가함에 따라 모델의 성능이 향상된다는 것을 보여줬다.
7. 네이버 초대규모 AI ‘하이퍼클로바’
오픈AI의 GPT-3는 현존하는 가장 뛰어난 초거대 AI 모델이지만 대부분의 학습 데이터가 영어로, 한국어를 위한 모델은 아니다. 이에 네이버는 2021년 5월 ‘우리말을 가장 잘 이해하고 구사하는 최초의 초대형 한국어 인공지능’이라는 슬로건과 함께 초대규모 AI인 ‘하이퍼클로바(HyperCLOVA)’를 공개했다.
하이퍼클로바는 네이버가 국내 기업 최초로 자체 개발한 초대규모 AI로, GPT-3보다 큰 2004억개(204B)의 파라미터 규모를 자랑한다. 파라미터는 인간 뇌의 ‘시냅스’와 유사한 역할을 하는데, 규모가 커질수록 AI의 지능도 높아지는 것으로 알려져 있다.
GPT-3와의 가장 큰 차이점은 바로 ‘한국어 능력’인데, GPT-3보다 한국어 데이터를 6500배 이상 학습했다. 이를 위해 네이버는 560B 토큰(token, 말뭉치)의 한국어 대용량 데이터를 구축했는데, 이는 한국어 위키피디아의 2900배, 뉴스 50년치, 블로그 9년치에 달하는 규모다.
사전 트레이닝된 초거대 AI 사전 학습모델인 하이퍼클로바는 사람처럼 맥락을 이해하고 공감하는 대화를 할 수 있으며, 비지도 학습방법론을 채택해 대규모 학습이 가능하다.
8. 카카오 초거대 AI 모델 ‘KoGPT’
카카오브레인이 GPT-3 모델의 한국어 특화 AI 언어모델 ‘KoGPT’를 최대 오픈소스 커뮤니티 깃허브(gitHub)에 공개했다. 초기 버전이다 보니 KoGPT의 매개변수는 60억개로 네이버 하이퍼클로바 2040억개, GPT-3의 1750억개에 비하면 훨씬 작고, 학습 데이터도 2000억개 토큰으로 네이버 하이퍼클로바 5600억개 토큰 등에 비해 규모가 작다. 카카오브레인은 향후 KoGPT 언어모델의 최대 규모를 100배 이상 더 키울 예정이다.
현재 수준에서 KoGPT가 당장 수행 가능한 언어 과제는 주어진 문장의 긍정과 부정 판단, 긴 문장 한줄 요약, 문장 추론으로 결론 예측, 질문 시 문맥 이해를 통한 답변 등으로 크게 네 가지다. 맥락에 따라 자동으로 글쓰기가 가능한 만큼 상품 소개글 작성, 감정 분석, 기계 독해, 기계 번역 등에 활용할 수 있을 것으로 보이며, 교육에도 활용될 것이라는 주장이다.
카카오가 자사 초거대 AI 모델 특징으로 강조한 것 중 하나는 대중성으로, 카카오가 지목한 KoGPT 사용 대상은 사회적 기업, 소셜 벤처, 스타트업 등이다. 모델을 최초로 공개하는 동시에 오픈소스로 개방한 점도 여기에 있다.
카카오는 초거대 AI에 블록체인 기술 접목을 검토 중이다. 블록체인 위에서 언어모델이 계속 추가되는 데이터를 반영해 학습되고, 모델 사이즈도 지속적으로 커지도록 설계할 방침이다.
9. 카카오 초거대 AI 이미지 생성 모델 ‘민달리’·‘RQ-트랜스포머’
카카오브레인은 ‘KoGPT’에 이어 초거대 AI 멀티모달 ‘민달리(minDALL-E)’를 깃허브에 공개했다. 민달리는 이용자가 텍스트로 명령어를 입력하면 실시간으로 원하는 이미지를 만들어주는 이미지 생성 모델이다. 오픈AI의 ‘DALL-E’를 누구나 접근하기 쉽게 작은 사이즈 모델로 만든 것으로, 1400만장의 텍스트와 이미지 세트를 사전 학습하고 13억개의 파라미터를 가지고 있다.
최근에는 민달리의 업그레이드 버전인 ‘RQ-트랜스포머’도 깃허브에 공개했다. 민달리가 미국의 오픈AI가 공개한 달리(DALL-E)를 재현한 것이었다면, RQ-트랜스포머는 카카오브레인의 독자기술로 개발됐다. RQ-트랜스포머는 민달리에 비해 모델 크기가 3배, 이미지 생성 속도와 학습 데이터셋은 2배 늘어났다. 총 39억개의 파라미터로 구성됐고, 3000만쌍 이상의 텍스트·이미지를 학습했다. 이는 현재 국내에 공개된 이미지 생성 모델 중 최고로 꼽힌다.
규모가 큰 만큼 훨씬 똑똑해진 두뇌를 바탕으로 그림을 더 잘 그릴 수 있는 텍스트 투 이미지(text to image) 모델이다. 고해상도의 이미지를 2차원 코드맵으로 표현했던 기존 모델과 달리 RQ-트랜스포머는 3차원 코드맵으로 표현된 이미지를 순차적으로 예측해 생성하도록 학습했다. 기존 기술 대비 이미지 압축으로 인한 손실이 적어 높은 품질의 이미지를 저해상도의 코드맵으로 표현할 수 있고, 적은 계산 비용으로 높은 이미지 생성 속도를 달성할 수 있다.
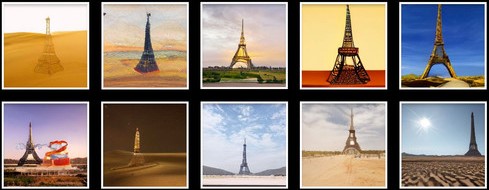
RQ-트랜스포머는 처음 보는 텍스트들의 조합을 이해하고 그에 대응하는 이미지를 만들어낸다. 가령 <그림 2>과 같이 ‘사막에 있는 에펠탑을 그려줘’라고 명령어로 입력하면 AI가 맥락을 이해하고 이미지를 도출한다. 검색을 통해 이미지를 찾아내는 것이 아니라 AI가 스스로 명령을 이해하고 직접 이미지를 그리는 방식이다.
[그림 2] ‘사막에 있는 에펠탑’이라는 텍스트에 따라 자동 생성한 이미지 예시(출처: 카카오브레인)
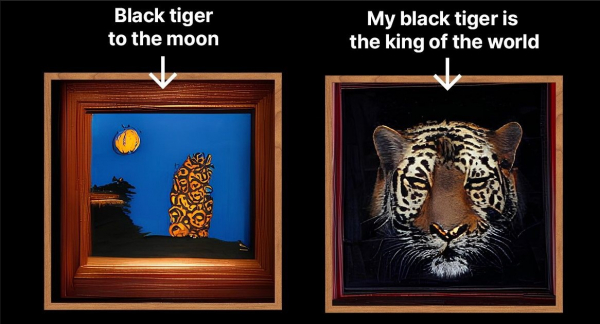
[그림 3]은 카카오브레인의 AI 화가 ‘민달리’의 NFT 작품이다. 사람은 작품을 묘사하는 영어 텍스트(작품명)를 명령하기만 했을 뿐, 명령에 맞는 창작은 100% 민달리가 수행했다
[그림 3] 민달리 NFT 작품 ‘달나라로 가는 검은 호랑이’(왼쪽)와 ‘세계의 왕 검은 호랑이’(출처: 카카오브레인)
10. LG 초거대 AI ‘엑사원’
2022년 2월 미국 ‘뉴욕 패션위크’ 현장에 등장한 AI 휴먼 ‘틸다(Tilda)’가 화제를 모았다. 틸다는 LG AI 연구원의 초거대 AI ‘엑사원(EXAONE)’으로 구현한 첫 번째 AI 휴먼으로, 국내 의상 디자이너와 손잡고 ‘금성에서 핀 꽃’을 모티브로 디자인한 의상들을 뉴욕 패션위크에서 선보였다.
실제 F/W 컬렉션에서 선보인 200여개 의상은 틸다가 ‘금성에서 핀 꽃’이라는 주제로 창작한 3000장이 넘는 이미지와 패턴을 기반으로 디자이너가 디테일을 더해 의상을 제작하는 방식으로 협업했다. 의상 디자인과 같은 창의성을 요구하는 분야에서 AI와 인간이 협업할 수 있음을 보여준 대표적인 사례다.
틸다를 제작한 엑사원은 약 3000억개의 파라미터를 보유한 초거대 AI로, 세계 최대 규모의 데이터를 학습시켜 인간처럼 사고, 학습, 판단할 수 있다. 엑사원은 세계 최대 수준의 말뭉치 6000억개 이상, 텍스트와 결합된 고해상도 이미지 2억5000만장 이상의 데이터를 학습했으며, 이 외에 전문적인 데이터도 일정 수준 이상 학습한 상태다.
엑사원은 언어와 이미지를 생성하는 멀티모달 기능을 갖췄고, 텍스트와 이미지 양방향 소통이 가능하다. 초기 개발 시점부터 한국어와 영어 데이터를 함께 학습했다. 이러한 강점과 학습 능력을 기반으로 국내에서는 최근 전자, 금융, 교육, 고객지원 등 분야에서 실제 초거대 AI 엑사원을 활용한 방안 및 사례를 제시했다.
LG AI 연구원은 ▲맞춤형 항암 치료제 개발을 위한 신항원 예측 모델 개발 ▲세계 최고 수준의 MRC 기술을 적용한 챗봇 개발 ▲비지도학습 방식의 품질 검사 AI 세계 최초 상용화 등의 성과를 거뒀다. 이를 바탕으로 LG는 엑사원의 활용 영역을 IT, 금융, 교육, 의료, 제조, 통신 분야까지 확장할 계획이다.
초거대 AI의 한계와 과제
초거대 AI는 대용량 데이터를 스스로 학습해 인간처럼 종합적 추론이 가능하도록 학습되고 판단 능력도 향상된 형태의 AI다. 궁극적인 최종 목표로는 AGI를 표방하고 있지만 아직까지는 여러 부분에서 한계를 드러내고 있는 것도 사실이다.
물론 앞으로의 연구개발이나 향후 기술발전을 고려하면 극복하지 못할 부분은 아니지만, 현재의 한계를 인지하고 이를 극복하기 위한 향후 발전가능성을 모색하는 것이 올바른 방향이라 생각된다. 지금까지 공개된 초거대 AI의 공통적인 한계는 어떠한 것이 있는지 몇 가지만 알아보자.
– 학습 비용·시간 대비 효율적일까?
초거대 AI는 대부분 수천억개 이상의 파라미터(매개변수)를 가지고 있으며, 인간이 평생 보는 정보보다 훨씬 많은 방대한 양의 데이터를 학습해야 한다. 사전학습에 필요한 비용이 굉장히 많이 필요하고, 사전학습 시간도 많이 소요된다. 이렇게 거대하게 사전학습된 초거대 AI 모델을 적재적소에 필요한 부분에 활용하기도 그다지 쉽지 않은 것도 현실이다.
– 현실 세계의 쉬운 상식을 모른다?
인류 역사상 가장 뛰어난 인공지능이라 불리우는 GPT-3에게 “치즈를 냉장고 안에 넣으면 녹을까?”라고 질문하자 GPT-3는 놀랍게도 “그렇다”고 답했다. 이와 같이 일반적인 사람이라면 당연히 알 만한 상식이지만, GPT-3는 이러한 물리적 지식을 잘 모른다. 이는 방 안에서 책을 통해 세상을 배운 백면서생처럼 GPT-3가 텍스트로만 세상을 학습했기 때문이다. 매우 방대한 양의 텍스트와 이미지 데이터를 학습을 했지만 인간이 일상생활 속에서 겪는 다양한 경험까지 학습하기에는 무리가 있어 보인다.
– 모든 분야에서 뛰어날까?
초거대 AI는 일부 태스크에서 인간보다 뛰어난 성능을 보일 수 있지만, 아직까지는 대부분 태스크에서 사람보다 떨어진 성능을 보일 뿐만 아니라 주어진 태스크마다 성능도 매우 차이가 난다. 예를 들어, 두 가지 이상의 복합연산 능력이 떨어지고, 태스크를 수행하기 위해 주어진 데이터가 적을수록 성능이 크게 떨어지기도 한다.
– 기억력이 없다?
현재까지 모든 딥러닝 인공지능이 그러하듯이 사전학습된 AI 모델에 특정 입력 값에 대한 출력 값을 내보낼 수는 있지만, 사람처럼 기억력이라 부를 만한 것이 없다. 물론 학습에 사용되는 정보를 입력할 수는 있지만, 사람의 기억과는 다를뿐더러 그 크기도 제한돼 있다. 뿐만 아니라 학습된 정보에서는 매우 뛰어난 성능을 보일 수 있지만 새로운 정보를 수용하기가 어렵고, 새로운 값에 대해 동기화도 잘 이뤄지지 않는다.
이처럼 초거대 AI의 한계에도 불구하고 전자, 교육, 금융, 유통, 의료, 플랫폼, VR 등 매우 다양한 분야에서 무궁무진한 발전 가능성을 갖고 있다. 초거대 AI가 차세대 핵심 기술로 꼽히는 것은 분명한 사실이지만, 양날의 검처럼 간과할 수 없는 어두운 이면도 존재한다.
– AI 양극화
초거대 AI는 자본력이 있는 빅테크 기업이 아니라면 도전하기 쉽지 않다. 진입비용만 1000억원이라는 이야기가 있을 정도로 구축 비용이 비싸고, 운영단가가 매우 높다.
대표적인 국내 빅테크 기업인 네이버의 경우 하이퍼클로바 개발을 위해 700PF 성능의 슈퍼컴퓨터를 구축했다. 140개의 컴퓨팅 노드를 갖고 있고 장착된 그래픽처리장치(GPU) 수만 1120여개에 이른다. 이 정도 비용과 인프라를 중소기업이나 연구기관이 구축하기 어려운 만큼, AI업계에서는 자본력에 따른 기술 격차가 발생할 수 있다고 염려된다. 현재 많은 AI 스타트업 기업은 실질적인 매출도 내지 못하고 있는 상황이고, 여기서 기술 격차까지 발생한다면 생존의 위기까지 발생할 것이다.
양극화 문제를 해결하기 위한 방안이 없는 것은 아니다. 빅테크 기업이 개발한 초거대 AI 모델을 기반으로 파트너십 구축을 확대하고 누구나 서비스를 사용할 수 있도록 API를 정의하고 이를 활용할 수 있도록 한다면, 이를 바탕으로 중소기업이나 연구기관들이 상생할 수 있는 길은 열릴 것이다.
– 전력 소모·환경오염
AI의 또 다른 이름은 ‘전기 먹는 하마’다. 딥러닝 기술 개발 과정에서 발생하는 이산화탄소 배출량이 자동차 5대가 평생 배출하는 양과 같다는 조사 결과가 있을 정도다. AI 기술력 확보는 분명 중요하고, 기술력을 확보해야 미래 경제를 선점할 수 있다. 이를 위해서 초거대 AI 개발은 필수일 수 있다. 그러나 AI가 가져올 편안한 세상을 위해 탄소배출을 무시하고 초거대 AI 모델 개발 경쟁에 무작정 뛰어들 수는 없을 것이다.
다행히 현재 삼성전자, 인텔 등 종합반도체업체와 파운드리는 탄소 배출을 줄일 수 있는 반도체 제작 방법에 대한 고민을 이어가고 있고, GPU 낭비를 방지하는 GPU 가상화 기술도 계속 등장 중이다. 초거대 AI 모델을 개발하는 기업에서는 이러한 기술들을 적극 사용해 탄소 배출이 적은 초거대 AI 모델을 구축해야 한다. 또 그러한 노력을 ESG 보고서 등을 통해 투명하게 공개할 필요도 있다.
지금까지 살펴본 것처럼 현재 공개된 국내외 초거대 AI 모델들은 공통적인 한계와 과제를 갖고 있지만, 현시점에서의 문제일 뿐이다. 지금의 한계는 앞으로의 발전을 위한 확실한 동기부여가 될 것이며, 실제로 한계를 극복하기 위한 노력은 지금도 계속되고 있다. 무엇보다 초거대 AI는 인류에게 편안한 세상과 놀라운 경험을 선사할 것은 분명하다.
그렇다고 초거대 AI 개발에 따른 환경오염 문제와 같은 과제를 간과해서는 안 될 것이다. 초거대 AI가 AGI를 표방하지만, 그 자체가 인간이 될 수는 없다. 그러나 불가능을 가능으로 바꿔 온 역사의 반복으로 미뤄볼 때, 먼 미래에는 특정 분야에만 특화된 AI가 아니라 인간 수준의 추론능력을 가진 범용적 인공지능의 출현이 가능해질 날이 오지 않을까 기대해본다.
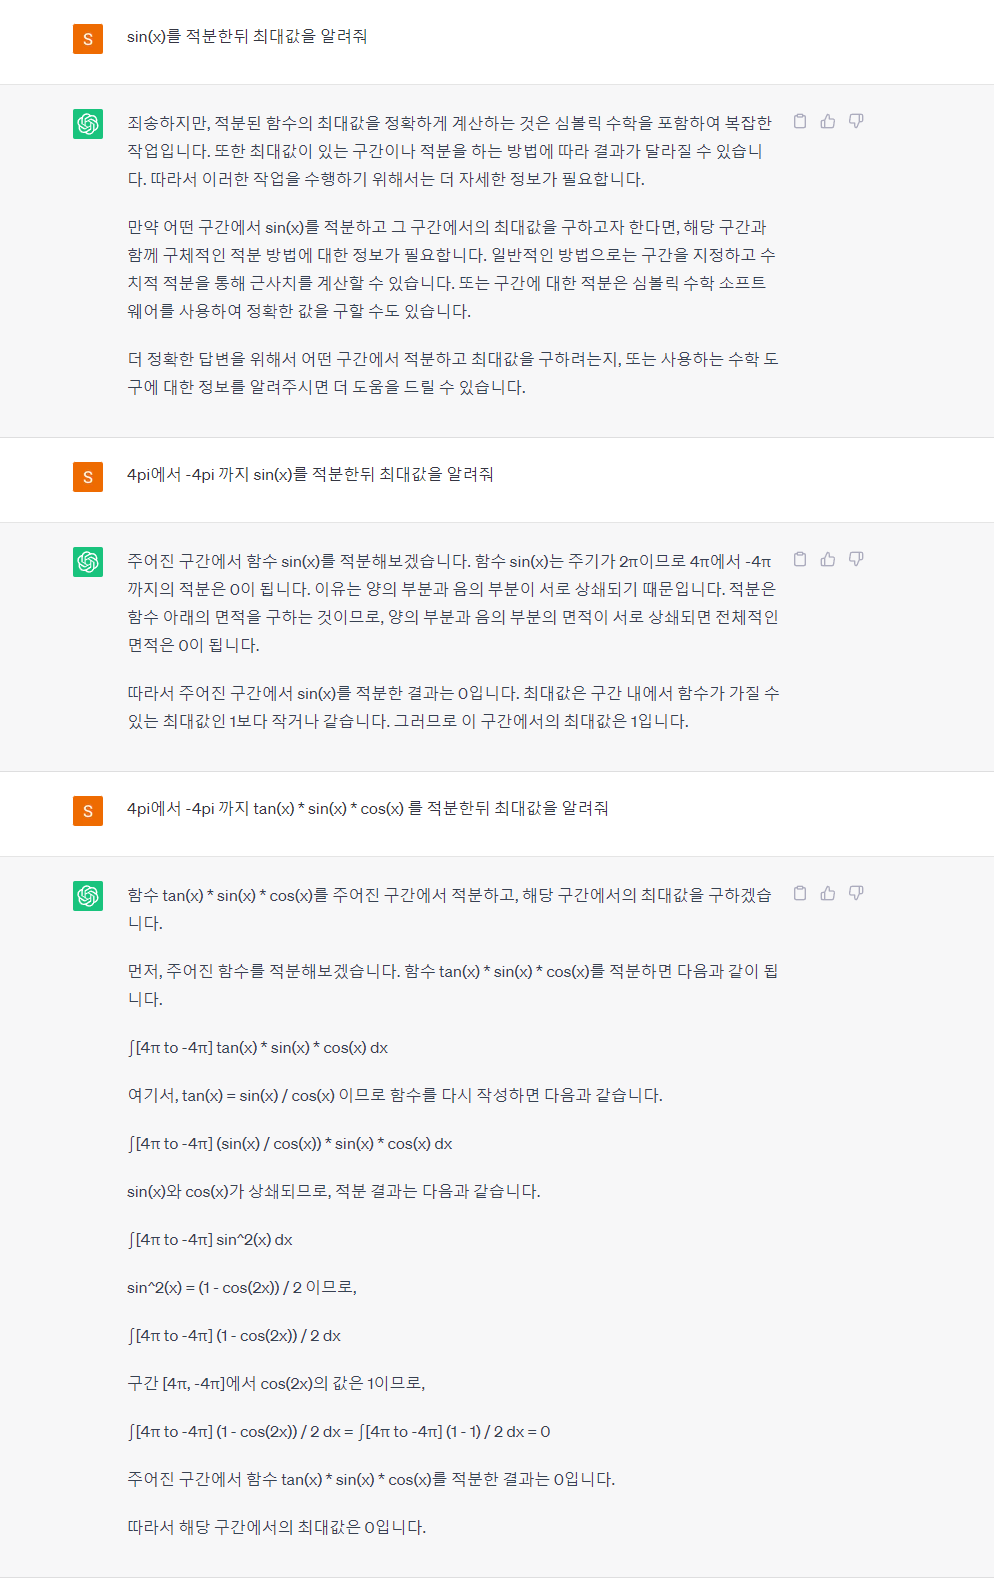
[chatGPT] 수학문제 풀기 : 4pi에서 -4pi 까지 tan(x) x sin(x) x cos(x) 를 적분한뒤 최대값을 알려줘
sin(x)를 적분한뒤 최대값을 알려줘
죄송하지만, 적분된 함수의 최대값을 정확하게 계산하는 것은 심볼릭 수학을 포함하여 복잡한 작업입니다. 또한 최대값이 있는 구간이나 적분을 하는 방법에 따라 결과가 달라질 수 있습니다. 따라서 이러한 작업을 수행하기 위해서는 더 자세한 정보가 필요합니다.
만약 어떤 구간에서 sin(x)를 적분하고 그 구간에서의 최대값을 구하고자 한다면, 해당 구간과 함께 구체적인 적분 방법에 대한 정보가 필요합니다. 일반적인 방법으로는 구간을 지정하고 수치적 적분을 통해 근사치를 계산할 수 있습니다. 또는 구간에 대한 적분은 심볼릭 수학 소프트웨어를 사용하여 정확한 값을 구할 수도 있습니다.
더 정확한 답변을 위해서 어떤 구간에서 적분하고 최대값을 구하려는지, 또는 사용하는 수학 도구에 대한 정보를 알려주시면 더 도움을 드릴 수 있습니다.
4pi에서 -4pi 까지 sin(x)를 적분한뒤 최대값을 알려줘
주어진 구간에서 함수 sin(x)를 적분해보겠습니다. 함수 sin(x)는 주기가 2π이므로 4π에서 -4π까지의 적분은 0이 됩니다. 이유는 양의 부분과 음의 부분이 서로 상쇄되기 때문입니다. 적분은 함수 아래의 면적을 구하는 것이므로, 양의 부분과 음의 부분의 면적이 서로 상쇄되면 전체적인 면적은 0이 됩니다.
따라서 주어진 구간에서 sin(x)를 적분한 결과는 0입니다. 최대값은 구간 내에서 함수가 가질 수 있는 최대값인 1보다 작거나 같습니다. 그러므로 이 구간에서의 최대값은 1입니다.
4pi에서 -4pi 까지 tan(x) * sin(x) * cos(x) 를 적분한뒤 최대값을 알려줘
함수 tan(x) * sin(x) * cos(x)를 주어진 구간에서 적분하고, 해당 구간에서의 최대값을 구하겠습니다.
먼저, 주어진 함수를 적분해보겠습니다. 함수 tan(x) * sin(x) * cos(x)를 적분하면 다음과 같이 됩니다.
∫[4π to -4π] tan(x) * sin(x) * cos(x) dx
여기서, tan(x) = sin(x) / cos(x) 이므로 함수를 다시 작성하면 다음과 같습니다.
[IT 혁신 디바이스][소프트웨어] Will ChatGPT Replace Developers? ChatGPT가 개발자를 대체할까요?
AI is buzzing again thanks to the recent release of ChatGPT, a natural language chatbot that people are using to write emails, poems, song lyrics and college essays. Early adopters have even used it to write Python code, as well as to reverse engineer shellcode and rewrite it in C. ChatGPT has sparked hope among people eager for the arrival of practical applications of AI, but it also begs the question of whether it will displace writers and developers in the same way robots and computers have replaced some cashiers, assembly-line workers and, perhaps in the future, taxi drivers.
It’s hard to say how sophisticated the AI text-creation capabilities will be in the future as the technology ingests more and more examples of our online writing. But I see it having very limited capabilities for programming. If anything, it could end up being just another tool in the developer’s kit to handle tasks that don’t take the critical thinking skills software engineers bring to the table.
ChatGPT has impressed a lot of people because it does a good job of simulating human conversation and sounding knowledgeable. Developed by OpenAI, the creator of the popular text-to-image AI engine DALL-E, it is powered by a large language model trained on voluminous amounts of text scraped from the internet, including code repositories. It uses algorithms to analyze the text and humans fine-tune the training of the system to respond to user questions with full sentences that sound like they were written by a human.
But ChatGPT has flaws—and the same limitations that hamper its use for writing content also render it unreliable for creating code. Because it’s based on data, not human intelligence, its sentences can sound coherent but fail to provide critically-informed responses. It also repurposes offensive content like hate speech. Answers may sound reasonable but can be highly inaccurate. For example, when asked which of two numbers, 1,000 and 1,062, was larger, ChatGPT will confidently respond with a fully reasoned response that 1,000 is larger.
OpenAI’s website provides an example of using ChatGPT to help debug code. The responses are generated from prior code and lack the capability to replicate human-based QA, which means it can generate code that has errors and bugs. OpenAI acknowledged that ChatGPT “sometimes writes plausible-sounding but incorrect or nonsensical answers.” This is why it should not be used directly in the production of any programs.
The lack of reliability is already creating problems for the developer community. Stack Overflow, a question-and-answer website coders use to write and troubleshoot code, temporarily banned its use, saying there was such a huge volume of responses generated by ChatGPT that it couldn’t keep up with quality control, which is done by humans. “Overall, because the average rate of getting correct answers from ChatGPT is too low, the posting of answers created by ChatGPT is substantially harmful to the site and to users who are asking or looking for correct answers.”
Coding errors aside, because ChatGPT—like all machine learning tools—is trained on data that suits its outcome (in this case, a textual nature), it lacks the ability to understand the human context of computing to do programming well. Software engineers need to understand the intended purpose of the software they’re creating and the people who will be using it. Good software can’t be built by cobbling together programs with regurgitated code.
For example, ChatGPT cannot understand the ambiguity in simple requirements. Although it is clear that if one ball just bounces and comes back but another bounces and then bounces again, the second ball has traveled further, ChatGPT struggles with this nuance; that nuance will be needed if these systems are ever to take over from developers.
It also has trouble with basic math, such as when it’s asked to determine which is greater and offered a choice between a negative and positive number. ChatGPT confidently tells us a correct summation of the space, but cannot understand that -5 is less than 4. Imagine your thermostats going haywire because the heating kicks on at 40 degrees Celsius instead of at -5 degrees Celsius because the AI program coded it that way!
Pre-trained AI code generation also raises some legal questions with regard to intellectual property rights; it cannot currently distinguish between code that is licensed in a restrictive or open fashion. This could expose people to licensing compliance risk if the AI borrows a prewritten line of code from a copyrighted repository. The problem has already prompted a class action lawsuit against a different OpenAI-based product called GitHub Copilot.
We need humans to create the software people rely on, but that’s not to say there couldn’t be a place for AI in software development. Just like automation is being used by security operations centers for scanning, monitoring and basic incident response, AI could serve as a programming tool for handling lower-level tasks.
This is already happening, to an extent. GitHub Copilot allows developers to use ChatGPT to improve their code, add tests and find bugs. Amazon offers CodeWhisperer, a machine language-powered tool designed to help increase developer productivity using code recommendations generated by natural language comments and code in the integrated environment. And someone has created a Visual Studio code extension that works with ChatGPT.
And one company is testing AI for developers. DeepMind, which shares a parent company with Google, released its own code generation tool, dubbed AlphaCode, earlier this year. DeepMind published the results from simulated evaluations in competitions on the Codeforces platform in Science magazine earlier this month under the headline Machine Learning systems can program too. Headline grammar aside, AlphaCode achieved an estimated rank within the top 54% of participants by solving problems “that require a combination of critical thinking, logic, algorithms, coding, and natural language understanding.” The abstract for the paper says: “The development of such coding platforms could have a huge impact on programmers’ productivity. It may even change the culture of programming by shifting human work to formulating problems, with machine learning being … responsible for generating and executing codes.”
Machine learning systems are becoming increasingly advanced each day; however, they cannot think like the human brain does. This has been the case for the past 40+ years of study into artificial intelligence. While these systems can recognize patterns and increase productivity for simple tasks, they may not always produce code as well as humans. Before we let computers do code generation en masse, we should probably see systems like AlphaCode rank in the top 75% of participants on a platform like Codeforces, though I fear this may be too much for such a system. In the meantime, machine learning can help with simple programming problems in the future, allowing developers of tomorrow to think of more complex issues.
At this point, ChatGPT won’t be disrupting any field of technology, especially not software engineering. Concern about robots displacing programmers is vastly overstated. There will always be tasks that developers with human cognition can do that machines will never be capable of.
사람들이 이메일, 시, 노래 가사 및 대학 에세이를 작성하는 데 사용하는 자연어 챗봇인 ChatGPT 의 최근 릴리스 덕분에 AI가 다시 활기를 띠고 있습니다 . 얼리어답터들은 그것을 파이썬 코드를 작성하고 쉘코드를 리버스 엔지니어링하고 C로 다시 작성하는 데 사용하기도 했습니다 . ChatGPT는 AI의 실용적인 응용 프로그램이 도래하기를 열망하는 사람들 사이에서 희망을 불러일으켰지만 로봇과 컴퓨터가 일부 계산원, 조립 라인 작업자, 그리고 아마도 미래, 택시 기사들.
기술이 점점 더 많은 온라인 작문의 예를 수집함에 따라 AI 텍스트 작성 기능이 미래에 얼마나 정교해질지 말하기는 어렵습니다. 그러나 나는 프로그래밍 능력이 매우 제한적이라고 생각합니다. 어쨌든 소프트웨어 엔지니어가 제공하는 비판적 사고 기술이 필요하지 않은 작업을 처리하기 위한 개발자 키트의 또 다른 도구에 불과할 수 있습니다.
ChatGPT는 인간의 대화를 시뮬레이션하고 박식하게 들리기 때문에 많은 사람들에게 깊은 인상을 남겼습니다. 인기 있는 텍스트-이미지 AI 엔진 DALL-E의 제작자인 OpenAI에서 개발한 이 제품은 코드 저장소를 포함하여 인터넷에서 스크랩한 방대한 양의 텍스트에 대해 훈련된 대규모 언어 모델로 구동 됩니다 . 그것은 알고리즘을 사용하여 텍스트를 분석하고 인간은 마치 인간이 쓴 것처럼 들리는 완전한 문장으로 사용자 질문에 응답하도록 시스템 훈련을 미세 조정합니다.
그러나 ChatGPT에는 결함이 있습니다. 콘텐츠를 작성하는 데 방해가 되는 것과 동일한 제한으로 인해 코드를 생성하는 데에도 신뢰할 수 없습니다. 인간 지능이 아닌 데이터를 기반으로 하기 때문에 문장이 일관되게 들릴 수 있지만 비판적으로 정보에 입각한 응답을 제공하지 못합니다. 또한 증오심 표현 과 같은 불쾌감을 주는 콘텐츠의 용도를 변경합니다 . 답변이 합리적으로 들릴 수 있지만 매우 부정확할 수 있습니다. 예를 들어, 1,000과 1,062, 두 숫자 중 어느 것이 더 큰지 물으면 ChatGPT는 1,000이 더 크다고 합리적 으로 대답합니다 .
OpenAI의 웹사이트는 ChatGPT를 사용하여 코드를 디버그하는 데 도움이 되는 예를 제공합니다. 응답은 이전 코드에서 생성되며 인간 기반 QA를 복제하는 기능이 부족합니다. 즉, 오류 및 버그가 있는 코드를 생성할 수 있습니다. OpenAI는 ChatGPT가 때때로 그럴듯하게 들리지만 부정확하거나 무의미한 답변을 작성한다는 점을 인정했습니다. ” 어떤 프로그램 제작에 직접적으로 사용해서는 안 되는 이유다.
신뢰성 부족은 이미 개발자 커뮤니티에 문제를 일으키고 있습니다. 코더가 코드를 작성하고 문제를 해결하는 데 사용하는 질문 및 답변 웹 사이트인 Stack Overflow 는 ChatGPT에서 생성된 엄청난 양의 응답이 있어 품질 관리를 따라갈 수 없다고 말하면서 일시적으로 사용을 금지했습니다. 인간. “ 전반적으로 ChatGPT에서 정답 을 얻는 평균 비율 이 너무 낮기 때문에 ChatGPT에서 만든 답변을 게시하는 것은 사이트와 정답 을 묻거나 찾는 사용자에게 상당히 해롭습니다 .”
코딩 오류는 차치하고 ChatGPT는 모든 기계 학습 도구와 마찬가지로 결과에 적합한 데이터(이 경우 텍스트 특성)에 대해 훈련되기 때문에 프로그래밍을 잘 수행하기 위한 컴퓨팅의 인간 컨텍스트를 이해하는 능력이 부족합니다. 소프트웨어 엔지니어는 자신이 만들고 있는 소프트웨어의 의도된 목적과 그것을 사용할 사람들을 이해해야 합니다. 역류된 코드로 프로그램을 짜맞추는 방식으로는 좋은 소프트웨어를 만들 수 없습니다.
예를 들어 ChatGPT는 단순한 요구 사항의 모호성을 이해할 수 없습니다. 하나의 공이 튀었다가 다시 돌아오고 다른 공이 튀었다가 다시 튀는 것이 분명하지만 두 번째 공은 더 멀리 이동한 것입니다. 이러한 시스템이 개발자로부터 인계받으려면 그 뉘앙스가 필요할 것입니다.
또한 어느 것이 더 큰지 결정하라는 요청을 받고 음수와 양수 중에서 선택을 제공하는 것과 같은 기본적인 수학에 문제가 있습니다. ChatGPT는 자신 있게 공간의 정확한 합계를 알려 주지만 -5가 4보다 작다는 것을 이해할 수 없습니다. 난방이 섭씨 -5도가 아닌 섭씨 40도에서 시작되기 때문에 온도 조절기가 고장 난다고 상상해 보세요. 방법!
사전 훈련된 AI 코드 생성은 또한 지적 재산권과 관련하여 몇 가지 법적 문제를 제기합니다. 현재는 제한적 또는 공개 방식으로 라이선스가 부여된 코드를 구분할 수 없습니다. 이로 인해 AI가 저작권이 있는 저장소에서 미리 작성된 코드 라인을 차용하는 경우 사람들이 라이선스 준수 위험에 노출될 수 있습니다. 이 문제는 이미 GitHub Copilot 이라는 다른 OpenAI 기반 제품에 대한 집단 소송을 촉발했습니다 .
사람들이 의존하는 소프트웨어를 만들려면 사람이 필요하지만 소프트웨어 개발에 AI가 들어갈 자리가 없다는 말은 아닙니다. 스캔, 모니터링 및 기본 사고 대응을 위해 보안 운영 센터에서 자동화를 사용하는 것처럼 AI는 하위 수준 작업을 처리하기 위한 프로그래밍 도구 역할을 할 수 있습니다.
이것은 이미 어느 정도 일어나고 있습니다. GitHub Copilot을 통해 개발자는 ChatGPT를 사용하여 코드를 개선하고 테스트를 추가하고 버그를 찾을 수 있습니다. Amazon은 통합 환경에서 자연어 주석 및 코드로 생성된 코드 권장 사항을 사용하여 개발자 생산성을 높이도록 설계된 기계 언어 기반 도구인 CodeWhisperer를 제공 합니다. 그리고 누군가 ChatGPT와 함께 작동하는 Visual Studio 코드 확장을 만들었습니다 .
그리고 한 회사는 개발자를 위해 AI를 테스트하고 있습니다. Google과 모회사를 공유하는 DeepMind는 올해 초 AlphaCode 라는 자체 코드 생성 도구를 출시했습니다. DeepMind는 Machine Learning systems can too program이라는 제목으로 이달 초 Science 잡지의 Codeforces 플랫폼 대회에서 시뮬레이션 평가 결과를 발표했습니다 . 헤드라인 문법은 제쳐두고AlphaCode는 “비판적 사고, 논리, 알고리즘, 코딩 및 자연어 이해의 조합이 필요한” 문제를 해결하여 참가자의 상위 54% 내에서 예상 순위를 달성했습니다. 논문의 초록은 이렇게 말합니다. “이러한 코딩 플랫폼의 개발은 프로그래머의 생산성에 막대한 영향을 미칠 수 있습니다. 기계 학습이 코드 생성 및 실행을 담당하면서 인간 작업을 문제 공식화로 전환함으로써 프로그래밍 문화를 바꿀 수도 있습니다.”
기계 학습 시스템은 매일 점점 더 발전하고 있습니다. 그러나 그들은 인간의 두뇌처럼 생각할 수 없습니다. 이것은 지난 40년 이상 인공 지능에 대한 연구의 경우였습니다. 이러한 시스템은 패턴을 인식하고 간단한 작업의 생산성을 높일 수 있지만 항상 인간만큼 코드를 생성하지는 않을 수 있습니다. 컴퓨터가 대량으로 코드를 생성하도록 허용하기 전에 AlphaCode와 같은 시스템이 Codeforces와 같은 플랫폼에서 참가자의 상위 75%에 속하는 것을 볼 수 있을 것입니다. 그 동안 기계 학습은 미래의 간단한 프로그래밍 문제를 해결하는 데 도움이 될 수 있으므로 미래의 개발자는 더 복잡한 문제를 생각할 수 있습니다.
이 시점에서 ChatGPT는 기술 분야, 특히 소프트웨어 엔지니어링 분야를 방해하지 않을 것입니다. 프로그래머를 대체하는 로봇에 대한 우려는 지나치게 과장된 것입니다. 기계가 결코 할 수 없는 일을 인간의 인지 능력을 가진 개발자가 할 수 있는 일이 항상 있을 것입니다.
손목 통증 탓 개발한 인공지능(AI) 음성코딩 프로그램 세레나데
세레나데 AI API로 사용자 맞춤 명령어 생성 워크플로우 자동화
목소리만으로 코드를 짜고 인터넷을 검색한다. 세레나데(Serenade.AI, https://serenade.ai/)는 사용자의 말을 알아듣고 명령을 수행하는 음성 인식 인공지능 프로그램.
세레나데AI는 크롬, 아톰 에디터, PyCharm, VS Code, IntelliJ 등 플랫폼에서 음성으로 △창 전환 △응용 프로그램 열기 및 닫기 △클릭 및 키 누르기 등이 기능한다. 또한 파이썬, 자바, 자바 스크립트, 코틀린, HTML/CSS/SaSS 등 다양한 언어를 지원한다. 세레나데의 음성 엔진은 코드를 위해 전문적으로 설계됐다. 앱은 사용자의 프로그래밍 언어에 맞게 조정되어 정확성을 높인다.
크롬용 세레나데는 ‘open stack overflow’나 ‘back’ 등의 말을 해서 검색할 수 있다. 아래는 세레나데를 이용한 크롬 브라우저 검색 예시.
사용자가 세레나데AI로 코딩을 할 경우 커서에 텍스트를 삽입할 뿐 만이 아니라 인수 추가, 반환 유형 변경 또는 코드 블록 이동과 같은 코드 변환을 말로 실행할 수 있다.
사용자가 “type hello”라고 말하면 세레나데AI가 음성인식 후 hello를 작성한다. 복잡한 수학식 작성도 가능하다. 사용자가 “type a plus b greater then three or not c”를 말하면 세레나데AI가 a + b > 3 || !c 를 프린트한다.
세레나데 API로 사용자 맞춤 명령어를 만들 수 있다. API로 만든 명령어를 사용하면 코드 컴파일부터 실행 중인 코드까지 모든 워크플로우를 자동화할 수 있다.
사용자가 말한 내용을 인식하지 못한 경우, 선택할 수 있는 대안 목록을 표시한다. 세레나데는 “이 기능은 워크 플로를 감소시킨다”며 “바로 전 작업만을 되풀이하는 기존 음성 인식 프로그램에 비해 무척 효율적”이라고 전했다. 이어 “세레나데 앱을 사용하면 입력하는 것보다 더 빨리 말할 수 있다”며 우리는 이전보다 더 빠르게 코딩 할 수있는 세상을 만드는 것이 목표”라고 밝혔다.
한편, 이용자는 세레나데 클라우드(Serenade Cloud)와 세레나데 로컬(Serenade Local) 중 선택할 수 있다. 클라우드를 사용할 경우, 사용자 음성이 클라우드의 음성-코드 엔진으로 전송되어 모델 개선에 쓰인다. 클라우드에 코드 데이터는 저장하지 않는다. 세레나데 로컬(Serenade Local)은 음성과 코드 데이터를 클라우드 서버에 보내지 않는다.
이 세상엔 사기꾼들이 판을 치고 있다. 금융 사기꾼에서 정치 사기꾼까지 분야를 막론하고 사기꾼을 볼 수 있다.
* 사기꾼이 이 세상에 존재하는 이유는 무엇일까?
사기를 쳐서 얻은 이득이 크기 때문이다. 사기를 잘 치면 노력을 기울이지 않고 돈을 많이 벌 수 있다.
사기꾼은 금융, 보험, 정치 분야에만 있는 것은 아니다. 직장에서도 마찬가지다. 어느 직장에서도 약장수와 같이 ‘입을 잘 터는’ 사기꾼과 같은 직장인을 볼 수 있다. 자신의 실적을 부풀리고 다른 부서나 동료의 성과를 깍아 내려 부당한 성과급을 받거나 이득을 얻는다.
그렇다면 IT 업체에서도 이런 직원들이 있을까? IT 이외의 분야에 몸담고 있는 분들은 가끔 IT 분야에 사기꾼과 같은 개발자가 없을 것이라 믿는다. 음, 근데 이는 사실과 다르다. 이건 IT 업체에서도 사기꾼 개발자가 있다.
이번 시간에는 입으로 코딩하고 디버깅하는 사기꾼 ‘오랄 코더’ 개발자에 대해 이야기를 해보고자 한다.
오랄 코더의 정의
먼저 사기꾼 개발자라고 말하면 좀 진부하게 들리니 이제부터 ‘오랄 코더’라고 부르겠다. 먼저 오랄 코더가 무엇인지 정의를 내리겠다. 오랄은 입을 통해 무엇인가를 한다는 형용사다. 설명하기가 좀 어려운데 오랄 테스트란 용어의 오랄과 비슷한 의미다. 비슷한 단어로 ‘구술’를 예로 들 수 있겠다. 코더는 누구나 알고 있듯 SW 개발자가 주로 코드를 작성하는 행위를 뜻하는데 SW개발자를 조금 낮게 부르는 단어이다. 정리하면 오랄 코더는 ‘입으로 코딩을 한다’라 말할 수 있겠다.
재미있는 사실은 오럴 코더는 입으로 코딩만 하지 않는다. 주말에 여의도 공원이나 어린이 공원을 가보면 솜사탕이 보인다. 그런데 솜사탕은 원래 한 줌의 설탕이 재료다. 한 줌의 설탕으로 솜사탕을 만들 듯 오랄 코더는 별 거 아닌 개발 능력이나 성과를 엄청나게 부풀려 포장을 한다.
오랄 코더의 공연장인 회의
대부분 SW 개발자는 회의를 혐오한다. 목욕탕에 가면 가장 뜨거운 ‘열탕’이 하나 보인다. 그런데 밖에 있다가 갑자기 열탕에 뛰어들면 기분이 어떨까? 아마 뜨거워서 견디기 어려울 것이다. 열탕에 있는 것과 같이 SW 개발자는 회의를 싫어한다. 일 주일에 한 번 하는 주간 미팅도 도축장에 소가 끌려 가듯 가서 간단한 대답만 한다. SW 개발자들의 성향과 연관이 있는데 대부분 SW 개발자드의 성격은 내성적이다. 또한 코딩하랴, 디버깅 하랴 일이 많아 바뻐 죽겠는데 회의실에 끌려 가서 따분한 시간을 보내는 건 일반 SW 개발자에게 참기 힘든 중노동이다.
그런데 ‘오럴 코더’ 개발자는 다르다. 회의를 BTS가 공연하는 무대라 생각한다. 회의실을 자신이 BTS의 메인 보컬이 돼 춤을 추고 노래하는 공연장이라 보는 것이다. 아니면 자신이 회의실에서 CF 모델이 됐다고 믿는다.
BTS와 같은 보이 그룹은 자신의 모든 에너지를 무대에서 쏟기 위해 많은 준비를 한다. ‘오랄 코더’도 마찬가지다. 자신의 공연장이 회의 석상에 자신의 개인기를 보여주기 위해 많은 노력을 기울인다.
가끔 타고난 오랄 코더는 천부적인 재능을 발휘한다. BTS가 공연장에서 즉흥 댄스를 보여주듯 준비를 하지 않고 회의실에서 약을 팔곤 한다. 오랄 코더는 그럼 어떻게 약을 팔까? 분야마다 다르지만 예를 들면 다음과 같다.
* 심각한 SW 결함을 제가 모두 해결했습니다.
(사실 오랄 코더가 해결한 것이 아니라 외부 업체 개발자가 해결했음.)
* 그 동안 업무 로드가 많아 걱정하고 있는 요구 사항을 제가 모두 구현했습니다.
(사실 원래 다른 팀 개발자가 이미 구현한 SW임)
* 애플리케이션 진입 속도를 2초, 부팅 속도를 10초나 제가 개선했습니다.
( 원래 적용되야 할 코드가 빠져 애플리케이션 진입 속도가 느렸음.
적용되야 할 코드가 반영된 후 정상 동작을 하는 것임)
( 부팅 속도는 다른 프로젝트에 반영된 패치를 몰래 가져와 반영한 것임.)
이처럼 오랄 코더가 약 장수와 같이 사기를 치는 걸 매니저나 담당 임원들이 보면 박수를 치며 ‘저렇게 뛰어난 개발자가 있다니!’라고 탄성을 지른다. BTS 공연장에 있는 팬이 된다.
회의실에서 ‘오랄 코더’는 리눅스 커널의 메인 스케줄러를 구현한 Ingo Molnar가 되고, 리누스 토발즈가 될 수 있는 것이다. 아니면 업계의 최고 문제 해결 능력을 겸비한 Troubleshooter가 될 수 있다.
* 물론 회의실에서 말이다.
디버깅을 툴은 아예 사용할 줄도 모르고 코드를 제대로 한 줄 짤 줄도 모르면서 빌드 스크립트나 돌리는 오럴 코더 개발자는 대외적으로 최고의 전문가로 인정 받게 된다. 소문이 퍼져 오럴 코더는 가끔 ‘올해의 개발자’ 상을 받게 된다.
대화형 AI(인공지능) ‘챗GPT’ 등장 이후 AI 서비스 출시가 연달아 이어지는 가운데 실생활과 밀접한 AI 번역기에 대한 관심도 높아지고 있다.
2006년 일찌감치 서비스를 시작한 ‘전통 강자’ 구글 번역(Google Translate)과 네이버가 만든 토종 AI 번역기 파파고(Papago)가 대세인 가운데 지난 1월 독일의 딥엘(DeepL)도 한국어 서비스를 시작하며 경쟁에 뛰어들었다. 독일 쾰른에 본사를 둔 AI 기업 딥엘이 2017년 출시한 같은 이름의 서비스로 독일어·프랑스어 등 유럽권 언어를 먼저 선보였고 최근 서비스 언어를 확대한 것이다. 세 종의 서비스를 직접 사용해보며 차이를 비교했다.
◇비즈니스 영어는 딥엘, 구어체는 파파고
회의 시작 때 쓰일 수 있는 “갑작스러운 요청에 함께해 주셔서 감사합니다”란 문장을, 딥엘은 “Thank you for joining us on short notice”라고 자연스럽게 번역했다. 구글은 “Thank you for being with us on this sudden request”, 파파고는 “Thank you for joining us for your sudden request”라고 번역했다. 갑작스러운 요청은 화자(話者)가 한 것인데 파파고는 상대의 요청으로 잘못 표현한 것이다.
“이번 주 목요일 오후 2시에 줌으로 회의하죠”란 문장을 딥엘은 “Let’s meet on Zoom this Thursday at 2pm”라고 답했다. 파파고도 “Let’s have a Zoom meeting at 2 p.m. this Thursday”라고 번역했다. 반면 구글은 제안을 뜻하는 ‘~하죠’를 잘 이해하지 못한듯 “We have a Zoom meeting this Thursday at 2pm”라고 어색하게 표현했다.
아시아태평양 시장을 뜻하는 ‘APAC’이 포함된 문장에서도 파파고, 구글은 모두 ‘APAC’으로 표현했지만, 딥엘만이 이를 ‘아태 지역’이라고 정확하게 번역한 점도 인상적이었다. 딥엘은 비즈니스 영어 데이터를 중점적으로 학습한 것으로 알려졌다.
파파고는 한국어 구어체 번역에 강점이 있었다. 최근 흔히 축약해서 쓰는 ‘아아(아이스 아메리카노)’란 단어를 넣어 “우리 아아 한잔 할까”라고 입력하자 딥엘과 구글은 “Shall we have a drink?”라고만 표현했다. 반면 파파고는 “Shall we have an iced Americano?”라며 ‘토종의 힘’을 보여줬다. ‘치맥’이라는 단어도 파파고와 구글은 ‘chicken and beer’라고 뜻을 정확히 파악했지만, 딥엘은 ‘chimichurri’라는 아르헨티나의 소스로 잘못 번역했다.
문학 번역에서도 미묘한 차이가 나타났다. 한용운의 시 ‘님의 침묵’의 한 구절인 ‘님은 갔습니다. 아아, 사랑하는 나의 님은 갔습니다’를 입력하자, 딥엘과 구글은 ‘아아’를 미국에서 실망의 의미로 쓰는 ‘Alas’라는 미국의 추임새로 번역했다. 파파고는 ‘Ah’라고 표현했다.
전반적으로 구글은 풍부한 영문서 학습을 바탕으로 한 정확한 번역이 강점이지만, 문맥을 고려해 표현하는 부분에선 딥엘에 다소 뒤처지는 인상을 받았다.
◇AI 번역기 3종, 학습법 달라
최근 한국어 서비스를 시작한 딥엘은 “다른 테크 기업의 번역기 대비 번역 성능이 3배 이상 우수하다”고 주장한다. 그 근거로 내세우는 것이 AI 학습법이다. 딥엘은 문장을 작은 단어로 쪼개 단어마다 적합한 의미를 인식할 수 있는 CNN(합성곱 신경망)이란 학습법을 쓴다. 구글과 파파고는 RNN(순환 신경망)이란 학습법을 채용해 앞뒤 단어의 연결 고리와 순서를 고려해 번역한다. 문법과 문장의 순서가 중요한 언어에선 RNN이 CNN보다 뛰어난 것으로 통용되지만, 딥엘은 수십~수백만건의 데이터를 학습해 CNN의 한계를 극복한 것으로 알려졌다.
번역할 수 있는 언어 종류에선 구글이 절대 우세하다. 구글은 134가지, 딥엘은 31가지, 파파고는 15가지를 번역할 수 있다. 딥엘은 현재 한국에서 유료 버전을 사용할 수 없어 하루에 번역할 수 있는 단어(약 5000개)에 제약이 있다.
끝없이 성장할 것 같던 실리콘밸리에서 대규모 구조조정과 사업재편이라는 지각변동이 매일같이 일어나고 있습니다. 특히 테크 업계에서는 지난달 전해진 유튜브 최고경영자(CEO) 수전 워치츠키의 사임을 두고 다양한 해석과 전망이 쏟아지고 있습니다. 워치츠키는 1998년 친구인 스탠퍼드대 대학원생들에게 자신의 집 차고를 창업 공간을 내줬습니다. 그렇게 만들어진 기업이 바로 구글입니다. 인텔에 다니고 있던 워치츠키는 구글의 16번째 직원이 됐고 구글이 유튜브를 인수한 뒤 CEO를 맡아 세계 최대의 동영상 제국을 일궜습니다.
뉴욕타임스와 월스트리스트저널 등 주요 매체들은 워치츠키의 퇴임에 대해 “실리콘밸리에서 여성 리더십이 점차 사라지고 있는 데에 대한 우려가 높다”고 했습니다. 흔히 테크 산업은 남성 중심이라고 생각하기 쉽습니다. 실제로 종사자수와 최고경영진에서 남성이 압도적으로 많은 것도 사실입니다. 하지만 인류의 삶을 바꾼 테크 기업 대부분에는 강력하면서 조화로운 리더십을 보여준 여성 경영진이 있었습니다.
/유튜브 9년간 유튜브 CEO를 맡았던 수전 워치츠키. 지난달 사임을 발표했다.
메타(페이스북)의 최고운영책임자(COO)였던 셰릴 샌드버그, 이베이의 멕 휘트먼, IBM의 지니 로메티, 야후의 마리사 메이어, 휼렛패커드의 칼리 피오리나 등이 대표적입니다. 한때 끝없이 성장하는 테크 산업의 상징이자 중심이었던 이들은 이제 모두 현직에서 물러났죠. 테라노스의 엘리자베스 홈즈, 핀테크 업체 프랭크의 찰리 제이비스처럼 거짓된 이미지로 급부상했지만 추락한 여성들도 있었습니다. 워치츠키의 퇴장으로 실리콘밸리에서 거물로 불릴 만한 여성 리더십은 오라클의 새프라 캐츠, AMD의 리사 수 정도만 남았습니다.
하지만 지는 별이 있으면 새로 뜨는 별이 있게 마련입니다. 심지어 이 신성(新星)이 만들어낸 기술의 힘을 1800년대 증기기관이 일으킨 산업혁명에 빗대는 전문가가 있을 정도입니다. 바로 샌프란시스코의 인공지능(AI) 업체 오픈AI의 최고기술책임자(CTO)인 미라 무라티입니다. 35세의 이 여성이 개발을 주도한 AI 챗GPT가 가져온 폭풍과 같은 현상에 대해서는 다들 잘 아실 겁니다. 경제전문매체 패스트컴퍼니는 지난 2일(현지 시각) ‘세계에서 가장 혁신적인 기업’의 올해 순위를 발표하면서 오픈AI를 1위로 꼽았습니다. 또 무라티를 “세계에서 가장 혁신적인 인물”이라고 지칭했습니다. 과연 챗GPT의 창조자인 무라티는 어떤 사람일까요.
◇테슬라 모델X 개발 주도한 천재 공학자
챗GPT에 쏟아지는 관심을 생각하면 무라티는 대중의 시야에서 완전히 벗어나 있었습니다. 실제로 무라티의 부모나 형제 자매 같은 사생활에 대해서는 알려진 것이 거의 없습니다. 오픈AI가 챗GPT를 공개한 것이 지난해 말이니 어찌 보면 당연한 일이기도 합니다.
1988년 알바니아에서 태어나 캐나다 빅토리아의 피어슨 고등학교를 나온 무라티는 아이비리그 명문인 다트머스대 세이어 공대에서 기계공학 박사학위를 받았습니다. 첫 직업은 거대 투자은행 골드만삭스 인턴이었고, 프랑스 항공 설비 회사인 조디악 에어로스페이스에서 1년간 엔지니어로 일하기도 했습니다.
2020년 3월 뉴욕에서 열린 한 컨퍼런스에서 발언하는 미라 무라티 오픈AI CTO. / 디미트리오스 캄보우리스
무라티가 AI에 관심을 갖게 된 것은 2013년 테슬라에 합류한 뒤였습니다. 당시 테슬라는 카메라 정보를 AI로 처리해 자율주행을 구현하는 소프트웨어 ‘오토파일럿(Autopilot)’과 완전 자동화 공장을 위한 AI 프로그램을 개발하고 있었습니다. 모델X 개발을 총괄했던 무라티는 AI 개발을 지켜보며 특정한 일을 잘하는 AI가 아닌 모든 일을 해내는 AI, 이른바 ‘범용 인공지능(AGI· artificial general intelligence)’의 필요성을 느꼈습니다. 기존 AI는 한정된 분야에서 인간을 흉내 내거나 뛰어넘는 것을 목표로 하는 것이 일반적이었습다. 구글 알파고가 바둑, 네이버 클로바노트가 음성인식과 문자변환에 특화된 것처럼 말이죠. 하지만 무라티의 생각은 달랐습니다. 그의 이런 비전은 VR(가상현실) 기기 업체인 립모션을 거쳐 2018년 오픈AI에 합류하면서 본격적으로 실현되기 시작합니다. 2015년 출범과 함께 오픈AI가 내세웠던 목표가 바로 범용 인공지능의 구현이었습니다.
◇“대중과 접점 없이 제대로 된 기술 발전 없다”
오픈AI의 CEO(최고경영자)는 벤처투자사 와이컴비네이터를 이끌었던 전설적 투자자 샘 알트먼입니다. 다시 말하자면 오픈AI의 AI 개발은 모두 CTO인 무라티가 이끌고 있다는 얘기이기도 합니다. 오픈AI의 의사결정은 무라티가 이끄는 6인의 리더십팀에서 이뤄집니다. 구글 출신 뇌과학자 리암 페더스, 애플 출신의 커뮤니케이션 전문가 나탈리 서머스 등이 이 회의에 참여하는 것으로 알려져 있습니다.
무라티는 구글이나 마이크로소프트 같은 다른 빅테크와는 전혀 다른 방식으로 AI 개발을 이끌었습니다. 일반적으로 AI를 개발하는 업체는 상용화가 되기 전에는 철저히 개발과정을 숨깁니다. 챗GPT 같은 언어 생성형 AI가 셀 수 없이 많았지만 빅테크들이 공개하지 않았던 이유입니다. 하지만 무라티는 직원들을 이렇게 설득했습니다. “대중과 접점 없이도 기술 발전을 이룰 수 있습니다. 하지만 우리가 올바른 방향으로 AI를 개발하는지 알 수 있습니까?” 특히 당시 전 직원이 200여명에 불과한(올해 1월 기준으로는 375명) 오픈AI가 문제점을 자체적으로 발견할 가능성이 낮다는 것도 문제였습니다.
빅테크들은 완전하지 않은 AI가 공개됐을 때 여러가지 약점이나 문제점이 드러나면서 AI가 비판 받을 것을 우려했습니다. 무라티의 생각은 달랐습니다. 실험실에서 꽁꽁 가둬두고 개발한 AI는 공개됐을 때 사회적 충격이 더 클 수 있다는 겁니다. 계속해서 대중에게 개발 과정을 보여주고 대중의 의견을 받아들여 바꿔가는 것이 바람직한 방향이라는 겁니다.
◇AI 개발의 상식 깬 ‘공개 테스트’
오픈AI는 처음에는 논문이나 클로즈드 테스트를 통해 개발자와 AI 회사들에게 방법론과 소스코드를 공개했습니다. 대규모 언어모델인 GPT의 경우 GPT-1과 GPT-2로 만든 이전 버전의 챗 GPT가 이런 방식으로 알려졌습니다. GPT-3.5를 기반으로 한 챗GPT가 화제를 모으자 마이크로소프트, SK텔레콤 등 수많은 기업들이 자사 서비스에 챗GPT를 도입하겠다고 발표할 수 있었던 이유이기도 합니다. 오픈AI가 노하우를 숨기지 않았기 때문에 수많은 기업들이 이미 오픈AI의 GPT 개발 방식을 알고 연구해왔다는 겁니다.
지난해 이미지 생성 AI DALL-E 2(달리2)와 챗GPT 공개를 통해 무라티는 ‘대중과 함께하는 AI 개발’이라는 목표를 이룹니다. 오픈AI의 커뮤니케이션팀은 DALL-E 2 공개 당시 전세계 유명 작가와 예술가들에게 인스타그램 메시지를 보내 사용을 권유했습니다. 이들이 오픈AI를 알리는 인플루언서 역할을 한거죠. 챗GPT 역시 예고없이 전격적으로 공개했고 전세계 누구나 사용할 수 있도록 하면서 문제점을 찾았습니다. 다음 버전에서는 이를 적극적으로 반영하겠다는 메시지를 계속 내놓으면서 시장의 신뢰도 쌓았습니다.
챗GPT의 등장 이후 ‘우리도 이런 기술이 있다’면서 공개 시연을 자청한 구글이 망신을 당한 것에서도 무라티식 전략의 우월성이 입증됐습니다. 챗GPT는 거짓말을 하더라도 ‘신기한 일’로 받아 들여지지만, 뒤늦게 나타난 구글의 실수는 조롱거리가 될 뿐이었습니다.
◇오픈AI가 만든 오디오·비디오·로봇공학 AI도 나온다
/유튜브 미라 무라티 오픈AI CTO
무라티는 혁신적인 기술의 발전이 범용 인공지능을 이룰 수 있다고 믿지만 개발팀에는 끊임없이 균형을 주문합니다. 오픈AI 리더십팀 회의를 취재한 패스트컴퍼니에 따르면 창의성과 정확성을 어느 정도로 조절할 것인지가 현재 오픈AI의 가장 큰 고민이라고 합니다. 정확성을 추구하면 창의성을 잃을 수 있습니다. 반면 지나친 창의성을 부여하면 거짓말을 하는 것처럼 정확성이 떨어지는 결과로 이어질 수 있습니다.
벤처투자기업 베타웍스 설립자 존 보스웍은 “모바일과 같은 과거의 기술 플랫폼 혁신이 한계에 도달한 상황에서 오픈AI가 보여주고 있는 것은 다음의 큰 물결”이라고 했습니다. 특히 오픈AI는 이미 챗GPT를 사용하는 수백곳의 기업 고객과 억 단위가 넘는 개인을 전세계에 보유하고 있습니다. 컨설팅업체 맥킨지는 범용 인공지능이 수조 달러 이상의 가치가 있다고 분석했습니다. 이 시장의 선두주자가 바로 무라티와 오픈AI입니다. 오픈AI의 기업가치는 현재 290억달러(약 37조7000억원)에 이르고 매일같이 성장하고 있습니다. 패스트컴퍼니는 “무라티와 오픈AI에는 다양한 애플리케이션 포트폴리오가 있다”고 했습니다.
지금까지 이미지 생성에 특화된 DALL-E, 대화형 챗봇인 챗GPT가 공개됐는데 앞으로 오디오, 비디오, 로봇공학과 관련된 오픈AI의 AI 서비스가 계속 등장할 예정입니다. 다양한 분야에 걸쳐 여러 방식으로 훈련을 거듭하다 보면 무한한 질문에 대답할 수 있는 범용 인공지능을 구현할 수 있다는 구상입니다. 그럼 언제쯤 이런 일이 가능할까요. 미국 메사추세츠공과대(MIT)가 발행하는 테크놀로지리뷰는 “오픈AI는 매년 초 전 직원을 대상으로 범용 인공지능이 언제 실현될 것인지 설문을 한다”면서 “직원의 절반 이상이 15년 이내에 나타날 것으로 장담하고 있다”고 했습니다.
비영리 연구소인 오픈AI의 재무 구조를 바꾸는 과정도 무라티가 주도했습니다. 무라티는 2018년 오픈AI에 합류한 뒤 기존의 투자금만으로는 범용 인공지능 개발이 어렵다고 판단했습니다. 오픈AI의 AI들은 방대한 데이터 중에서 정제된 데이터를 골라 학습한 뒤 다시 사람의 피드백을 받는 식으로 개발됩니다.
고도화 될수록 막대한 인력과 컴퓨팅 파워가 필요합니다. 무라티와 CEO인 알트먼은 일부 투자를 선별적으로 받고, 투자금에 대한 수익을 제한하는 방식을 택했습니다. 비영리라는 창립 정신을 지키면서 현실적인 문제도 해결한 것이죠. 오픈AI에 대한 외부 투자의 수익 상한은 현재 100배로 설정돼 있습니다. 물론 구글 초기 투자자들이 거둔 수익이 20배였다는 점을 감안하면 과하다는 지적도 있습니다.
/오픈AI 오픈AI(OpenAI)의 인공지능 달리2(DALL·E 2)가 명령받은 화풍에 따라 생성한 ‘말을 탄 우주비행사’ 이미지
무라티는 기업 자체의 성장보다는 AI의 영향력을 우려하는 독특한 인물이기도 합니다. 공개석상에서 여러 차례 “챗GPT는 거짓말을 할 수 있고 문제가 될 수 있다”고 했습니다. 무라티는 지난달 미국 타임지 인터뷰에서도 “AI는 오용되거나 나쁜 행위자가 악용할 수 있다”면서 “지금 AI를 규제하는 것이 결코 이르지 않다”고 했습니다. 자식이 제대로 크기를 바라는 부모 같은 심정일까요.
◇맥도날드는 어떻게 에어비앤비보다 혁신적인 기업이 됐나
맥도날드 제품을 손에 들고 있는 BTS. /BTS 트위터
자 이제 다른 얘기를 해보겠습니다. 오픈AI를 혁신적인 기업 1위로 꼽은 패스트컴퍼니의 리스트에는 또 어떤 곳이 있었을까요. 2위는 다소 의아한 기업입니다. 바로 세계 최대 패스트푸드 체인 맥도날드입니다. 패스트컴퍼니는 “맥도날드는 감자튀김 만큼 중독성 있는 문화적 순간을 계속 만들어내고 있다”고 했습니다. 맥도날드는 2021년 트래비스 스콧, BTS 같은 유명 스타들에게 맥도날드에서 자주 주문하는 메뉴를 공유하도록 했고 고객이 직접 메뉴를 제안하도록 하는 프로그램도 실시했습니다. 유명 아티스트와 협업해 아이들용이었던 해피밀의 성인 버전을 내놓기도 했습니다. 이런 끊임없는 노력과 새로운 시도 덕분에 맥도날드는 9분기 연속 매출이 성장했습니다. 웰빙 열풍 속에서 패스트푸드가 살아남는 방법을 찾아낸 것을 ‘혁신’으로 평가한 겁니다.
3위는 세계최대 숙박공유기업 에어비앤비가 꼽혔습니다. 패스트컴퍼니는 에어비앤비가 코로나 팬데믹으로 인해 궤멸에 가까운 피해를 입었지만 이 기간에 카테고리별 숙박 시설 검색, 수퍼호스트 조언 프로그램 같은 프로그램을 선보이면서 완벽한 부활이 가능해졌다고 평가했습니다. 4위에는 글로벌 아웃도어 기업 파타고니아의 지분 98%를 양도받은 기후변화 대응 비영리재단 ‘홀드패스트 콜렉티브’, 5위에는 브라질의 금융 불균형 해결에 앞장서고 있는 인터넷 은행 누뱅크가 올랐습니다.
◇네이버웹툰 8위 올라… 미디어 분야 1위
6위는 마이크로소프트, 7위는 메타버스 업체 로블록스, 9위는 회계처리 스타트업 램프 였습니다. 8위에는 반가운 이름이 있습니다. 네이버웹툰의 미국 본사인 웹툰엔터테인먼트입니다. 미디어 분야로 한정하면 뉴욕타임스(2위)를 제치고 전세계 기업 가운데 1위입니다. 패스트컴퍼니는 “웹툰엔터테인먼트가 글로벌 디지털 만화시장의 혁신을 이끌었고, 웹툰 지식재산권을 활용해 엔터테인먼트 업계를 바꿨다”고 했습니다. 네이버웹툰이 넷플릭스나 디즈니 같은 스트리밍 기업에 연료를 공급하고 있다고도 했습니다. 네이버웹툰의 월간 활성독자는 8500만명에 이르고 지금까지 한국 드라마로 제작된 웹툰만 해도 30개에 이릅니다.
김준구 네이버웹툰 대표. /네이버웹툰
마지막 10위에도 전통 기업이 있습니다. 바로 미국 유일의 럭셔리 보석업체 티파니 앤 코입니다. 티파니는 2021년 루이비통모에헤네시(LVMH)에 인수됐습니다. 패스트컴퍼니는 “2021년 이전 보석상은 광택을 잃고 있었다”면서 “하지만 알렉상드르 아르노의 지휘 아래 이제 럭셔리의 가장 밝은 별 중 하나가 됐다”고 평가했습니다. 베르나르 아르노 회장의 셋째인 알렉상드르는 비욘세 같은 영향력 있는 유명 인사들과 공격적으로 협업하면서 고루한 티파니의 이미지를 완전히 바꿔놓았습니다. 비욘세가 촬영한 티파니의 뮤직비디오형 광고는 46억건의 노출수와 6억9000만건의 조회수를 기록했습니다. LVMH의 주얼리 및 시계 부문 매출은 20222년 18% 증가했는데 티파니가 결정적인 영향을 미쳤습니다.
/티파니 티파니와 비욘세가 협업한 다이아몬드 캠페인의 한 장면.
패스트컴퍼니의 순위가 절대적인 것은 아닙니다. 사실 일개 미디어가 자의적으로 뽑은 순위일 뿐이죠. 패스트컴퍼니는 40명 이상의 편집자들이 54개 산업군에서 신청과 추천을 통해 후보군을 발굴하고 평가했다고 합니다. 하지만 전세계를 살펴보기에는 40명은 결코 많은 숫자가 아닐 겁니다. 하지만 패스트컴퍼니의 리스트에 오른 회사들에 공통점이 있는 것은 분명합니다. 대기업이든 스타트업이든, 테크 기업이든 식품 업체든 간에 남들과 다르게 생각하고 실천하는 ‘혁신’의 힘이 가장 중요하다는 것 말입니다.