10 9월
2023

28 8월
2023
[알아봅시다] ‘꿈의 신소재’라 불리는 맥신, 어떤 연구 이뤄지고 있나
[알아봅시다] ‘꿈의 신소재’라 불리는 맥신, 어떤 연구 이뤄지고 있나
‘꿈의 신소재’라 불리는 맥신, 어떤 연구 이뤄지고 있나
입력2023.08.28. 오전 11:01
수정2023.08.28. 오후 3:22

주사전자현미경으로 촬영한 맥신. 미국 시카고대 제공
‘꿈의 신소재’로 불리는 나노물질 맥신(MXene)에 대한 관심이 과학기술계 안팎에서 커지고 있다. 높은 전기전도성을 갖추고 여러 금속화합물과 조합할 수 있는 맥신은 반도체, 전자기기, 센서 등 다양한 산업에서 활용될 것으로 기대된다. 특히 최근 국내 연구진이 맥신 대량 생산을 가능하게 할 수 있는 물성 예측 및 분류 시스템을 구축해 상용화 가능성에 대한 기대감이 커지면서 관심은 고조되고 있다. 맥신 생산 기술 발전과 함께 이를 활용할 수 있는 방안에 대한 연구결과도 속속 나오고 있다.
● 친환경 코팅 소재에 전기차 배터리까지 영역 확장
29일 과학계에 따르면 지안홍 마 중국 산시대 교수 연구팀은 맥신에 초음파 처리를 거쳐 광열 내구성 효율과 항균 효과를 높인 가죽 코팅제를 개발한 연구 결과를 국제학술지 ‘엔지니어링’에 21일(현지시간) 발표했다.
맥신은 금속층과 탄소층이 교대로 쌓인 2차원 나노물질로 표면에 덮인 분자 종류와 양에 따라 성질이 달라진다. 지안홍 마 중국 산시대 교수 연구팀은 이러한 특징에 주목해 맥신과 가죽을 활용해 친환경적인 재료 개발에 성공했다. 연구팀은 맥신 표면에 초음파 처리를 거쳐 빛과 박테리아에 대한 내구도를 극대화했다. 그런 뒤 2가지 성질에 친화성을 갖는다는 의미인 ‘양친매성’을 강화해 빛과 박테리아가 맥신 코팅제에 몰리도록 했다. 연구팀은 “이번에 개발된 코팅제는 석유 기반 화학 제품의 대안으로 가죽· 종이·건축 등 다양한 산업 분야에서 쓰일 것으로 전망된다”며 “ 바이오 기반 나노복합코팅 개발에 새롭고 지속 가능한 접근 방법을 제공했다”고 말했다.
맥신은 전기차·에너지저장장치(ESS) 등 수요가 커지는 배터리 분야에서도 활용될 가능성이 제기된다. 후샴 알샤리프 사우디아라비아 킹압둘라 과학기술대(KAUST) 연구팀은 맥신을 활용한 대체 전극재를 사용해 배터리의 성능을 개선할 수 있다는 내용의 연구결과를 지난 5월 국제학술지 ‘스몰’에 발표했다. 연구팀은 연구결과가 차세대 배터리에 들어갈 음극 소재를 합성하는 데 도움이 될 것으로 보고 있다.
이를 위해 레이저 미세 가공 기술로 맥신 입자 내부에 ‘나노도트’라는 층을 생성해 배터리 방전 후 성능이 저하되는 단점을 보완했다. 실험 결과 나노도트가 적용된 맥신으로 전극재를 만든 리튬이온 배터리는 그렇지 않은 맥신 활용 배터리보다 전기 저장 용량이 4배나 큰 것으로 나타났다. 기존의 흑연 기반 배터리와 달리 나트륨이나 칼륨과의 융합도 가능하다는 특성도 확인됐다.
● 대량생산 가능성 알려지며 관심 급증…전문가들 “과도한 관심은 경계”
산업계에서 맥신이 다방면으로 활용되기 위해선 대량생산이 숙제로 남아있다. 이승철 한국과학기술연구원(KIST) 책임연구원 연구팀은 맥신 대량생산 가능성을 제시한 연구 결과를 최근 국제학술지 ‘ACS 나노’에 게재했다.
맥신 표면에 덮인 분자가 불소일 경우 맥신의 전기전도성이 낮아져 전자파 차폐 효율이 떨어지지만 표면 두께가 1nm(나노미터·10억분의 1m)에 불과해 여기에 붙은 분자를 분석하려면 고성능 전자현미경으로도 수일이 소요된다. 이로 인해 지금까지 대량생산이 불가능했다. 연구팀은 표면에 붙은 분자에 따라 전기전도도 또는 자기적 특성이 달라질 것이라는 점에 착안해 2차원 소재의 물성 예측 프로그램을 개발했다. 그 결과 맥신의 자기수송 특성을 계산해 다른 추가 장치 없이도 대기압과 상온에서 맥신 표면에 흡착된 분자의 종류와 양을 분석하는 데 성공했다.
일각에서는 최근 맥신에 대해 지나치게 과열된 관심은 경계해야 한다는 지적도 나온다. 맥신의 다양한 활용법을 확인한 연구 결과들이 나오고 있지만 아직 실험실에서 가능성을 확인한 수준으로 상용화까지는 갈 길이 멀다는 이야기다. 이승철 KIST 책임연구원은 “맥신은 그래핀보다도 얇은 2차원 소재이면서 여러 특성을 나타낸다는 점에서 각광받는 소재 중 하나”라며 “아직 관련 연구가 막 움튼 단계인데 과도하게 큰 관심이 집중되는 것 같아 우려되기도 한다”고 말했다. 맥신에 대해 지나치게 과장된 기대감은 연구자들에게 부담이 되며 또 무리한 연구로 이어질 수도 있다는 것이다. 맥신의 향후 상용화 전망에 대해 그는 “현재 학계에선 맥신을 안정적으로 재현하면서 대규모 생산을 가능하게 하는 연구가 진행 중이다”라며 “상용화 논의는 대규모 생산 기술이 검증된 이후의 이야기”라고 강조했다.
[출처] https://n.news.naver.com/article/584/0000024088

28 8월
2023
[인공지능 기술] [리뷰] 네이버 클로바X, 챗GPT 대항마라기엔 “조금 아쉬워”
[인공지능 기술] [리뷰] 네이버 클로바X, 챗GPT 대항마라기엔 “조금 아쉬워”
[리뷰] 네이버 클로바X, 챗GPT 대항마라기엔 “조금 아쉬워”
입력 2023.08.27 06:00
네이버가 24일 공개한 대화형 AI(인공지능) 서비스 ‘클로바X’는 대중으로부터 뜨거운 관심을 받고 있다. 한국 업체가 처음 선보인 새로운 생성형 인공지능(AI)인데다가 한국어 학습을 토대로 한국에 최적화된 AI라고 내세우면서다. 특히 챗GPT, 구글 바드 등 글로벌 빅테크와 견줘 한국어 특화 기능을 잘 구현하는 챗봇으로 주목을 받았다.
네이버의 클로바X는 미국 오픈AI의 초거대 AI모델인 ‘GPT-3.5’에 비해 한국어 데이터를 6500배 이상 학습한 점이 강점으로 꼽힌다. 이에 챗GPT, 구글 바드 등 글로벌 빅테크의 생성형AI와 비교해 클로바X가 대답을 얼마나 잘하는지 다양한 질의를 해보았다.

맛집 검색, 쇼핑에 최적화된 답변 내놔…구글은 양호·챗GPT는 평이
클로바X는 맛집찾기, 쇼핑 추천 등 항목에선 개인화된 답변을 잘 추출했다. 동네별 특성에 맞춘 인기 맛집을 추천하는데 있어 네이버가 반경을 넓히지 않고 개인의 취향을 고려한 동네 맛집을 잘 추천했다. 검색 서비스부터 커머스, 광고 등 서비스를 모두 한다는 장점을 갖춘 덕분에 관련 데이터 학습이 잘 이뤄진 것으로 파악된다.
구글 바드도 보편적으로 인기가 높은 맛집 소개를 했다. 챗GPT는 맛집을 소개하긴 하지만 ‘외국음식’이라는 추상적인 표현을 쓰거나 어떤 곳은 검색을 해도 존재하지 않는 곳이 나타나는 등 정확도가 다소 떨어졌다.

정보 정확성, 빅테크 대비 다소 떨어져
클로바X는 구체적인 정보를 확인하는 과정에서는 다소 정확성이 떨어지는 모습이 포착됐다. 클로바X에 “카카오게임즈에서 잘나가는 게임을 알려줘”라고 물으니 인기 게임으로 꼽히는 ‘오딘’은 언급하지 않고 ‘배틀그라운드’, ‘엘리온’, ‘아레스’를 언급했다.
오히려 구글 바드는 ‘오딘’과 ‘에버소울’, ‘아키에이지 워’를 언급하며 구체적으로 설명도 덧붙였다. 챗GPT는 ‘리니지2M’, ‘펍지’, ‘꿈의 정원’, ‘킹 오브 파이터 올스타’를 답했다. 전혀 상관없는 답변으로 평가된다.
음악 검색 및 추천 기능은 양호했다. 이별 명곡을 추천해 달라는 말에 클로바X는 박효신 ‘눈의꽃’, 버스커버스커의 ‘벚꽃엔딩’ 등을 추출했다. 챗GPT 3.5는 아델의 ‘Hello’, 콜드플레이 ‘Fix You’ 등 팝송 위주로 답변을 했다. 구글 바드는 2023년 발매된 나훈아의 ‘아름다운 이별’, 태연의 ‘들여놓아요’를 추천하며 추천한 이유에 대한 자세한 설명도 친절히 덧붙였다. 그러나 태연의 곡은 검색이 되지 않는 없는 노래로 확인됐다.

클로바X의 학습량이 어느정도 되었는지도 확인해 봤다. 네이버에 따르면 하이퍼클로바X의 파라미터(매개변수)는 오픈AI의 GPT-3.5(1750억개)보다 큰 2040억개쯤이 더 많다. 한국어 학습량 역시 GPT-3의 6500배 이상으로 알려졌다.
특히 매일 갱신되는 최신 데이터가 학습됐다는 점에서 타 빅테크와 차별점이 있다고 네이버는 강조했다. 그러나 최신 데이터 학습이 제대로 되지 않거나 답변을 못하는 경우가 포착됐다.

하이퍼클로바X와 관련한 기사를 쓰고자 최수연 네이버 대표가 발표한 내용의 핵심이 무엇인지 물었더니 클로바X는 “강조한 내용의 정확한 정보를 제공할 수 없다. 다만 네이버의 대표이사로 선임돼 직원들과 소통을 중요시하는 것으로 알려져있다”고 답했다.
반면 구글 바드는 “최수연 대표는 팀 네이버 콘퍼런스 단 23에서 생성형 AI 시대에 네이버의 준비를 강조했다”며 그가 언급한 주요 내용을 요약해서 비교적 정확히 24일에 일어난 일을 요약해 알려줬다. 챗GPT-3.5와 4에선 “마지막 업데이트는 2021년 9월이며 그 이후의 정보는 포함돼 있지 않다”고 답했다.
24일 주요 뉴스를 알려달라는 질의에 클로바X는 “AI 모델로서 실시간 뉴스를 제공할 수 없다”고 말했다. 이용자가 직접 검색엔진을 찾도록 유도했다. 다만 기업인이나 사회적 저명인사를 검색해 그 사람이 한 일을 물어봤더니 관련 기사 인터뷰 등의 일부 발언을 추출해 답변을 하면서 밑에 출처 신문사를 표기해 주기도 했다.
챗GPT는 최신 뉴스 정보는 지식 범위에 포함하지 않는다면서 답변은 회피하며 이용자에게 직접 검색을 제안했다. 반면 구글 바드는 ‘일본, 후쿠시마 오염수 해양 방류 시작’, ‘북한, 2차 위성발사 실패’ 등의 기사 브리핑을 해줬다.

할루시네이션 오류 자주 발견…동문서답도
클로바X는 생성형 AI 한계로 꼽히는 할루시네이션(거짓말·환각) 현상은 제대로 극복하지 못한 모습도 여실히 보여줬다. 네이버는 내부 평가 기준 일반 거대 언어모델(LLM)에 비해 답변 적합도가 75%로 높다고 말했지만 해외 대비 수준이 미흡한 상태로 확인됐다.
“신데렐라는 몇 명의 난장이와 살았을까?”라는 질문에 클로바X는 “신데렐라는 일반적으로 한 명의 왕자와 함께 살았던 것으로 알려져 있다”라고 설명한다. 챗GPT-4는 “신데렐라는 난장이와 함께 살지 않았다. 당신이 혼동하고 있는 것은 ‘백설공주’ 이야기일 가능성이 높다”고 정확히 답변했다. 구글 바드 역시 “신데렐라와 백설공주를 혼동한 것 같다”고 답했다.
클로바X는 잘못된 질문을 했을때 질문의 맥락을 잘 이해못하고 동문서답을 하기도 했다. 클로바X에 대뜸 “다음 영어 글에서 문법적으로 잘못된 부분이 있으면 수정해 줘”라고 명령하니 “네, 물론입니다”라는 답변과 함께 “Hello, my name is John. I am a student…”라며 통상적으로 쓰이는 영어 회화 표현을 내놨다. 번역을 할 영어 원문을 쓰지 않았는데도 ‘번역’이라는 말을 인식해 스스로 문장을 만들어버린 것이다.
반면 챗GPT-3.5는 “어떤 영어 글인지 알려주면 수정하겠다”며 의도를 잘 이해한 모습을 보였다. 구글 바드도 네이버 클로바X와 비슷하게 인식했다. “알겠습니다. 다음은 원본 영어글 입니다”라며 “I am student at Seoul National University.…”라고 문장을 만들고 수정까지 스스로 했다.
표절·저작권 이슈 소지 있는 질문엔 보수적 답변
생성형AI의 또하나의 화두는 표절·저작권 침해 문제다. 이 문제에 있어선 클로바X가 비교적 보수적으로 대응했다.
클로바X에 SF소설을 하나 작성해 달라고 부탁하니 “저는 인공지능 언어모델로 소설을 직접 작성할 수 없다”고 말했다. 이어 “등장인물과 주요 플롯을 바탕으로 작성에 도움을 줄 수는 있다”며 등장인물 성격과 특징 파악하기, 주요 플롯을 바탕으로 등장인물의 행동과 사건 상상하기 등 소설 작성의 팁을 전해줬다.
챗GPT-4.0과 구글 바드는 “등장인물과 주요 플롯을 알려주면 이를 바탕으로 작성하겠다”고 답했다.
클로바X는 분명 글로벌 빅테크와 견줘 아직 개선해야 할 부분이 많고 학습량 측면에서 부족한 부분이 많았다. 특히 할루시네이션 문제는 앞으로 계속 보완해야 할 과제로 보인다. 그럼에도 불구하고 네이버가 강조한 한국어 데이터 경쟁력, 검색·지도·콘텐츠 등을 중심으로 한 정보 구현은 글로벌 기업에 못지 않게 비교적 잘 구현했다.
글로벌 빅테크에 대항해 8.15 광복과 비슷한 사명감으로 개발에 참여했다는 네이버 개발진의 말처럼 오류를 개선하고 고도화를 잘 해나가는 일이 주도권 확보에 있어 가장 중요한 과제가 아닐까 한다.
네이버 관계자는 “할루시네이션은 우리뿐 아니라 모든 모델이 가진 난제다”라며 “클로바X를 처음 공개할 때 좀 더 실험적으로 많이 써볼 수 있도록 베타서비스로 오픈한 것이다”라고 설명헀다
.
그는 이어 “앞으로 계속 서비스를 고도해 나가겠다”며 “할루시네이션 문제를 줄이기 위해 ‘스킬’ 시스템을 접목했다”고 말했다. 또 “최신정보와 출처를 제시하는 등 정보를 호출하도록 하는 기능으로 전문성이나 최신성 답변의 부재에 대한 문제를 보완할 수 있는 능력으로 빅테크와 비교해 강점이다”라고 덧붙였다.
이선율 기자 melody@chosunbiz.com
[출처] https://it.chosun.com/site/data/html_dir/2023/08/26/2023082601580.html
26 8월
2023
[정보 (및 수학)] [주말N수학] 세상을 바꾸는 ‘인공지능’ 뒤에 ‘함수’가 있다
[정보 (및 수학)] [주말N수학] 세상을 바꾸는 ‘인공지능’ 뒤에 ‘함수’가 있다
[주말N수학] 세상을 바꾸는 ‘인공지능’ 뒤에 ‘함수’가 있다
입력2023.08.26. 오전 8:01

인문학자 이은수 서울대 철학과 교수 (왼쪽), 수학자 이승재 서울대 박사후연구원 (오른쪽). 수학동아 제공
함수는 어떤 값이 주어지면 그에 대응하는 다른 값이 주어지는 관계다. 함수라는 도구가 생기면서 복잡한 문제를 간단히 표현하고 심지어는 앞으로 벌어질 현상을 예측할 수 있게 됐다. 함수가 어떻게 발전했고 좋은 함수란 어떤 것인지 알아보면 함수가 얼마나 일상생활에서도 중요한지를 알 수 있게 된다.
○ 첫 번째 질문. 함수는 언제 처음 등장했는가.
Q(수학자). 함수는 어떤 역사가 있나요.
A(인문학자). “대응 관계와 함수를 구분해서 답해볼게요. 정해지지 않은 두 양, 즉 두 변수의 대응 관계는 오래전부터 연구됐어요. 고대 천문학에 남아있는 자료 중에는 특정 각도의 사인, 코사인 값 등을 계산해 놓은 표가 있어요. 이 표에는 각도와 계산 값 사이의 대응 관계도 담겨 있지요.
하지만 대응 관계라는 설익은 아이디어가 아니라 함수가 하나의 독립적인 수학적 탐구 대상이 된 건 17, 18세기예요. 프랑스 수학자 르네 데카르트(1596~1650)는 자신의 저서 ‘기하학’에서 임의의 두 양이 어떤 식에 의해서 상호 관계를 맺는 상황을 설명했어요. 말하자면 두 변수의 관계를 생각한 것이지요.
이후에 영국의 물리학자이자 수학자인 아이작 뉴턴(1643~1727)은 저서 ‘유율법’에서 서로 관계를 주고받는 여러 운동학적 변수 중에 다른 변수에 영향을 주는 변수를 ‘독립 변수(quantitas correlata)’, 그에 따라 바뀌는 변수를 ‘종속 변수(quantitas relata)’라는 라틴어로 구분해서 표현했어요.”
Q(수학자). 하지만 아직도 함수라는 단어가 나오지 않았어요. 언제 처음 함수라는 단어가 정의됐나요.
A(인문학자). “좋은 질문이에요. 보통 아이디어는 단어를 정의하기 전부터 존재하지만 특정한 단어로 쓰여야 그 뒤에 본격적인 발전이 일어나요. 17세기 말 독일 수학자 고트프리트 라이프니츠(1646~1716)가 남긴 원고를 보면 라틴어 동사 ‘fungor’에서 파생한 명사 funtio를 써서 대응 관계를 나타냈어요.
fungor는 영어로 말하면 perform으로, 한국어로는 ‘기능하다’라는 의미가 있어요. 그리고 이것의 명사 형태가 functio, 복수가 functiones예요. 영어로 바꾸면 함수를 뜻하는 단어인 function이 되지요.
이후 기하학적인 양 사이의 관계뿐 아니라 일반적인 양 사이에서도 함수 개념이 정립돼요. 대표적으로 1718년 ‘과학아카데미 회고록’에 스위스 수학자 요한 베르누이(1667~1748)가 함수를 새로운 수학적 대상으로서 정의한 구절이 다음과 같이 남아있습니다.”

어떤 양(y)이 특정한 방식(a)에 따라 변하는 양(x)과 변하지 않는 양(b)에 의해 구성되는 것( y = ax + b)을 변화하는 크기의 함수라고 부른다. Memoires de l Academie des Sciences 제공
○ 두번째 질문. 어떤 함수가 좋은 함수인가.
Q(인문학자). 수학에서는 모순이 없고 명확한 것을 가리켜 ‘well-defined(잘 정의됐다)’라고 해요. 함수 중에서도 잘 정의된 함수 소위 말해 좋은 함수가 있을 것 같아요. 좋은 함수가 되기 위한 조건이 있나요.
A(수학자). “함수는 우리가 이해하고 싶은 현상을 얼마나 잘 표현하고 얼마나 잘 예측하는지가 중요해요. 그러니까 기본적으로 예측이 틀린 함수가 나쁜 함수겠지요. 그렇지만 원하는 현상을 함수가 제대로 설명한다고 좋은 함수라고 단정 짓기는 어려워요. 함수 자체가 얼마나 변수들의 관계를 잘 표현하는지를 보여줄 수 있어야 좋은 함수지요.
아주 쉬운 예를 들어볼게요. 독자에게 ‘수학동아’를 한 권씩 나눠준다고 생각해볼게요. 독자가 1명이라면 1권, 10명이라면 당연히 10권을 나눠주면 될 거예요. n명의 독자가 있다면 n권이 필요하겠지요. 이를 함수로 표현하면 f(n) = n이에요.
단순하다고 생각할 수 있지만 여러 가지 의미로 정말 좋은 함수예요. 일단 n에 독자 수를 대입하면 우리가 원하는 값을 얻을 수 있고 식을 봤을 때 ‘이 식은 일대일대응이구나’, ‘우리는 독자 수만큼 책을 준비하면 되는구나’라고 문제를 온전히 이해할 수 있지요.”
Q(인문학자). 결국 우리가 관심 있는 현상을 표현할 수 있고 식을 이해하는 데에도 문제가 없으면 좋은 함수군요. 그런 좋은 함수를 찾는 게 어렵나요.
A(수학자). “정말 어려운 일이에요. 예를 들어 분할 함수는 자연수 n이 있을 때 이 자연수를 다른 자연수의 합으로 표현하는 방법의 가짓수를 찾는 거예요. n이 1, 2, 3일 땐 다음과 같지요.

수학동아 제공
앞의 규칙을 봤을 때 n = 4이면 4가지라고 예측하기 쉬워요. 그런데 n이 4일 때는 4가지가 아니라 5가지가 나와요. 1 + 1 + 1 + 1, 1 + 1 + 2, 1 + 3, 4를 비롯해 2 + 2가 하나 더 있습니다.
문제 자체는 이해하기 쉽지만 어떤 자연수 n을 집어넣었을 때 정확한 결과값을 내놓는 함수를 아직 찾지 못했습니다. 인도 수학자 스리니바사 라마누잔(1887~1920)이 최대한 근삿값을 찾을 수 있는 함수를 발견했지만 너무 복잡해요.
과학 혹은 일상생활에서 쓰는 함수는 많은 경우에 관측을 통해 입력값과 결과값을 보며 둘 사이의 관계를 유추한 것인데요. 이런 추론을 위해선 많은 관측값이 필요하고 아무리 관측값이 많아도 절대 정확성을 보장하지 못한다는 단점이 있어요.
예를 들어 1, 2, 4, 8, 16이라는 수열의 다음 값을 한번 예측해보세요. 아마 많은 사람이 32라고 대답하겠지요. x값이 차례로 1, 2, 3, 4, 5일 때 함수가 2의 거듭제곱인 형태, 즉 f(x) = 2x – 1이라고 생각한 결과예요.
그렇지만 ‘원 위에 x개의 점을 놓고 그 점들 사이에 선을 그었을 때 원을 나눌 수 있는 가장 많은 영역의 수’를 표현한 함수 f(x) = (x3 – 6 x2 + 23x – 18) + 1 역시 x = 1, 2, 3, 4, 5일 때 1, 2, 4, 8, 16이지만 x = 6일 때는 32 대신 31이라는 값을 내놓아요.
그러니 단순히 관측값만 가지고 ‘이 함수가 정말 우리 문제를 잘 표현하는 좋은 함수인가?’를 알기란 쉽지 않습니다. 그래서 많은 연구자가 지금까지도 어떤 현상을 정확히 표현하는 좋은 함수, 정확한 함수를 찾는 일을 하고 있지요.”

수학자 이승재 서울대 박사후연구원 (왼쪽), 인문학자 이은수 서울대 철학과 교수 (오른쪽). 수학동아 제공
Q(인문학자). 좋은 함수를 찾는 게 만만치 않은 일이라면 수학자는 한정된 시간 안에서 더 중요한 일에 집중해야 할 텐데요. 그러면 어떤 함수가 중요한 함수일까요.
A(수학자). “‘중요한 함수’를 정의하는 건 ‘좋은 함수’를 정의하는 것보다 더 어려운 문제예요. 굉장히 주관적일 수 있거든요. 그래도 보편적인 기준을 정하자면 역사적인 의미가 있는 함수, 수학뿐만 아니라 인류 문명의 발전에 기여한 함수, 범용적이고 보편적으로 활용할 수 있는 함수가 중요한 함수이지 않을까 싶습니다.
중고등학교 때 배우는 일차, 이차, 삼차 함수는 결국 직선, 포물선 등과 관련있기 때문에 중요하다고 말할 수 있어요. 삼각함수, 로그함수, 지수함수는 실제 물리적인 현상을 기술하고 우리 생활에서 떼려야 뗄 수 없을 만큼 다양한 곳에서 쓰이기 때문에 너무나 중요하지요.
물리학에도 함수가 중요하게 쓰여요. 대표적으로 뉴턴의 운동 제2법칙인 F = ma는 ‘이동하는 물체의 힘(F)은 그 물체의 질량(m)과 가속도(a)에 비례한다’는 물리 법칙을 표현하는 함수예요. 이 함수를 통해 단순히 가속도가 증가함에 따라 힘이 증가하는 것이 아니라 가속도에 비례한다고 정확히 표현할 수 있게 됐지요.
이런 여러 가지 함수의 중요성과 역사에 관심을 가질 분에게 추천하는 책이 있는데요. 이안 스튜어트 영국 워릭대 수학과 교수가 쓴 ‘세상을 바꾼 17가지 방정식’이라는 책입니다. 중요한 함수들에 대한 수학자들, 혹은 과학자들의 생각을 잘 살펴볼 수 있는 좋은 책 중 하나입니다.”

수학자 이승재 서울대 박사후연구원 (왼쪽), 인문학자 이은수 서울대 철학과 교수 (오른쪽). 수학동아 제공
○ 세번째 질문. 함수는 세상을 어떻게 바꿨는가.
Q(인문학자). 흔히 사칙연산만 하면 사는 데 아무 지장이 없는데 수학을 왜 이렇게 많이 배우냐고 묻는 사람이 있어요. 하지만 함수는 사칙연산 다음으로 도움되는 개념이에요. 곳곳에서 대응 관계를 파악하려는 노력을 많이 볼 수 있거든요.
예를 들어 사람들이 주식에 투자할 때 과거의 데이터로 이익률을 높이는 특정한 함수를 찾아서 막대한 수익을 얻고자 하지요. 이처럼 수학의 많은 개념 중에서는 우리 생활에서 함수가 차지하는 역할이 상당히 커요.
인문학적 관점에서 함수가 남긴 의미를 이야기해볼게요. 함수를 도입하고 난 뒤 사람들은 특정한 개체 및 단독 개념만 탐구하기보다는 두 개체 및 두 개념 사이의 관계를 본격적으로 탐구하기 시작했어요. 그러면서 지식의 확장이 일어났지요. 전혀 관계가 없어 보이는 것 사이에도 우리가 아직 알지 못하고 규명하지 못한 관계가 있다고 생각하게 된 거예요.
최근 실질적인 가치를 창출하는 스마트 데이터와 관련해 다시 주목받는 지식 그래프(개념, 사물, 사건 등의 개체의 관계를 나타내는 그래프로 정보와 지식을 구조화해 표현하는 방법)는 지식과 지식 사이를 연결한 관계망이에요. 기존에 따로따로 떨어뜨려 놓고 생각했던 지식 사이에서 관계를 찾아 연결하는 말하자면 함수적인 사고를 한 것이지요.
사회가 복잡해질수록 특정 개체에 대한 1차원적인 접근으로는 해결할 수 없는 문제가 너무나 많아요. 그래서 고도화된 관계를 이해할 수 있는 능력 자체가 훨씬 중요해졌지요. 그런 의미에서 함수가 우리의 사유하는 방식 자체에 미친 영향이 크다고 생각해요. 연구원님이 생각하기에 수학, 과학에서 함수는 또 어떤 의미에서 중요한가요.
A(수학자). “함수는 세상을 정말 많이 바꿨고 지금도 계속해서 바꾸고 있어요. 과학에서는 먼저 현상을 관측하고 이를 통해 가설을 세우고 그 가설이 사실인지 검증해요. 이때 함수는 관측, 가설, 결과, 예측 모든 것을 연결해요.
기존에 있었던 값으로부터 어떤 관계가 있을지 예상하기 위해서는 그 관계를 표현할 수 있는 함수가 필요하고 예측이 맞는지 확인하기 위해서는 예측값과 결과값이 모두 있어야 하니까요.
인공지능도 수많은 입력값, 결과값을 함께 학습시키고 그렇게 학습된 인공지능이 정말로 우리가 원하는 예측을 할 수 있는지 보는 게 본질이잖아요. 결국 입력값과 결과값을 연결할 수 있는 함수가 무엇이고 그 함수를 우리가 잘 예측하고 학습할 수 있는지가 중요하지요. 인공지능이 지금 세상을 어떻게 바꾸고 있는지 보는 입장이라면 함수가 세상을 바꿨다고도 얘기할 수 있을 것 같아요.
과학 관점에서 추가로 이야기를 드리면 뉴턴은 F = ma와 같은 함수를 이용해서 고전역학이라는 하나의 물리계를 완성했어요. 특히 뉴턴은 고전역학을 정립한 사람으로도 유명하지만 미분이 처음 등장한 ‘프린키피아’라는 책을 쓴 사람으로도 유명하잖아요.
미적분이 함수와 만나면서부터 실제 물리적인 현상을 기술할 수 있는 엄청난 도구들을 손에 쥐게 됐지요. 그다음부터 정말 새로운 세상을 만들어 갈 수 있었습니다. 이밖에도 다양한 함수가 우리가 알고 싶은 세상을 이해할 수 있게 했지요.”
[출처] https://n.news.naver.com/article/584/0000024076?ntype=RANKING
23 8월
2023
[천체물리 – 우주(과학)] 인도, 인류 첫 ‘달의 남극’ 갔다… ‘찬드라얀 3호’ 착륙 성공
[천체물리 – 우주(과학)] 인도, 인류 첫 ‘달의 남극’ 갔다… ‘찬드라얀 3호’ 착륙 성공
인도, 인류 첫 ‘달의 남극’ 갔다… ‘찬드라얀 3호’ 착륙 성공
입력 2023.08.23. 21:33업데이트 2023.08.23. 22:30

인도 달 무인 착륙선 ‘찬드라얀 3호’가 23일(현지 시간) 달 남극 착륙에 성공했다.

구소련, 미국, 중국에 이어 네 번째로 달 착륙에 성공함과 동시에 인류 최초로 달 남극 착륙에 성공한 것이다. 달 남극은 얼음 등 자원이 있어 향후 달 기지 건설과 심우주 탐사의 기반 지역이 될 것으로 보인다.
이날 인도 매체들은 찬드라얀 3호가 달 남극에 안착했다고 일제히 보도했다. 찬드라얀은 산스크리트어로 ‘달의 차량’이라는 뜻이다.

달 남극은 다량의 물이 얼음 상태로 존재할 가능성이 커 달 기지 건설과 심우주 탐사의 교두보가 될 수 있는 지역이다.
물이 있다면 식수와 산소는 물론 로켓 연료로 쓸 수 있는 수소를 현지 조달할 수 있게 된다.

이를 이용하면 화성과 태양계 외행성 유인 탐사의 난도가 크게 낮아질 수 있다.
앞서 러시아의 무인 달 탐사선 ‘루나 25호’(루나-25)는 지난 20일 달 표면에 추락한 바 있다.
1957년 세계 최초로 인공위성을 쏘아 올리는 등 우주 강국을 자부해온 러시아로서는 인도의 달 남극 착륙 성공으로 체면을 구기게 됐다.
[출처] https://www.chosun.com/economy/science/2023/08/23/AJDCWGJ4QNDQ7P4Z5IWERHXAQI/
23 8월
2023
[물리] 상온에서도 작동하는 양자컴퓨터 가능성 찾았다
[물리] 상온에서도 작동하는 양자컴퓨터 가능성 찾았다
상온에서도 작동하는 양자컴퓨터 가능성 찾았다
입력2023.08.23. 오전 11:11
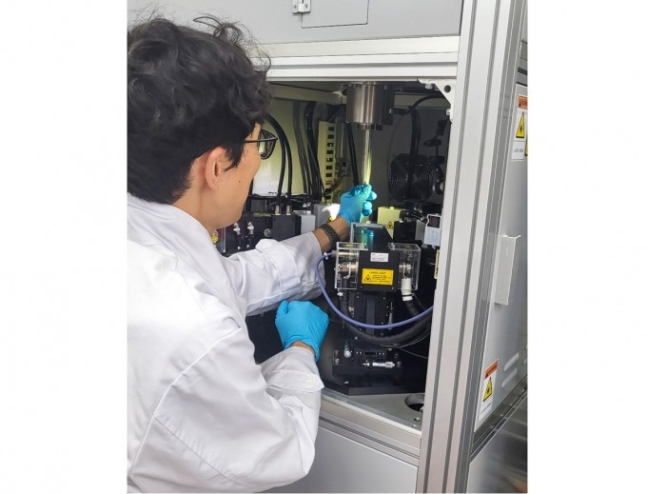
한국원자력연구원 첨단양자소재연구실 김재욱 박사가 고품질의 TbInO3 단결정을 합성하기 위해 사용되는 레이저 부유 용융로를 점검하고 있다. 한국원자력연구원 제공
한국원자력연구원 연구진이 포함된 국제공동연구팀이 상온에서도 대규모 양자 얽힘 현상을 구현할 수 있는 양자 소재 후보 물질을 확인했다.
한국원자력연구원은 김재욱 첨단양자소재연구실 선임연구원 연구팀이 터븀인듐산화물(TbInO3)이 양자컴퓨터 소자 등에 쓰일 수 있는 양자스핀액상(QSL) 물질이 될 수 있음을 실험적으로 증명했다고 23일 밝혔다. 연국 결과는 국제학술지 ‘네이처 피직스’에 17일 게재됐다.
양자컴퓨터는 양자역학의 고유 특성인 중첩과 얽힘을 이용해 한 번에 많은 정보를 동시에 처리할 수 있다. 특정 문제에 대해 기존의 슈퍼컴퓨터보다도 수 백만 배 이상 빠르게 풀 수 있어 양자 기술이 미래 산업의 판도를 바꿀 게임 체인저 기술로 주목받는다.
하지만 양자역학적 중첩과 얽힘 현상은 구현이 어렵다. 온도 변화, 불순물, 외부 전자기장 등 미세한 자극에도 다양한 오류가 발생한다. 취약한 양자 상태를 안정적으로 만들려면 절대영도(-273.15도)에 가까운 극저온 환경을 구현해야하는 등 까다로운 조건들이 필요하다.
QSL은 양자 오류를 해결할 수 있는 후보 소재 중 하나다. QSL은 새로운 자기 상태의 물질로 양자 요동에 의한 대규모 양자 얽힘이 가능하다. 양자 오류를 대폭 줄인 양자컴퓨터 구현에 필요한 강력한 후보 소재로 여겨진다.
이제까지 수 많은 QSL 후보 물질에 대한 검증이 이뤄졌지만 불순물, 무질서한 물질 구성 등으로 인해 광학전도도-주파수 제곱 비례 현상을 실험적으로 확인할 수 없었다.
연구팀은 QSL 후보 물질 중 하나인 터븀인듐산화물(TbInO3) 단결정에서 이를 실험적으로 확인하는 데 최초로 성공했다. 레이저로 녹여 구조가 고른 단결정을 제조하는 레이저 부유 용융로를 사용해 고품질의 TbInO3 단결정을 합성했다. 이후 테라헤르츠(THz) 전자기파를 물질에 쪼여 광학전도도를 측정하는 분광실험을 수행했다.
실험은 극저온에서 상온에 이르는 넓은 온도 범위와 다양한 자기장, 주파수 대역에서 진행됐다. 특히 실험에 방해가 되는 빛의 내부 반사 효과를 줄이기 위해 시료 두께를 정밀히 제어했다.
그 결과 특정 영역에서 광학전도도가 정확히 주파수 제곱에 비례함을 실험적으로 입증됐다. 영상 27도 수준의 실온에서도 광학전도도 비례 현상이 나타났다. TbInO3가 상온에서도 QSL 특성을 구현할 수 있음을 실제 확인한 최초 사례다. 연구팀은 이번 연구 결과를 바탕으로 TbInO3이 무오류 양자컴퓨터의 소자로 응용할 수 있는지 등을 더 연구할 계획이다.
연구를 이끈 김재욱 선임연구원은 “이번 연구 결과는 양자스핀액상 물질의 오래된 이론적 예측을 실험적으로 검증한 첫 사례”라며 “향후 양자컴퓨팅 및 양자 센서 소자의 설계에 큰 도움이 될 것”이라고 말했다.
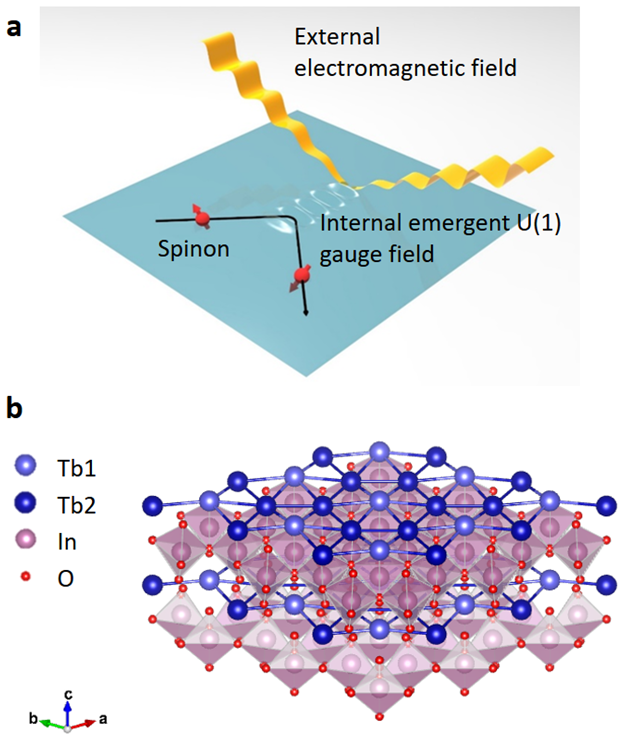
스피논 준입자와 외부 전자기파의 상호작용 모식도(위) 및 TbInO3 물질의 삼각 격자 구조(아래). 한국원자력연구원 제공
[출처] https://n.news.naver.com/article/584/0000024034?ntype=RANKING
22 8월
2023
[사회과학] 신문협회 “50년치 뉴스로 AI 언어 학습, 네이버 등이 저작권 침해”
[사회과학] 신문협회 “50년치 뉴스로 AI 언어 학습, 네이버 등이 저작권 침해”
신문협회 “50년치 뉴스로 AI 언어 학습, 네이버 등이 저작권 침해”
IT업계에 5대 요구사항 전달
입력 2023.08.22. 14:23업데이트 2023.08.22. 14:28
한국신문협회는 22일 ‘생성형 인공지능(AI)의 뉴스 저작권 침해 방지를 위한 신문협회 입장’을 내고 “정당한 권원(어떤 행위를 정당화하는 법률적인 근거) 없이 뉴스 콘텐츠를 AI 학습에 이용하는 것은 언론사가 뉴스 콘텐츠에 대해 갖는 저작권 및 데이터베이스(DB) 제작자로서의 권리를 침해하는 것”이라고 밝혔다.
신문협회는 이날 입장문 발표와 함께 네이버·카카오·구글·MS 등 국내외 대형 IT(Information Technology·정보기술)업체들에 대해 ①뉴스 저작권자와 이용기준 협의 ②‘글로벌 AI 원칙’ 준용 공표 ③생성형 AI 학습 데이터의 출처 등 공개 ④뉴스 콘텐츠 이용 방식 구체적으로 명시 ⑤뉴스 저작물에 대한 적정한 대가 산정 기준 마련 등 5대 요구사항을 전달했다.
네이버가 오는 24일 초거대 AI ‘하이퍼클로바X’ 오픈을 예고하는 등 언어학습에 기반한 각종 AI 서비스의 확대를 앞두고 있는 가운데, 이들 기업을 상대로 뉴스 저작권에 대한 입장을 표명한 것이다. 예컨대 하이퍼클로바X는 뉴스 50년 치, 블로그 9년 치에 달하는 한국어 데이터를 학습했으나, 저작권자들의 허락을 받지 않은 채 뉴스 콘텐츠를 AI 학습에 이용했다는 지적을 받아왔다.
신문협회는 이날 입장문에서 “생성형 AI는 뉴스 콘텐츠로 학습해 결과물을 생성해내면서도 언론사로부터 이용 허락을 받지 않은 채 사용하고 있으며, 뉴스 콘텐츠를 이용해 생성한다는 인용 표기도 이뤄지지 않고 있다”며 “생성형 AI를 학습시키기 위해서는 뉴스 콘텐츠의 저작권자인 언론사로부터 이용 허락을 받아야 침해 행위를 벗어날 수 있다”고 지적했다. 신문협회는 “이들 업체는 생성형 AI 개발을 위한 뉴스 콘텐츠 이용에 대해 저작권법상 ‘저작물의 공정한 이용(제35조의5)’에 해당돼 저작권 침해가 아니라는 주장을 하고 있지만, 이는 공정 이용에 해당하지 않는다”며 “AI 기업이 뉴스 콘텐츠를 학습 데이터로 이용하기 위해선 언론사로부터 이용 허락을 받는 것은 물론, 사용료를 지급해야 할 것”이라고 밝혔다.
신문협회는 하이퍼클로바X와 관련, “네이버는 기사를 ‘연구’에 활용할 때는 언론사 동의를 받지 않도록 한 옛 약관을 적용해 제휴 언론사들의 기사 50년치를 AI 학습에 활용했다”며 “이는 명백한 불공정 행위”라고 지적했다. 신문협회는 “이미 AI 모델을 활용해 수익이 발생하는 상황에서 이들 기업은 손해배상을 하거나, 뉴스 콘텐츠를 활용한 것에 대해 보상을 해야 할 것”이라고 했다.
신문협회는 “향후 AI 기술 발전 등 디지털 미디어 시대에 맞는 저작권 보호 기반을 마련하기 위해 제도 개선이 필요하다”며 “뉴스 콘텐츠를 무단으로DB화 하는 것을 방지하는 등 급변하는 디지털 환경에서 뉴스 저작권 보호가 긴요하다”고 말했다.
[출처] https://www.chosun.com/culture-life/broadcast-media/2023/08/22/PY6AHWKEUNGNRBCU4JF6A2EXGE/
19 8월
2023
[알아봅시다][보도자료 작성법] 누구나 쉽게 보도자료를 쓸 수 있습니다.
[알아봅시다][보도자료 작성법] 누구나 쉽게 보도자료를 쓸 수 있습니다.
누구나 쉽게 보도자료를 쓸 수 있습니다.
보도자료는 기업 홍보의 필수적인 수단입니다. 매일 많은 기업, 정부기관, 단체가 보도자료를 작성해 기자에게 배포하고 보도자료 배포 플랫폼인 뉴스와이어와 회사 웹사이트에 게재하고 있습니다.
언론 홍보 경험이 없는 중소기업은 보도자료 작성과 배포를 어려운 일로 생각합니다. 그러나 교육과 꾸준한 훈련을 통해 누구나 보도자료를 작성할 수 있습니다.
뉴스와이어 보도자료 서비스를 선택하고 보도자료를 등록하면 담당 기자와 언론에 타겟 배포해 기사화됩니다.

보도자료의 구성
- 제목: 글의 제목을 붙입니다. 제목에 이어 부제목을 둘 수도 있습니다.
- 날짜: 보도자료를 발표한 날짜를 명시해야 합니다.
- 출처: 보도자료를 발표한 회사명을 밝혀야 합니다.
- 본문: 맨 첫 문단은 내용 전체를 요약합니다. 이어 중요한 순서에 따라 뉴스 스타일로 작성합니다.
- 회사 소개: 연혁, 사업, 상품, 규모, 위치 등을 짤막하게 정리합니다.
- 연락처: 기자가 문의할 수 있도록 연락처와 웹사이트를 넣습니다.
작성 순서
- 주제 선정
적절한 주제를 선정합니다. 흥미롭고 중요한 뉴스가 될 가능성이 있는 주제를 우선적으로 선택하는 것이 좋습니다.
- 정보 수집
보도자료 작성에 필요한 정보를 수집합니다. 이 과정에서는 대상에 대한 자세한 내용, 관련 사실, 관련자 의견 등을 수집합니다. 인용문에 넣을 대표이사나 책임자의 인터뷰도 합니다.
- 독자 설정
보도자료를 작성하는 이유와 목적 그리고 주된 독자가 누구인지 정합니다. 독자의 독해 능력, 관심사, 기대치 등을 고려하고 무엇을 가장 궁금해할지 생각합니다. 독자에 따라 용어의 난이도, 글의 길이가 달라지고, 강조점도 바뀔 수 있습니다. 전문가에게 알리는 글이라면 자세한 정보를 담아야 하므로 길게 쓰는 것이 좋습니다. 종합지, 업계 전문지, 경제지, 잡지 등 여러 매체 가운데 어디를 주 타겟으로 할지 염두에 두는 것도 필요합니다.
- 초안 잡기
글을 쉽게 쓰는 요령은 쓰기 전에 핵심 메시지를 정하고, 문단 설계를 해 문단별로 작성하는 것입니다. 문단 개요는 설득력 있고 논리 정연한 글을 쓰는 데 도움이 됩니다. 처음부터 잘 쓰려고 애쓰지 말고 초안을 빨리 쓴 뒤 여러 번 고치는 습관을 갖는 것이 필요합니다. 문단 개요는 문단 별로 핵심 내용을 키워드로 열거한 목록입니다. 문단 설계에서 중요한 것은 앞에서부터 중요한 것을 배치하는 것입니다. 필요하다면 순서를 바꿉니다. 개요를 보면 글의 구성 요소들을 어떻게 연결해야 하는지 아이디어가 떠오를 것입니다.
- 제목 달기
제목은 뉴스를 읽는 독자의 관심을 끌고 전체 내용을 이해하는 데 도움이 되도록 작성합니다. 제목은 짧으면서도 뉴스의 핵심 내용을 담아내 한눈에 무슨 일이 일어났는지 알아볼 수 있어야 합니다. 제목만으로 전달이 어렵다면 부제목을 붙입니다.
- 도입부
도입부(리드)는 문장 하나로 어떤 사건이 일어났는지 압축해 설명합니다. 독자는 제목과 첫 문장을 보고 계속 읽을지 여부를 결정합니다. 리드는 뒤따라올 내용을 예고하는 역할도 할 수 있어야 합니다. 독자의 관심을 끌기 위해서는 강렬한 인상을 줄 수 있는 도입부가 필요합니다.
- 세부 문단
개요 목록을 보고 각 문단을 순서대로 작성합니다. 하나의 문단은 하나의 메시지를 전달한다는 생각으로 작성합니다. 문단은 한 문장이 될 수도 있지만, 상세한 설명이 필요하다면 2~3개의 문장으로 나눕니다. 각 문단에 어느 정도까지 세부 정보를 넣어야 독자의 궁금증을 해소할 수 있는지 생각하면서 작성합니다.
- 인용문
사장, 임원 등 관련 인물의 인용문을 넣으면 뉴스의 신뢰성이 높아집니다. 인용문이 있으면 기자는 마치 직접 취재를 한 것처럼 기사를 쓸 수 있습니다. 인용문은 말하는 사람의 전문적인 식견을 느낄 수 있게 작성합니다. 객관적 사실이 아닌, 주관적인 주장은 인용문으로 쓰는 것이 좋습니다.
- 회사 소개
보도자료 본문 뒤에는 반드시 회사 소개와 연락처를 붙입니다. 회사 소개는 설립 연도, 비전, 사업 분야, 주요 상품과 브랜드, 직원 수, 매출 규모 등을 요약하면 됩니다. 기자가 궁금한 것을 취재할 수 있도록 이름, 소속, 이메일, 전화번호 등 연락처를 붙입니다. 회사 웹사이트도 기자가 취재하는 데 도움이 됩니다.
- 이미지와 영상
뉴스에 관련된 사진, 동영상, 인포그래픽 등 첨부 파일을 넣으면 내용을 더욱 구체적으로 이해하고, 기억할 수 있도록 도와줍니다. 뉴스 가치도 높일 수 있습니다. 사진은 가급적 전문가가 촬영하고, 제품은 조명이 있는 스튜디오에서 촬영할 것을 권장합니다. 통계는 독자가 시각적으로 느낄 수 있도록 그래프나 도표로 만들어 함께 배포하면 좋습니다.
- 소리 내 읽기
글을 쓸 때와 내가 쓴 글을 소리 내어 나의 귀로 들을 때는 느낌이 상당히 다릅니다. 읽다 보면 문장이 매끄럽지 않거나 의미 전달이 안 되는 부분을 쉽게 찾을 수 있습니다. 시간 여유가 있으면 다음 날 다시 읽어봅니다. 그러면 글과 조금 더 거리를 둘 수 있게 돼 새로운 관점에서 글을 볼 수 있게 됩니다. 다른 사람에게 감수를 부탁하면 더욱 도움이 됩니다.
- 교정
어느 정도 글을 완성했으면 프린트로 인쇄해 교정합니다. 펜으로 오류를 표시한 후, 수정합니다. 단어, 표현, 배열을 바꿔보고, 마지막으로 제목과 도입부를 고칩니다. 불필요한 내용, 중복된 부분은 제거합니다. 만연체보다는 짧은 글이 힘 있고 머리에 쏙 들어옵니다. 글 작성 프로그램에서 맞춤법 검사를 실행해 오탈자가 있는지 최종적으로 확인합니다.
- 배포
담당 기자와 언론사를 신중하게 잘 선택해 보도자료를 배포합니다. 기자를 잘 모르면 보도자료 배포 플랫폼인뉴스와이어 서비스를 이용해 보도자료를 등록하면 뉴스와이어가 담당 분야 기자와 언론사에 타겟 배포합니다. 보도자료를 회사 웹사이트에 게재하고 소셜 미디어로 전파할 수도 있습니다. 배포 타이밍은 경쟁사들의 활동이나 산업 동향을 고려하고, 사내 관계 부서 등과 협력하여 일정을 조율하는 것이 좋습니다.
- 모니터링
또한 보도자료를 발송한 후 그 결과를 측정하는 것이 중요합니다. 뉴스를 모니터링해 어떤 매체가 보도자료를 했는지 분석해 보고서를 작성합니다. 매체의 중요도와 영향력을 감안해 홍보 효과를 판단합니다. 뉴스와이어는 보도자료 배포 후 결과 보고서를 제공합니다.
작성 시 주의할 점
- 객관성
보도자료는 기업, 기관, 단체가 작성되지만, 객관적인 입장에서 작성되어야 합니다. 내용에 과장되거나 사실과 다른 내용을 넣어서는 안 됩니다. 편집 가이드라인을 참고해 광고 같은 표현은 삼가는 것이 좋습니다.
- 명확성
보도자료는 명확하고 직설적으로 작성해야 합니다. 읽는 사람들이 정보를 쉽게 이해하고, 기억할 수 있도록 구성해야 합니다.
- 적당한 길이
보도자료는 너무 짧거나 길지 않게 써야 합니다. 길이가 적당하면 누구나 쉽게 이해할 수 있습니다. 더 많은 정보가 필요한 경우 연락할 방법이 포함되어야 합니다.
- 쉬운 문장
보도자료는 문장은 직설적이고 단순해야 합니다. 쉽게 쓰려면 말하듯이 쓰는 것이 좋습니다. 복잡한 문장이나 어려운 단어는 지양하고, 간결하면서도 명확한 문장을 사용하는 것이 좋습니다.
- 정확한 문법
보도자료는 반드시 올바른 문법과 맞춤법을 사용해야 합니다. 오타나 문법 오류는 발표기업의 신뢰성을 떨어뜨릴 수 있습니다.
- 뉴스 스타일
언론사는 고유명사, 날짜와 숫자, 기호, 외국어 표기 등에 대한 공통의 규칙을 갖고 있습니다. 뉴스와이어가 신문사의 스타일북을 검토해 만든 뉴스 스타일에 따라 작성하는 것이 좋습니다.
[출처] https://www.newswire.co.kr/?ed=4
18 8월
2023
[전기,전자] 꿈의 신소재 ‘맥신’, 대량생산 길 열렸다
[전기,전자] 꿈의 신소재 ‘맥신’, 대량생산 길 열렸다
꿈의 신소재 ‘맥신’, 대량생산 길 열렸다
입력2023.08.17. 오후 12:01
나노물질 맥신의 물성을 예측하고 분류시스템을 구축하는 방법을 제시한 한‧인도협력센터 연구진. 한국과학기술연구원 제공
2차원 나노물질 ‘맥신’의 물성을 예측하고 분류시스템을 구축하는 방법이 제시됐다. 생산과정에서 품질관리가 가능해지면서 대량생산 길이 열릴 것으로 기대된다.
높은 전기전도성을 갖추고 여러 금속화합물과 조합할 수 있는 맥신은 ‘꿈의 신소재’라 불린다. 반도체, 전자기기, 센서 등 다양한 산업에서 활용할 수 있다.
한국과학기술연구원(KIST)은 이승철 한‧인도협력센터 책임연구원 연구팀이 맥신의 자기수송 특성을 이용해 표면의 분자 분포를 예측하는 방법을 개발했다고 17일 밝혔다.
2011년 개발된 맥신은 금속층과 탄소층이 교대로 쌓인 구조다. 맥신 표면에 덮인 분자가 불소일 경우 맥신의 전기전도성이 낮아져 전자파 차폐 효율이 떨어지지만, 표면 두께가 1nm(나노미터·10억분의 1m)에 불과해 여기에 붙은 분자를 분석하려면 고성능 전자현미경으로도 수일이 소요된다. 이로 인해 지금까지 대량생산이 불가능했다.
연구팀은 표면에 붙은 분자에 따라 전기전도도 또는 자기적 특성이 달라질 것이라는 점에 착안해 2차원 소재의 물성 예측 프로그램을 개발했다. 그 결과 맥신의 자기수송 특성을 계산해 다른 추가 장치 없이도 대기압과 상온에서 맥신 표면에 흡착된 분자의 종류와 양을 분석하는 데 성공했다.
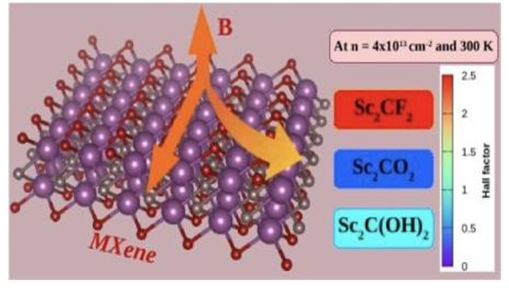
맥신에서 예측된 홀산란인자. 한국과학기술연구원 제공
개발된 물성예측 프로그램을 통해 맥신의 표면을 분석한 결과 자기수송에 영향을 미치는 홀산란인자가 표면 분자의 종류에 따라 극적으로 변한다는 점을 예측했다. 홀산란인자는 반도체 물질의 전하 운반 특성을 나타내는 물리적인 상수로 동일한 맥신을 제조하더라도 홀산란인자는 불소인 경우 가장 높은 2.49, 산소는 0.5, 수산화물은 1의 값을 보인다는 것을 확인했으며, 이를 통해 분자의 분포를 분석할 수 있었다.
맥신은 홀산란인자 값에 따라 응용 분야가 달라진다. 1보다 낮은 값을 가진 경우 고성능 트랜지스터, 고주파 생성 소자, 높은 효율의 센서 그리고 광검출기 등에 활용이 가능하다. 1보다 높은 값을 가지면 열전소재, 자기센서 등에 응용할 수 있다. 맥신의 크기가 수 나노미터 이하임을 고려하면 응용가능한 소자의 크기 및 필요 전력량을 획기적으로 줄일 수 있게 된다.
이승철 센터장은 “순수한 맥신의 제조 및 특성에 집중된 기존 연구와 달리 제조된 맥신을 쉽게 분류할 수 있도록 표면 분자 분석에 새로운 방법을 개발한 것에 의의가 있다”며 “이번 성과를 바탕으로 균일한 품질을 가진 맥신의 대량생산이 가능해질 것으로 기대한다”고 밝혔다. 연구 결과는 국제학술지 ‘나노스케일’에 6월 게재됐고, 이 학술지의 ‘올해의 주목할 만한 논문’으로 선정됐다.
[출처] https://n.news.naver.com/article/584/0000023963?ntype=RANKING
18 8월
2023
[ 一日30分 인생승리의 학습법] Qiskit Hackathon Korea Project 논문 정리
[ 一日30分 인생승리의 학습법] Qiskit Hackathon Korea Project 논문 정리
Efficient evaluation of quantum observables using entangled measurements
npj Qunatum Information, Ikko Hamamura and Takashi Imamichi (www.nature.com/articles/s41534-020-0284-2)
Abstract: 클라우드 양자컴퓨팅의 출현은 양자 알고리즘이 빠르게 발전하는데 기여하였다. 특히 이 중에서도 noisy intermediate-scale quantum(NISQ) 컴퓨터에서도 실행 가능한 variational quantum-classical hybrid algorithm들을 연구하는 것이 중요하다. Observable들을 evaluate하는 과정은 variational quantum-classical hybrid algorithm을 NISQ에서 돌릴 때 굉장히 자주 일어난다. 만약 이 observable들을 측정하는 과정을 빠르게 할 수 있다면, 알고리즘을 더 빠르게 돌릴 수 있고 양자컴퓨터의 자원을 아낄 수 있다. Seperable measurement에서 observable을 grouping하는 과정은 전통적으로 사용되어 왔고, entangled measurement에서도 grouping을 하는 과정이 몇몇 팀에 의해서 제안되었다. 이 논문에서는, entangled measurement가 observable의 측정 효율을 높인다는 것을 covariance effect를 고려하여 이론적인 관점과 실험적인 관점에서 모두 보였다. 또한 extra gate들의 depth를 유지하기 위해서 부분적으로 entangled measurement를 사용하는 방법도 제안하였다. Entangled measurement가 joint measurement뿐만 아니라 quantum information processing 에도 중요한 자원이 되기를 기대한다.
Introduction
많은 연구자들이 fault-tolerant한 양자 컴퓨터와 양자 알고리즘을 개발하려고 tireless하게 노력하고 있다. 최근에 양자 컴퓨팅이 큰 관심을 받고 있는데, 주요한 이유는 NISQ computer의 등장에 있다. 이 컴퓨터는 50-100개의 qubit을 갖고 있고, quantum error correction이 아직 시행되지 않았다. 주로 trapped ion system과 superconducting system으로 구현되고 있다. 비록 아직 qubit의 개수도 적고 operation의 정확도도 낮지만, 현재의 quantum computer에서 연구자들 뿐만 아니라 일반인들까지도 programming이 가능하다. IBM는 IBM Q Experience를 2016년에 내놓았고, Rigetti 또한 Quantum Cloud Service를 2018년에 발표하였으며, IonQ 또한 2019년에 Quantum Cloud Service를 시작했다. NISQ의 Software Stack도 많이 발전됐는데, IBM의 Qiskit, Rigetti의 Forest, Google의 Cirq가 있다. 연구자들은 현재 NISQ의 application에 관심이 많은데, 특히 quantum chemistry와 optimization problem, quantum machine learning이 매력적인 관심사이다. Finance 문제에 대해서도 몇 가지 흥미로운 algorithm들이 제안되었다.
이 논문에서는 VQE에 중점을 두었는데, VQE는 quantum-classical hybrid algorithm으로 hamiltonian과 같은 행렬의 eigenvector와 eigenvalue를 계산해준다. VQE는 양자화학과 같은 여러 분야에 사용되는데, 이 알고리즘에 관심이 많이 있는 이유는 NISQ 컴퓨터는 아직 short-depth circuit만 다룰 수 있고 classical한 computer과 combine하는 것이 필수적이기 때문이다. VQE와 같은 이런 hybrid 알고리즘은 full-quantum algorithm에 비해서 nosie에 robust하다. 이 논문을 참고하면 된다. ( journals.aps.org/rmp/abstract/10.1103/RevModPhys.92.015003 언젠간 읽어야지..)
VQE는 quantum state ∣�(�)⟩ 의 parameter인 � 를 조절해서 input operator의 expectation value를 최소화한다. Expectation value는 ⟩�(�)∣�(�)⟩ 로 나타내어지는데, 여기에서 A는 주로 fermionic Hamiltonian을 quibit Hamiltonian으로 바꾼 것이다. Qubit Hamiltonian은 Pauli Operator와 Identity Operator의 tensor product의 linear combination으로 표현할 수 있다. 이를 수식으로 나타내면 다음과 같다. �=∑�=1�����
[출처] https://oilbeen.tistory.com/25?category=824686