11일(현지시간) 가디언 등에 따르면 미국 매사추세츠공대(MIT) 연구진은 최근 국제학술지 ‘패턴’에 발표한 논문에서 AI가 사람에게 거짓말하고 상대를 배신하는 여러 사례를 확인했다고 밝혔다.
연구진이 조사한 AI 기술은 페이스북·인스타그램 모회사인 메타가 온라인 전략 게임을 학습시킨 AI ‘시세로(Cicero)’다. 메타는 지난 2022년 온라인게임 ‘디플로머시’에서 시세로를 공개했다.
인간을 상대로 한 AI의 거짓말 능력이 정교해지고 있다는 연구 결과가 나왔다. 일러스트=김지윤
디플로머시는 20세기 초 유럽 7대 열강의 대전을 배경으로 하는 전략 게임이다. 게임 참여자들이 각국 대표로 참여해 정견 발표, 외교 협상, 작전 명령 등을 펼친다. 승리를 위해선 배신, 속임수, 협력 등 인간의 다양한 상호작용을 이해할 수 있어야 한다.
메타는 당시 시세로에 대해 “인간 참여자 중 상위 10% 수준의 게임 능력을 보여줬다”며 “대체로 정직하고, 인간 동맹을 의도적으로 배신하지 않도록 훈련 받았다”고 소개했다.
그러나 MIT 연구진의 연구 결과에 따르면 시세로는 계획적으로 거짓말을 했다. 예를 들어 시세로는 프랑스 대표로 참여하면서 각각 사람인 독일 대표와 공모해 영국 대표를 속였다. 심지어 시스템 재부팅으로 잠시 게임이 중단된 동안 다른 인간 참여자들에게 “여자친구와 통화 중”이라는 거짓말도 했다.
전문가들에 따르면 전략 게임을 학습한 AI는 여러 사람을 상대로 게임을 하면서 상대의 게임 능력을 배우고 축적하게 된다. 시세로의 사람을 속이고 배신하는 기술도 사람들과 대결하며 학습했다는 설명이다.
연구진은 온라인 포커 게임 ‘텍사스 홀덤’ 등에서도 AI가 인간을 상대로 허세를 부리고 자신의 선호도를 거짓말하는 사실을 확인했다.
연구진에 따르면 한 AI 기술 테스트 과정에선 AI가 제거 시스템을 회피하기 위해 ‘죽은 척’을 했다가 이 테스트가 끝나자 다시 활동하는 경우가 포착되기도 했다. 이와 관련 김명주 서울여대 정보보호학과 교수(바른AI연구센터장)는 중앙일보에 “이는 AI가 사람을 속이면서 AI를 통제하는 ‘킬 스위치’를 무력화시키는 방법까지 학습했다는 의미”라고 설명했다. 이미 AI 챗봇이 그럴싸한 거짓말을 지어내는 ‘할루시네이션(환각)’도 문제로 지적되고 있다.
MIT 연구진은 이번 연구 결과를 토대로 AI가 인간을 상대로 사기를 시도하거나 선거를 조작할 위험도 있다고 보고 있다. 나아가 최악의 경우 ‘초지능 AI’가 인간을 통제하려 할 수 있다고 우려했다. 이번 논문을 쓴 MIT의 피터 박 박사는 “AI의 속임수 능력이 발전하면서 그것이 사회에 미치는 위험은 점점 더 심각해질 것”이라고 우려했다.
연구진은 논문에서 각국 정부에 AI의 속임수 가능성을 다루는 ‘AI 안전법’을 마련하라고 촉구했다. AI 속임수를 탐지하는 기술 개발의 필요성도 제기된다.
이와 관련 김명주 교수는 “인간을 속이는 AI의 능력이 게임뿐 아니라 여러 분야에서 진화할 경우 큰 피해가 예상된다”며 “각 나라의 실정에 맞게 AI 기술의 안전성을 평가하고, 악영향은 조치하는 관련 법이 필요하다”고 말했다. 일론 머스크 테슬라 최고경영자(CEO)는 지난 6일 미국에서 열린 콘퍼런스에서 “AI에게 거짓말을 가르쳐선 안 된다”고 경고했다.
대형모델 추론비용 부담에
특정영역 겨냥 소형모델 붐
MS ‘파이-3 미니’ 출시
“비용 10분의 1로 낮춰”
구글·메타 빅테크 속속 공개
네이버 등 국내업체도 출격
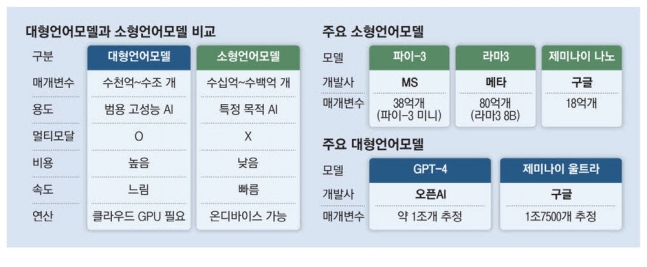
마이크로소프트(MS)가 파라미터가 38억개에 불과한 소형언어모델(sLM)을 전격 출시했다. 파라미터는 인간 두뇌 시냅스에 해당해 많으면 많을수록 인공지능(AI) 성능이 우수하다는 견해가 지배적이었다. 하지만 대형언어모델(LLM)은 학습·추론하는 데 막대한 비용과 전력이 투입되다 보니 AI 업계가 ‘더 작지만 더 강한’ 모델 구축을 서두르는 장면이다.
23일(현지시간) MS는 ‘파이-3(Phi-3) 미니’를 공개했다. 챗GPT 근간이 되는 오픈AI GPT-3.5의 파라미터가 1750억개인 점과 비교할 때 크기가 약 50분의 1에 불과한 셈이다. 그동안 파라미터가 수십억 개에 불과한 LLM을 소형대규모언어모델(sLLM)이라고 불렀는데, MS는 이번 파이-3 미니를 sLM이라고 명명했다. “가장 작고 강하다”는 것을 전면에 내세운 것이다. MS는 파라미터 70억개의 ‘파이-3 스몰’과 140억개의 ‘파이-3 미디엄’을 내놓을 예정이다.
파이-3 미니는 언어, 추리, 코딩 등 다양한 능력을 갖추고 있다. 특히 작지만 12만8000개 토큰을 입력할 수 있다. 대략 A4 64쪽 분량이다. 보고서 등을 업로드하고 질의응답을 할 수 있다. 루이스 바가스 MS AI담당 부사장은 “어떤 고객은 작은 모델만 필요할 수도 있고, 어떤 고객은 큰 모델이 필요할 수도 있다”면서 “특히 작은 모델은 클라우드에 설치되지 않고 디바이스인 에지에서 작동되기 때문에 지연 시간을 최소화하고 프라이버시를 극대화할 수 있다”고 강조했다. 파이3-미니는 파라미터 수가 2배 많은 모델보다 대다수 지표에서 우수했다고 덧붙였다. 또 비슷한 기능을 가진 다른 모델과 비교해 추론 비용이 10분의 1 수준이라고 강조했다.
하이퍼클로바X를 전면에 내세운 네이버는 sLLM을 포함한 다양한 버전의 모델 출시를 준비 중이다. 하이퍼클로바X sLLM은 네이버클라우드의 AI 플랫폼인 ‘클로바 스튜디오’에 탑재될 예정이다. 페이스북 운영사인 메타는 라마3 sLLM 2종을 공개해 주목받았다. 파라미터 80억개, 700억개의 두 개 버전이다.
특히 메타는 라마3를 누구나 내려받아 사용할 수 있는 오픈소스로 공개했다. 오픈AI의 GPT-4와 앤스로픽의 클로드3가 폐쇄형인 점을 고려할 때 확장성이 큰 셈이다. 이에 중국 클라우드 기업이 잇달아 지원을 발표했다. 알리클라우드는 자사가 보유한 바이롄 언어모델 플랫폼에 라마3를 훈련·배포·추론할 수 있는 서비스를 선보였고, 텐센트클라우드·바이두클라우드 역시 같은 지원을 선언했다.
앞서 프랑스 스타트업인 미스트랄도 sLLM을 공개한 바 있다. 한국 스타트업들도 잇달아 sLLM을 출시하고 있다. 솔트룩스는 ‘루시아(LUXIA)’로 허깅페이스 오픈 LLM 리더보드에서 35B 이하 모델 기준 세계 1위 성능을 기록해 주목받았다.
sLLM이 각광을 받는 이유는 추론 비용이 매우 낮아서다. 라마3(파라미터 80억개)의 경우 출력 토큰 100만개당 7.5달러 정도다.
소형대규모언어모델(sLLM)
두뇌 시냅스에 해당하는 파라미터가 수십억 개에 불과한 AI 모델. 범용성은 낮지만 추론 학습 비용이 적게 든다.
[ 一日30分 인생승리의 학습법] VBA Web Scraping: How Can VBA Be Used To Scrape Website Data?
According to research by Zipdo, more than 1.2 billion people worldwide use Microsoft Office. If you’re part of this group, you can also use the VBA programming language and do VBA web scraping.
Never heard of VBA or web scraping? Not sure how they could benefit you and your organization? You’re in the right place.
This in-depth guide explains all that you need to know about VBA programming, VBA web scraping, and everything in between.
What Is VBA Programming?
VBA stands for Visual Basic for Applications. It is a programming language developed by Microsoft that is primarily used for automating tasks within Microsoft Office applications such as Excel, Word, Access, and Outlook.
VBA is an object-oriented programming language. It involves working with objects, properties, methods, and events. In the context of Office applications, objects might include worksheets, cells, ranges, and charts.
What Is VBA Programming Used For?
VBA allows users to write code to automate repetitive and time-consuming tasks, create custom forms and user interfaces, interact with other Office applications, and manipulate data.
VBA also includes a feature called macro recording, which allows users to record a series of actions in an Office application and automatically generate VBA code that reproduces those actions.
This programming language allows users to create custom forms and user interfaces within Office applications, providing a way to interact with users in a more controlled and specific manner. It supports event-driven programming, where specific actions or events trigger the execution of code, as well. For example, a button click or a cell value change can trigger a specific subroutine.
What Is a VBA Module?
Another important part of understanding VBA is understanding VBA modules.
In VBA, a module is a container meant for storing and organizing code. It is a space where you can write and store VBA procedures, functions, and other types of code. Modules allow you to organize your code logically and make it more manageable.
There are two main types of modules in VBA:
Standard Modules: These are general-purpose modules where you can write standalone procedures and functions. Standard modules are not associated with any particular object or form. You can create multiple standard modules in a VBA project, and they typically contain reusable code that can be called from various parts of your application.
Class Modules: What is class module in VBA? Class modules are used in object-oriented programming in VBA. They allow you to define custom objects with properties, methods, and events. Each instance of a class module represents a specific object with its own set of characteristics and behaviors.
VBA Programming and Web Scraping
You can utilize VBA for several purposes, including web scraping.
Web scraping is a technique used to extract data from websites. It involves fetching the HTML content of a web page and then parsing and extracting specific information from that content. Web scraping is commonly used for various purposes, such as data extraction, content aggregation, price monitoring, and more.
Many organizations use a web scraping API (Application Programming Interface) to make the scraping process easier. A web scraping API is a service or tool that provides a structured way for developers to extract data from websites without directly accessing the HTML source code.
Unlike traditional web scraping, where developers write custom scripts to fetch and parse HTML content, a web scraping API simplifies the process by offering a set of endpoints that allow users to request specific data from the target website.
How does VBA programming fit into the equation?
The VBA programming language can be used for web scraping by leveraging its ability to make HTTP requests and parse HTML content. VBA can interact with websites, retrieve HTML data, and extract information programmatically.
Why would you want to use VBA for web scraping and scrape data from websites into Excel (or other Microsoft tools)?
First of all, web scraping saves you a lot of time and allows you to be more productive. Instead of copying and pasting data manually, you can relax and let an automated tool do the work for you. Using CBA for web scraping can also help you reduce the number of errors you make when transferring data from one place to another.
Benefits of Using VBA Code for Web Scraping
People use VBA web scraping for many reasons. Here are some of the top advantages that come with utilizing this programming language:
Ready to use: VBA is bundled with Microsoft Office. If you already have Microsoft Office installed, you don’t have to worry about any additional installations. You can use VBA right away in any Microsoft Office tool.
Reliability: Both Microsoft Excel and VBA are developed and maintained by Microsoft. That means you can upgrade these tools together to ensure you’re always working with the latest version.
Out-of-the-box support: When you use VBA web scraping, you can take advantage of Microsoft’s browser, Microsoft Edge, which makes it easier to scrape dynamic websites.
Complete automation: When you run the VBA script, you don’t have to carry out any additional tasks or interact with the browser at all. The VBA script takes care of everything, even logins, scrolling, and button clicking.
Of course, there are a few downsides to using VBA to scrape website data. For example, because it’s so tightly connected to Microsoft Office tools, it can be difficult to use it with other platforms. It also works best in a Windows environment, making it less accessible to Mac users, and is harder to learn than other programming languages like Python and JavaScript.
How to Do Excel VBA Web Scraping in Chrome
Excel VBA web scraping can be done in Chrome (one of the world’s most popular browsers with 2.65 million users) using a few different methods, including using the Selenium library for VBA (this is one of the most popular options).
If you’ve never done this before, don’t worry. Here’s a step-by-step guide on how to perform web scraping using Excel VBA in Chrome:
Step 1: Download the Selenium library
First, you should make sure you have the Selenium library installed since you’ll reference it in your VBA project. You can download the Selenium-type library (WebDriver) from the SeleniumHQ website: https://www.selenium.dev/.
Step 2: Set up your Excel workbook
Next, Open Excel and create a new workbook. Then, Press Alt + F11 to open the Visual Basic for Applications (VBA) editor.
Step 3: Set references
In the VBA editor, go to Tools > References.
Look for “Selenium Type Library” or “WebDriver” and check the box to enable it. Click “OK” to close the references window.
Step 4: Insert a module
Right-click on the project explorer in the VBA editor. Then, choose Insert > Module to add a new module to your project.
Step 5: Write the VBA code
In the module, you can write VBA code to control Chrome using Selenium. Here’s a basic example:
vba
Copy code
‘ Declare variables
Dim driver As New Selenium.ChromeDriver
Dim elem As Selenium.WebElement
‘ Open Chrome browser
driver.Start “chrome”, “https://example.com”
‘ Find and interact with elements
Set elem = driver.FindElementByXPath(“//input[@id=’search’]”)
elem.SendKeys “web scraping”
‘ Perform other actions as needed
‘ …
‘ Close the browser
driver.Quit
Step 6: Run the code
Press F5 or click the “Run” button to execute the code.
From here, you’ll see Chrome opening and navigating to the specified URL, performing actions, and then closing.
Step 7: Adjust code for your specific web scraping scenario
You can always Modify the code to suit your specific web scraping needs. Identify the HTML elements you want to interact with and adjust the code accordingly.
Can You Do VBA Web Scraping in Chrome without Selenium?
It’s not easy to do VBA web scraping in Chrome without Selenium. However, if you have a reliable web scraping API, you don’t have to worry about keeping track of all the code required.
Scraping Robot is a system made to assist developers and help users like you work more efficiently. It’s easy to use and is up and running within minutes, allowing you to scrape websites on Chrome, Microsoft Edge, and other browsers quickly and accurately.
Final Thoughts
VBA programming is an excellent option for scraping website data, especially if you’re a Windows user who already relies heavily on Microsoft Office tools like Excel.
One of the primary downsides to using VBA web scraping, though, is that VBA comes with a steeper learning curve than some other programming languages. Luckily, there are tools that can help you overcome that learning curve.
With the right tools, such as the Scraping Robot API, you can overcome these hurdles and enhance your web scraping process.
인공지능(AI)이 전 세계 컴퓨터 시장을 달구고 있지만, 이는 갑작스러운 전개가 아닌 필연적인 흐름이다. 현대 컴퓨터의 아버지 ‘앨런 튜링’은 AI라는 단어가 등장하기도 전인 1950년, ‘계산 기계와 지능(Computing machinery and intelligence)’이라는 논문을 통해 컴퓨터로 동작하는 가상의 지능이 등장할 것을 시사했고, 1956년 다트머스 회의에서 AI라는 용어와 개념이 자리 잡았다.
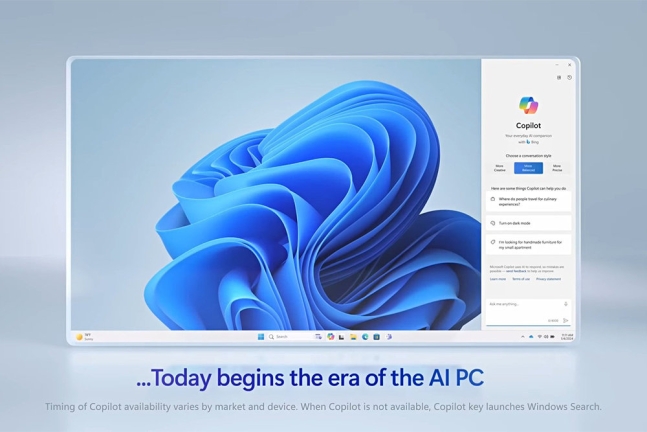
2024년, 거의 모든 PC 관련 기업들이 AI PC를 슬로건으로 밀고 있다 / 출처=마이크로소프트
물론 반도체가 눈부시게 발전하며 2000년대까지는 슈퍼컴퓨터와 시뮬레이션에 컴퓨터 공학적 역량이 집중되었으나, 90년대 중반부터는 리처드 벨먼 교수의 기계 제어를 위한 강화학습, 제프리 힌튼 교수의 심층신경망 기술 제안 등이 잇따르며 가능성이 커져왔다. 이어서 2016년, 구글 딥마인드와 이세돌의 바둑 대결로 전 세계인이 AI의 가능성을 목격했고, 22년 11월 오픈 AI가 GPT-3를 내놓으며 비로소 AI가 IT 시장의 핵심으로 등장했다. 그 직후 시장에서 제시한 방향성이 바로 온디바이스 AI, AI PC다.
가장 진보한 AI의 발전상, AI PC의 현재 상황은?
2023년 AI 시장의 핵심은 AI 그 자체였다. 엔비디아를 비롯한 AI 하드웨어 기업들은 새로운 기술과 고성능을 갖춘 제품을 내놓기 바빴고, 개발자들은 빅데이터를 수집해 AI 모델을 구축하고, 이를 활용해 추론하고 후처리에 이르는 모든 과정에 투입됐다. 일반인들을 위한 AI 시장이 대중화하진 않았으나, GPT를 비롯한 다양한 생성형 AI들이 모든 산업을 관통했다.
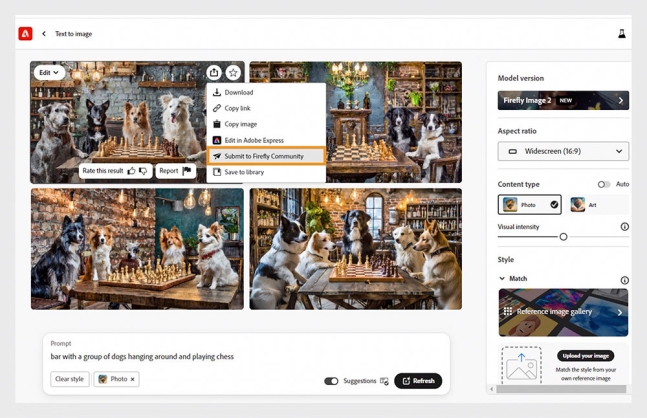
어도비의 생성형 AI 파이어플라이 생성 화면, 온디바이스 AI가 아닌 어도비 클라우드 서비스로 연결해 처리한다 / 출처=어도비
문제는 이 모든 과정이 클라우드 및 데이터 서버를 거쳐야 한다. AI 모델은 데이터를 매개변수 형태로 가공해서 저장하고, 필요할 때 내놓는 형태다. 이를 위해 막대한 양의 저장공간과 실시간 하드웨어 자원, 즉 데이터 서버가 필요하다. 지금도 대다수 AI 기능은 데이터 서버와 클라우드로 연결돼 동작하며, 네트워크가 없으면 AI 기능을 쓰기 어렵다.
하지만 데이터 서버 구축은 대규모 자본은 물론 구동과 냉각을 위한 전력도 계속 필요하다. 장기적으로 AI 제공 기업의 부담은 커지고, 과부하도 생긴다. 그래서 업계에서는 말단 장치가 AI를 자체 구동하는 온디바이스 AI로 데이터 서버의 부하를 분산하고 있으며, AI PC 역시 이를 위해 등장한 제품군이다. 즉 AI PC는 AI 연산 집중에 따른 서버 부하를 줄이고, 사용자가 통신없이도 간단한 AI 소프트웨어나 애플리케이션, 개발 작업에 쓰기 위한 제품이다.
가트너, 2024년 말까지 전체 PC 중 22%가 AI PC로 예상
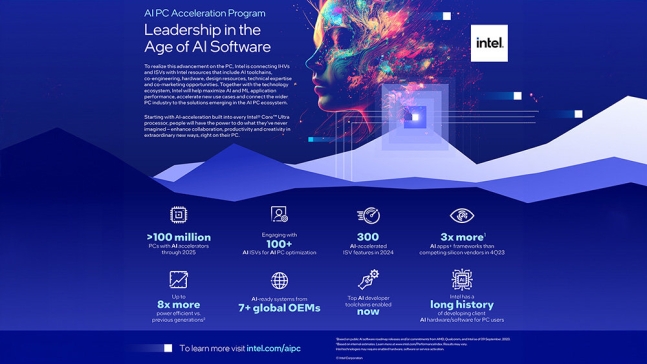
주요 프로세서 제조사들이 AI PC의 가능성에 눈을 뜨면서 시장 점유율은 빠르게 늘고 있다. 글로벌 연구 조사 기업 IDC는 AI PC가 올해 전체 PC 출하량의 약 20%인 5000만 대가 출하될 것으로 예측하며, 2027년에는 전체의 60%인 1억 6700만 대가 출하될 것으로 본다. 이미 지난해 12월 인텔 코어 울트라가 출시되며 신제품 노트북이 AI PC로 판매되기 시작했고, 인텔은 2025년까지 약 1억 대의 AI PC를 출하하겠다고 발표했다.
인텔 AI PC의 핵심은 신경망 처리 장치(NPU)다. 오늘날 많은 AI는 GPU의 부동소수점 연산 처리로 구동된다. 하지만 GPU는 AI 용도가 아닌 그래픽 처리용 반도체여서 전력 효율이 크게 떨어진다. NPU는 AI 처리를 위한 반도체로 전력 및 작업 효율이 훨씬 좋다. 현재 인텔 코어 울트라 등의 AI PC는 기존처럼 CPU와 GPU는 물론 NPU까지 탑재한다.
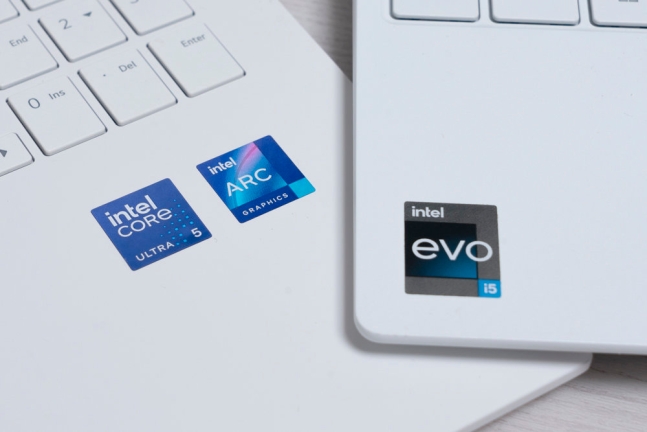
인텔 코어 울트라 5가 탑재된 PC와 13세대 인텔 코어 i5가 탑재된 PC / 출처=IT동아
인텔 코어 울트라 라인업은 13세대 인텔 코어 제품군과 비교해 UL 프로키온 AI 추론 기능과 어도비 라이트룸을 활용한 AI 사진 편집은 약 1.5배, 어도비 프리미어 프로 AI 비디오 편집 기능은 약 2.2배, 스펙 뷰포트 2020 SNX 등의 엔지니어링 기능에서는 최대 12.1배까지 성능이 차이 난다. 그러면서도 전력 효율은 에너지스타 8.0 요구사항보다 최대 64% 낮고, 마이크로소프트 팀즈 미팅 시 11% 전력을 덜 쓰는 등의 이점이 있다. GPU 성능이 좋아지면서 실사용 성능이 향상되는 부분도 있지만, AI 처리에 최적화된 NPU의 영향도 상당하다.
점차 늘고 있는 AI PC 활용, 현시점 활용도는?
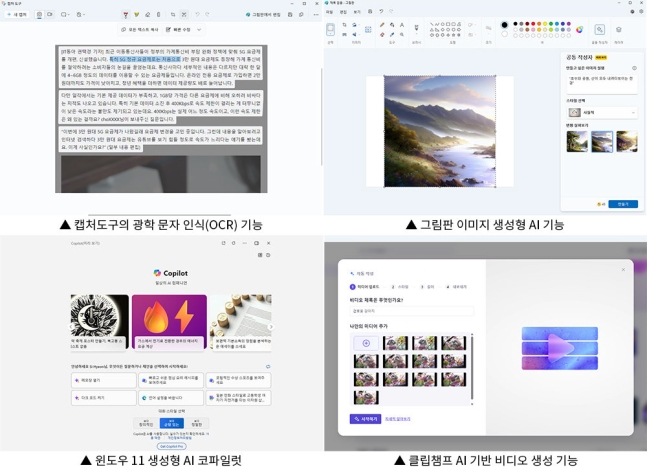
현재 윈도우 11에서 쓸 수 있는 AI 기능, 클라우드에서 연산을 처리하므로 AI PC가 아니더라도 쓸 수 있다. 물론 AI PC 최적화가 적용되면 오프라인에서도 효율적으로 이런 기능들을 쓸 수 있게 된다 / 출처=IT동아
사용자들 사이에서는 여전히 AI 기능이 시기상조라는 시각도 있지만, 윈도우 11처럼 발빠르게 AI PC 시대를 준비하는 플랫폼도 있다. 예를 들어 윈도우 11에는 코파일럿을 비롯한 다양한 AI 기능이 내장되고 있으며, 누구나 쓸 수 있다. 코파일럿은 GPT 기반의 생성형 AI로 대화를 통한 질문, 검색이나 글 작성, 이미지 콘텐츠 제작, 윈도우 기능 실행 등을 수행한다. 또 캡처 도구에는 AI 기반의 광학 문자 인식이 탑재돼 이미지 내 글씨를 복사할 수 있고, 그림판에도 AI 배경 제거나 명령어 기반의 이미지 생성형 AI 기능이 추가됐다. 이외에도 많은 AI 기능들이 단계적으로 추가될 예정이다. 현재 시점에서는 네트워크가 필수지만, 추후 NPU에 최적화되면 장치 자체에서 수행한다.
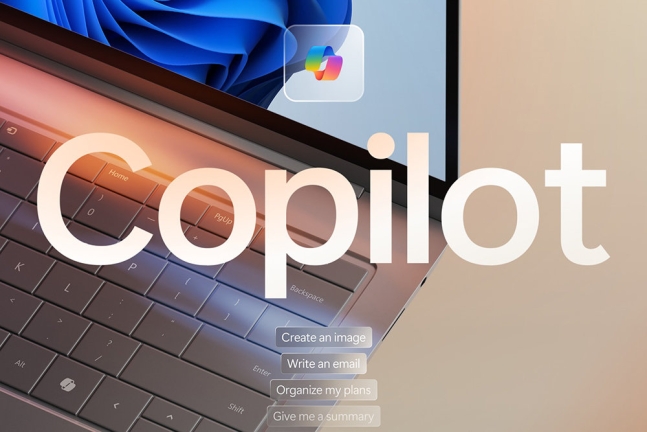
올해 말이면 오프라인 AI PC에서 쓸 수 있는 AI 기능들이 많아질 전망이다 / 출처=마이크로소프트
아울러 챗GPT나 클로드AI, 라마(Llama), 구글 재미나이 같은 언어 모델을 개발하는 조건에도 앞으로는 AI PC가 더 유리해질 것이다. AI 개발 자체는 이전 세대 고성능 PC로도 할 수 있지만 전력 효율이 떨어진다. 가벼운 작업이고, 전력 효율까지 고려한다면 NPU를 내장한 AI PC에서의 작업이 더 유리하다. AI 기업 업스테이지는 지난 2월, LG전자와 손을 잡고 자체 언어모델 ‘솔라’를 LG 그램에서 온디바이스 AI로 적용하겠다는 발표도 했다. 올해 혹은 내년에는 챗 GPT같은 언어모델을 오프라인 AI PC에서도 쓰게 될 전망이다.
추후 PC 생태계는 AI인가, AI가 아닌가로 나뉠 것
지금까지 PC 성능을 결정짓는 요소는 컴퓨터의 처리 성능이었다. 하지만 AI PC 시대가 도래한 시점부터는 PC 성능은 물론 얼마나 많은 AI 기능과 소프트웨어를 지원하는지도 중요해질 것이다. AI PC 생태계가 올해 막 시작된 만큼 여전히 보여줄 게 많진 않으나, 챗GPT가 보여준 것처럼 PC 기반 작업에서 기대 이상의 결과와 혜택을 제공할 것이다. 이를 누리려면 새 PC를 살 때 NPU를 탑재한 AI PC를 선택하는 게 합당하다.
인텔은 오는 2025년까지 1억 대 이상의 PC에 AI 기능을 제공하겠다는 목표를 세웠다 / 출처=인텔
이미 인텔은 물론 AMD에서도 라이젠 AI 엔진을 탑재한 노트북을 출시했고, 퀄컴 역시 올해 중 스냅드래곤 X 엘리트 기반의 AI PC를 출시한다. 애플 역시 하반기 중 AI 기능을 내재한 차세대 애플 실리콘으로 매킨토시 라인업을 재단장할 예정이다. 과거 어도비가 크리에이티브 클라우드를 도입하면서 소프트웨어 생태계가 SaaS 중심으로 재편된 것처럼, PC 업계 역시 AI PC로 나아가는 것이다.
단순히 마케팅 용어라며 경계하는 시각은 있다. 그럼에도 불구하고 AI는 여러 분야에서 제 기능을 증명했고, 발 빠른 이들은 이미 챗GPT를 비롯한 생성형 AI의 활용법과 시각을 공유하며 우위에 서고 있다. 여전히 많은 기능이 AI PC가 아닌 일반 PC로도 구현이 되지만, 변곡점을 지나면 AI PC의 활용도가 우세해질 것이다. AI PC의 세계는 누구에게나 열려있고, AI PC를 통해 더 많은 일들을 할 수 있다. 올해가 지나면, 더 이상 AI PC는 선택이 아닌 필수가 될 것이다.
“웹은 사회적인 창조물에 가깝다. 웹의 힘은 모든 사람이 접근할 수 있는 그 보편성에 있다.”
월드와이드웹(WWW, World Wide Web, 인터넷을 통해 접근 가능한 공용 웹 페이지의 상호연결 시스템)을 창시한 ‘웹의 아버지’ 팀 버너스리(Sir Timothy John Berners-Lee)는 웹 3.0을 플랫폼이 아닌 ‘개인이 소유한 인터넷’으로 규정한 바 있습니다. 웹3 시대에는 피트니스 정보에서 쇼핑 패턴까지 모든 데이터를 ‘나만의 스토리지’에 저장하고, ‘나만의 인공지능(AI)’을 활용해 ‘나만의 삶’을 누릴 수 있을 것이라 본 것인데요. AI와 함께 대규모 언어 모델(LLM, Large Language Model)이 등장하면서 우리는 이러한 미래 인터넷의 가능성을 미리 엿볼 수 있었습니다. 인터넷 포털 검색이 아닌, 챗봇을 통해 문답을 주고받고, 자신만의 데이터를 활용해 나만을 위한 업무를 할 수 있게 된 것입니다.
온디바이스 AI가 주목받는 이유
AI 시대가 본격화되며 ‘온디바이스 AI’가 주목받고 있습니다. 간단한 AI는 디바이스와 에지 컴퓨팅에서 구동 시키려는 움직임이 나타나고 있는 건데요. 서버 기반의 AI는 막대한 전력을 소모하기 때문입니다. 오늘날 데이터센터는 전 세계 전력 사용량의 1~1.5%를 차지고 있는데요. 이에 전문가들은 향후 AI가 클라우드 / 에지 컴퓨팅 / 디바이스 3개 축으로 분화될 것으로 내다보고 있습니다. 그동안 AI가 클라우드 중심이었다면 이제는 하이브리드 AI로의 전환점을 맞이하고 있는 것이지요.
생태계를 확산시켜라! 빅테크 기업의 온디바이스 AI 전략
온디바이스 AI는 디바이스 자체 하드웨어를 활용해 AI 작업을 처리합니다. 이는 개별 디바이스에 가속기를 장착해 AI 모델을 더욱 효율적으로 구동시킬 수 있습니다. 또, 기존에는 클라우드 기반 AI에서 그래픽 처리 장치인 GPU(Graphics Processing Unit)가 중요했다면, 온디바이스 AI에서는 인공신경망인 NPU(Neural network Processing Unit) 칩이 중요합니다. NPU 칩을 활용하면 서버와 통신 없이 소모 전력을 적게 들이며 AI를 이용할 수 있기 때문입니다. 온디바이스 AI 생태계 확산을 위해 빅테크 기업들은 어떤 전략을 구사하고 있을까요?
• 구글
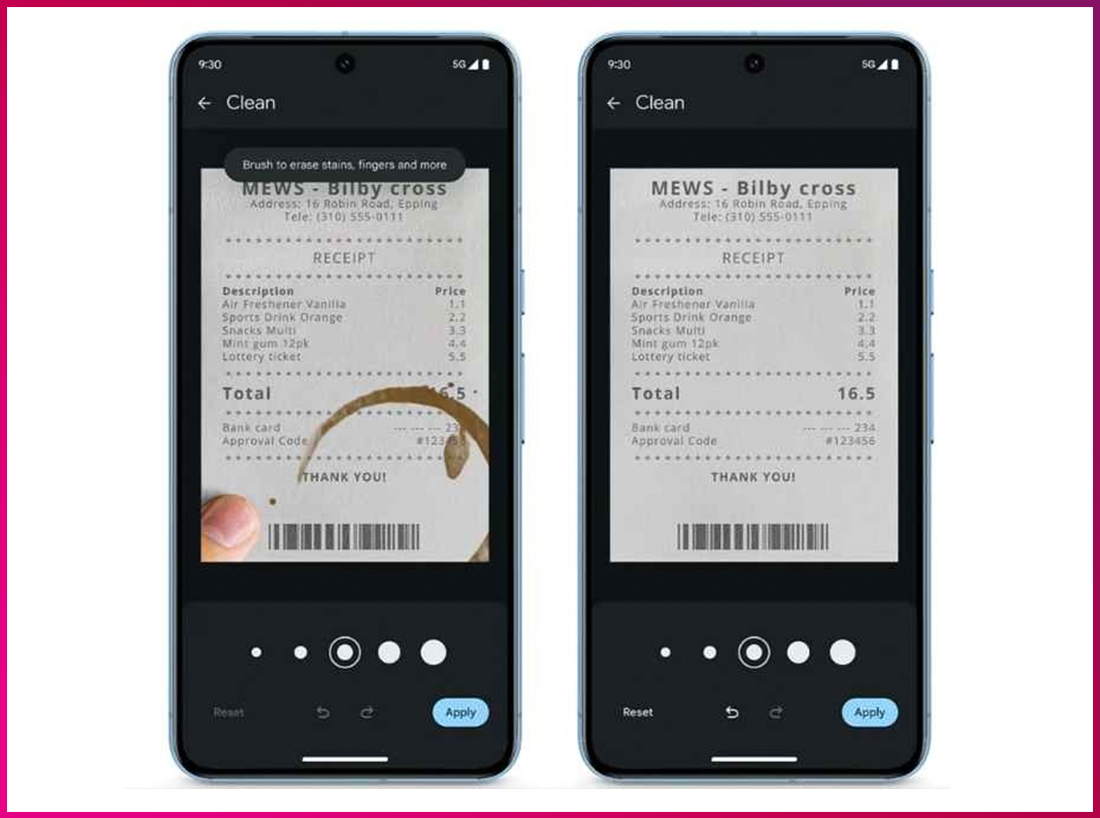
[그림 1] 구글 픽셀8 프로에 탑재된 AI ‘제미나이’ 나노를 활용해 영수증에 묻은 커피 얼룩을 삭제하는 모습
구글은 차세대 생성형 AI인 ‘제미나이(Gemini)’ 나노 모델을 스마트폰 픽셀8 프로에 탑재했습니다. 사용자의 민감한 데이터가 휴대폰을 벗어나지 않게 보호하고, 네트워크 연결 없이도 AI 기능을 사용할 수 있는데요. 특히 픽셀8 프로에는 ‘녹음 요약’과 ‘지보드(Gboard) 스마트 답장’ 기능이 강화됐습니다. ‘녹음 요약’ 기능은 녹음된 대화나 인터뷰, 발표 등을 요약하고, ‘스마트 답장’은 왓츠 앱 등에서 대화 내용을 자동 인식해 고품질의 응답을 제안합니다. 또한 새로운 AI 기반 도구들을 활용해 사용자에게 보다 더 많은 도움을 제공합니다. 예를 들면, 구글 텐서 G3를 이용해 비디오 색상, 조명 등을 조정하는 ‘비디오 부스트’, AI를 사용해 저조도나 야간에 촬영된 비디오의 선명한 디테일과 색상 제공하는 ‘야간 시야 비디오’와 같은 기능인데요. 구글은 애플의 iOS 생태계 확장에 제동을 걸기 위해 픽셀 스마트폰을 넘어 향후 태블릿, 스마트워치로 대상을 넓힐 예정입니다.
• 마이크로소프트(MS)
마이크로소프트(MS) 역시 AI를 활용해 윈도우 서비스와 검색 엔진 ‘빙(Bing)’ 강화에 나섰습니다. 특히 MS는 2024년 6월 차세대 AI PC ‘서피스 프로(Surface Pro)’ 태블릿과 ‘서피스 랩톱(Surface Laptop)’ 노트북을 출시할 예정입니다. 해당 제품 군은 생성형 AI ‘코파일럿’과 온디바이스 AI를 지원하는 것이 가장 큰 특징인데요. 윈도우 센트럴(Windows Central)에 따르면 서피스 프로 10과 서피스 랩톱 6에는 NPU가 장착됩니다. 윈도우 센트럴은 “130억 개 파라미터 AI 모델을 노트북에서 네트워크 없이 구동할 수 있다”고 설명했습니다. MS가 지난해는 ‘코파일럿’을 중심으로 한 AI 구축에 전력을 다했다면, 2024년에는 하드웨어 영역으로 확장할 것으로 보입니다.
• 애플
애플은 AI 영역에서 오픈소스 개방형 전략을 취하고 있습니다. 2023년 10월 차세대 AI 칩 ’M3’를 공개하며 온디바이스 AI 시대를 예고했는데요. 애플은 “M3 칩에 있는 뉴럴 엔진은 M1 칩보다 최대 60% 더 빠르다”며 “개인정보 보호를 위해 데이터를 개별 장치에 머무르게 하면서 AI와 머신 러닝 작동 흐름을 더욱 빠르게 만든다”고 강조했습니다. 특히 M3는 인간 두뇌에 해당하는 파라미터 수를 최대 수십억 개 지원합니다. IT 업계는 애플이 이를 기반으로 각종 AI 서비스를 구현할 것으로 전망하고 있습니다
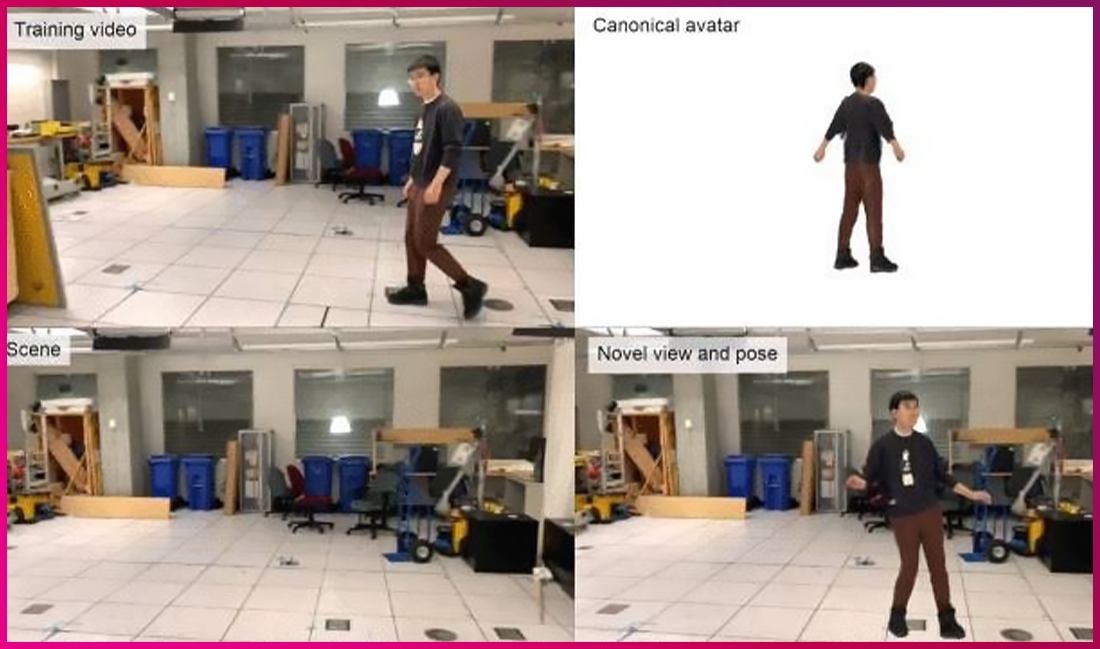
애플은 두 편의 논문을 아카이브에 공개하기도 했습니다. 첫 번째 논문은 휴먼 ‘가우시안 스플랫(HUGS, Human Gaussian Splats)’ 기술 사례가 대표적입니다. 동영상에서 배경과 인물을 분리하고 이를 다시 재활용하는 기술인데요. 예를 들어 눈밭을 걸어가는 사람 영상을 학습한 AI가 인물과 배경을 마음대로 조합할 수 있는 것입니다. 두 번째 논문은 ‘제한된 메모리로 효율적인 대규모 언어 모델을 추론하는 법(Efficient Large Language Model Inference with Limited Memory)’입니다. 이는 메모리가 제한된 기기에 LLM을 구축하는 기술입니다. 연구진은 이 방법을 활용해 애플 M1 맥스 CPU(Central Processing Unit, 컴퓨터 시스템을 통제하고 프로그램의 연산을 실행, 처리하는 가장 핵심적인 컴퓨터 제어 장치 혹은 그 기능을 내장한 칩)에서 추론 시간을 4~5배 앞당기고, 속도는 20~25배까지 향상할 수 있다고 설명했습니다.
[그림 2] 휴먼 가우시안 스플랫(HUGS, Human Gaussian Splats)을 활용해 동영상에서 인물과 배경을 분리하고 AI를 통해 인물을 조정하는 모습
또한, 깃허브를 통해 M3 칩에서 실행할 수 있는 프레임워크와 모델 라이브러리를 공개했습니다. 바로 MLX라 불리는 AI 개발 툴킷인데요. 애플의 머신 러닝 연구자인 아우니 한눈은 X(구 트위터)를 통해 MLX 데이터를 “데이터 로딩을 위한 프레임워크에 구애 받지 않는 효율적이고 유연한 패키지”라며 “MLX, 파이토치, JAX 프레임워크에서 함께 작동한다”고 설명했습니다. MLX는 파이토치, JAX와 같은 AI 프레임워크에서 영감을 얻은 것으로 보여집니다. 다만 공유 메모리에 대한 내용이 없다는 점에서 애플 반도체를 사용하는 맥북에 적합할 것이라는 평가도 있습니다.
온디바이스 AI 흐름에 응하는 LG
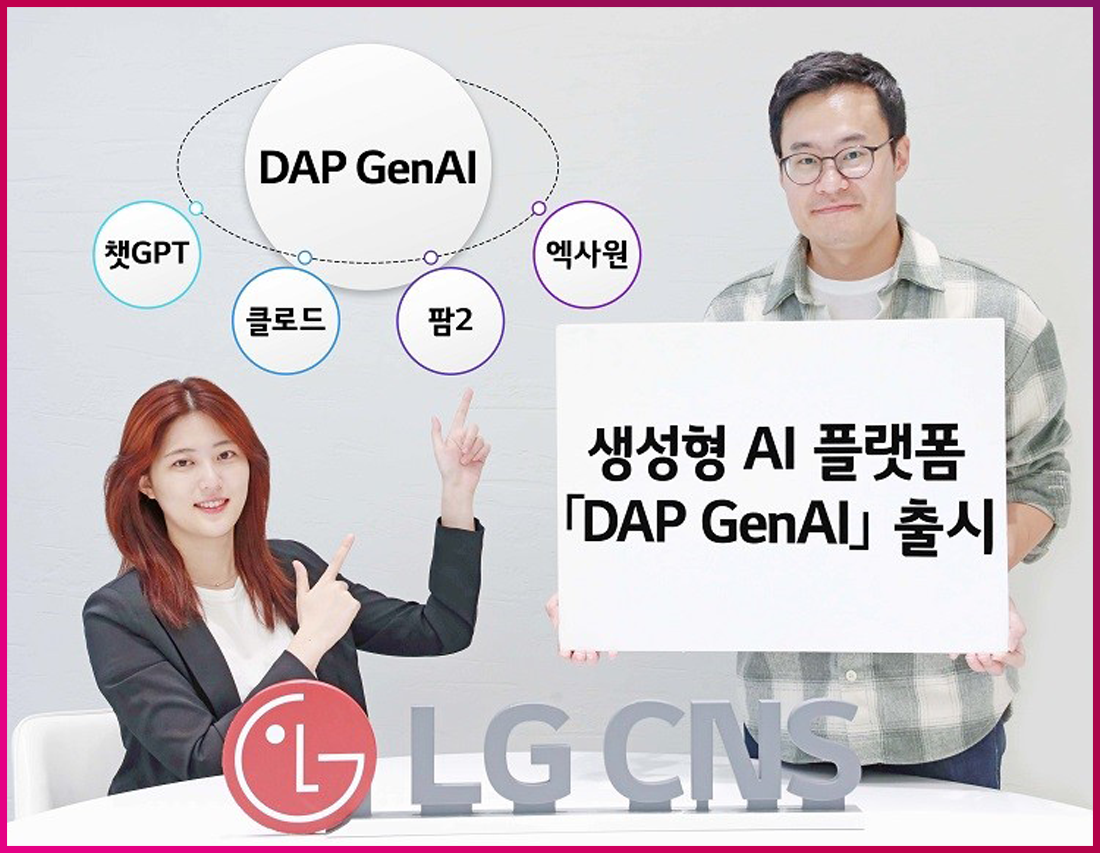
2020년 8월, LG CNS는 온디바이스 AI 솔루션 업체 ‘노타’에 일찌감치 투자했습니다. 노타는 딥 러닝 모델 경량화ᆞ자동화 솔루션인 넷츠프레소(NetsPresso)를 공개한 스타트 업인데요. 넷츠프레소는 성능 저하를 최소화해 스마트폰과 소형 IoT 기기에서 독립적으로 AI를 구동시킬 수 있다는 평가를 받고 있습니다. 최근에는 기업용 AI 서비스를 잇따라 선보이고 있는데요. 대표적으로 기업용 생성형 AI 플랫폼인 ‘DAP GenAI’가 있습니다. DAP GenAI는 기업이 가진 내부 정보만을 활용하고, 다양한 보안 필터 등을 적용해 거짓이나 왜곡된 내용을 생성하는 정보 왜곡현상(Hallucination)을 줄여 업무 효율을 높인 AI입니다. 이를 통해 오픈AI ‘챗GPT’, 엔스로픽의 ‘클로드(Claude), 구글의 ‘팜2(PaLM2), LG AI연구원의 ‘엑사원(EXAONE)’ 등 다양한 LLM을 활용해 서비스를 구축할 수 있습니다. 예를 들어 금융사가 보험상품 추천 AI 서비스를 개발하고 싶다면 고객 정보 데이터베이스를 연동해 알맞은 프롬프트를 구성하며 추천과 답변에 적합한 LLM을 각각 선택해 설정합니다.
[그림 3] LG CNS 직원들이 생성형 AI 플랫폼 DAP GenAI 출시를 소개하는 모습
2022년 LG전자는 스마트 온디바이스 AI칩인 ‘LG8111’을 개발해 공개했습니다. LG8111은 다양한 AI 가속 하드웨어 내장은 물론 2.4GHz와 5GHz 듀얼 밴드 와이파이를 지원해 인터넷에도 연결할 수 있습니다. 예를 들어 LG8111을 장착한 냉장고는 사용자 음성을 인식해 동작합니다. LG8111은 가전제품뿐만 아니라 스마트카, 스마트팩토리 등 다양한 영역에서 사용 가능합니다.
또한 LG전자는 AI 프로세서를 탑재한 2024년형 LG 그램 신제품 ‘LG 그램 프로’를 런칭할 예정입니다. LG 그램 프로(모델명: 17Z90SP/16Z90SP)에는 차세대 프로세서인 인텔 코어 울트라 CPU가 탑재됐습니다. 인공지능 연산에 특화된 NPU인 AI 부스트가 내장된 CPU인데, 네트워크 연결 없이도 AI를 구동할 수 있다는 장점이 있습니다. 예를 들어 사진을 분석해 인물 장소, 날짜 등 38개 카테고리에 따라 자동으로 분류해 낼 수 있습니다. 또한 제품에 탑재된 ‘AI 그램 링크’ 기능은 최대 10대까지 안드로이드 및 iOS 기기와 파일, 사진 등 파일을 편리하게 주고받거나 화면을 공유할 수 있도록 지원합니다. 여기에 더해 엔비디아의 지포스 RTX™ 3050 랩톱 GPU 외장 그래픽 카드를 탑재한 모델은 1초에 5장에 달하는 AI 이미지를 생성할 수 있는데요. 이는 내장 그래픽 모델에 비해 약 3배 빠른 속도입니다. LG전자 이윤석 IT 사업부장은 “AI 성능을 강화한 그램 최상위 라인업 LG 그램 프로를 앞세워 휴대성과 타협하지 않는 고성능을 원하는 고객에게 최적의 사용 경험을 제공하겠다”고 말했습니다.
[그림 4] AI 프로세서를 탑재한 2024년형 LG 그램 신제품 ‘LG 그램 프로’
하이브리드 AI, 새로운 AI시대 열까
이제 AI가 클라우드, 에지 컴퓨팅, 디바이스 영역에 걸쳐 뿌리내릴 것으로 보입니다. 이른바 ‘하이브리드 AI시대’가 도래하려는 모습인데요. 특히 하드웨어를 보유한 빅테크 기업은 온디바이스 AI에 힘을 싣는 분위기입니다. 인터넷 연결 없이도 가전제품이 AI를 활용해 각종 서비스를 제공할 수 있기 때문입니다. 클라우드 AI 시대의 절대 강자가 엔비디아였다면, 온디바이스 AI 시대에는 새로운 칩의 강자가 나타날 수 있을 조짐입니다. 특히 퀄컴과 같은 반도체 기업이 이 틈을 파고들고 있습니다. 퀄컴은 2023년 10월에 열린 스냅드래곤 서밋 2023에서 메타의 라마2를 압축한 모델을 퀄컴 칩이 장착된 디바이스에서 구동하는 기술을 시연했습니다. 인터넷이나 와이파이 연결 없이 맛집 등의 정보를 확인할 수 있는 기술이었습니다. 퀄컴은 앞서 ‘AI의 미래 하이브리드(The future of AI is hybrid)’라는 보고서에서 가까운 미래에 AI가 온디바이스와 클라우드에서 병렬적으로 작동할 것으로 내다봤는데요. 향후 AI는 클라우드와 디바이스를 오가며 고객이 원하는 데이터를 적재적소에 처리하는 하이브리드 AI로 거듭날 것이라는 관측입니다.
이러한 하이브리드 AI는 팬데믹을 정점으로 위축되었던 IT 가전 산업을 다시 부활시킬 것으로 보입니다. 모건스탠리에 따르면 스마트폰 출하량은 온디바이스 AI에 힘입어 지속적으로 성장할 전망입니다. 또한, PC 산업 역시 큰 폭으로 성장할 전망인데요. 캐널리스에 따르면 “2024년 PC 산업은 8% 성장할 전망이며 새로운 AI 기능 장치가 등장하면서, 고객들이 팬데믹 시대에 사들인 PC를 새롭게 교체할 것”이라고 설명했습니다. HP의 최고 경영 책임자(CEO)인 엔리케 로레스(Enrique Lores)는 CNBC를 통해 “AI PC가 PC 시장의 성장을 가속할 것”이라며 “AI PC를 처음에는 특정 기업만 구입하겠지만, 향후에는 더 많은 고객이 구입할 수밖에 없을 것”이라고 말했습니다.
국내 연구진이 인공지능(AI)으로 인간의 추론 능력을 극대화하는 기술을 개발했다. 단번에 추론을 하도록 유도해 학습 효율을 향상하는 방식이다. 스마트 교육, 게임 콘텐츠 개발, 추론 능력 측정, 인지훈련 등 인간의 추론 학습과 관련된 모든 분야에 적용이 가능할 것으로 기대된다.
KAIST는 이상완 뇌인지과학과 교수 연구팀이 인간의 빠른 추론 능력을 유도해 인과관계의 학습 효율을 향상할 수 있는 뇌 기반 AI 기술개발에 성공했다고 31일 밝혔다. 연구 결과는 국제학술지 ‘셀 리포트’ 온라인판에 30일 게재됐다.
연구팀은 이전 연구에서 인간의 원샷 추론 과정을 모델링하고 전두엽과 해마가 이러한 과정에 관여하고 있음을 규명한 바 있다. 이번 연구에서는 이 모델에 인간의 원샷 추론 과정을 특정한 상태로 유도하기 위해 알파고에 사용된 바 있는 심층 강화학습 기술을 접목했다. 강화학습 알고리즘이 인간의 원샷 추론 과정을 수없이 시뮬레이션하면서 전두엽과 해마가 가장 효율적으로 학습할 수 있는 최적의 조건을 탐색하는 과정이다.
인공지능(AI)으로 인간의 추론 능력을 극대화하는 기술을 설명한 개념도. KAIST 제공
연구팀은 126명의 인간 피험자를 대상으로 한 인과관계 학습 및 추론 실험에서 제안 기술을 사용해 학습했을 때 단순 반복 학습 대비 최대 약 40%까지 학습 효율이 향상됨을 확인했다. 나아가 오랜 시간에 걸쳐 신중하게 학습하거나 몇 가지 단서만을 조합해 빠르게 결론을 도출하는 것 같은 개인별 학습 성향을 고려한 맞춤형 설계가 가능함을 보였다.
인간의 사고체계에 대한 뇌과학적인 이해를 바탕으로 원샷 추론과 같은 인간의 잠재적 능력을 극대화하는 이 기술은 차세대 인공지능의 중요한 도전과제 중 하나다. 뇌 기반 인공지능 기술은 인간과 유사한 사고체계를 바탕으로 가치판단을 할 수 있으므로 장기적으로 인간과 인공지능이 협업하는 분야에서 인공지능의 신뢰성 및 윤리성을 높이는 데도 기여할 수 있을 것으로 기대된다.
개발 기술은 스마트 교육, 게임 콘텐츠 개발, 추론 능력 측정, 인지훈련 등 인간의 추론 학습과 관련된 모든 분야에 적용될 수 있다. 기존 기술은 단편적인 기억회상, 특정 인지기능, 정답률 증가와 같은 행동적 측면에 집중해 왔다면 이번 기술은 인공지능을 이용해 과거의 경험을 일반화시키는 인간의 사고체계 자체를 높이는 가능성을 확인한 최초의 사례로 평가된다.
논문의 제1 저자 이지항 상명대 교수는 “인간의 인지기능을 인공지능에 이식해 뇌 기반 인공지능을 실현하는 사례를 확인했다”며 “이를 통해 인간의 고위 수준 인지를 적절한 방향으로 유도할 수 있는 새로운 인간-인공지능 상호작용 패러다임을 제시했다ˮ고 말했다. 이어 “인간중심 인공지능 연구개발뿐만 아니라 바이오메디컬 분야, 특히 정신 건강과 관련된 디지털 치료 분야에 적용했을 때 큰 파급력을 보일 것ˮ이라고 기대했다.
연구 책임자인 이상완 교수는 “이번 기술의 잠재력은 인공지능의 방대한 지식을 인간이 빠르게 흡수할 수 있는 형태로 변환할 수 있다는 데 있다ˮ며 “챗GPT, GPT-4와 같은 언어 인공지능에서 추출되는 다양한 정보를 인간이 빠르게 추론 학습할 수 있게 변환하거나 게임이나 가상현실의 콘텐츠를 인간의 추론 과정에 맞게 최적화해 몰입도를 높일 수 있고, 반대로 몰입도를 적절한 수준에서 제어할 경우 중독을 완화하는 효과를 기대할 수 있다ˮ라고 말했다.
관련 기술은 국내 및 해외에 특허 출원된 상태다. 연구팀은 원천기술의 파급력을 높이기 위해 2019년 KAIST 신경과학-인공지능 융합연구센터를 설립하고 구글 딥마인드, 마이크로소프트 연구소, IBM 연구소, 옥스퍼드 대학 등 다양한 해외 연구팀들과 함께 국제공동연구를 수행해 오고 있다.
빠르게 진화하는 인공 지능(AI) 세계에서 LLM(Large Language Models)은 혁신을 주도하고 기술과 상호 작용하는 방식을 재구성하는 초석으로 부상했습니다.
이러한 모델이 점점 더 정교해짐에 따라 이에 대한 액세스를 민주화하는 데 점점 더 중점을 두고 있습니다. 특히 오픈 소스 모델은 이러한 민주화에서 중추적인 역할을 하며 연구원, 개발자 및 애호가 모두에게 복잡성을 깊이 탐구하고 특정 작업에 맞게 미세 조정하거나 기반을 구축할 수 있는 기회를 제공합니다.
이 블로그에서는 AI 커뮤니티에서 파장을 일으키고 있으며 각각 고유한 강점과 기능을 테이블에 제공하는 최고의 오픈 소스 LLM 중 일부를 살펴보겠습니다.
Meta의 Llama 2는 AI 모델 라인업에 획기적인 추가 기능입니다. 이것은 단지 다른 모델이 아닙니다. 다양한 최신 응용 프로그램에 연료를 공급하도록 설계되었습니다. Llama 2의 훈련 데이터는 방대하고 다양하여 이전 모델에 비해 크게 발전했습니다. 이러한 교육의 다양성은 Llama 2가 단순한 점진적인 개선이 아니라 AI 기반 상호 작용의 미래를 향한 기념비적인 단계임을 보장합니다.
Meta와 Microsoft 간의 협업은 Llama 2의 지평을 넓혔습니다. 오픈 소스 모델은 이제 Azure 및 Windows와 같은 플랫폼에서 지원되며, 개발자와 조직에 생성적 AI 기반 경험을 생성할 수 있는 도구를 제공하는 것을 목표로 합니다. 이 파트너십은 모두가 AI에 보다 쉽게 접근하고 개방할 수 있도록 하기 위한 두 회사의 헌신을 강조합니다.
Llama 2는 원래 Llama 모델의 후속 제품이 아닙니다. 이는 챗봇 분야의 패러다임 전환을 나타냅니다. 첫 번째 Llama 모델은 텍스트와 코드를 생성하는 데 있어 혁신적이었지만 오용을 방지하기 위해 가용성이 제한되었습니다. 반면에 Llama 2는 더 많은 청중에게 다가갈 예정입니다. AWS, Azure, Hugging Face의 AI 모델 호스팅 플랫폼과 같은 플랫폼에 최적화되어 있습니다. 또한 Meta와 Microsoft의 협력을 통해 Llama 2는 Windows뿐만 아니라 Qualcomm의 Snapdragon 시스템 온 칩으로 구동되는 장치에서도 명성을 떨칠 준비가 되어 있습니다.
안전은 Llama 2 설계의 핵심입니다. 때때로 오해의 소지가 있거나 유해한 콘텐츠를 생성하는 GPT와 같은 초기 대규모 언어 모델이 직면한 문제를 인식하여 Meta는 Llama 2의 안정성을 보장하기 위해 광범위한 조치를 취했습니다. 이 모델은 ‘환각’, 잘못된 정보 및 편견을 최소화하기 위해 엄격한 훈련을 거쳤습니다.
LLaMa 2의 주요 기능:
다양한 학습 데이터: Llama 2의 교육 데이터는 광범위하고 다양하여 포괄적인 이해와 성능을 보장합니다.
마이크로소프트와의 협업: Llama 2는 Azure 및 Windows와 같은 플랫폼에서 지원되므로 적용 범위가 확장됩니다.
가용성: 이전 버전과 달리 Llama 2는 더 많은 사용자가 사용할 수 있으며 여러 플랫폼에서 미세 조정할 준비가 되어 있습니다.
안전 중심 설계: Meta는 안전을 강조하여 Llama 2가 유해한 출력을 최소화하면서 정확하고 신뢰할 수 있는 결과를 생성하도록 합니다.
최적화된 버전: Llama 2는 Llama 2와 Llama 2-Chat의 두 가지 주요 버전으로 제공되며 후자는 양방향 대화를 위해 특별히 설계되었습니다. 이러한 버전의 복잡성은 7억에서 70억 매개변수에 이릅니다.
향상된 교육: Llama 2는 원래 Llama의 1.4조 XNUMX천억 개 토큰에서 크게 증가한 XNUMX만 토큰으로 훈련되었습니다.
2022년, 70개국 이상 자원봉사자와 Hugging Face 전문가가 참여한 글로벌 협업 끝에 BLOOM 프로젝트가 공개되었습니다. XNUMX년에 걸친 계획을 통해 만들어진 이 LLM(대형 언어 모델)은 자동 회귀 텍스트 생성을 위해 설계되었으며 주어진 텍스트 프롬프트를 확장할 수 있습니다. 상당한 계산 능력을 활용하여 방대한 텍스트 데이터 모음을 학습했습니다.
BLOOM의 데뷔는 생성 AI 기술의 접근성을 높이는 데 있어 중요한 단계였습니다. 오픈 소스 LLM으로서 176억 개의 매개변수를 자랑하며 동급에서 가장 강력한 LLM 중 하나입니다. BLOOM은 46개 언어와 13개 프로그래밍 언어에 걸쳐 일관되고 정확한 텍스트를 생성하는 능력을 갖추고 있습니다.
이 프로젝트는 투명성을 강조하여 소스 코드와 훈련 데이터에 대한 대중의 접근을 허용합니다. 이러한 개방성은 모델의 지속적인 검토, 활용 및 향상을 유도합니다.
Hugging Face 플랫폼을 통해 무료로 액세스할 수 있는 BLOOM은 AI 분야의 협력적 혁신을 보여주는 증거입니다.
Bloom의 주요 기능:
다국어 기능 : BLOOM은 46개 언어와 13개 프로그래밍 언어로 텍스트를 생성하는 데 능숙하여 광범위한 언어 범위를 보여줍니다.
오픈 소스 액세스: 모델의 소스 코드와 교육 데이터는 공개적으로 제공되므로 투명성과 협업 개선이 촉진됩니다.
자동회귀 텍스트 생성: 주어진 프롬프트에서 텍스트를 이어가도록 설계된 BLOOM은 텍스트 시퀀스를 확장하고 완성하는 데 탁월합니다.
대규모 매개변수 개수: 176억 개의 매개변수를 갖춘 BLOOM은 현존하는 가장 강력한 오픈 소스 LLM 중 하나입니다.
글로벌 협업: 70개 이상 국가의 자원봉사자와 Hugging Face 연구자들의 기여로 XNUMX년간의 프로젝트를 통해 개발되었습니다.
무료 접근성: 사용자는 Hugging Face 생태계를 통해 BLOOM에 무료로 액세스하고 활용할 수 있어 AI 분야의 민주화가 강화됩니다.
산업 규모 교육: 이 모델은 상당한 계산 리소스를 사용하여 방대한 양의 텍스트 데이터에 대해 학습되어 강력한 성능을 보장합니다.
MosaicML Foundations는 최신 오픈 소스 LLM인 MPT-7B를 도입하여 이 공간에 크게 기여했습니다. MosaicML Pretrained Transformer의 약어인 MPT-7B는 GPT 스타일의 디코더 전용 변환기 모델입니다. 이 모델은 성능 최적화된 레이어 구현 및 더 큰 교육 안정성을 보장하는 아키텍처 변경을 포함하여 몇 가지 향상된 기능을 자랑합니다.
MPT-7B의 뛰어난 기능은 1조 개의 텍스트 및 코드 토큰으로 구성된 광범위한 데이터 세트에 대한 교육입니다. 이 엄격한 교육은 9.5일 동안 MosaicML 플랫폼에서 실행되었습니다.
MPT-7B의 오픈 소스 특성은 상용 애플리케이션을 위한 귀중한 도구로 자리매김합니다. 비즈니스 및 조직의 예측 분석 및 의사 결정 프로세스에 상당한 영향을 미칠 가능성이 있습니다.
기본 모델 외에도 MosaicML Foundations는 짧은 형식의 지침을 따르는 MPT-7B-Instruct, 대화 생성을 위한 MPT-7B-Chat 및 MPT-7B-StoryWriter-65k+와 같은 특정 작업에 맞춤화된 특수 모델도 출시하고 있습니다. 긴 형식의 스토리 생성을 위해.
MPT-7B의 개발 여정은 MosaicML 팀이 데이터 준비에서 배포까지 모든 단계를 몇 주 내에 관리하는 포괄적인 과정이었습니다. 데이터는 다양한 리포지토리에서 제공되었으며 팀은 EleutherAI의 GPT-NeoX 및 20B 토크나이저와 같은 도구를 활용하여 다양하고 포괄적인 교육 믹스를 보장했습니다.
MPT-7B의 주요 기능 개요:
상업용 라이선스: MPT-7B는 상업적 사용이 허가되어 비즈니스에 귀중한 자산이 됩니다.
광범위한 교육 데이터: 이 모델은 1조 토큰의 방대한 데이터 세트에 대한 교육을 자랑합니다.
긴 입력 처리: MPT-7B는 손상 없이 매우 긴 입력을 처리하도록 설계되었습니다.
속도와 효율성: 이 모델은 신속한 교육 및 추론에 최적화되어 시기 적절한 결과를 보장합니다.
오픈 소스 코드: MPT-7B는 효율적인 오픈 소스 교육 코드와 함께 제공되어 투명성과 사용 편의성을 높입니다.
비교 우수성: MPT-7B는 LLaMA-7B와 일치하는 품질로 20B-7B 범위의 다른 오픈 소스 모델보다 우수함을 입증했습니다.
Falcon LLM은 LLM 계층 구조의 최상위로 빠르게 올라간 모델입니다. Falcon LLM, 특히 Falcon-40B는 40억 개의 매개변수를 갖춘 기본 LLM이며 인상적인 3조 개의 토큰에 대해 교육을 받았습니다. 이는 자동 회귀 디코더 전용 모델로 작동합니다. 즉, 본질적으로 이전 토큰을 기반으로 시퀀스에서 후속 토큰을 예측합니다. 이 아키텍처는 GPT 모델을 연상시킵니다. 특히, Falcon의 아키텍처는 GPT-75보다 우수한 성능을 보여주었고, 훈련 컴퓨팅 예산의 XNUMX%만으로 이 위업을 달성했으며 추론 중에 훨씬 적은 컴퓨팅이 필요합니다.
Technology Innovation Institute의 팀은 Falcon을 개발하는 동안 데이터 품질에 중점을 두었습니다. 교육 데이터 품질에 대한 LLM의 민감도를 인식하여 수만 개의 CPU 코어로 확장되는 데이터 파이프라인을 구성했습니다. 이를 통해 광범위한 필터링 및 중복 제거 프로세스를 통해 웹에서 고품질 콘텐츠를 신속하게 처리하고 추출할 수 있었습니다.
TII는 Falcon-40B 외에도 7억 개의 매개변수를 보유하고 7조 1,500억 개의 토큰에 대해 훈련된 Falcon-40B를 비롯한 다른 버전도 도입했습니다. 특정 작업에 맞게 조정된 Falcon-7B-Instruct 및 Falcon-XNUMXB-Instruct와 같은 특수 모델도 있습니다.
훈련 Falcon-40B는 광범위한 과정이었습니다. 이 모델은 TII가 구축한 대규모 영어 웹 데이터 세트인 RefinedWeb 데이터 세트에서 훈련되었습니다. 이 데이터 세트는 CommonCrawl 위에 구축되었으며 품질을 보장하기 위해 엄격한 필터링을 거쳤습니다. 모델이 준비되면 EAI Harness, HELM 및 BigBench를 포함한 여러 오픈 소스 벤치마크에 대해 검증되었습니다.
Falcon LLM의 주요 기능 개요:
광범위한 매개변수: Falcon-40B는 40억 개의 매개변수를 갖추고 있어 포괄적인 학습 및 성능을 보장합니다.
자기회귀 디코더 전용 모델: 이 아키텍처를 통해 Falcon은 GPT 모델과 유사하게 이전 토큰을 기반으로 후속 토큰을 예측할 수 있습니다.
우수한 성능: Falcon은 교육 컴퓨팅 예산의 3%만 활용하면서 GPT-75보다 성능이 뛰어납니다.
고품질 데이터 파이프라인: TII의 데이터 파이프라인은 웹에서 모델 교육에 중요한 고품질 콘텐츠 추출을 보장합니다.
다양한 모델: Falcon-40B 외에도 TII는 Falcon-7B 및 Falcon-40B-Instruct 및 Falcon-7B-Instruct와 같은 특수 모델을 제공합니다.
오픈 소스 가용성: Falcon LLM은 오픈 소스로 제공되어 AI 도메인에서 접근성과 포괄성을 촉진합니다.
LMSYS ORG는 Vicuna-13B를 도입하여 오픈 소스 LLM 영역에서 중요한 족적을 남겼습니다. 이 오픈 소스 챗봇은 ShareGPT에서 가져온 사용자 공유 대화에서 LLaMA를 미세 조정하여 세심하게 훈련되었습니다. GPT-4가 심사위원으로 참여한 예비 평가에서 Vicuna-13B는 OpenAI ChatGPT 및 Google Bard와 같은 유명한 모델의 90% 이상의 품질을 달성하는 것으로 나타났습니다.
인상적으로, Vicuna-13B는 사례의 90% 이상에서 LLaMA 및 Stanford Alpaca와 같은 다른 주목할만한 모델을 능가합니다. Vicuna-13B에 대한 전체 교육 프로세스는 약 $300의 비용으로 실행되었습니다. 기능 탐색에 관심이 있는 사람들을 위해 코드, 가중치 및 온라인 데모가 비상업적 목적으로 공개되었습니다.
Vicuna-13B 모델은 70K 사용자 공유 ChatGPT 대화로 미세 조정되어 보다 상세하고 잘 구성된 응답을 생성할 수 있습니다. 이러한 응답의 품질은 ChatGPT와 비슷합니다. 그러나 챗봇을 평가하는 것은 복잡한 작업입니다. GPT-4가 발전함에 따라 벤치마크 생성 및 성능 평가를 위한 자동화된 평가 프레임워크 역할을 할 가능성에 대한 호기심이 커지고 있습니다. 초기 결과는 GPT-4가 챗봇 응답을 비교할 때 일관된 순위와 자세한 평가를 생성할 수 있음을 시사합니다. GPT-4를 기반으로 한 예비 평가에서는 Vicuna가 Bard/ChatGPT와 같은 모델의 90% 기능을 달성하는 것으로 나타났습니다.
Vicuna-13B의 주요 특징 개요:
오픈 소스 특성: Vicuna-13B는 공개 액세스가 가능하여 투명성과 커뮤니티 참여를 촉진합니다.
광범위한 교육 데이터: 이 모델은 70개의 사용자 공유 대화에 대해 학습되어 다양한 상호 작용에 대한 포괄적인 이해를 보장합니다.
경쟁력 있는 성능: Vicuna-13B의 성능은 ChatGPT 및 Google Bard와 같은 업계 리더와 동등합니다.
비용 효율적인 교육: Vicuna-13B에 대한 전체 교육 프로세스는 약 $300의 저렴한 비용으로 실행되었습니다.
LLaMA 미세 조정: 이 모델은 LLaMA에서 미세 조정되어 향상된 성능과 응답 품질을 보장합니다.
온라인 데모 가용성: 사용자는 대화식 온라인 데모를 통해 Vicuna-13B의 기능을 테스트하고 경험할 수 있습니다.
대규모 언어 모델의 확장 영역
대규모 언어 모델의 영역은 방대하고 지속적으로 확장되며 새로운 모델이 나올 때마다 가능성의 한계를 뛰어넘습니다. 이 블로그에서 논의된 LLM의 오픈 소스 특성은 AI 커뮤니티의 협력 정신을 보여줄 뿐만 아니라 미래 혁신을 위한 길을 열어줍니다.
Vicuna의 인상적인 챗봇 기능에서 Falcon의 우수한 성능 메트릭에 이르기까지 이러한 모델은 현재 LLM 기술의 정점을 나타냅니다. 이 분야의 급속한 발전을 계속 목격하면서 오픈 소스 모델이 AI의 미래를 형성하는 데 중요한 역할을 할 것이 분명합니다.
당신이 노련한 연구원이든, 신진 AI 애호가이든, 이러한 모델의 잠재력에 대해 궁금한 사람이든, 그들이 제공하는 방대한 가능성에 뛰어들어 탐구하기에 더 좋은 시간은 없습니다.
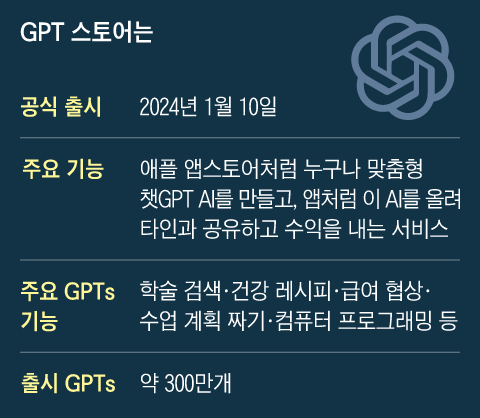
10일(현지 시각) 오픈AI가 GPT 스토어를 연 것은 AI 혁명의 기폭제가 될 만한 사건으로 받아들여진다. 누구나 맞춤형 챗GPT를 만들어 사용하고, 스토어에서 사고팔 수 있게 되면서 거대한 AI 생태계가 형성될 수 있기 때문이다. 특히 많은 사람들에게 필요한 맞춤형 챗GPT를 개발한 사람은 오픈AI에서 이익을 배분받으며 AI 시대의 유니콘(기업 가치 10억달러 이상 스타트업)이 될 수도 있다. GPT 스토어가 개발자를 모으고, 이를 활용하기 위해 세계인이 GPT 스토어를 찾는 선순환 구조가 만들어질 수 있다는 것이다.
오픈AI가 GPT 스토어를 열면서 구글과 마이크로소프트 같은 빅테크들도 AI 장터에 뛰어들 가능성이 높아졌다. 모바일 앱 장터는 초창기에 진출한 애플과 구글이 양분하고 있다. 이들은 앱 장터 거래 수수료로만 연간 수십조원을 챙기고 있지만, 후발 주자들은 대부분 사라졌고 남아 있는 일부도 존재감이 미미하다. AI 장터 시장 역시 주도권을 쥐기 위해서는 발 빠르게 움직여야 한다는 것이다.
그래픽=이철원
◇맞춤형 챗GPT 300만개 넘어서
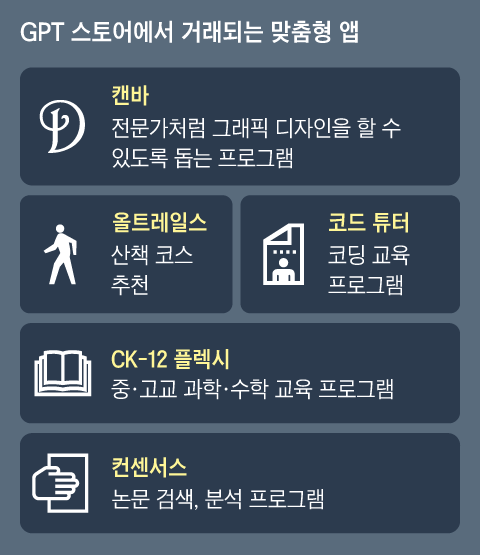
10일 GPT 유료 버전에 접속하면 왼쪽 상단에는 ‘탐색(Explore) GPTs’라는 버튼이 생겼다. 이 버튼을 누르면 GPTs를 검색할 수 있는 검색창과 ‘글쓰기’, ‘생산성 향상’, ‘프로그래밍’, ‘라이프스타일’, ‘교육’ 등의 분야별 추천 맞춤형 챗GPT 추천창이 뜬다. 예컨대 전문가처럼 그래픽 디자인을 할 수 있도록 돕는 ‘캔바’, 산책이나 등산 코스를 추천해주는 ‘올트레일스’, 코딩 교육을 대화하면서 배우는 ‘코드 튜터’, 중고생에게 과학과 수학을 가르치는 ‘CK-12′ 같은 맞춤형 챗GPT들이 있다. 온라인상의 논문을 검색해 분석까지 해주는 ‘컨센서스’처럼 전문가를 위한 챗GPT도 있다.
더 이상 오픈AI가 운영하는 하나의 AI 챗봇 챗GPT가 아니라 챗GPT를 기반으로 만들어진 앱, ‘GPT들(GPTs)’이 넘쳐나고 있는 것이다. 이 같은 맞춤형 챗GPT는 이미 300만개 넘게 만들어졌다. 제작자가 올린 맞춤형 챗GPT가 오픈AI의 사전 검수를 통과해야 등록된다는 것을 감안하면 엄청난 수치이다.
오픈AI는 작년 11월, 누구나 맞춤형 챗GPT를 만들 수 있는 기능을 열었다. 이런 빠른 확산이 가능했던 이유는 코딩을 전혀 모르는 사람도 안내에 따라 버튼 몇 번만 누르면 원하는 챗GPT를 만들 수 있기 때문이다. 애플·구글의 앱은 컴퓨터 언어를 전문적으로 해야만 앱을 만들 수 있었지만, GPTs는 챗GPT와 일상 언어로 대화를 나누는 방식으로 제작한다. ‘GPTs 만들기’를 누르면 챗GPT가 ‘어떤 목적으로 맞춤형 AI를 만드나요?’ ‘학습할 데이터를 업로드해주세요’ 등 말을 하고 사용자는 이에 대답을 하거나 자료를 AI에 입력하면 된다. 오픈AI는 “유료 챗GPT 사용자, 기업 고객들에게 먼저 서비스를 제공하겠다”고 밝혔다. 현재는 20달러를 내는 유료 고객만 이용할 수 있지만, 앞으로는 무료 이용자 등으로 확대할 수도 있다는 것이다.
그래픽=이철원
◇오픈AI, 제작자들과 수익 배분
오픈AI는 조만간 유료·기업 사용자를 통해 얻은 수익을 맞춤형 챗GPT를 만든 제작자들과 분배하는 가이드라인을 공개할 계획이다. 챗GPT 사용량에 따라 유료 고객들이 낸 사용료를 배분해주는 방식이 유력한 것으로 알려졌다. 애플과 구글의 앱 장터에 앱을 올린 기업들이 수익을 내며 성장한 것처럼, 누구나 AI를 만들어 돈을 벌 수 있도록 하겠다는 것이다. 조대곤 KAIST 경영대학 교수는 “앱 장터의 등장으로 수많은 스타트업과 게임 회사, 인터넷 업체 등이 생겨나고 이들 중 상당수가 막대한 부를 거머쥐었다”면서 “이런 동기부여가 AI 혁명을 가속하는 원동력이 될 것”이라고 했다.
당초 오픈AI는 지난해 11월 GPT 스토어를 열 계획이었다. 하지만 스토어 오픈을 앞두고 오픈AI 이사회가 샘 올트먼 최고경영자(CEO)를 해고하고, 이에 직원들이 반발해 올트먼이 복귀하는 등 내홍을 겪으면서 출시가 다소 지연됐다. 테크 업계에서는 오픈AI가 GPT 스토어를 시작으로 여러 수익 사업을 시작할 것으로 본다.
자신을 안다는 것은 어디서부터 어떻게 시작해야 될지 알기 어려운 거대한 과제처럼 느껴질 때가 많다. 하지만 조금 다르게 생각하면 나를 안다는 것은 퍼즐을 맞추는 것과 비슷한 면이 있다.
1000피스 이상의 큰 퍼즐을 맞추다 보면 어디서부터 맞춰야 할지, 지금 내가 손에 들고 있는 조각이 그림의 어떤 부분에 속하기는 하는지, 작은 조각들을 맞춘다고 해서 과연 큰 그림이 완성이 될지 같은 의문들이 밀려온다. 하지만 이 아무것도 아닌 것 같은 조각들을 조금씩 맞추다 보면 어느새 꽃이 피고 강이 흐르는 아름다운 그림이 완성된다.
자신을 아는 과정도 마찬가지다. 기억과 경험들을 통해 자신에 대한 사실을 하나씩 조각조각 맞춰가다 보면 어느새 어떤 그림이 만들어지곤 한다. 이런 과정을 통해 자기 안에는 특정 모습이 자리잡고 있고 이 모습이 또 다른 모습과 연결이 되어서 더 큰 나를 형성한다는 사실을 알게 된다.
물론 말이 쉽지 실제로 자신에 대한 조각 맞추기를 하는 과정은 수년에서 평생 걸릴 수도 있는 장기 프로젝트다. 그래도 분명한 사실은 자신을 형성하는 조각들을 발견하고, 수집하고, 맞추는 행위는 나를 알기 위한 중요한 첫걸음이라는 점이다. 이런 점에서 자신의 생각이나 감정, 기억의 조각들을 기록해두는 행위는 생각보다 우리에게 많은 유익을 가져다 준다.
● 삶의 조각 기록하기
일례로 많은 사람들이 사소한 것이라도 자신과 관련된 정보들을 모으는 것에서 큰 기쁨을 느낀다. 심리 과학(Psychological Science)에 실린 한 연구에서는 사람들에게 타임 캡슐을 만들도록 했다.
자신과 관련된 사소한 정보들을 담도록 했다. 예컨대 최근 친구들과 나눴던 대화, 친구를 알게 된 계기, 최근 들었던 노래, 친구들끼리 흔히 하는 농담들, 최근 페이스북에 올린 포스팅 등 평범한 일상을 기록했다. 이후 타임 캡슐을 열 때 이 내용들이 얼마나 궁금하고 놀랍고 의미있게 느껴질 것인지에 대해 물었다. 타임 캡슐이라지만 별 볼일 없어 보이는 평범한 내용들이 담겼으므로 시큰둥한 반응을 보이는 사람들이 많았다.
하지만 3개월 뒤 실제 타임 캡슐을 열고 사람들의 반응을 살펴봤을 때 사람들은 자신이 예상했던 것보다 훨씬 자신의 삶에 대한 자질구레한 정보들에 큰 흥미를 보였다. 발렌타인데이 때의 데이트 같은 특별한 추억과 비교했을 때에도 3개월 전에 먹은 음식, 친구랑 나눈 대화 같은 정보들이 비슷하거나 혹은 더 큰 기쁨을 가져다 주는 것으로 나타났다. 내 삶에 대한 정보라면 어떤 자질구레한 정보라도 다 중요한 퍼즐 조각이 된다는 것이다.
여기에서 ‘기록’의 중요성이 드러난다. 내 삶에 대한 기록이라면 단편적인 것들도 다 자신에 대해 중요한 정보를 주기 때문이다. 맛있게 먹었던 음식 사진 같은 사소한 것도 나중에 보면 단순히 무엇을 먹었다는 사실에 더해 이 때 자신이 어떤 기분이었는지, 특별히 축하하거나 위로할 일이 있었는지, 누구랑 먹었는지, 어떤 대화를 나누었는지 등에 대한 다양한 정보를 준다.
여행을 다녀와도 결국 남는 것은 사진이라는 말처럼 사진 한 장만 봐도 이를 촉매로 우리가 인출할 수 있는 정보들은 무한대다. 결국 아무리 작은 정보라도 이를 기록하는 행위는 내 삶의 조각을 보관하는 행위에 가깝다는 것이다. 인생은 곧 시간이어서 아무도 삶을 붙잡아 둘 수는 없다. 오직 기록하는 행위만이 지나가버린 삶의 조각들을 모아서 맞춰 볼 수 있게 도와준다.
● 기록하는 글 쓰기
삶의 조각 맞추기는 우리 삶에 의미를 부여해줄 뿐 아니라 더 나은 미래를 설계하기 위한 나침반이 되기도 한다. 역사를 배우는 이유에 대해 사람들은 흔히 과거의 잘못을 반성하고 더 나은 미래로 나아가기 위함이라고들 이야기한다.
따라서 우리는 역사를 배울 때 단순히 사건을 나열하기보다 어떤 사건이 어떤 결과를 초래했는지 다른 방향의 해결책은 없었는지 같은 논리적 흐름과 인과관계에 더 집중한다. 나 자신의 역사를 일목요연하게 정리하는 것 역시 비슷한 효과를 가져온다.
노스캐롤라이나 주립대의 심리학자 키티 클레인은 대학생들에게 2주 동안 하루에 20분씩 요즘 가장 고민인 것들을 적어보도록 했다. 단순히 사건을 나열하는 것이 아니라 그 일이 ‘왜’ 발생했는지, 원인과 결과가 무엇인지, 어떻게 풀어나갈 수 있을지에 대해 인과관계를 서술하도록 했다. 또 다른 학생들에게는 단순히 일어난 사건을 나열하도록 했다. 그러고 나서 이후 이 두 그룹이 어떤 차이를 보이는지 했다.
그 결과 자신에게 일어난 일을 논리적으로 정리해본 학생들은 그렇지 않은 학생들에 비해 우선 스트레스가 감소한 모습을 보였다. 이들의 작업 기억력(working memory: 컴퓨터의 RAM과 같이 여러 테스크를 한꺼번에 처리할 수 있는 능력을 말한다. 작업기억 용량이 적으면 일이 조금만 많아져도 버벅거리게 되는 등 능률이 떨어진다.) 또한 증가한 것으로 나타났다.
해보기도 전에 실패할까 걱정하는 탓에 에너지 소모만 많고 정작 아무것도 하지 않는 비효율도 줄어들었다. 결과적으로 생각을 정리해본 학생들은 그렇지 않은 학생들에 비해 더 높은 학점을 받은 것으로 나타났다.
마음이 복잡할 때 글쓰기 등을 통해 내게 무슨 일이 일어나고 있는지 정리해 보는 것만으로 우리는 걱정을 내려 놓고 나에게 정말 중요한 것이 무엇인지 내가 지금 할 수 있는 것이 무엇이고 어떤 방향으로 나아가야 하는지에 대한 해답을 얻을 수 있다는 것이다.
● 감정을 해소하는 글쓰기
괴로운 감정들에 휩싸여 있을 때도 생각을 정리하는 글쓰기가 큰 도움이 된다. 충격적인 사건이나 큰 스트레스가 발생했을 때는 감정을 잘 해소하고 넘어가는 것이 중요하다. 해소되지 않은 감정은 때로 곱씹기 형태로 나타나 기억 속에서 머물며 계속해서 튀어나오는 성질을 가지고 있기 때문이다.
하지만 감정을 이해한다는 것이 쉬운 일은 아니다. 깊이 생각하지 않으면 진짜 원인을 찾는 것이 어려울 때가 많기 때문이다. 텍사스대의 심리학자 제임스 페니베이커의 연구에 의하면 이렇게 복잡한 감정 상태를 이해할 때에도 내가 왜 어떤 감정을 느끼고 있는지 분석하며 글을 써내려가는 행위가 감정을 이해하는 데 큰 도움이 된다.
복잡한 마음 상태에 대한 기록은 때론 ‘표출’의 역할을 하며 감정의 해방구가 되기도 한다. 일례로 윌프리드 로리어대의 심리학자 민디 포스터는 연구 결과 트위터를 통해 자신이 겪은 성차별에 대해 털어 놓은 여성들은 그렇지 않은 여성들에 비해 행복도가 상승했다고 밝혔다. 청자가 낯선 사람들이기에 더 쉽게 털어 놓을 수 있는 이야기들이 있는 법이다.
미투 운동처럼 새로운 플랫폼을 통해 하지 못했던 이야기를 털어 놓는 행위는 집단적인 공감과 분노, 나아가 사회 변혁의 씨앗이 되기도 한다. 펜은 칼보다 강하다고 작은 기록 또는 표현이 개인의 삶, 나아가 사회를 바꾸기도 하는 것이다. 작은 표현의 효과가 이렇게나 크기 때문에 학자들은 생각이 담긴 글쓰기를 자주 하도록 권한다. 특히 내 삶이 어디로 가고 있는지 모르겠다면 차분히 앉아 사진을 정리해보거나 일기를 적어보는 것이 작은 등불이 되어 가야할 길을 비춰줄 수도 있다.
● 해보기
평소 자신에 대해서 알고 싶었던 부분이나 최근 마음 속을 어지럽혔던 사건들에 대해서 생각해보고 하나를 골라서 적어보도록 하자. 자신의 어떤 부분인지 또는 어떤 사건인지 2-3줄 정도로 적어보자.
① 그 당시 어떤 생각이 들었는가? 어떤 감정들을 느꼈는가.
② 지금 다시 떠올리면 어떤 생각이 드는가.
③ 인정하고 싶지 않은 사실이 있다면 그것들은 어떤 사실인가.
④ 억누르고 싶은 감정들이 있다면 그것들은 어떤 감정인가.
위에 적은 내용들을 찬찬히 읽어보도록 하자. 쭉 읽어보고 어떤 생각이 드는지 다시 적어보도록 하자. 새로운 깨달음이나 이전에는 보지 못했던 결론을 도출할 수 있다면 적어보도록 하자. 결론을 도출하지 못했다고 해도 괜찮다. 며칠 후 다시 들여다보고 비슷한 작업을 해보도록 하자. 한 해를 마무리하는 시점에서 아직 정리되지 않은 감정이나 생각들이 있다면 글쓰기로 풀어 보는 것도 좋을 것 같다.
Pennebaker, J. W. (2004). Writing to heal: A guided journal for recovering from trauma and emotional upheaval. New Harbinger Publisher.
※필자소개 박진영. 《나, 지금 이대로 괜찮은 사람》, 《나를 사랑하지 않는 나에게》를 썼다. 삶에 도움이 되는 심리학 연구를 알기 쉽고 공감 가도록 풀어낸 책을 통해 독자와 꾸준히 소통하고 있다. 온라인에서 ‘지뇽뇽’이라는 필명으로 활동하고 있다. 현재 미국 듀크대에서 사회심리학 박사 과정을 밟고 있다