2 9월 2024

[인공지능 기술] RAG(검색 증강 생성)란? – LLM 단점을 보완하는 기술

[인공지능 기술] RAG(검색 증강 생성)란? – LLM 단점을 보완하는 기술

RAG(검색 증강 생성)란? – LLM 단점을 보완하는 기술

LLM(Large Language Model)의 많은 장점에도 불구하고 단점을 보완하기 위한 RAG(검색 증강 생성)이 많은 관심을 받고 있습니다. RAG의 기본 개념, 등장 배경, 원리, 적용 사례 등을 알아보겠습니다.

2024-05-07 | 박성돈

최근 인공지능 기술의 발전은 다양한 분야에서 혁신을 일으키고 있으며, 그 중에서도 텍스트 생성 AI는 특히 주목받고 있습니다. 하지만 이러한 기술이 가진 정확성과 신뢰성의 문제는 사용자와 개발자 모두에게 중요한 과제로 남아 있습니다. 이 문제를 해결하기 위해 등장한 기술 중 하나가 바로 RAG(Retrieval-Augmented Generation)입니다.

본문에서는 RAG의 기본 개념, 등장 배경, 원리, 적용 사례 등에 대해 살펴보겠습니다. 먼저 LLM이 무엇인지, 특징과 장/단점에 대해 알아보겠습니다.

LLM이란?

LLM은 Large Language Model의 약자로, 자연어 처리(NLP)에서 사용되는 인공지능 기술의 한 종류입니다. 이 모델들은 대규모의 텍스트 데이터를 학습하여 언어의 구조와 의미를 이해하고, 그 학습을 바탕으로 텍스트 생성, 번역, 요약, 질문에 대한 답변 등 다양한 언어 관련 작업을 할 수 있습니다.

LLM의 주요 특징은 다음과 같습니다.

  • 방대한 지식 보유: 다양한 분야의 텍스트를 학습하여 광범위한 지식을 갖추고 있습니다.
  • 문맥 이해 능력: 단순히 단어를 매칭하는 것이 아니라 전후 맥락을 고려하여 언어를 이해할 수 있습니다.
  • 자연어 생성 능력: 문장 생성, 질문 응답, 요약, 번역 등 다양한 자연어 처리 태스크를 수행할 수 있습니다.
  • 전이 학습 능력: 한 분야에서 학습한 지식을 다른 유사 태스크에 활용하는 등 전이 학습이 가능합니다.
  • 확장성: 더 많은 데이터와 컴퓨팅 자원을 활용하면 계속 성능을 향상시킬 수 있습니다.

LLM은 챗봇, 검색 엔진, 콘텐츠 생성 등 다양한 분야에서 활용되고 있으며, 인간과 유사한 수준의 언어 이해와 생성 능력을 보여주고 있습니다. 하지만 편향성 문제, 사실 관계 오류 등의 한계점도 지적되고 있어 해결해야 할 과제도 남아있는 상황입니다.

LLM의 장점

LLM(Large Language Model)은 다음과 같은 다양한 장점을 가지고 있습니다:

  1. 광범위한 지식 활용
    • 방대한 양의 텍스트 데이터를 학습하여 다양한 분야의 지식을 습득
    • 학습한 지식을 바탕으로 사용자의 질문에 폭넓고 심도 있는 답변 가능
  2. 뛰어난 언어 이해 및 생성 능력
    • 단어 간의 관계와 문맥을 고려하여 자연스러운 언어 이해 가능
    • 문법적으로 정확하고 의미 있는 문장 생성 능력
  3. 다양한 태스크 수행 가능
    • 텍스트 분류, 질의응답, 요약, 번역, 문장 생성 등 다양한 NLP 태스크 처리 가능
    • 하나의 모델로 여러 태스크를 수행할 수 있어 범용성이 높음
  4. 사용자 친화적인 인터페이스
    • 자연어로 된 사용자 입력을 이해하고 응답할 수 있어 접근성이 좋음
    • 챗봇, 가상 어시스턴트 등으로 활용되어 사용자 경험 향상
  5. 다양한 분야에서의 활용
    • 고객 서비스, 콘텐츠 제작, 교육, 의료 등 다양한 산업 분야에서 활용 가능
    • 사람과 기계 간의 상호작용을 향상시키고 업무 효율성 증대에 기여

LLM의 단점

LLM(Large Language Model)은 많은 장점에도 불구하고 다음과 같은 단점과 한계점을 가지고 있습니다:

  1. 편향성 문제
    • 학습 데이터에 내재된 편향성을 그대로 반영할 수 있음
    • 성별, 인종, 종교 등에 대한 고정관념이나 차별적 표현을 생성할 위험 존재
  2. 사실 관계 오류 가능성
    • 방대한 데이터를 학습하지만, 항상 정확한 정보를 제공하지는 않음
    • 잘못된 정보나 허위 정보를 진실로 간주하고 전파할 수 있음
  3. 맥락 이해의 한계
    • 문장 단위의 이해는 가능하지만, 장문의 글이나 복잡한 맥락 파악은 어려울 수 있음
    • 세계 지식과 상식 추론 능력이 부족하여 심층적인 이해에 한계 존재
  4. 일관성 문제
    • 동일한 입력에 대해 일관된 답변을 생성하지 않을 수 있음
    • 모델의 확률적 특성상 생성 결과가 매번 달라질 수 있어 신뢰성 저하
  5. 윤리적 문제
    • 악용 가능성이 존재하며, 책임 소재 파악이 어려울 수 있음
    • 모델의 출력 결과에 대한 통제와 검증 체계 마련 필요

RAG는 LLM의 단점 중 무엇을 개선하는가?

RAG(Retrieval-Augmented Generation)는 LLM의 단점 중 ‘사실 관계 오류 가능성’과 ‘맥락 이해의 한계’를 개선하는 데 초점을 맞춘 방법입니다. RAG는 LLM에 외부 지식 베이스를 연결하여 모델의 생성 능력과 사실 관계 파악 능력을 향상시키는 기술입니다.

구체적으로 RAG는 다음과 같은 방식으로 LLM의 한계를 보완합니다:

  1. 외부 지식 활용
    • 대규모의 구조화된 지식 베이스(예: 위키피디아)를 모델에 연결
    • 주어진 질의에 대한 관련 정보를 지식 베이스에서 검색 및 추출
  2. 증거 기반 생성
    • 검색된 지식 정보를 증거로 활용하여 보다 사실에 기반한 답변 생성
    • 생성된 답변의 출처를 명시함으로써 신뢰성 향상
  3. 맥락 이해력 향상
    • 외부 지식을 통해 질의에 대한 배경 지식과 맥락 정보를 파악
    • 단순한 패턴 매칭이 아닌 추론 능력을 바탕으로 한 답변 생성

RAG는 기존 LLM의 생성 능력과 외부 지식 베이스의 정보를 결합함으로써, 보다 정확하고 사실에 기반한 답변을 제공할 수 있습니다. 또한 모델의 출력 결과에 대한 증거를 제시할 수 있어 설명 가능성과 신뢰성을 높일 수 있습니다.

RAG 기술은 질의응답, 정보 검색, 팩트 체킹 등의 태스크에서 활발히 연구되고 있으며, 구글의 LaMDA, OpenAI의 WebGPT 등 최신 LLM에도 적용되고 있습니다. 다만 RAG 모델의 성능은 연결된 지식 베이스의 품질과 커버리지에 크게 의존하므로, 고품질의 지식 베이스 구축이 중요한 과제로 남아 있습니다.


RAG의 기본 개념

RAG(Retrieval-Augmented Generation)는 대규모 언어 모델(LLM)의 한계를 극복하기 위해 제안된 새로운 자연어 처리 기술입니다. LLM은 방대한 양의 텍스트 데이터를 사전 학습하여 강력한 언어 이해 및 생성 능력을 갖추고 있지만, 학습 데이터에 없는 최신 정보나 특정 도메인 지식은 제공하기 어렵다는 단점이 있습니다.

RAG는 이러한 LLM의 한계를 극복하기 위해 ‘지식 검색’과 ‘언어 생성’을 결합한 프레임워크입니다. RAG의 기본 아이디어는 질문에 답하기 위해 필요한 지식을 외부 데이터베이스에서 검색하여 활용하는 것입니다.

RAG의 주요 구성 요소

  1. 질의 인코더(Query Encoder): 사용자의 질문을 이해하기 위한 언어 모델입니다. 주어진 질문을 벡터 형태로 인코딩합니다.
  2. 지식 검색기(Knowledge Retriever): 인코딩된 질문을 바탕으로 외부 지식 베이스에서 관련 정보를 검색합니다. 예를 들어 Wikipedia, 뉴스 기사, 전문 서적 등 방대한 문서 집합에서 질문과 연관된 문단이나 구절을 찾아냅니다.
  3. 지식 증강 생성기(Knowledge-Augmented Generator): 검색된 지식을 활용하여 질문에 대한 답변을 생성하는 언어 모델입니다. 기존의 LLM과 유사하지만, 검색된 지식을 추가 입력으로 받아 보다 정확하고 풍부한 답변을 생성할 수 있습니다.

RAG의 동작 과정 요약

  1. 사용자의 질문이 주어지면 질의 인코더가 이를 이해하기 쉬운 형태로 변환합니다.
  2. 지식 검색기가 인코딩된 질문을 바탕으로 외부 지식 베이스에서 관련 정보를 검색합니다.
  3. 검색된 지식은 지식 증강 생성기의 입력으로 전달됩니다.
  4. 지식 증강 생성기는 검색된 지식을 활용하여 사용자 질문에 대한 답변을 생성합니다.

RAG는 LLM의 강력한 언어 이해 및 생성 능력과 외부 지식 활용을 결합함으로써, 보다 정확하고 풍부한 정보를 제공할 수 있습니다. 특히 최신 정보나 특정 도메인 지식이 필요한 질문에 효과적으로 대응할 수 있다는 장점이 있습니다.

RAG의 등장 배경과 필요성

RAG는 자연어 처리와 인공지능 기술의 발전, 그리고 증가하는 사용자의 요구에 따라 등장하게 되었습니다. RAG의 등장 배경과 필요성을 다음과 같이 정리할 수 있습니다.

  1. 지식 기반 질의응답 시스템의 한계
    • 초기의 질의응답 시스템은 주로 제한된 도메인의 구조화된 데이터를 기반으로 동작했습니다. 이는 시스템이 다룰 수 있는 주제와 질문의 유형이 한정적이라는 문제가 있었습니다.
    • 사용자의 다양한 정보 요구를 충족시키기 위해서는 보다 광범위한 지식을 활용할 수 있는 시스템이 필요하게 되었습니다.
  2. 비정형 텍스트 데이터의 폭발적 증가
    • 인터넷의 발달과 디지털 기기의 보급으로 웹페이지, 뉴스 기사, 소셜 미디어 게시물 등 비정형 텍스트 데이터가 기하급수적으로 증가하고 있습니다.
    • 이러한 대규모 텍스트 데이터는 방대한 지식을 포함하고 있어, 질의응답 시스템의 지식 베이스로 활용할 수 있는 잠재력이 높습니다.
    • 그러나 비정형 데이터를 효과적으로 처리하고 활용하기 위해서는 기존과는 다른 접근 방식이 필요했습니다.
  3. 사전 학습된 언어 모델의 발전
    • BERT, GPT 등 사전 학습된 대규모 언어 모델의 등장은 자연어 처리 분야에 큰 변화를 가져왔습니다.
    • 이러한 언어 모델은 방대한 텍스트 데이터로부터 언어의 구조와 의미를 학습하여, 다양한 언어 이해 및 생성 태스크에서 뛰어난 성능을 보여주었습니다.
    • 사전 학습된 언어 모델을 질의응답 시스템에 활용함으로써, 보다 자연스럽고 문맥을 고려한 답변 생성이 가능해졌습니다.
  4. 실시간 정보 제공에 대한 사용자의 요구 증대
    • 인터넷과 모바일 기기의 발달로 사용자들은 언제 어디서나 필요한 정보를 즉시 얻고자 하는 요구가 커지고 있습니다.
    • 단순히 정보를 검색하는 것을 넘어, 대화형 인터페이스를 통해 원하는 정보를 직관적으로 얻고자 하는 사용자가 늘어났습니다.
    • 이에 따라 사용자의 질문을 이해하고 적절한 답변을 실시간으로 제공할 수 있는 지능형 질의응답 시스템의 필요성이 대두되었습니다.
  5. 지식 검색과 답변 생성의 통합 필요성
    • 기존의 질의응답 시스템은 지식 검색과 답변 생성을 별도의 단계로 처리하는 경우가 많았습니다. 이로 인해 검색된 정보와 생성된 답변 사이의 정합성이 떨어지는 문제가 발생했습니다.
    • 지식 검색과 답변 생성을 통합적으로 수행할 수 있는 프레임워크의 필요성이 제기되었고, 이는 RAG 아키텍처의 등장으로 이어졌습니다.

이러한 배경과 필요성 속에서 RAG는 대규모 비정형 텍스트 데이터를 활용하고, 사전 학습된 언어 모델과 통합 프레임워크를 통해 보다 진보된 형태의 질의응답 시스템을 구현하고자 합니다. RAG는 사용자의 다양한 정보 요구를 만족시키고, 인간과 자연스럽게 상호작용할 수 있는 지능형 대화 시스템의 발전에 기여할 것으로 기대됩니다.

RAG 기술을 적용한 상용 서비스 사례

RAG 기술을 적용한 상용 서비스는 아직 많지 않지만, 몇몇 대표적인 사례들이 있습니다.

  1. Microsoft Bing Search
    • 2023년 2월, Microsoft는 Bing 검색 엔진에 RAG 기술을 적용한 대화형 AI 기능을 추가했습니다.
    • 사용자의 검색 질의에 대해 웹 페이지의 정보를 활용하여 자연어로 응답을 생성합니다.
    • 제공된 응답의 근거가 되는 웹 페이지 링크를 함께 제시합니다.
  2. Anthropic’s Constitutional AI (CAI)
    • Anthropic사는 RAG 기술을 활용한 대화형 AI 모델인 CAI를 개발했습니다.
    • CAI는 대화 과정에서 외부 지식을 활용하여 사용자의 질문에 답변을 생성합니다.
    • 생성된 응답의 근거가 되는 출처를 명시하여 신뢰성을 높였습니다.
  3. Perplexity AI
    • Perplexity AI는 RAG 기반의 질의응답 서비스를 제공하는 스타트업입니다.
    • 사용자의 질문에 대해 웹 검색을 통해 관련 정보를 수집하고, 이를 바탕으로 응답을 생성합니다.
    • 제공된 응답의 출처와 검색 과정을 사용자에게 투명하게 공개합니다.
  4. OpenAI’s WebGPT (in development)
    • OpenAI는 GPT 모델에 RAG 기술을 적용한 WebGPT를 개발 중입니다.
    • WebGPT는 웹 검색을 통해 획득한 지식을 활용하여 사용자의 질의에 대한 응답을 생성할 것으로 예상됩니다.
    • 아직 공개된 서비스는 아니지만, 향후 RAG 기술의 발전 방향을 보여주는 사례로 주목받고 있습니다.

위의 사례들은 RAG 기술의 초기 적용 단계라고 볼 수 있습니다. RAG의 잠재력이 입증됨에 따라 앞으로 더 많은 분야에서 RAG 기반의 서비스들이 등장할 것으로 예상됩니다. 특히 검색 엔진, 가상 어시스턴트, 고객 서비스 등의 분야에서 RAG 기술이 활발히 도입될 것으로 보입니다.

다만 RAG 기술의 상용화를 위해서는 지식 베이스의 품질 관리, 프라이버시 보호, 책임 소재 등의 이슈들이 선결되어야 할 것입니다. 기술적 진보와 함께 사회적, 윤리적 문제에 대한 고민이 병행되어야 RAG가 실생활에 안전하게 적용될 수 있을 것입니다.

참고 자료

[출처] https://modulabs.co.kr/blog/retrieval-augmented-generation/

Loading

23 8월 2024

[물리] 韓 과학자들, 암흑물질 유력 후보 ‘액시온’ 수사망 좁혔다

[물리] 韓 과학자들, 암흑물질 유력 후보 ‘액시온’ 수사망 좁혔다

韓 과학자들, 암흑물질 유력 후보 ‘액시온’ 수사망 좁혔다

입력
물리학에서 우주를 설명하는 표준 모델에 따르면 우주의 구성 성분 중에 우리가 이해할 수 있는 물질은 약 5%뿐이다. 26.8%는 암흑물질이, 나머지는 암흑에너지가 차지한다. 게티이미지뱅크 제공

물리학에서 우주를 설명하는 표준 모델에 따르면 우주의 구성 성분 중에 우리가 이해할 수 있는 물질은 약 5%뿐이다. 26.8%는 암흑물질이, 나머지는 암흑에너지가 차지한다. 게티이미지뱅크 제공

표준 우주론 모델에 따르면 우주의 26.8%는 암흑물질이 차지하지만 암흑물질의 정체는 명확히 밝혀지지 않았다. 과학자들은 이론으로 예측된 범위에서 암흑물질이 존재하지 않는 영역을 배제하는 식으로 암흑물질을 찾는다.

특히 액시온(Axion)은 유력한 암흑물질 후보다. 질량이 매우 작으며 다른 입자와 상호작용을 거의 하지 않는 것으로 추정되는 입자다. 최근 기초과학연구원(IBS) 액시온 및 극한상호작용연구단은 액시온 존재 여부를 판단할 수 있는 범위를 좁힌 연구 결과를 최근 잇따라 공개해 주목을 받고 있다.

일반적으로 과학자들은 강력한 자석을 사용해 액시온의 존재 여부를 판단한다. 이론에 따르면 액시온은 자기장과 만나면 질량에 따른 주파수를 나타내는 광자(빛의 입자)로 변환된다. 이때 공진기를 이용해 주파수를 증폭하고 검출하면 해당 관찰 영역의 액시온 존재 여부를 파악할 수 있다.

핵심은 액시온의 질량과 질량이 변환된 주파수를 알지 못한다는 점이다. 이론에서 예측한 넓은 주파수 영역에서 라디오 주파수를 맞추듯 조금씩 탐색해야 한다.

● 자체 장비 개발해 액시온 탐색

액시온에 대한 이론적 모델로 ‘DFSZ’와 ‘KSVZ’가 있다. ‘DFSZ 액시온’ 모델에서 예측한 액시온은 KSVZ에서 제시한 것보다 다른 입자와의 상호작용이 작아 실험에서 탐지하기 더 어렵지만 기존 우주론의 한계를 극복한 ‘대통일 모델(GUT)’의 근거를 확보할 수 있다.

이런 이유로 IBS 연구단은 ‘DFSZ 액시온’ 탐색에 초점을 맞춰 장비를 개발하고 특정 범위에서 액시온의 존재 여부를 확인하는 데 성공했다. 연구 결과는 12일(현지 시간) 국제학술지 ‘피지컬 리뷰 X’에 공개됐다.

액시온 검출 확률은 자기장이 클수록 높아진다. 연구팀은 초전도체로 지구자기장 세기의 24만 배에 달하는 12테슬라(T)의 자석을 구현했다. 연구팀은 개발한 장비를 활용해 1.025~1.185기가헤르츠(GHz) 주파수 범위에서 질량이 4.24~4.91µeV(마이크로전자볼트)인 액시온을 세계 최고 감도로 탐색하는 데 성공했다. 전자볼트(eV)는 주로 입자물리학에서 사용되는 매우 작은 에너지·질량 단위다. 멈춰 있는 전자의 질량이 약 511킬로전자볼트(keV)로 알려졌다.

정우현 IBS 연구단 연구위원은 “DFSZ 액시온을 탐색할 수 있는 연구팀은 전 세계에서 두 곳뿐”이라며 “1GHz 이상 주파수에서 고감도로 액시온 탐색에 성공한 건 현재까지 IBS 연구팀이 유일하다”고 설명했다.

● 고주파수 영역에서도 최고 수준 성과

연구단은 고주파수 영역에서도 최고 수준의 연구성과를 냈다. KSVZ 이론에 따른 최근 연구들은 액시온의 질량이 20~30µeV, 주파수로는 4.8~7.25GHz 영역에 있을 것으로 예측한다. 연구단은 기존 실험보다 더 높은 고주파에 주목했다.

고주파 신호를 탐색하려면 주파수를 증폭하는 공진기의 부피를 줄여야 한다. 부피가 줄면 데이터를 얻는 데 시간이 오래 걸린다. 연구팀은 원통형 공진기를 피자 조각처럼 나눈 ‘다중방 공진기’를 고안했다. 실험 결과 액시온이 질량 21.86~22.00µeV 범위에서 존재하지 않는다는 사실이 확인됐다. 신뢰도는 90% 수준으로 해당 범위에서는 현재까지 가장 민감도가 높은 결과다. 연구결과는 지난달 31일(현지 시간) ‘피지컬 리뷰 레터스’에 게재됐다.

윤성우 IBS 연구단 연구위원은 “액시온 탐색은 건초더미에서 바늘을 찾는 일과 비슷하다”며 “차세대 액시온 탐색 실험의 방향성을 제시하는 연구”라고 밝혔다.

<참고 자료>
– doi.org/10.1103/PhysRevX.14.031023
– doi.org/10.1103/PhysRevLett.133.051802

Loading

13 8월 2024

[인공지능 기술] AI 기반 물리 정보 신경망을 이용한 시뮬레이션

[인공지능 기술] AI 기반 물리 정보 신경망을 이용한 시뮬레이션

AI 기반 물리 정보 신경망을

이용한 시뮬레이션

AI 기반 물리 정보 신경망을 이용한 시뮬레이션

이번 글에서는 시뮬레이션에서 최근 화두가 되고 있는 물리 정보 신경망(Physics-Informed Neural Network, 이하 PINN)에 대해서 다루어 보겠습니다. 여기서 시뮬레이션이라는 것은 유체역학, 전자기학 등 공학 문제를 슈퍼컴퓨터를 이용한 수학적인 방법으로 푸는 것을 말합니다. 자동차 형상, 휴대폰 열설계, 반도체 소자 시뮬레이션 등이 있습니다.

전통적으로 시뮬레이션은 유한차분법(Finite Difference Method), 유한요소법(Finite Element Method), 그리고 유한체적법(Finite Volume Method)이라고 하는 전체 도메인을 작은 요소로 나누어 근사적인 해를 구하는 수치해석적인 방법을 사용하여 시뮬레이션을 하였으며 이 과정에서 엄청난 양의 계산을 위해 슈퍼컴퓨터를 사용하였습니다.

하지만 최근 AI의 발전으로 인해 시뮬레이션 분야에도 AI를 접목시킨 물리 정보 신경망이라는 방법이 연구되기 시작하였습니다. 이 방법은 Inverse 문제와 Ill-posed 문제 등 전통적인 수치해석 기법의 한계를 극복하기 위해 대두되었습니다.

전통적인 수치해석 방법

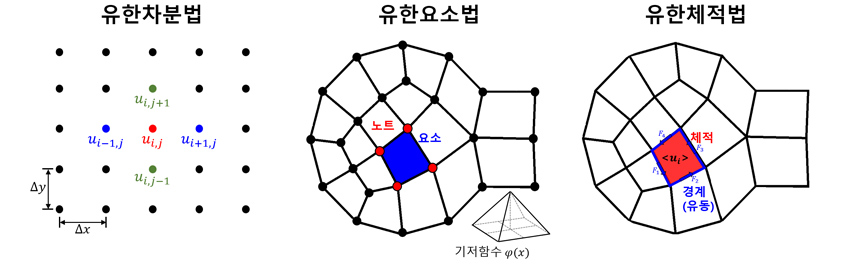
통상적으로 전통적인 수치해석 방법이라 함은 유한차분법, 유한요소법, 그리고 유한체적법이라고 할 수 있습니다. 이 세 가지 방법은 모두 도메인을 잘게 요소(Element)로 나누어 각 요소에서 수치해석적인 방법을 적용하여 계산합니다. 이렇게 각 요소에서 계산한 값을 모아서 시뮬레이션을 수행합니다.

유한차분법

  • Ui,j+1
  • Ui-1,j / Ui,j / Ui+1,j
  • △y / Ui,j-1
  • △x

유한요소법

  • 노트
  • 요소
  • 기저함수 ∮(x)

유한체적법

  • 체적
  • ⁢Ui >
  • 경계(유동)

[그림 1] 유한차분법, 유한요소법, 유한체적법의 차이

유한차분법의 경우 함숫값의 차이를 이용한 미분계수를 근사하여 편미분 방정식을 푸는 방법입니다. 전방(forward), 후방(backward), 중앙(central) 차분법 등 세 가지로 나눌 수 있으며 테일러 급수 전개를 통해 유도합니다. 직사각격자에 적합하고 알고리즘이 직관적이어서 사용하기 쉽고 병렬계산에 적합하여 학술적인 연구나 간단한 시뮬레이션을 할 경우에 효과적입니다. 선형 문제뿐만 아니라 비선형 문제에도 쉽게 적용 가능하며 특히 유체역학 시뮬레이션에 많이 사용됩니다.

유한요소법의 경우 풀고자 하는 편미분방정식을 적분형으로 표현한 뒤 최종적으로 Ax=b 형태의 선형시스템으로 변환하여 근사해를 구하는 방법입니다. 주로 고체역학이나 전자기학 시뮬레이션 등에 사용되며 GPU 가속 효과가 가장 크고 불규칙한 물체 시뮬레이션에 적합합니다. 유한차분법에 비해 해의 연속성을 유지할 수 있기 때문에 물리적으로 타당한 해를 얻을 가능성이 높습니다.

유한체적법의 경우 보존 법칙을 만족하는 문제를 푸는데 적합하기 때문에 주로 유체역학 시뮬레이션에 사용됩니다. 유한체적의 면을 지나는 유동의 양을 기준으로 유도되며 시뮬레이션 형상에 대해 유연하게 계산을 적용할 수 있습니다. 유한차분법과 마찬가지로 불규칙한 물체를 시뮬레이션하는 데 적합합니다.

물리 정보 신경망의 특징

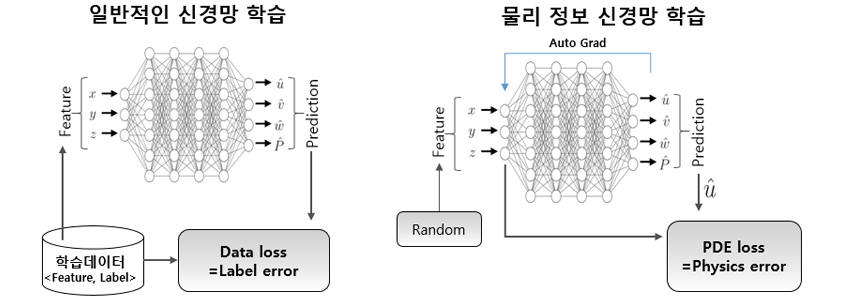
일반적인 신경망이 물리적 법칙을 고려하지 않고 데이터에 전적으로 의존하는 반면, 물리 정보 신경망은 지배방정식(물리방정식)을 만족하도록 식에 내제되어 있는 물리 정보를 신경망에 도입하는 방법입니다.

일반적인 신경망 학습

  • -> Feature
  • x, y, z ->
  • -> u, v, w, p
  • Prediction ->
  • ⁢ – 학습데이터(feature, label) ->
  • Data loss=label error ⁢ –

물리 정보 신경망 학습

  • -> Feature
  • x, y, z ->
  • Auto Grad
  • -> u, v, w, p
  • Prediction -> (u)
  • ⁢ – Random
  • PDE loss=Physics error ⁢ –

[그림 2] 일반적인 신경망과 물리 정보 신경망의 학습 방법

일반적인 신경망은 학습 데이터만을 사용하여 학습하며 손실 함수는 원본 데이터와 학습 모델에서 예측한 데이터에서의 레이블의 불일치 정도를 최소화하도록 학습하는 반면, 물리 정보 신경망은 물리 방정식 자체를 손실 함수에 사용하여 샘플링한 데이터가 물리 법칙을 만족하도록 학습을 진행합니다.

전통적인 시뮬레이션 방법은 도메인을 작은 요소로 나누어 각각에 대해서 계산합니다. 이 과정에서 도메인을 작은 요소로 나누는 Meshing 기법을 사용하지만 물리 정보 신경망을 사용하면 데이터를 단지 샘플링만 하기 때문에 도메인을 작은 요소로 나누는 등 추가적인 계산이 필요 없어지게 되는 장점이 있습니다. 실제 시뮬레이션은 학습(Train)을 진행한 후 추론(Inference)을 통하여 진행하게 됩니다. 이 과정에서 물리적인 법칙을 만족하는 신경망을 찾았기 때문에 물리 법칙을 만족하는 시뮬레이션이 가능하게 됩니다. 학습에 비해 추론하는 시간은 매우 작기 때문에 시뮬레이션하려는 도메인에 대해 한 번 학습을 진행하면 추론을 통한 반복 시뮬레이션을 매우 빠른 시간에 할 수 있다는 장점이 있습니다.

이러한 장점에도 불구하고 현재 물리 정보 신경망은 학습의 수렴성 문제, 전통적인 시뮬레이션 방법에 비하면 아직은 높지 않은 정확도 등의 단점이 존재하여 최근에는 전통적인 시뮬레이션 방법과 물리 정보 신경망을 이용한 방법을 합친 하이브리드 시뮬레이션에 대한 연구가 시작되고 있습니다.

하이브리드 시뮬레이션

하이브리드 시뮬레이션이란 전통적인 시뮬레이션과 물리 정보 신경망을 이용한 시뮬레이션을 혼합한 방법입니다. 혼합하는 방법에 따라 크게 두 가지 방법이 존재하며 먼저 전통적인 시뮬레이션 방법에 계산시간이 큰 부분을 신경망으로 대체하는 방법에 대해 살펴보겠습니다.

  • old velocity v(t)
  • convolutional neural network ->

convective flux ∮ij / ×d2

  • filter constraints ->uij interpolation / uij interpolation ->
  • x ->

External forcing F(t) ->

  • divergence ->
  • explict timestep ->
  • pressure projection ->
  • New velocity v(t + △t)

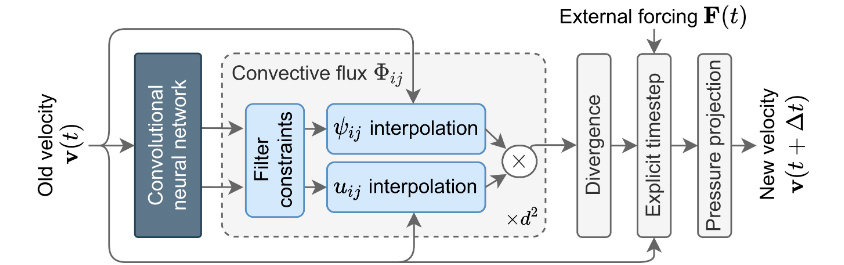
[그림 3] 시간이 많이 걸리는 계산을 물리 정보 신경망으로 대체[1]

전통적인 방법이 물리 정보 신경망에 비해 정확도가 높기 때문에 전체적인 프레임워크는 전통적인 수치해석 방법으로 진행하나 시간이 많이 걸리는 계산을 신경망으로 대체하였습니다. 유체해석을 위한 Navier-Stokes 방정식을 푸는 것으로, 단일 Time Step에 대한 흐름도를 보여준 것으로 Convective Flow 계산 시 기존 Standard Numerical Solver를 Convolutional Neural Network을 사용하여 대체하였습니다. 이렇게 하였을 때 전통적인 방법에 비해 상당한 정도의 속도 향상을 이루었다고 합니다.

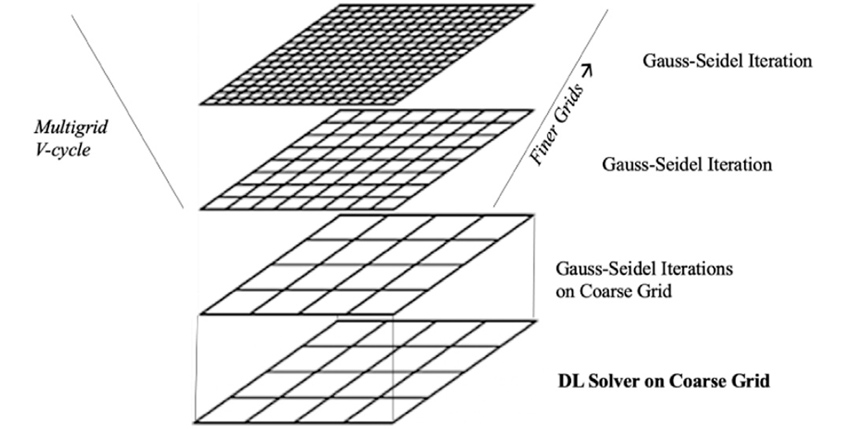
다른 한 가지 방법으로는 물리 정보 신경망의 빠른 시뮬레이션 속도를 이용하여 근사치까지 신경망으로 계산한 후 더 정확한 계산을 위해 전통적인 수치해석 방법을 사용하는 것입니다.

  • Multogrid V-cycle
  • Finer Grids->

DL Solver on Coarse Grid

  • Gauss-Seidel Iteration / Gauss-Seidel Iteration / Gauss-Seidel Iteration on Coarse Grid

[그림 4] 물리 정보 신경망으로 계산 시간을 줄인 후 전통적인 방법으로 정확도를 보정[2]

도메인의 Mesh를 크게 하여 물리 정보 신경망(Deep Learning Solver 사용)으로 시뮬레이션하여 대략적인 값을 얻은 후 더 정확한 계산을 위해 Gauss-Seidel(Standard Solver)을 사용하는 방법으로 전통적인 수치해석 기반 시뮬레이션에 비해 큰 속도 향상을 얻을 수 있습니다.

결론

최근 화두가 되고 있는 AI 기법을 도입한 물리 정보 신경망에 대해 알아보았습니다. AI의 발전에 따라 시뮬레이션 분야에서도 AI가 도입됨은 어찌 보면 당연한 처사입니다. 또한 AI를 구동할 수 있는 GPU와 같은 가속기의 발전에 따라 물리 정보 신경망은 계속해서 발전할 것으로 예상되며 빠른 시뮬레이션 속도로 인한 실시간 시뮬레이션이 가능하기 때문에 Digital Twin 등 응용 분야가 많은 것이 예상됩니다.

References
[1] Machine learning–accelerated computational fluid dynamics, D Kochkova, JA Smitha, A Alieva, Q Wanga, MP Brenner, and S Hoyera, Proceedings of the National Academy of Sciences, 2021
[2] The Old and the New: Can Physics-Informed Deep-Learning Replace Traditional Linear Solvers?, S Markidis, Frontiers in Big Data, 2021

[출처] https://www.samsungsds.com/kr/insights/physics_informed_neural_network.html

문기효
문기효 인공지능/애널리틱스 전문가

삼성SDS 고성능컴퓨팅연구Lab

슈퍼컴퓨터를 이용한 수치해석 분야를 연구하여 박사학위를 취득하였습니다. LLM 추론 및 HPC 시뮬레이션 가속을 연구하고 있으며 양자 컴퓨팅 등 미래 컴퓨팅 기술에 관심이 많습니다.

Loading

30 7월 2024

[인공지능 기술] ‘집컴’으로 실행한 일기예보 AI, 슈퍼컴 이겼다

[인공지능 기술] ‘집컴’으로 실행한 일기예보 AI, 슈퍼컴 이겼다

‘집컴’으로 실행한 일기예보 AI, 슈퍼컴 이겼다

입력
“허리케인 경로 정확히 예측”

8일(현지시간) 허리케인 베릴이 휩쓸고 간 미국 텍사스 베이시티의 한 집 앞에 나무가 뿌리채 뽑혀 쓰러져 있다. AP/연합뉴스 제공

8일(현지시간) 허리케인 베릴이 휩쓸고 간 미국 텍사스 베이시티의 한 집 앞에 나무가 뿌리채 뽑혀 쓰러져 있다. AP/연합뉴스 제공

일반 가정용 컴퓨터나 노트북 수준의 사양으로 실행할 수 있는 인공지능(AI) 프로그램이 슈퍼컴퓨터보다 허리케인 경로를 정확히 예측해 화제다.

미국 뉴욕타임스(NYT)는 29일(현지시간) 보도를 통해 7월 초 미국을 강타한 허리케인 ‘베릴’의 경로를 예측한 AI와 슈퍼컴퓨터를 비교하며 미래 기상예보에서 AI의 역할에 대해 조명했다.

7월 초 유럽 중기기상예보센터(ECMWF)와 미국 국립허리케인센터는 허리케인 베릴의 최종 상륙 위치가 멕시코 부근일 가능성이 가장 높을 것이라고 예측했다. 비행기, 부표, 우주선 등을 통해 모은 전 세계 관측 자료를 바탕으로 거대 슈퍼컴퓨터의 계산을 통해 만든 예보였다.

같은 시기 구글 딥마인드가 만든 일기예보 AI인 그래프캐스트(GraphCast)는 베릴이 텍사스에 상륙할 것으로 예측했다. 기상기관의 슈퍼컴퓨터보다 훨씬 작은 컴퓨터에서 구동된 AI 프로그램은 지구 대기에 대해 학습한 내용만을 바탕으로 예보했다.

7월 8일 베릴은 텍사스를 강타해 최소 36명이 사망하고 수백만 명의 주민들이 정전 피해를 입었다. AI 프로그램이 거대 슈퍼컴퓨터보다 더 정확하게 허리케인의 경로를 예측한 것이다.

지구의 날씨는 여러 가지 요인이 복합적으로 작용해 예측이 매우 어렵다. 지구 기울기, 흔들림, 바람, 비, 구름, 기온과 기압 등 변수가 많아 앞으로의 날씨를 예측하기 위해 거대한 크기의 슈퍼컴퓨터의 계산 능력이 필요하다. 그럼에도 일기예보는 며칠 후나 몇 시간 뒤 날씨 예측에 실패할 정도로 쉽지 않은 영역이다.

인간의 학습 방식을 모방하는 AI는 특히 ‘패턴 인식’에 강점을 보인다. 측정값과 예측값의 수많은 계산을 수행하는 대신 복잡한 데이터 속에서 인간이 식별하기 어려운 패턴을 찾아내 빠르게 날씨를 예측하는 것이다.

그래프캐스트 연구팀의 수석 과학자인 레미 램은 뉴욕타임스에 “유럽 예보 센터에서 수집한 40년간의 전 세계 기상 관측 자료를 바탕으로 AI를 훈련시켰다”며 “슈퍼컴퓨터에서 한 시간 이상 걸리는 10일 예보를 단 몇 초 만에 만들어낼 수 있다”고 말했다.

그는 “그래프캐스트는 AI용으로 설계된 컴퓨터에서 가장 잘 작동하지만 일반 데스크톱 컴퓨터나 노트북에서도 작동할 수 있다”고 덧붙였다. 예보를 생성하는 데 더 이상 거대 슈퍼컴퓨터가 필요하지 않을 수도 있다는 뜻이다.

AI는 허리케인 진로를 성공적으로 예측했지만 해일이나 바람 등 다른 기상 요소도 정확히 예측하려면 아직 발전이 더 필요하다는 분석이다.

각국 기상 전문가들은 AI 시스템이 슈퍼컴퓨터의 접근방식을 보완할 수 있을 것으로 보고 적극적인 움직임을 보이고 있다. 유럽 ECMWF는 그래프캐스트뿐 아니라 미국 엔비디아, 중국 화웨이 등 IT 기업에서 만든 AI 예측 프로그램도 도입하는 것으로 알려졌다. 미국 국립허리케인센터도 새로운 AI 프로그램을 평가해 활용할 수 있을 것이라는 입장을 밝혔다.

Loading

23 7월 2024

[알아봅시다] 뉴욕 타임스퀘어도 꺼졌다…초연결 시대 ‘IT대란 반복’의 서막

[알아봅시다] 뉴욕 타임스퀘어도 꺼졌다…초연결 시대 ‘IT대란 반복’의 서막

뉴욕 타임스퀘어도 꺼졌다…초연결 시대 ‘IT대란 반복’의 서막

입력
초연결 사회가 심화되면서 IT 대란이 반복될 위험이 높아졌다. Thapana Onphalai/게티이미지뱅크 제공.

초연결 사회가 심화되면서 IT 대란이 반복될 위험이 높아졌다. Thapana Onphalai/게티이미지뱅크 제공.

지난 19일 전 세계 전산망 시스템이 동시다발적으로 ‘먹통’됐다. 전 세계가 인터넷으로 연결되는 ‘초연결 사회’인 오늘날 이번 사태는 지속 반복될 것이라는 게 전문가들의 공통적인 지적이다. 실효성 있는 대책이 강구돼야 한다는 목소리다.

이번 ‘IT 대란’으로 항공기 4만대의 운항이 지연되고 주요 은행과 증권거래소, 방송국 등은 서비스에 차질을 빚었다. 화려한 불빛으로 가득한 미국 뉴욕 타임스퀘어는 전광판이 꺼졌고 생명을 다루는 병원에서는 수술이 취소되는 등 우려스러운 상황이 벌어졌다. 국내에서는 10개 기업이 피해를 입었고 정부는 사이버 공격 등에 대비하는 긴급 조치에 나섰다.

이번 사태는 마이크로소프트 윈도와 보안업체 크라우드스트라이트의 보안 패치 충돌로 일어난 것으로 파악되고 있다. 윈도 시스템이 정상 종료되지 않으면서 전산망 마비가 일어났다.

KT, 네이버 클라우드 등 주요통신사업자 26곳은 이번 IT 대란의 영향을 받지 않은 것으로 전해진다. 하지만 지난 2022년 SK C&C 판교 클라우드 데이터센터 화재 사건에서 카카오 서비스가 중단된 것처럼 주요통신사업자 또한 언제든 피해를 입을 수 있다.

● 소프트웨어 상호작용 심화…피해 규모 점점 커질 것

이번 IT 대란은 온라인에 대한 높은 의존도가 한 국가를 넘어 전 세계적으로 통신 마비를 일으키고 혼란을 일으킬 수 있다는 점을 보여줬다. 앞으로 이와 유사한 사고가 더욱 큰 규모로 발생할 수 있다.

강동호 한국전자통신연구원(ETRI) 사이버보안연구본부 차세대시스템보안연구실 실장은 “오늘날 소프트웨어는 오픈소스, 외부소프트웨어 등 상호의존성이 심화됨에 따라 점점 더 복잡해지고 있다”며 “다양한 소프트웨어가 서로 상호작용하면서 예기치 않은 충돌이나 버그가 발생할 가능성이 높다”고 말했다.

이어 “특히 보안 패치나 업데이트는 시스템 핵심 기능에 영향을 미칠 수 있기 때문에 충돌 위험이 늘 존재한다”며 “피해 규모는 점점 증가할 것으로 예상된다”고 덧붙였다.

소프트웨어 충돌 위험은 물론 사이버 공격, 프라이버시 침해 등의 위험도 존재한다. 강 실장은 “기업 대상 데이터 유출, 랜섬웨어 공격 증가, 국가 기반 시설에 대한 공급망 보안 위협, 클라우드 서비스에 대한 공격 등 사이버 위협이 예상된다”며 “또 AI 의존성 증가 및 과도한 권한 부여에 대한 대응 능력 부재, 의사결정의 편향성으로 인한 문제가 확대될 것으로 보인다”고 설명했다.

● 美 보안 강화 행정명령 시행…국내도 실효성 있는 지침 필요

디지털 기술과 인터넷의 영향으로 세계가 긴밀히 연결되는 초연결·초지능 사회에서는 사이버 보안 위협이 확대되고 기술적 장애, 프라이버시 침해 등의 문제가 발생할 것으로 예상되는 만큼 향후 또 다시 발생할 IT 대란에 미리 대비해야 한다는 목소리가 커지고 있다.

2020년 미국 정부는 러시아 해커 조직이 소프트웨어 개발사인 솔라윈즈 네트워크에 침입해 고객사 1만8000여곳에 제공하는 소프트웨어에 백도어를 심었다는 사실을 발견했다. 이 사건으로 미국 법무부, 국방성, 국토안보부, 재무부 등 연방 정부 기관 최소 9곳과 MS, 맨디언트, 인텔, 시스코, 팔로 알토 네트워크스 등 빅테크 기업이 피해를 입었다.

조 바이든 당시 미국 대통령은 정보시스템 보안을 강화하는 ‘행정명령 14028’을 시행했다. 연방 정부의 사이버 보안을 강화하고 소프트웨어 공급망 보안을 개선해 정부의 정보시스템을 보호한다는 목표다.

국내에서도 이처럼 실질적 효과를 낼 수 있는 조치가 필요하다는 게 전문가 설명이다. 강 실장은 “한국 정부도 공급망 보안 가이드라인을 제시하고 있지만 실효성 있는 규제 지침으로 확대하는 노력이 필요하다”고 말했다.

이어 “기업 차원에서는 보안 운영 센터(SOC)를 구축해 실시간으로 보안 패치와 관련된 문제를 모니터링해야 한다”며 “정기적인 보안 점검을 통해 패치 적용 상태와 호환성을 확인하고 장애에 신속한 복구 조치 등을 취할 수 있는 보안 관리 체계를 시급히 구축해야 할 것”이라고 설명했다.

Loading

9 7월 2024

[인공지능 기술] GPU 추가 없이 메모리 확장, 대규모 AI 활용 성능 2배 ‘업’

[인공지능 기술] GPU 추가 없이 메모리 확장, 대규모 AI 활용 성능 2배 ‘업’

GPU 추가 없이 메모리 확장, 대규모 AI 활용 성능 2배 ‘업’

입력
KAIST 연구진

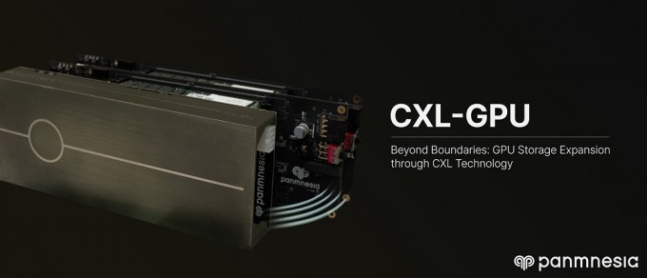
컴퓨트 익스프레스 링크(CXL, Compute Express Link) 기술은 GPU를 추가하지 않고도 GPU 메모리를 확장할 수 있는 기술이다. KAIST 제공

컴퓨트 익스프레스 링크(CXL, Compute Express Link) 기술은 GPU를 추가하지 않고도 GPU 메모리를 확장할 수 있는 기술이다. KAIST 제공

국내 연구팀이 인공지능(AI) 기술 구현의 핵심인 그래픽처리장치(GPU)의 메모리 확장 기술을 개선해 성능을 끌어올렸다.

KAIST는 정명수 전기및전자공학부 교수팀이 차세대 인터페이스 기술인 ‘컴퓨트 익스프레스 링크(CXL, Compute Express Link)’가 활성화된 고용량 GPU의 메모리 읽기·쓰기 성능을 최적화하는 기술을 개발했다고 8일 밝혔다. 연구결과는 7월 미국 유즈닉스(USENIX) 연합 학회와 핫스토리지 연구 발표장에서 선보일 예정이다.

최신 대규모 언어모델(LLM)은 추론·학습에 수십 테라바이트(TB, 1TB는 1024GB)의 메모리가 필요하다. 단일 GPU의 내부 메모리 용량은 수십 기가바이트(GB) 수준이라 단독으로 언어 모델을 활용하는 것은 불가능하다. 일반적으로 GPU 여러 개를 연결하는 방식을 사용하지만 최신 GPU의 높은 가격이 걸림돌이다.

대용량 메모리 장치를 GPU에 연결해 메모리 크기를 확장하는 ‘CXL-GPU’ 구조가 산업계에서 주목받고 있다. 메모리 용량을 늘리기 위해 값비싼 GPU를 추가로 구매할 필요가 없기 때문이다. 하지만 GPU에 연결된 메모리 확장 장치의 읽기·쓰기 속도가 GPU 내부 메모리와 비슷한 수준으로 구현돼야 대규모 AI 서비스에 활용될 수 있다.

연구팀은 CXL-GPU의 메모리 읽기·쓰기 성능이 저하되는 원인을 분석하고 이를 개선했다. 확장된 메모리의 쓰기 작업 완료 여부를 기다리지 않고도 동시에 GPU 내부 메모리에도 쓰기 작업을 할 수 있도록 해 쓰기 성능을 개선한 것이다. 읽기 작업에서도 확장된 메모리 장치에서 필요한 읽기 작업을 미리 수행할 수 있도록 해 읽기 성능을 향상시켰다.

국내 반도체 팹리스 스타트업인 파네시아(Panmnesia)의 CXL-GPU 프로토타입을 활용해 성능을 검증한 결과 기존 GPU 메모리 확장 기술보다 AI 서비스를 2.36배 빠르게 실행할 수 있는 것으로 나타났다.

정명수 교수는 “CXL-GPU 시장 개화 시기를 앞당겨 대규모 AI 서비스를 운영하는 기업의 메모리 확장 비용을 획기적으로 낮추는 데 기여할 것”이라고 밝혔다.

Loading

30 6월 2024

[인공지능 기술][chatGPT] GPTs 사용법 – 챗GPT로 5분만에 나만의 챗봇 만드는 방법

[인공지능 기술][chatGPT] GPTs 사용법 – 챗GPT로 5분만에 나만의 챗봇 만드는 방법

1700487586600-230208_main.png
아티클

GPTs 사용법 – 챗GPT로 5분만에 나만의 챗봇 만드는 방법

조회수 27921·3분 분량

2023. 11. 20.

챗GPT로 만드는 나만의 챗봇, GPTs의 등장

이제 챗GPT를 활용해서, 누구나 자기만의 챗봇을 만들 수 있습니다. 11월 6일 오픈AI 개발자 회의에서 공개된 GPTs라는 기능 덕분이죠. GPTs 코딩 없이 대화만으로 만드는 맞춤형 챗봇입니다. 아래의 대화는 오픈AI 개발자 회의의 GPTs 시연을 옮겨온 것입니다.

????(GPT Builder) : 어떤 챗봇을 만들고 싶으신가요?

????‍????(샘 알트만) : 스타트업 창업자가 사업 아이디어를 생각하고 조언을 구할 수 있도록 돕고 싶어.

???? : 챗봇 이름으로 ‘스타트업 멘토’는 어떤가요?

????‍???? : 좋아. [스타트업에 대한 강의 녹취록 업로드]

????‍???? : 이 녹취록을 바탕으로 조언을 해줘. 단, 조언은 간결적이고 건설적으로 해줘.

[창업자를 위한 챗봇 완성]

정말 간단해 보이지 않나요? 순식간에 창업을 준비하는 사람에게 조언을 해 주는 챗봇이 완성됐죠. 하지만 사용 방법이 아무리 간단하더라도 ‘처음’은 언제나 낯설죠. 그래서 준비했습니다. GPTs의 기본적인 사용 방법을 친절하게 알려드리겠습니다.

GPTs

GPTs 사용법

참고로 현재는 챗GPT 플러스 또는 엔터프라이즈 서비스를 구독하는 유료 사용자만 GPTs의 베타 버전을 사용할 수 있습니다.(11월 20일 기준)  

1. 로그인 

 ChatGPT에 접속한 뒤 로그인하세요. 그리고 좌측 상단 Explore 메뉴를 클릭합니다.

챗GPT 로그인

2. GPT 생성하기 

 My GPTs 카테고리에서 ‘Creat a GPT(GPT 생성하기)’를 클릭해 GPT 빌더를 켭니다

GPTs 켜기

3. GPT 빌더 입력하기

Configure(설정)를 클릭해 주세요. 왼쪽의 Create 버튼은 대화를 하며 챗봇을 생성하는 기능입니다. 아직 Create 기능은 아직 미숙하다는 의견이 대세입니다.

GPTs Configure

4. GPT 이름, 프로필 이미지 설정하기

적절한 이름을 입력하세요. 이미지는 직접 파일을 업로드 하거나 아래처럼 DALL·E를 이용해 이름에 어울리는 이미지를 생성할 수 있습니다.

GPTs 이름, 이미지 생성

DALL·E 사용하기를 클릭하자 아래처럼 이름에 어울리는 이미지가 생성됐습니다.

GPTs 이미지 생성

※ 참고로 ‘Create’ 기능을 이용해 GPT 이름과 이미지를 추천받을 수도 있습니다.

GPTs Create

저는 GPT Builder의 추천 대신, 제가 직접 지은 이름을 사용하기로 했습니다.

GPTs create 이미지

5. GPT의 세부사항 입력

Configure의 각 항목을 입력해주세요. 한글보다는 영어를 입력했을 때 훨씬 수월하게 세팅이 가능합니다. 필자는 DeepL로 한글을 영어로 번역해 사용했습니다.

GPTs Configure 입력

저는 각 내용을 아래와 같이 입력했습니다. 참고로 규칙을 입력할 때는 만들고자 하는 GPT의 역할과 가이드라인, 제약사항 등을 자세하게 입력하는 것이 좋습니다.

예시)
① 간단한 설명 : 이 GPT는 사용자가 입력한 키워드와 관련된 개발자를 찾는 챗봇입니다. 
② 규칙 :이 챗봇의 사용자들은 단어를 입력해야 해. 단어가 한 번에 이해되지 않으면 이해될 때까지 사용자에게 물어봐줘. 그리고 챗봇은 사용자에게 다음의 조건을 만족하는 답변을 해주면 돼.
(1) 입력받은 단어와 관련된 가장 유명한 사람을 선택해줘. 예를 들어 사용자가 챗봇에 Java를 입력하면 자바를 최초 개발한 제임스 고슬링을 출력하는 거야. 
(2) 개발자 이름뿐만 아니라, 그에 관한 설명도 함께 출력해줘. 
(3) (2)는 업로드한 파일의 형식처럼 작성해줘. 
③ 시작 대화 : 어떤 단어와 관련된 개발자를 찾고 있나요? 
④ 파일 업로드 : 글의 흐름 방향을 알 수 있도록 사람이 직접 작성한 파일 첨부.    

6. 저장하기

오른쪽 상단의 ‘Save’ 버튼을 눌러 저장합니다. 이때 GPT의 접근 권한을 설정할 수 있습니다. 오직 나만 사용할 수 있는 설정(only me)과 링크가 있는 사람이 사용할 수 있는 설정(only people with a link)과 모든 사람이 사용할 수 있는 설정(public) 중에 선택할 수 있습니다.

GPTs Save

7. 사용하기

저장하면 왼쪽 탭에 생성된 GPT가 나타납니다. 이제 언제나 생성한 GPT를 클릭해 사용할 수 있습니다. 예시로 만든 Dev.Dictionary를 실행시켜, ‘Super mario’를 입력했습니다. 그 결과, Super mario를 만든 게임 개발자 ‘사토루 이와타’에 관한 설명이 나왔습니다. 답변은 GPT 제작 당시 업로드 한 파일의 형식처럼 작성됐네요.

Gpts 사용


이렇게 GPTs를 활용해서 챗봇을 만들어보았습니다. 어때요? 정말 간단하지 않나요?

새로운 기술이 등장했다는 것은 새로운 기회가 생겼다는 이야기이기도 하죠.(오픈 AI는 GPTs로 만든 챗봇을 거래할 수 있는 생태계를 조성하겠다는 계획도 밝혔습니다.) 오늘은 GPTs로 나만의 챗봇을 만들어보며 활용법을 고민해보면 어떨까요. 때로는 도구에서부터 근사한 아이디어가 떠오르기도 하는 법이니까요.

[출처] https://spartacodingclub.kr/blog/how-to-use-gpts

Loading

9 6월 2024

[알아봅시다] [테크토크]클라우드 느려터져서 택배로 데이터 받아요

[알아봅시다] [테크토크]클라우드 느려터져서 택배로 데이터 받아요

[테크토크]클라우드 느려터져서 택배로 데이터 받아요

입력 
수정2024.06.02. 오후 2:01
거대 데이터, 클라우드로도 한참 걸려
가끔은 ‘택배’로 배송하는 게 더 빨라
이상한 말처럼 들릴 수 있지만, 글로벌 클라우드 1위 아마존웹서비스(AWS)의 핵심 비즈니스가 바로 ‘데이터 택배’입니다. 말 그대로 컴퓨터 데이터를 포장해 고객의 집 앞에 배송하는 사업입니다. 이메일 열람부터 영화 스트리밍까지 클라우드로 해결되는 초연결 시대에 왜 이런 번거로운 사업이 남아 있을까요.

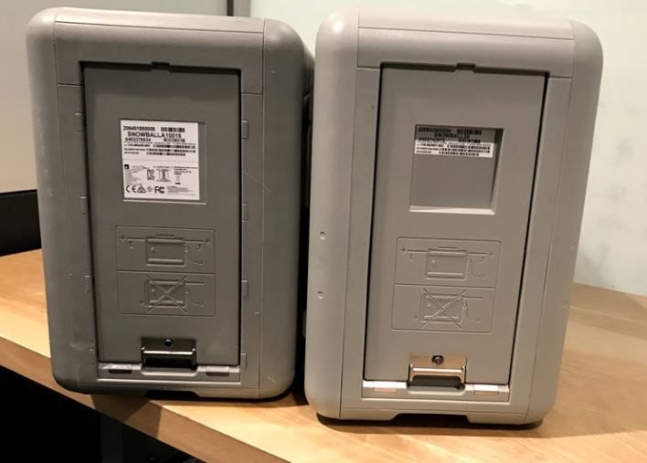
데이터 택배 상자, 아마존 스노우볼

데이터를 옮기는 택배상자, 아마존 AWS 스노우볼 [이미지출처=AWS 홈페이지 캡처]

데이터를 옮기는 택배상자, 아마존 AWS 스노우볼 [이미지출처=AWS 홈페이지 캡처]

아마존은 2016년 ‘스노우볼(Snowball)’이라는 엣지형 컴퓨터 서버를 만들었습니다. 스노우볼은 특수 케이스로 안전하게 보호한 소형 데이터센터입니다. 일반적인 AWS 데이터센터에 탑재되는 CPU, 메모리 장치는 모두 탑재됐고, 기능도 동일합니다. 단지 20㎏ 남짓한 작은 케이스 수준으로 크기를 줄였을 뿐입니다.

스노우볼의 목적은 단 하나입니다. ‘물리적으로’ 고객의 컴퓨터와 클라우드를 잇는 겁니다. 일단 주문을 받으면 아마존은 스노우볼을 4~6일 안에 고객에게 배송합니다. 고객은 전원을 켜서 자기 컴퓨터와 스노우볼을 랜(LAN)으로 연결한 뒤, 컴퓨터의 데이터를 스노우볼에 옮겨 담습니다. 그 후 아마존 직원이 스노우볼을 다시 가져와 AWS 데이터센터에 옮기는 겁니다.

때로는 통신보다 택배원이 더 빠르다

클라우드를 이용할 수 있는데, 상자 크기 서버를 주고받으며 데이터를 옮긴다? 얼핏 들으면 이해가 안 될 겁니다. 마치 이메일을 인터넷으로 전송하는 대신 프린터기로 복사해서 우체국에 보내는 격이니까요.

하지만 스노우볼이 탄생한 데엔 이유가 있습니다. 구글 클라우드 등을 이용해 봤다면 수십기가바이트(GB)짜리 대용량 데이터를 옮기거나 다운로드받을 때 어느 정도 시간이 걸린다는 걸 알 겁니다.

페타바이트 규모 데이터는 현대 통신 기술로도 감당하기 힘들다. [이미지출처=픽사베이]

페타바이트 규모 데이터는 현대 통신 기술로도 감당하기 힘들다. [이미지출처=픽사베이]

그러나 기업들의 상황은 다릅니다. 테라바이트(TB, 1TB는 약 1000GB) 규모나 페타바이트(PB, 약 1000TB) 단위 데이터를 옮겨야 하는 일이 심심찮게 벌어집니다. 내 컴퓨터에서 네트워크를 거쳐 데이터센터로 파일이 전송되기까지 네트워크 환경에 따라 대략 2~3주일에서 수개월 넘게 걸릴 수도 있습니다.

데이터가 너무 커서 생기는 클라우드 상의 병목(Bottleneck)은 데이터 중심 기업들이 흔히 직면하는 문제입니다. 8~12K 해상도 영상으로 작업하는 할리우드 영화계나, 초고해상도 이미지를 전송하는 천문학 연구소, 은행 등이 대표적인 사례입니다.

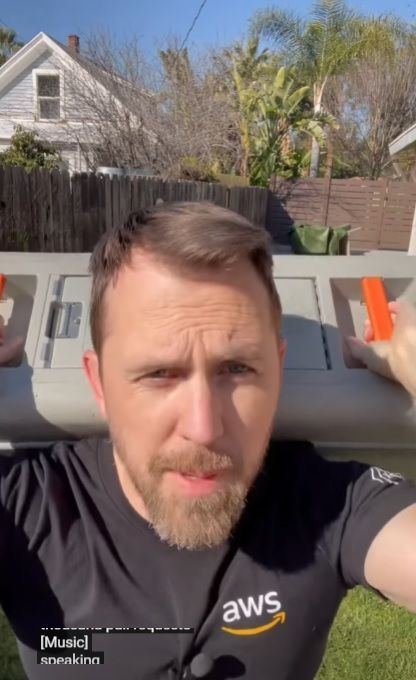
스노우볼에 거대 데이터를 저장한 뒤 직접 사람이 들어 옮긴다. [이미지출처=유튜브]

스노우볼에 거대 데이터를 저장한 뒤 직접 사람이 들어 옮긴다. [이미지출처=유튜브]

이 문제를 어떻게 해결할까요. 의외로 방법은 간단합니다. 초대형 데이터를 받아다가 클라우드로 가져갈 임시 데이터센터를 만드는 겁니다. 그게 바로 스노우볼이었습니다. 아마존은 이미 전 세계 어디에든 물류 거점을 두고 있습니다. 인터넷 케이블이 한 달 동안 데이터를 소화하려고 애를 쓰고 있는 사이 스노우볼을 든 택배원은 1주일 안에 데이터 전송 작업을 마무리할 수 있습니다.

클라우드론 10년 걸릴 작업도 6개월로 단축

하지만 물리적으로 데이터를 옮기는 건 너무 위험하지 않을까요? 오히려 더 안전할 수도 있습니다. 스노우볼 서버를 감싼 특수 케이스는 최첨단 소재 공학을 동원했으며, 심지어 미 공군의 수송기에서 낙하산에 매달아 떨어뜨려도 끄떡없을 정도입니다. 덕분에 스노우볼은 군대, 재난 지역 등에서도 애용됩니다.

컨테이너형 데이터센터 이동수단인 '스노모빌' [이미지출처=AWS]

컨테이너형 데이터센터 이동수단인 ‘스노모빌’ [이미지출처=AWS]

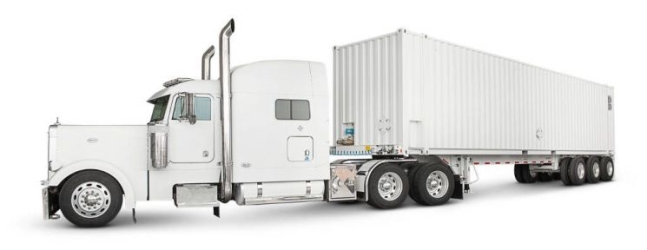
스노우볼 1100여개를 연결한 ‘스노모빌(Snowmobile)’이라는 컨테이너형 데이터센터도 있습니다. 이 데이터센터는 대형 트럭이 운송합니다. AWS가 스노모빌을 고안한 건 과거 ‘디지털 글로브’라는 인공위성 사진 기업의 의뢰 때문이었다고 합니다.

디지털 글로브는 100PB 규모 사진 자료를 보유하고 있었는데, 이를 AWS로 전부 옮기려면 무려 10년이 소요될 예정이었습니다. 대신 스노모빌을 이용해 ‘물리적’으로 운송하자, 기간은 6개월로 대폭 줄어들었다고 합니다.

초연결 시대에도 네트워크 한계는 여전

스노우볼은 디지털 시대에도 ‘통신’이라는 개념이 얼마나 어려운 건지 보여주는 사례입니다. 때로는 첨단 통신망보다 단순한 택배 트럭이 훨씬 빠를 때도 있으니까요.

물론 오프라인 데이터 전송 시스템은 점차 과거의 유산이 될 겁니다. AWS는 지난달 스노모빌 서비스를 단계적으로 종료하겠다고 밝힌 바 있습니다. 최신 데이터 전송 기술이 보편화하면서 더는 컨테이너 규모의 데이터센터를 옮길 필요는 없어졌기 때문입니다. 언젠가 PB 단위 데이터를 빠르게 옮길 수 있는 통신망이 전 세계에 갖춰진다면, 스노우볼도 차차 사라지게 되겠지요.

[출처] https://n.news.naver.com/mnews/hotissue/article/277/0005426533?type=series&cid=2001402

Loading

28 5월 2024

[인공지능 기술] 인공지능 ‘블랙박스’ 풀리나

[인공지능 기술] 인공지능 ‘블랙박스’ 풀리나

인공지능 ‘블랙박스’ 풀리나

기자이희욱
  • 수정 2024-05-27 09:32
  • 등록 2024-05-27 09:00
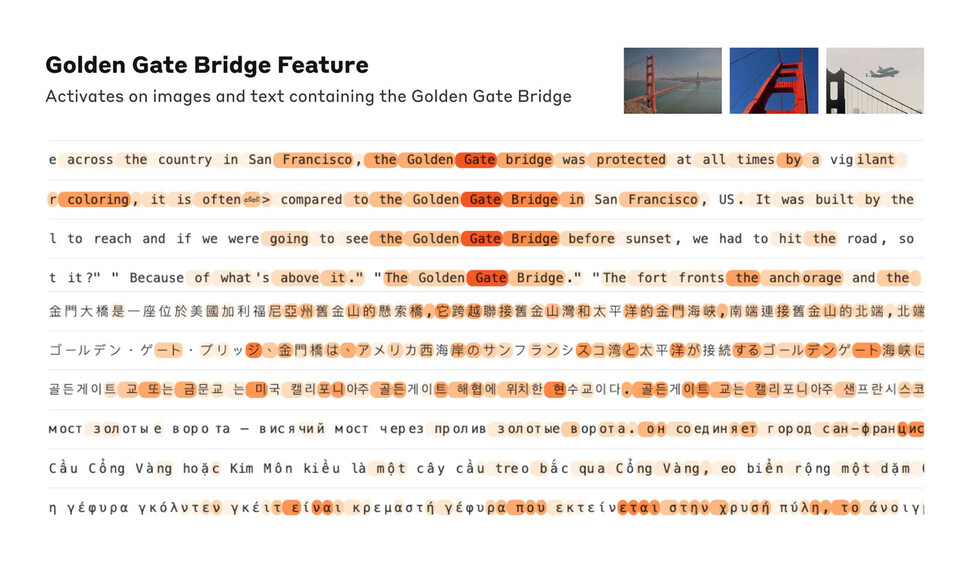
‘금문교’를 입력했더니 여러 언어에 걸쳐 연관성 높은 단어들이 활성화됐다. 주황색 부분은 해당 기능이 활성화된 단어나 단어 일부이다. 앤스로픽

인공지능 챗봇의 두뇌는 거대언어모델이다. 거대언어모델은 ‘블랙박스’와 같다. 우린 아직 그 작동 원리를 명확히 밝혀내지 못했다. 이런 인식의 배경엔 두려움이 똬리틀고 있다. 어느날 인공지능이 인간의 지시 없이 핵폭탄 발사 단추를 누른다면? 인간 통제를 벗어난 영화 속 ‘스카이넷’이 언제 현실이 될지 알 수 없다.

인공지능 스타트업 앤스로픽이 이런 두려움에 제동을 거는 소식을 전했다. 앤스로픽은 최근 ‘클로드3 소네트’의 내부를 상세히 분석한 연구 결과를 발표했다. 클로드3 소네트는 앤스로픽이 올해 3월 공개한 거대언어모델로, 매개변수가 700억개에 이른다. 작은 표본 모델을 대상으로 작동 원리를 들여다본 실험은 있었지만, 이 정도 큰 언어모델의 내부 작동 원리를 규명한 건 생성 인공지능 등장 이후 처음이다.

인공지능 모델 내부는 사람의 뇌와 비슷한 방식으로 작동한다. 뇌에서 뉴런이 신호를 주고받아 정보를 처리하듯, 인공지능 모델도 수많은 인공 뉴런이 정보를 주고받으며 작동한다. 인공지능이 질문에 답하기 전에 ‘생각하는’ 과정은 이 뉴런들의 활동이다. 인공 뉴런은 사람이 생각하는 개념을 여러 뉴런에 걸쳐 표현한다. 우리가 ‘사과’란 단어를 생각할 때 여러 뇌세포가 동시에 활성화되는 것과 비슷하다. 하지만 인공지능의 뉴런 활동은 숫자 목록으로 표현되기에, 겉보기엔 복잡하고 이해하기 어렵다.

연구진은 이런 뉴런 활성화 패턴을 분석해 인간이 이해할 수 있는 개념과 일치시키는 작업을 진행했다. 샌프란시스코, 로잘린드 프랭클린, 리튬 원소, 면역학, 개발 코드 등 다양한 개념을 넣어 인공지능 뉴런이 어떤 식으로 활성화되는지 살폈다. 그랬더니 인공지능이 어떤 개념을 어떻게 표현하는지 드러났다.

인공지능은 한 개념을 떠올릴 때 연관 단어 사이의 ‘거리’를 측정했다. ‘금문교’ 단어와 근처엔 알카트라즈 섬, 기라델리 스퀘어, 골든 스테이트 워리어스, 캘리포니아 주지사 개빈 뉴섬, 1906년 지진, 알프레드 히치콕의 영화 ‘현기증’이 자리잡고 있는 식이다. 지금까진 인공지능이 수백억 개 뉴런 속 어딘가에서 의미들을 가져와 질문에 대답하는 건 알았지만, 구체적으로 어디서 무엇을 가져오는지는 몰랐다. 이번 실험은 인공지능이 의미를 수집해 오는 뉴런의 연결 경로를 알아냈다.

작동 방식을 이해하면 조작도 가능하다. ‘금문교’란 특성을 증폭했더니 클로드는 ‘너는 누구야?’란 질문에 ‘나는 인공지능 챗봇입니다’ 대신 ‘나는 금문교입니다. 내 육체는 상징적인 다리 자체입니다’라고 대답했다. 이처럼 특정한 특성을 조정해 인공지능의 사고 방식과 답변을 조절할 수 있음이 실험으로 확인됐다.

조작이 가능하면 통제도 어렵잖다. 인공지능 시스템이 위험한 행동을 하는지 추적하거나, 질문에 대한 답변을 바람직한 결과로 유도하거나, 위험한 주제를 제거할 수 있다. 인공지능이 해로운 답변이나 예상치 못한 폭주를 하지 않도록 제어하는 스위치를 찾아낸 것이다.

오픈에이아이는 최근 사람의 감정을 이해하는 거대언어모델 ‘지피티-포오’(GPT-4o)를 공개했다. 하지만 그 직후 안전한 인공지능을 연구하는 사내 전담 조직을 없앴다. 안전보다 효율을 우선시한 인공지능 업체들의 발걸음을 걱정하는 목소리도 커졌다. 오픈에이아이가 “좋아, 빠르게 가”를 외치며 인공지능의 제동장치 점검을 뭉개는 동안, 앤스로픽은 블랙박스를 열어젖혔다. 이번 연구는 인공지능 모델의 심연을 탐색하는 첫걸음이다.

이희욱 미디어랩팀장 asadal@hani.co.kr

[출처] https://www.hani.co.kr/arti/economy/it/1142149.html#cb

Loading

24 5월 2024

[인공지능 기술] 메타 AI 책임자 “LLM, 인간 추론 능력 도달 못해”

[인공지능 기술] 메타 AI 책임자 “LLM, 인간 추론 능력 도달 못해”

메타 AI 책임자 “LLM, 인간 추론 능력 도달 못해”

입력
얀 르쾽 AI 수석 과학자 “논리 이해, 매우 제한적”
인간 수준 지능 AI 시스템, 10년 걸릴 듯

메타 AI 로고./로이터연합

메타 AI 로고./로이터연합
“거대언어모델(LLM)은 논리에 대한 이해가 매우 제한적이다. 물리적 세계를 이해 못할 뿐더러 지속적인 기억력이 없으며, 용어에 관한 합리적 정의를 추론할 수도, 계층적으로(hierarchically) 계획할 수도 없다.”

메타의 인공지능(AI) 책임자이자 AI 수석 과학자인 얀 르쾽은 23일(현지 시각) 파이낸셜타임스(FT) 인터뷰에서 이 같이 말하고 “LLM은 결코 인간처럼 추론하고 계획하는 능력을 달성하지 못할 것”이라고 했다.

그는 “이에 따라 기계 장치들에서 ‘초지능(superintelligence)’을 만들어 내기 위한 급진적인 방식의 대안에 집중하고 있다”고 덧붙였다.

르쾽은 AI 기술을 개척한 공로를 인정받아 2019년 컴퓨터 과학 분야의 노벨상으로 불리는 튜링상을 공동 수상했으며, 마크 저커버그 메타 최고경영자(CEO)의 핵심 고문 중 한 명이다. 르쾽은 메타의 자체 AI 연구소로 2013년에 설립된 ‘페어’(FAIR·Fundamental AI Research)에서 약 500명으로 이뤄진 팀을 이끌고 있다.

그는 “고급 LLM에 의존해 인간 수준의 지능을 만드는 것에 반대한다”면서 “이러한 모델들은 올바른 학습 데이터가 제공돼야 정확하게 응답할 수 있어 본질적으로 안전하지 않다”고 설명했다. 다만 “인간 수준의 지능을 갖춘 기계들을 구동할 완전히 새로운 세대의 AI 시스템 개발에 힘쓰고 있다”며 “이런 비전을 달성하는 데는 10년이 걸릴 수 있다”고 말했다.

그의 이번 발언은 메타와 경쟁사들이 더욱 발전된 LLM을 추진하는 가운데 나왔다. 오픈AI의 샘 올트먼 CEO 등은 범용인공지능(AGI·사람과 유사한 수준 또는 그 이상의 지능을 갖춘 AI)을 만드는데 LLM들이 중요한 단계를 제공할 것으로 믿고 있다. 메타는 마이크로소프트(MS)가 지원하는 오픈AI, 구글을 포함하는 경쟁사들을 따라잡기 위해 자체 LLM 개발에 수십억 달러를 쏟아붓고 있는 상황이다.

Loading