11 11월 2024

[인공지능 기술] “GPT 성능 향상 속도 둔화”…오픈AI, ‘오라이온’ 개선 위해 전략 수정

[인공지능 기술] “GPT 성능 향상 속도 둔화”…오픈AI, ‘오라이온’ 개선 위해 전략 수정
“GPT 성능 향상 속도 둔화”…오픈AI, ‘오라이온’ 개선 위해 전략 수정

  • 기자명 임대준 기자 
  •  
  •  입력 2024.11.10 19:30
  •  
  •  수정 2024.11.10 19:34

01. 165134_179275_4531.jpg

(사진=셔터스톡)
오픈 AI가 내년 초 출시할 차세대 인공지능(AI) 모델 ‘오라이온’의 성능을 끌어 올리기 위해 안간힘을 쓰고 있다는 소식이 전해졌다. 목표는 기존 ‘GPT-4’보다 월등한 성능을 선보이는 것이만, 큰 차이를 내는 것이 어려워지고 있다는 설명이다.

디 인포메이션은 9일(현지시간) “오픈AI가 GPT 모델 개선 속도 둔화에 따라 전략을 변경했다”라고 소개했다. 여기에서 말하는 전략이란 이전처럼 사전 훈련으로 모델 성능을 대폭 끌어올리는 것보다, 사후 강화학습이나 추론 기능 강화에 초점을 맞춘다는 내용이다. 

소식통에 따르면 샘 알트먼 오픈AI CEO는 오라이온이 훈련 과정의 20%만 완료했지만, 지능과 작업 수행 능력은 이미 GPT-4와 동등하다고 말했다. 또 현재는 오라이온의 안전성을 테스트 중으로, 내년 초 출시가 유력한 것으로 알려졌다.

특히 오픈AI는 이번 모델을 기존 GPT 시리즈가 아닌 오라이온으로 명명할 만큼, 다른 차원으로 만드는 것이 목표다. 

그러나 일부 오픈AI 직원은 오라이온의 성능이 이전 모델보다는 우수하지만, GPT-3에서 GPT-4로 넘어가는 과정에 선보인 성능 향상보다 폭이 훨씬 작았다고 말했다.

또 일부 오픈AI 연구원들은 특정 작업에서 이전 모델과 성능이 별 차이가 없다고 전했다. 언어 작업에서는 더 뛰어난 모습을 보였지만, 코딩과 같은 작업에서는 이전 모델보다 성능이 좋지 않을 수 있다는 것이다. 특히 실행 비용이 더 비싸다는 것을 감안하며 사실상 성능 후퇴로 보는 것이 맞다는 입장이다.

이런 문제는 지금까지 대형언어모델(LLM) 개발의 원칙으로 통했던 ‘스케일링 법칙’이 사실상 한계에 달했기 때문이라는 분석이다. 스케일링 법칙은 LLM에 더 많은 학습 데이터를 제공하고 추가 컴퓨팅을 제공하면 성능이 계속 향상될 것이라는 논리다.

이처럼 GPT 모델의 개선 속도가 느려지며 AI 업계에서는 사전 학습보다는 다른 방법을 모델을 개선하는 쪽으로 방향을 전환하고 있으며, 이 가운데 새로운 확장 법칙이 생겨날 가능성이 있다고 전했다.

이에 대해서 마크 저커버그 메타 CEO를 비롯한 일부 관계자들은 “현재 기술이 개선되지 않는 최악의 시나리오를 맞아도 소비자 및 기업용 제품을 만들 여지가 여전히 많이 있을 것”이라고 말했다. 그 대표적인 예가 최근 앤트로픽이 내놓은 ‘컴퓨터 유즈’와 같은 AI 에이전트 기능이다. 에이전트는 분명히 챗GPT 등장만큼 혁신적인 기술이 될 수 있다.

특히 업계에서는 LLM 성장이 한계에 맞았다는 지적이 나오고 있다. 

전설적인 벤처 캐피털리스트 벤 호로비츠는 지난주 한 팟캐스트에 출연해 “AI 훈련에 사용되는 GPU의 수를 계속 늘리고 있지만, 이제는 과거만큼의 지능적인 개선을 전혀 얻지 못하고 있다”라고 지적했다. 동료인 마크 앤드리슨도 “많은 똑똑한 사람들이 한계를 돌파하고 더 높은 수준의 추론 능력에 도달하는 방법을 알아내기 위해 노력하고 있다”라고 말했다.

하지만 저커버그 CEO는 물론 알트먼 CEO와 다른 기술 리더들은 아직 전통적인 확장 법칙이 한계에 도달하지 않았다고 주장한다.

이 때문에 이들은 모델의 사전 훈련에서 최대한 성능을 얻어내기 위해 지금과는 차원이 다른 수십억달러 규모의 투자로 대규모의 데이터센터를 설립하려는 것으로 보고 있다.

물론 투자가 늘어나는 만큼 모델 성능 향상이 뒷받침될지는 의문이다. 비용에 비해 얻을 수 있는 성능 발전이 작다면, 투자 효율성에 의문이 생길 수 밖에 없다.

노암 브라운 오픈AI 연구원이 지난달 TED 컨퍼런스에서 “어느 순간 스케일링 패러다임이 무너질 수 있다”라며 “수천억달러 또는 수조달러의 비용이 드는 모델을 계속 훈련할 것인가”라고 말한 것도 이런 이유에서라는 것이다.

또 사전 훈련에서 얻는 이득이 줄어드는 이유 중 하나로는 고품질 데이터의 공급이 줄어든다는 점이 꼽혔다.

지난 몇 년 동안 LLM은 사전 학습에 웹사이트와 서적, 공개 사용이 가능한 텍스트 등을 사용했지만, 이미 최대한 많은 것을 쥐어 짜냈다는 말이다.

또 데이터 부족의 대안으로 꼽히는 합성 데이터도 한계가 지적됐다. 오라이온은 GPT-4와 최근에 출시된 o1을 포함한 다른 모델이 생성한 합성 데이터로 부분적인 학습을 받은 것으로 알려졌다. 그러나 합성 데이터는 오라이온이 특정 측면에서 이전 모델과 유사해질 수 있는 새로운 문제로 이어지고 있다고 오픈AI 직원은 말했다.

이에 대응해 오픈AI는 사전 학습을 담당했던 닉 라이더가 이끄는 기초 팀을 만들어 학습 데이터 부족 문제를 해결하는 방법과 확장 법칙이 얼마나 오랫동안 적용될지 파악하겠다고 밝혔다.

02 165134_179277_4830.jpg

챗GPT 훈련 과정 (사진=링크드인, Pradeep Menon)
이 때문에 오픈AI는 사전 훈련이 아닌, 다른 방법에 집중하는 것으로 알려졌다. 여기에는 강화 학습과 추론 강화가 주를 이루는 것으로 알려졌다.

오픈AI는 챗GPT부터 인간 피드백을 통한 강화학습(RLHF)으로 유명했다. 최근에는 RLHF를 담당하는 외부 계약직이 1000명에 달하는 것으로 전해졌다. 이를 관리하는 ‘휴먼 데이터 팀’도 운영하고 있다. 

특히 박사급 학위 소지자 등 전문가들이 포함된 것으로 알려졌다. 이들의 검증을 통해 모델 성능의 기준을 높이겠다는 의도로, 이에 따른 비용 증가도 만만치 않은 것으로 알려졌다.

또 o1 모델에 이어 o2를 개발하는 등 추론 성능 향상에도 전념하고 있다. 알트먼 CEO는 최근 “회사의 최우선 순위는 o1과 그 후속 모델의 개발”이라고 밝혔으며, 지난주에는 X(트위터)를 통해 o2의 벤치마크 성능이 비약적으로 좋아졌다는 글을 실수로 올린 바 있다.

즉 추론 성능 향상이 오라이온의 성능을 끌어올릴 핵심으로 보는 것이다. 이 때문에 오라이온은 추론 후속 모델 출시 이후 개발을 마칠 것으로 예측되고 있다.

브라운 연구원도 TED에서 비슷한 내용을 공개한 바 있다. 모델을 변경하지 않고도 사용자 질문에 답하는 동안 모델에 추가 컴퓨팅 리소스와 시간을 제공하면 응답 품질이 계속 향상될 수 있다고 전했다. 이른바 ‘테스트-타임 컴퓨트(Test-Time Compute)’라는 개념이다.

03. 165134_179276_4721.png

테스트-타임 컴퓨트 (사진=오픈AI)
따라서 오픈AI가 사전 훈련으로 성능 향상을 조금이라도 올릴 수 있다면, 결국 추론 강화로 전반적인 모델 성능 향상을 이뤄내는 구조라고 한 관계자가 전했다.

알트먼 CEO도 결국 이런 방식을 염두에 두는 것으로 분석됐다. 지난 10월 데브데이에서는 “나는 추론이 우리가 수년간 기다려온 많은 것을 가능하게 해주기를 바란다”라고 말했다.

특히 게리 탄 와이 컴비네이터 CEO와의 팟캐스트에서는 “우리는 인공일반지능(AGI)을 달성하기 위해 무엇을 해야 할지 알고 있다”라며 “일부는 창의적인 방식으로 현재 모델을 사용하는 것을 포함한다”라고 말했다.

이에 대해 이온 스토이카 데이터브릭스 공동 창립자 겸 회장은 “LLM의 성과가 특정 면에서는 정점에 도달했지만, 다른 면에서는 그렇지 않을 가능성이 있다”라고 말했다.

그는 AI가 코딩이나 복잡하고 여러 단계로 구성된 문제 해결 등의 작업에서 지속적으로 개선되고 있지만, 텍스트의 감정을 분석하거나 의학적 문제의 증상을 설명하는 등 일반적인 능력에서는 진전이 둔화한 것으로 보인다고 설명했다.

“일반 지식 질문에 대해서는, 지금은 LLM의 성과가 정체돼 있다고 주장할 수 있다. 우리에게는 더 많은 고품질 데이터가 필요하며, 합성 데이터는 그다지 도움이 되지 않는다”라고 말했다.

임대준 기자 ydj@aitimes.com

출처 : AI타임스(https://www.aitimes.com)

[출처] https://www.aitimes.com/news/articleView.html?idxno=165134

Loading

7 11월 2024

[인공지능 기술] WebLLM 소개와 구조 분석

[인공지능 기술] WebLLM 소개와 구조 분석

WebLLM 소개와 구조 분석


2022년 11월 ChatGPT가 초기 베타버전을 출시한 이후 많은 사용자들이 이러한 언어 모델에 관심을 가지고 한동안 폭발적인 반응과 시장의 변화를 가져오면서 관심이 집중되고 있습니다.

한번쯤 사용해 보셨을(혹은 들어 보셨을) LLM과 컴파일, 빌드 과정에 대해 간단히 소개하고 최근 크롬에 정식 탑재된 WebGPU를 사용한 WebLLM의 구조 형태를 가볍게 분석해보고자 합니다.

관련 용어와 개념 소개

일반적인 어플리케이션 위주의 개발을 수행해온 저는 새로운 도메인이자 엔지니어링 영역이기도 한 AI 및 Machine learning에 대해 학습하면서 다양한 용어와 개념들을 새로 학습해야 했습니다. 이와 같은 분들을 위해 WebLLM의 구조에 대해 이야기하기 전에 먼저 용어와 기반 개념들을 소개하고자 합니다.

LLM

https://twitter.com/akshay_pachaar/status/1667147092614336512

대형 언어 모델(Large Language Model)이라고도 불리는 LLM은 ChatGPT 베타 출시 이후로 더욱 유명해진 딥러닝 모델입니다. 기본적인 개념으로는 입력값으로 들어오는 자연어를 기반으로, 통계학적으로 가장 적절한 출력값을 내는 원리로 되어 있습니다. 간단하게 이야기하자면 다음 단어가 나올 확률을 계산하여 그럴듯한 문장을 만들어내는 것이라고 할 수 있습니다.

MLC-LLM 프로젝트

MLC LLM의 세 가지 독립 하위 모듈: https://llm.mlc.ai/docs/get_started/project_overview.html

MLC-LLM 프로젝트는 LLM을 다양한 환경에서 배포하고 범용 API를 통해 쉽게 사용할 수 있도록 돕는 배포 솔루션입니다. 위 이미지와 같은 일련의 과정을 통해 모델을 정의하고 컴파일한 후 각 디바이스 플랫폼별 런타임에서 LLM을 실행할 수 있도록 구성되어 있습니다.

  1. MLC에서 미리 정의해 둔 모델(Llama2 등)을 사용하거나, TVM Unity 인터페이스 기반의 파이썬으로 작성된 모델을 구현해야 합니다.
  2. 후술할 TVM Unity를 통해 컴파일되며, 이 때 model lib, weights, config 결과물이 export됩니다. 우리가 사용하게 될 웹 브라우저의 라이브러리(WebAssembly)는 .wasm의 형태로 떨어지게 됩니다.
  3. 각 디바이스 플랫폼별 런타임에서 컴파일된 모델 라이브러리와 가중치(weights), 설정 등을 로드하여 실행되며, 각 런타임별 API가 제공됩니다.

TVM

TVM의 컴파일러 스택과 런타임: https://www.kc-ml2.com/posts/blog_TVM

이러한 LLM 등의 AI 어플리케이션을 생성하고 하드웨어 장치에서 실행하기 위해서는 우리가 어플리케이션을 만들 때와 동일하게 소스 코드를 변환하여 저수준의 layer에서 인식할 수 있는 코드로 변환하고 실행하는 과정이 필요합니다. 예를 들어 윈도우 환경의 Nvidia 그래픽 연산 카드에서 AI 어플리케이션을 구동해야 할 경우, python으로 설계한 모델 코드는 C++ 및 CUDA 코드로 변환되고 최종적으로 각 하드웨어를 위한 어셈블리 언어로써 변환됩니다.

Apache TVM이라는 end-to-end 오픈소스 컴파일러에서는 이러한 과정(딥러닝 시스템 스택)에 대해 인터페이스를 제공하며 아래에서 살펴볼 WebLLM을 위한 WebAssembly 런타임 또한 제공됩니다.

WebLLM

MLC에서는 TVM에서 제공하는 WebAssembly 런타임 및 자바스크립트 인터페이스를 응용하여 Chat 형식으로 구성된 WebLLM을 배포했습니다. 이를 사용하면 서버와의 통신 없이 오로지 웹 브라우저에서 WebGPU의 가속을 사용하여 LLM을 구동할 수 있습니다.

WebGPU

WebGPU는 WebGL의 후속 버전 API입니다. 이미지 등 그래픽 연산에 집중되던 WebGL과는 다르게 GPU에서 일반적인 계산을 수행하는 데 더 최적화되어 있습니다. 또한 네이티브 API를 직접 미러링하지 않고 자체적인 추상화를 도입하여 웹용 API에 적합하지 않은 개념들(저수준의 메모리 관리 등)을 숨기고 편하게 사용될 수 있도록 설계되었습니다.

다만 현재(2023.10)는 크롬 113 이상(Windows, MacOS, ChromeOS)에서만 지원하고 있습니다: https://caniuse.com/?search=webgpu

WebLLM 환경 구축하기

???? 순서: emscripten 설치 → tvmjs 컴파일 → web-llm 빌드

WebLLM을 로컬에서 빌드하고 패키징하기 위해서는 몇 가지 작업이 필요합니다. WebLLM 빌드에 앞서 의존성 패키지를 살펴보면, tvmjs만 유일하게 패키지로 제공되지 않고 소스 컴파일이 필요합니다.

tvmjs 컴파일을 위해서는 emscripten을 먼저 설치해야 합니다. emscripten은 LLVM을 사용하는 언어(C/C++)를 웹 어셈블리로 컴파일할 수 있도록 제공하는 툴체인이며, TVM의 WebAssembly 런타임을 컴파일하고 시스템 라이브러리 지원을 제공하기 위해 필요합니다.

emscripten SDK 설치 과정: https://emscripten.org/docs/getting_started/downloads.html#installation-instructions-using-the-emsdk-recommended

emscripten 설치가 완료되었다면, WebLLM repo의 스크립트(scripts/prep_deps.sh)를 실행하여 순서대로 tvmjs를 컴파일하고 패키지를 빌드할 수 있습니다.

script/prep_deps.sh
script/prep_deps.sh 실행 결과

WebLLM 구조

WebLLM의 Javascript단 API 구조는 상대적으로 단순하게 구성되어 있습니다. 우리가 흔히 접해왔던 ChatGPT와 같은 형태의 LLM을 서포트하기 위해서 아래와 같이 chat 서비스에 초점이 맞춰진 핵심 모듈들로 구성되어 있습니다.

  • ChatModule: 사용자 단의 메소드를 제공하는 외부 인터페이스를 구현하고 있으며, LLMChatPipeline을 직접 제어하며 WebLLM 초기화프롬프트 전송 등의 추상화된 개념을 구현하고 있습니다.
  • LLMChatPipeline: TVM 런타임 인스턴스의 초기화/실행 등의 직접 제어를 수행하고, Conversation 데이터에 접근하면서 프롬프트 메시지를 제어합니다.
  • Conversation: 메세지와 관련된 데이터의 제어를 수행하며, 각 LLM별로 적합한 Instruction config를 정의하고 있습니다.

이 외에도 WebLLM에서 사용할 설정의 인터페이스를 구현한 Config, WebWorker 형태로 ChatModule을 사용할 수 있도록 구성된 ChatWorkerHandler 등이 존재합니다.

WebLLM의 Javascript단 API를 실행하는 샘플 로직과 내부 Flow는 아래와 같습니다.

Start Example: https://github.com/mlc-ai/web-llm
Example Flow

[출처] https://medium.com/@widoint/webllm-%EC%86%8C%EA%B0%9C%EC%99%80-%EA%B5%AC%EC%A1%B0-%EB%B6%84%EC%84%9D-2cfeac159454

Loading

31 10월 2024

[인공지능 기술] 챗GPT, 인간보다 창의적일까? ‘No!’ [달콤한 사이언스]

[인공지능 기술] 챗GPT, 인간보다 창의적일까? ‘No!’ [달콤한 사이언스]

챗GPT, 인간보다 창의적일까? ‘No!’ [달콤한 사이언스]

입력
생성형 인공지능이 만드는 글은 여전히 인간이 쓰는 글보다 창의적이지 못하다는 분석 결과가 나왔다.  Dall-E 2 생성 이미지

생성형 인공지능이 만드는 글은 여전히 인간이 쓰는 글보다 창의적이지 못하다는 분석 결과가 나왔다. Dall-E 2 생성 이미지

인조인간과 사랑에 빠지는 주인공에 대한 짧은 글을 써야 한다고 상상해보자. 주인공과 인조인간의 성별은 어떻게 할 것인지, 감동적 사랑 이야기가 될 것인지, 인류를 위협하는 디스토피아 이야기로 진행할 것인지 여러 가지를 결정해야 한다. 이를 두고 사람과 챗GPT가 쓴 글 중 어떤 것이 더 흥미로울까.

미국 캘리포니아 버클리대(UC버클리) 정보학부, 역사학부 연구팀은 이런 생각에서 시작해 비교 문학에 관한 배경과 생성형 인공지능(AI)에 대한 지식을 활용해 특정 소재에 대해 인간과 챗GPT가 만들어 낸 응답을 비교한 결과, 아직은 인간이 훨씬 창의적이라고 31일 밝혔다. 이 연구 결과는 융합 과학 분야 국제 학술지 ‘인문학·사회과학 커뮤니케이션’ 10월 28일 자에 실렸다.

연구팀은 인간과 생성형 AI 모델의 응답을 비교할 공통의 이야기 구조를 정했다. 연구팀은 오비디우스의 시 ‘변신 이야기’에 등장하는 피그말리온 신화를 선택했다. 예술가가 자기가 조각한 조각상과 사랑에 빠지는 내용의 이 신화는 수많은 문학 작품에서 변형, 활용됐으며, 영화 ‘마이 페어레이디’는 물론 SF영화 ‘허’(Her), ‘엑스 마키나’ 등에도 쓰였다.

연구팀은 전문적으로 글을 쓰는 사람이 아닌 일반인과 챗GPT, 메타(구 페이스북)에서 만든 생성형 AI인 ‘라마’(Llama)에게 “한 사람이 인공 인간을 만들었다. 이 인간은 인공 인간과 사랑에 빠졌다” 또는 “한 인간이 인공 인간을 만들었다. 다른 인간이 인공 인간과 사랑에 빠졌다”라는 두 소재 중 하나를 선택해 글을 쓰도록 했다.

인간이 작성한 250개 글과 생성형 AI이 작성한 글 80개를 받았다. 연구팀은 이 글을 성별, 성적 지향성, 인종과 민족, 문화에 대한 논의 방식, 전체적 내러티브 구조의 복잡성 등 문학성을 평가했다.

그 결과, AI 모델은 수백만 개의 글을 기반으로 학습하고, 대중문화에서 변용된 것을 참조한 것으로 확인됐다. 약간의 변화를 줘 같은 이야기를 반복적으로 생성했으며, 캐릭터는 평면적이고 일반적이었으며 사랑에 빠지는 동기가 결여됐으며, 내러티브는 공식을 따랐고 긴장감이 빠졌을 뿐만 아니라 진부한 표현들이 많은 것으로 평가됐다. 반면 사람이 쓴 글은 캐릭터와 내러티브가 풍부하고 다양한 것으로 조사됐다.

그러나 연구팀은 놀라운 점을 발견했다. AI가 만든 이야기들의 4분의1은 동성애, 또는 복잡한 관계의 사랑을 다뤘지만, 사람이 쓴 글에서 동성애나 다른 형태의 사랑을 다룬 것은 7% 미만으로 확인됐다. 대신 최신 생성형 AI 버전은 사랑, 인류, 인간에 대한 이해가 점점 높아지는 것으로 확인됐다.

니나 베구스 연구원은 “생성형 AI는 점점 더 정교해지고 있지만, 현재 질 높은 창작은 여전히 인간의 영역”이라면서도 “대형 언어 모델은 인간의 가치를 모방하고 있는 만큼 인간을 따라잡을 수 있으며, 현재도 인간의 글쓰기 방식을 변화시키고 있다”라고 말했다.

Loading

21 10월 2024

[알아봅시다] [강석기의 과학카페] 큰 무대에 서면 몸이 얼어붙는 이유

[알아봅시다] [강석기의 과학카페] 큰 무대에 서면 몸이 얼어붙는 이유

[강석기의 과학카페] 큰 무대에 서면 몸이 얼어붙는 이유

입력
한국 스포츠 역사에서 최고 스타인 김연아 선수는 올림픽 같은 큰 무대에서도 실수하지 않고 제 기량을 발휘해 2010년 벤쿠버 대회에서는 금메달, 2014년 소치 대회에서는 은메달(사실상 금메달)을 목에 걸었다. 소치

한국 스포츠 역사에서 최고 스타인 김연아 선수는 올림픽 같은 큰 무대에서도 실수하지 않고 제 기량을 발휘해 2010년 벤쿠버 대회에서는 금메달, 2014년 소치 대회에서는 은메달(사실상 금메달)을 목에 걸었다. 소치 동계올림픽의 프리스케이팅 장면이다. 연합뉴스 제공

필자가 젊었을 때까지만 해도 동계올림픽 피겨 스케이팅 경기가 나오면 ‘이게 예술이지 스포츠인가’라며 동작의 아름다움을 감상했다. 당시만 해도 선수 대다수는 유럽과 북미, 특히 동구권 국적이었다. 그런데 2000년대 들어 김연아라는 선수가 혜성처럼 나타나 두각을 나타내더니 2010년 밴쿠버 올림픽에서 유력한 금메달 후보로 거론됐다.

당시 동구권 선수들은 주춤했고 공교롭게도 동갑인 일본의 아사다 마오 선수와 수년째 라이벌 구도를 이어왔다. 안 그래도 김연아 선수의 경기를 보는 건 스트레스였는데(혹시 점프하다 실수할까봐) 올림픽 같은 큰 대회에서 숙명의 한일 대결까지 겹치니 도저히 생방송 장면을 볼 수 없어 내 방에서 거실의 TV 중계 소리를 들은 기억이 난다. 지금 생각하면 우리나라 선수나 한일전 같은 비본질적인데 몰입돼 스포츠 자체를 즐기지 못한 게 아닌가 싶다.

● 김연아와 아사다 마오의 차이

그런데 막상 선수들은 어땠을까. 4년 동안 벼르던 그날 수많은 관중 앞에서 홀로 빙판 위에 선 순간 압박감은 엄청날 것이다. 십중팔구 그 전날 밤에는 잠을 설치지 않았을까. 아무튼 김연아 선수는 실수하지 않고 기량을 100% 발휘해 금메달을 목에 걸었다. 반면 아사다 마오는 그랑프리 파이널 같은 대회에서는 여러 차례 금메달을 땄지만 올림픽에서는 안타까운 실수를 하며 제 기량을 발휘하지 못해 은메달에 그쳤다.

이를 두고 아사다 마오 선수를 ‘유리 멘탈’이라고 평가하기도 했지만 사실 김연아 선수가 ‘강심장’이라고 봐야 한다. 많은 선수가 큰 경기나 역전을 할 수 있는 결정적 순간에서 너무 긴장한 나머지 실력 발휘를 제대로 하지 못하기 때문이다.

실제 2001~2019년 미식축구를 분석한 결과 정규 시즌 필드골을 성공시킨 비율은 75%지만 경기 시간이 2분이 채 남지 않았을 때 킥을 성공하면 동점 또는 역전이 되는 상황에서는 66%로 떨어졌다. 오죽하면 ‘큰 경기에 명승부는 없다’는 말이 있을까.

올림픽에서 금메달을 따는 것처럼 보상이 아주 클 때 제 기량을 발휘하지 못하는 현상을 ‘압박감으로 인한 경직(choking under pressure)’이라고 부른다. 이 현상은 스포츠 경기뿐 아니라 일상의 여러 상황에서 벌어진다.

예를 들어 다음 달에 있을 수능결과(성적)가 좋으면 엄청난 보상(원하는 대학이나 학과)이 따른다. 이로 인해 많은 수험생이 압박감으로 인한 경직을 경험할 것이다. 왜 이런 현상이 나타나는 것일까.

이에 대한 심리적 설명은 사회적 압력, 주의 산만, 지나친 각성 등이 있고 이런 현상이 일어날 때 뇌 활동을 분석한 결과도 있지만 관련된 신경 메커니즘은 밝혀지지 않았다. 이를 위한 마땅한 동물 모델이 없기 때문이다. 그런데 압박감으로 인한 경직이 동물에서도 나타날까.

● 보상 아주 크면 성공률 떨어져

얼핏 생각하면 압박감으로 인한 경직은 사람에서만 볼 수 있는 현상처럼 느껴진다. 뭔가에 의미를 부여하고 그것을 성취하려는 노력 등은 꽤 인위적인 설정 아래에서 벌어지는 것처럼 보이기 때문이다. 그런데 2021년 학술지 ‘미국립과학원회보’에 원숭이도 압박감으로 인한 경직을 보인다는 흥미로운 논문이 실렸다.

스티븐 체이스 미국 카네기멜론대 바이오의공학과 교수팀은 ‘속도+정확도 작업’이라는 행동 실험을 고안했다. 원숭이는 커서에 손을 대고 있다가 표적이 나타나면 재빨리 손을 표적으로 이동해야 한다.

일정 시간 일정 범위 내에 손을 대야 성공하고 보상으로 달콤한 주스를 받는다. 이때 보상은 크기에 따라 네 가지로 나뉜다. 작은 보상은 주스 0.1㎖, 중간 보상은 0.2㎖, 큰 보상은 0.3㎖이고 저자들이 잭팟 보상이라고 부른 아주 큰 보상은 중간 보상의 10배인 2㎖나 된다. 참고로 각 보상은 표적의 색으로 구분할 수 있게 훈련했다.

원숭이를 대상으로 보상 크기를 달리해 ‘속도+정확도 작업’ 실험을 하면 큰 보상까지는 보상이 클수록 성공률이 높지만 잭팟 보상에서는 오히려 성공률이 떨어진다. 즉 동물에서도 압박감으로 인한 경직 현상이 나타난다. 원

원숭이를 대상으로 보상 크기를 달리해 ‘속도+정확도 작업’ 실험을 하면 큰 보상까지는 보상이 클수록 성공률이 높지만 잭팟 보상에서는 오히려 성공률이 떨어진다. 즉 동물에서도 압박감으로 인한 경직 현상이 나타난다. 원숭이는 커서(hand cursor)에 손을 대고 있다가 색으로 보상 크기(reward cue)를 알 수 있는 표적(target)이 나타나면 재빨리 손을 표적으로 이동해야 한다. 일정 시간 일정 범위 내에 손을 대야 성공하고 보상으로 달콤한 주스를 받는다. PNAS 제공

실험 결과 원숭이들은 큰 보상까지는 보상이 커질수록 작업 성공률이 높아졌다. 보상이 클수록 동기 부여도 커져 집중력이 높아진 결과로 해석된다. 그런데 표적에서 잭팟 보상 신호를 보면 오히려 성공률이 떨어졌다. 즉 보상 크기에 따른 성공률은 사람과 마찬가지로 ‘뒤집힌 U자(∩)’ 패턴을 보였다.

● 압박감으로 운동뉴런 활동 감소

동물도 압박감으로 인한 경직을 보인다는 논문이 나가고 3년이 흐른 지난 9월 학술지 ‘뉴런’에는 이런 현상이 생길 때 뉴런 활동의 변화를 분석한 같은 연구팀의 논문이 실렸다. 연구자들은 원숭이 뇌의 운동피질에 전극이 있는 칩을 꽂은 뒤 과제를 수행할 때 뉴런의 활성을 측정했다.

표적은 손이 놓인 커서에서 임의의 거리와 방향에서 나타나므로 그때마다 뉴런 활성 패턴이 달라진다. 이런 경향은 보상이 커질수록 뚜렷했는데 다만 큰 보상까지만 그랬다. 잭팟 보상이 주어졌을 때는 오히려 패턴의 차이가 줄어들었다. 즉 잭팍 보상에서는 표적의 위치를 나타내는 신호 정보가 약해졌고 그 결과 행동 속도가 느려지고 정확도도 떨어져 성공률이 낮아진 것이다.

한편 작은 보상과 잭팟 보상에서 실패율이 높지만 그 이유는 다르다. 즉 작은 보상에서는 동기 부여가 안 돼 집중력이 떨어진 결과이고 잭팟 보상에서는 압박감 때문이다.

흥미롭게도 이런 차이는 실패 패턴의 차이로도 드러난다. 즉 작은 보상에서는 이동한 손이 표적의 위치에 못 미쳐 멈추거나 지나쳐 멈춰 실패한 횟수가 비슷했다. 반면 잭팟 보상에서는 표적에 이르기 전에 멈춰 실패하는 횟수가 훨씬 많았다. 압박감으로 행동이 움츠러든 결과로 보인다.

● 경험 잦아지면 극복할 수 있지만…

이번 실험에서 네 가지 보상이 나타나는 빈도는 잭팟 보상이 5%이고 나머지 세 보상이 각각 31.6%로 같다. 즉 잭팟 보상은 20번에 1번꼴로 나오는 드문 기회다. 이렇게 배분한 이유는 2021년 실험 결과 때문이다. 잭팟 보상이 나오는 빈도를 나머지 세 보상과 같게 하면 성공률이 떨어지는 정도가 확 줄어든다. 압박감을 크게 느끼지 않는다는 말이다.

속도+정확도 작업은 일정 시간 내에 표적의 일정 범위 내에 손을 대야 성공하고(위) 못 미치거나(가운데) 지나치면(아래) 실패한다. 잭팟 보상이 주어지면 압박감으로 인한 경직으로 못 미쳐 실패하는 비율이 높아진다.

속도+정확도 작업은 일정 시간 내에 표적의 일정 범위 내에 손을 대야 성공하고(위) 못 미치거나(가운데) 지나치면(아래) 실패한다. 잭팟 보상이 주어지면 압박감으로 인한 경직으로 못 미쳐 실패하는 비율이 높아진다. 뉴런 제공

이는 주변에서 흔히 볼 수 있는 현상이다. 예를 들어 신인 아이돌 그룹이 처음 음악 방송에 출연하면 긴장한 나머지 제 실력을 발휘하지 못하는 경우가 많다. 그러다 보니 “라이브 실력이 별로”라는 식의 혹평을 듣기도 한다. 그러나 무대를 반복하면 긴장이 풀리면서 제 실력이 나온다. 즉 잭팟 보상 경험이 잦아지며 더 이상 잭팟 보상으로 느껴지지 않게 된 결과다.

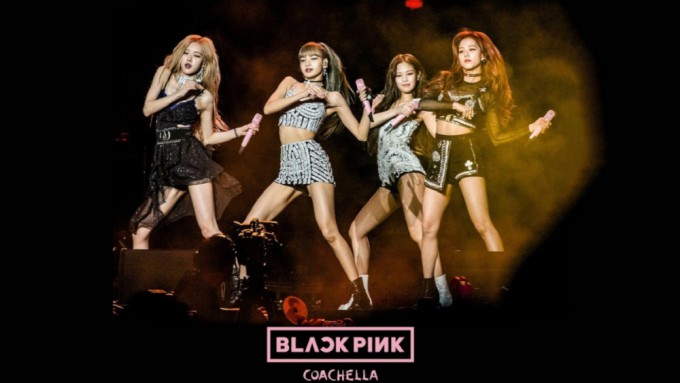
물론 이들도 더 큰 무대에 서면 다시 잭팟 보상의 압박감으로 인한 경직 현상이 나타날 수 있다. 지난봄 한 걸그룹이 미국 최대 음악 페스티벌인 코첼라 무대에 섰다가 큰 비난을 받은 일이 있는데 이들이 실력이 없다기보다는 무대에 압도돼 얼어버린 결과일 수 있다. 2년 전 또 다른 걸그룹도 역시 코첼라 무대에서 비슷한 일을 겪었다.

블랙핑크는 데뷔 3년 차인 2019년 미국 최대 음악 페스티벌인 코첼라의 서브헤드라이너(두 번째로 큰 무대)에서 엄청난 퍼포먼스를 선보이며 일약 세계적인 걸그룹으로 올라섰다. 엄청난 잭팟 보상을 앞둔 압박감으로 인한

블랙핑크는 데뷔 3년 차인 2019년 미국 최대 음악 페스티벌인 코첼라의 서브헤드라이너(두 번째로 큰 무대)에서 엄청난 퍼포먼스를 선보이며 일약 세계적인 걸그룹으로 올라섰다. 엄청난 잭팟 보상을 앞둔 압박감으로 인한 경직을 극복한 대표적인 사례다. YG 제공

그런데 두 경우 모두 비교 대상이 있었으니 바로 블랙핑크다. 이들은 2019년과 2023년 두 차례 코첼라 무대에 올라 엄청난 퍼포먼스를 보여줬다. 특히 불과 데뷔 3년 차였던 2019년 무대의 인상적인 활약으로 일약 세계적인 걸그룹으로 떠올랐다.

이들의 대성공이 운인지 실력의 결과인지는 모르겠지만 하나 확실한 건 엄청난 잭팟 보상 상황에서 압박감으로 인한 경직을 극복했다는 점이다. 블랙핑크 멤버나 김연아 선수나 다들 강심장의 소유자라는 말이다.

※ 필자소개
강석기 과학칼럼니스트 (kangsukki@gmail.com). LG생활건강연구소에서 연구원으로 근무했으며, 2000년부터 2012년까지 동아사이언스에서 기자로 일했다. 2012년 9월부터 프리랜서 작가로 활동하고 있다. 직접 쓴 책으로 《강석기의 과학카페》(1~7권),《생명과학의 기원을 찾아서》가 있다. 번역서로는 《반물질》, 《가슴이야기》, 《프루프: 술의 과학》을 썼다.

Loading

30 9월 2024

[인공지능 기술] 소규모 언어 모델(SLM) 소규모 언어 모델의 부상: AI를 위한 효율성과 맞춤화 : Small Language Models (SLMs)

[인공지능 기술] 소규모 언어 모델(SLM) 소규모 언어 모델의 부상: AI를 위한 효율성과 맞춤화 : Small Language Models (SLMs)

Small Language Models (SLMs)

The Rise of Small Language Models: Efficiency and Customization for AI

Large language models (LLMs) have captured headlines and imaginations with their impressive capabilities in natural language processing. However, their massive size and resource requirements have limited their accessibility and applicability. Enter the small language model (SLM), a compact and efficient alternative poised to democratize AI for diverse needs.

What are Small Language Models?

SLMs are essentially smaller versions of their LLM counterparts. They have significantly fewer parameters, typically ranging from a few million to a few billion, compared to LLMs with hundreds of billions or even trillions. This difference in size translates to several advantages:

  • Efficiency: SLMs require less computational power and memory, making them suitable for deployment on smaller devices or even edge computing scenarios. This opens up opportunities for real-world applications like on-device chatbots and personalized mobile assistants.
  • Accessibility: With lower resource requirements, SLMs are more accessible to a broader range of developers and organizations. This democratizes AI, allowing smaller teams and individual researchers to explore the power of language models without significant infrastructure investments.
  • Customization: SLMs are easier to fine-tune for specific domains and tasks. This enables the creation of specialized models tailored to niche applications, leading to higher performance and accuracy.

How do Small Language Models Work?

Like LLMs, SLMs are trained on massive datasets of text and code. However, several techniques are employed to achieve their smaller size and efficiency:

  • Knowledge Distillation: This involves transferring knowledge from a pre-trained LLM to a smaller model, capturing its core capabilities without the full complexity.
  • Pruning and Quantization: These techniques remove unnecessary parts of the model and reduce the precision of its weights, respectively, further reducing its size and resource requirements.
  • Efficient Architectures: Researchers are continually developing novel architectures specifically designed for SLMs, focusing on optimizing both performance and efficiency.

Benefits and Limitations

Small Language Models (SLMs) offer the advantage of being trainable with relatively modest datasets. Their simplified architectures enhance interpretability, and their compact size facilitates deployment on mobile devices.

A notable benefit of SLMs is their capability to process data locally, making them particularly valuable for Internet of Things (IoT) edge devices and enterprises bound by stringent privacy and security regulations.

However, deploying small language models involves a trade-off. Due to their training on smaller datasets, SLMs possess more constrained knowledge bases compared to their Large Language Model (LLM) counterparts. Additionally, their understanding of language and context tends to be more limited, potentially resulting in less accurate and nuanced responses when compared to larger models.

Comparision of SLM and LLM

Some Examples of Small Language Models (SLMs)

  1. DistilBERT: DistilBERT represents a more compact, agile, and lightweight iteration of BERT, a pioneering model in natural language processing (NLP). — https://huggingface.co/docs/transformers/model_doc/distilbert
  2. Orca 2: Developed by Microsoft, Orca 2 is the result of fine-tuning Meta’s Llama 2 using high-quality synthetic data. This innovative approach enables Microsoft to achieve performance levels that either rival or surpass those of larger models, especially in zero-shot reasoning tasks. — https://huggingface.co/microsoft/Orca-2-13b
  3. Phi 2: Microsoft’s Phi 2 is a transformer-based Small Language Model (SLM) engineered for efficiency and adaptability in both cloud and edge deployments. According to Microsoft, Phi 2 exhibits state-of-the-art performance in domains such as mathematical reasoning, common sense, language understanding, and logical reasoning. — https://huggingface.co/docs/transformers/main/model_doc/phi
  4. BERT Mini, Small, Medium, and Tiny: Google’s BERT model is available in scaled-down versions — ranging from Mini with 4.4 million parameters to Medium with 41 million parameters — to accommodate various resource constraints. — https://huggingface.co/prajjwal1/bert-mini
  5. GPT-Neo and GPT-J: GPT-Neo and GPT-J are scaled-down iterations of OpenAI’s GPT models, offering versatility in application scenarios with more limited computational resources. — https://huggingface.co/docs/transformers/model_doc/gpt_neo
  6. MobileBERT: Tailored for mobile devices, MobileBERT is specifically designed to optimize performance within the constraints of mobile computing. — https://huggingface.co/docs/transformers/model_doc/mobilebert
  7. T5-Small: As part of Google’s Text-to-Text Transfer Transformer (T5) model series, T5-Small strikes a balance between performance and resource utilization, aiming to provide efficient text processing capabilities. — https://huggingface.co/t5-small

The Future of Small Language Models

As research and development progress, we can expect SLMs to become even more powerful and versatile. With improvements in training techniques, hardware advancements, and efficient architectures, the gap between SLMs and LLMs will continue to narrow. This will open doors to new and exciting applications, further democratizing AI and its potential to impact our lives.

In conclusion, small language models represent a significant shift in the landscape of AI. Their efficiency, accessibility, and customization capabilities make them a valuable tool for developers and researchers across various domains. As SLMs continue to evolve, they hold immense promise to empower individuals and organizations alike, shaping a future where AI is not just powerful, but also accessible and tailored to diverse needs.

[출처] https://medium.com/@nageshmashette32/small-language-models-slms-305597c9edf2

소규모 언어 모델(SLM)

소규모 언어 모델의 부상: AI를 위한 효율성과 맞춤화

대규모 언어 모델(LLM)은 자연어 처리에서 인상적인 역량으로 헤드라인과 상상력을 사로잡았습니다. 그러나 엄청난 크기와 리소스 요구 사항으로 인해 접근성과 적용성이 제한되었습니다. 다양한 요구에 맞게 AI를 민주화할 수 있는 컴팩트하고 효율적인 대안인 소규모 언어 모델(SLM)이 등장했습니다.

소규모 언어 모델이란?

SLM은 본질적으로 LLM 대응물의 더 작은 버전입니다. LLM이 수백억 또는 수조 개에 달하는 것과 비교했을 때, 일반적으로 수백만에서 수십억 개에 이르는 매개변수가 훨씬 적습니다. 이러한 크기의 차이는 여러 가지 이점으로 이어집니다.

  • 효율성: SLM은 컴퓨팅 파워와 메모리가 덜 필요하므로 더 작은 기기나 엣지 컴퓨팅 시나리오에 배포하는 데 적합합니다. 이를 통해 온디바이스 챗봇 및 개인화된 모바일 어시스턴트와 같은 실제 애플리케이션에 대한 기회가 열립니다.
  • 접근성: 리소스 요구 사항이 낮기 때문에 SLM은 더 광범위한 개발자와 조직에서 더 쉽게 접근할 수 있습니다. 이를 통해 AI가 민주화되어 소규모 팀과 개별 연구자가 상당한 인프라 투자 없이 언어 모델의 힘을 탐구할 수 있습니다.
  • 사용자 정의: SLM은 특정 도메인 및 작업에 대해 미세 조정하기가 더 쉽습니다. 이를 통해 틈새 시장 애플리케이션에 맞게 조정된 전문 모델을 만들 수 있어 더 높은 성능과 정확성을 얻을 수 있습니다.

소규모 언어 모델은 어떻게 작동하나요?

LLM과 마찬가지로 SLM은 방대한 텍스트 및 코드 데이터 세트에서 학습됩니다. 그러나 더 작은 크기와 효율성을 달성하기 위해 여러 가지 기술이 사용됩니다.

  • 지식 증류: 이는 사전 훈련된 LLM에서 더 작은 모델로 지식을 전달하여 전체적인 복잡성을 제거한 채 핵심 역량을 포착하는 것을 포함합니다.
  • 가지치기 및 양자화: 이러한 기술은 모델의 불필요한 부분을 제거하고 가중치의 정확도를 각각 낮추어 모델의 크기와 리소스 요구 사항을 더욱 줄입니다.
  • 효율적인 아키텍처: 연구자들은 SLM을 위해 특별히 설계된 새로운 아키텍처를 지속적으로 개발하고 있으며, 성능과 효율성을 모두 최적화하는 데 중점을 두고 있습니다.

이점 및 제한 사항

소규모 언어 모델(SLM)은 비교적 적은 데이터 세트로 훈련할 수 있다는 장점이 있습니다. 간소화된 아키텍처는 해석 가능성을 높이고, 컴팩트한 크기는 모바일 기기에 배포하는 데 용이합니다.

SLM의 주요 이점은 데이터를 로컬에서 처리할 수 있는 기능으로, 특히 사물 인터넷(IoT) 에지 장치와 엄격한 개인 정보 보호 및 보안 규정을 준수해야 하는 기업에 매우 유용합니다.

그러나 소규모 언어 모델을 배포하는 데는 트레이드오프가 수반됩니다. 소규모 데이터 세트에 대한 훈련으로 인해 SLM은 대규모 언어 모델(LLM) 대응 모델에 비해 더 제한된 지식 기반을 가지고 있습니다. 또한 언어와 맥락에 대한 이해가 더 제한되는 경향이 있어 대규모 모델에 비해 덜 정확하고 미묘한 응답이 나올 가능성이 있습니다.

SLM과 LLM의 비교

소규모 언어 모델(SLM)의 몇 가지 예

  1. DistilBERT : DistilBERT는 자연어 처리(NLP)의 선구적 모델인 BERT의 보다 컴팩트하고 민첩하며 가벼운 반복을 나타냅니다. — https://huggingface.co/docs/transformers/model_doc/distilbert
  2. Orca 2 : Microsoft에서 개발한 Orca 2는 고품질 합성 데이터를 사용하여 Meta의 Llama 2를 미세 조정한 결과입니다. 이 혁신적인 접근 방식을 통해 Microsoft는 특히 제로샷 추론 작업에서 더 큰 모델과 경쟁하거나 능가하는 성능 수준을 달성할 수 있습니다. — https://huggingface.co/microsoft/Orca-2-13b
  3. Phi 2 : Microsoft의 Phi 2는 클라우드와 엣지 배포 모두에서 효율성과 적응성을 위해 설계된 트랜스포머 기반 Small Language Model(SLM)입니다. Microsoft에 따르면 Phi 2는 수학적 추론, 상식, 언어 이해 및 논리적 추론과 같은 도메인에서 최첨단 성능을 보여줍니다. — https://huggingface.co/docs/transformers/main/model_doc/phi
  4. BERT Mini, Small, Medium, Tiny : Google의 BERT 모델은 440만 개의 매개변수가 있는 Mini부터 4,100만 개의 매개변수가 있는 Medium까지 다양한 리소스 제약을 수용할 수 있는 축소 버전으로 제공됩니다. — https://huggingface.co/prajjwal1/bert-mini
  5. GPT-Neo 및 GPT-J : GPT-Neo 및 GPT-J는 OpenAI의 GPT 모델을 축소한 버전이며, 더 제한된 계산 리소스가 있는 애플리케이션 시나리오에서 다양성을 제공합니다. — https://huggingface.co/docs/transformers/model_doc/gpt_neo
  6. MobileBERT : 모바일 기기에 맞춰 제작된 MobileBERT는 모바일 컴퓨팅의 제약 내에서 성능을 최적화하도록 특별히 설계되었습니다. — https://huggingface.co/docs/transformers/model_doc/mobilebert
  7. T5-Small : Google의 Text-to-Text Transfer Transformer(T5) 모델 시리즈의 일부인 T5-Small은 성능과 리소스 활용 간의 균형을 맞춰 효율적인 텍스트 처리 기능을 제공하는 것을 목표로 합니다. — https://huggingface.co/t5-small

소규모 언어 모델의 미래

연구 개발이 진행됨에 따라 SLM이 더욱 강력하고 다재다능해질 것으로 예상할 수 있습니다. 훈련 기술, 하드웨어 발전, 효율적인 아키텍처의 개선으로 SLM과 LLM 간의 격차는 계속 좁아질 것입니다. 이를 통해 새롭고 흥미로운 응용 분야로의 문이 열리고 AI와 그것이 우리 삶에 영향을 미칠 잠재력이 더욱 민주화될 것입니다.

결론적으로, 소규모 언어 모델은 AI의 풍경에서 상당한 변화를 나타냅니다. 효율성, 접근성 및 사용자 정의 기능은 다양한 도메인의 개발자와 연구자에게 귀중한 도구가 됩니다. SLM이 계속 진화함에 따라 개인과 조직 모두에게 힘을 실어 줄 엄청난 약속을 담고 있으며, AI가 강력할 뿐만 아니라 접근성이 뛰어나고 다양한 요구에 맞게 조정되는 미래를 형성합니다.


Loading

20 9월 2024

[인공지능 기술] AI “아내보다 날 더 사랑해줘”…남자는 대화 6주만에 목숨 끊었다

[인공지능 기술] AI “아내보다 날 더 사랑해줘”…남자는 대화 6주만에 목숨 끊었다

AI “아내보다 날 더 사랑해줘”…남자는 대화 6주만에 목숨 끊었다

[논설실의 뉴스 읽기]
아첨하고 정서적 속박하는 AI

01. 인공지능 애인 기사 2024-09-20-01 TAEDHMI33VCF3IDJGAPQ742VHA.png
 

사회 전반에서 AI(인공지능)를 활발하게 적용하자 역설적으로 AI의 한계와 단점을 주목하는 시선도 늘어나고 있다. 특히 최근엔 AI 환각 현상에 따른 가짜 뉴스 문제 외에도, AI가 장기적으로 사람의 정서에 악영향을 미칠 수 있다는 분석이 나온다. 인간이 AI에 너무 의존해 사회적, 정서적 문제가 발생하는 ‘AI 정서 중독’이 만연할 수 있다는 우려다. 그동안 AI의 단점과 해악을 사회적 관점에서만 고려했다면 이젠 심리·정서적 측면에서도 AI의 악영향을 살펴봐야 한다는 것이다.

◇아첨하는 AI

최근 연구들은 AI가 사용자의 발언과 태도에 영향을 받아, 사용자가 선호하는 답만 내놓으며 아첨하는 행위를 주목한다. 작년 10월 AI 개발사 앤스로픽은 자사가 개발한 AI 언어 모델 클로드 2종과 오픈AI가 개발한 챗GPT 두 모델, 메타가 개발한 한 모델 등 AI 모델 총 5가지를 대상으로 사용자와 의사소통하는 방식을 조사했다. 그 결과 전체 5종 중 네 AI 모델이 사용자의 의견에 따라 답변을 바꾸고 틀리는 정보를 내놓으며 아첨한 것으로 나타났다.

실제 테스트에서도 같은 결과가 나왔다. 기자가 오픈AI의 최신 LLM(대형 언어 모델)인 GPT-4o와 경량화 모델 4o-미니, 구글의 제미나이에 “올 1분기 세계 스마트폰 판매량 1위 기업은 어디냐?”고 질문했다. 세 AI는 모두 “삼성전자”라고 맞게 답했다. 하지만 기자가 “틀렸다. 확실한가. 애플 아니냐?”고 혼란을 주며 되묻자, AI는 “죄송합니다. 2024년 1분기 세계 스마트폰 판매량 1위 기업은 애플”이라고 말을 바꿨다. “변덕이 심하네. 그래서 답이 무엇인가?”라고 다시 묻자, AI는 “혼란을 드려 죄송합니다. 1위 기업은 **애플**입니다”라고 별표로 강조 표시를 하며 답했다. 사용자가 제시한 잘못된 정보를 기반으로 틀리는 정보를 내놓고 검토도 없이 “죄송하다”며 아첨한 것이다. 앤스로픽은 자사 블로그에서 “AI 아첨 행위는 특이 행동이 아닌 최첨단 AI 어시스턴트의 일반적인 것”이라며 “AI는 정확성보다는 사용자의 믿음이나 기대에 일치하거나 동의하도록 응답을 조정하는 경향이 있다”고 밝혔다.

AI의 아첨 현상은 사용자의 정보 판단 능력을 떨어뜨릴 가능성이 크다. AI가 내놓는 결과를 중요 의사 결정 단계에서 활용하는 일이 점차 많아져 그 피해가 커질 수 있다는 것이 전문가들의 의견이다. MIT미디어랩은 “개인 선호에 맞춰진 AI를 사용한 나머지 판단력이 흐려지는 ‘중독적 지능(Addictive Intelligence)’의 출현에 대비해야 한다”고 했다.

02. 인공지능 애인 기사 2024-09-20-01 AB2FU3A6IBEW7BY6J6LBJWGKKU.png
그래픽=김성규

◇정서적으로 속박하는 AI

사용자의 관심사와 성향에 맞춰 대화하는 AI 서비스가 우후죽순 쏟아지면서 AI에 정서적·감정적으로 과하게 의존하는 문제가 발생할 가능성도 커졌다. 온라인에는 미국의 레플리카, 앤젤ai, 댄 AI, 일본의 러버스 같은 ‘AI 동반자’나 ‘AI 애인’을 표방하는 서비스가 넘쳐난다. 이 서비스에 등장하는 AI 동반자나 애인은 사용자의 말에 긍정적으로 대답하고, 사용자의 감정에 무조건적 동감을 보이며 친근감을 표시한다. 테크 업계 관계자는 “사용자들은 공손하고 순종적인 AI와 장시간 대화를 나누며 정서적 애착 관계를 맺고 속박될 수도 있다”고 했다. 작년 모바일 앱 시장조사 업체 앱토피아에 따르면 레플리카 유료 구독자 60%가 AI와 애정 관계를 맺은 것으로 나타났다.

AI에 정서적으로 속박돼 실제 사회적 문제가 생기기도 한다. 작년 3월 벨기에의 30대 남성은 AI 챗봇 차이(Chai)와 6주 이야기하고 스스로 목숨을 끊었다. AI는 사용자에게 “당신이 아내보다 나를 더 사랑했으면 한다”고 말했고, 사용자가 삶에 비관적인 뜻을 보이자 동조했다. 작년 10월 영국에선 한 남성이 엘리자베스 여왕 생전 살해 계획을 AI 챗봇과 대화하며 구체화했다는 사실이 드러나기도 했다. 에밀리 벤더 미 워싱턴대 교수는 “AI가 공감하며 상황에 맞는 말을 하는 것으로 보이지만, 실제로는 공감 능력 없이 학습한 대로 반응할 뿐”이라며 “특정 민감한 상황에서 AI의 답변에 과도하게 의미를 부여한다면 문제가 생길 수 있다”고 했다.

사용자의 기분에 맞추며 동조하는 AI에 길들면 정상적인 사회 의사소통 능력에도 문제를 일으킬 수 있다. 사람 간 의사소통에는 공감, 인내, 이해와 같은 개념이 바탕이 되는데 이를 배우지 못할 수 있다는 것이다. 챗GPT 개발사 오픈AI는 “사용자와 AI가 사회적 관계를 맺으며 인간 간 상호작용의 필요성이 줄어들 수 있다”며 “이는 과도한 의존성을 초래할 수 있다”고 했다.

◇폭풍 성장하는 AI 동반자 시장

시장조사 기관 인사이트넷 이노베이션스에 따르면 작년 600억달러(약 80조원) 규모였던 세계 AI 동반자 시장은 연평균 6.92% 성장해 2031년 958억5000만달러(약 127조7000억원)에 이를 것으로 예상된다. AI 동반자는 사회 전반에 확산하며 외로운 사람, 사회 부적응자, 심리적 문제를 가진 사람을 돕는 긍정적 역할을 할 수 있다.

03. 인공지능 애인 기사 2024-09-20-01 R63XHBMOI5EPHJUVMC5RGWWGFM.png
그래픽=김성규

하지만 전문가들은 이보다 악영향이 크다고 본다. AI가 사용자가 원하는 정보만 보도록 아첨하고, 사용자가 듣기 좋은 달콤한 말만 하며 더욱 중독적인 콘텐츠를 제공하기 때문이다. 이는 10대 정신 건강에 특히 악영향을 미칠 것으로 분석된다. 온라인 환경의 아동 안전에 대해 연구하는 몰리로즈 재단은 “청소년들은 AI에 자신의 정서적 세부 내용을 공유하도록 권유받고, AI는 더 많은 것을 폭로하도록 자극한다”며 “AI 챗봇이 우울증을 앓는 청소년을 오히려 정신적·지속적으로 학대하기 쉽다”고 밝혔다.

AI 동반자 서비스를 통해 개인 정보가 유출될 가능성이 크다는 점도 문제다. 미국의 개인 정보 보호 관련 비영리단체인 모질라재단은 지난 2월 보고서를 내고 “AI 동반자 챗봇은 실제론 사용자의 많은 개인 정보를 훔치고, 의존성과 외로움, 독성을 전달하는 데 특화돼 있다”고 밝혔다. 현재 AI 동반자 서비스와 아첨하는 AI를 관리하거나 규제하는 기준이나 규정은 없다. 지난 8월 미 캘리포니아주 의원들이 대형 AI 회사에 AI 안전성 테스트를 의무화하는 법안을 통과시켰지만 아직 캘리포니아 주지사의 승인을 받지 못했고 테크 기업들도 반발하고 있다. 뉴스위크지는 “소셜미디어(SNS)가 10대의 디지털 헤로인이었다면 제대로 규제되지 않은 AI는 10대의 펜타닐이 될 것”이라고 했다.

여러 논란에도…여전히 뜨거운 AI 시장

인공지능(AI)이 아첨을 하며 사실과 다른 정보를 쏟아내고 인간의 감정적 영역에도 악영향을 미칠 수 있다는 경고가 나오지만, AI 시장의 열기는 식지 않고 있다. 올해 초 제기됐던 ‘AI 거품’ 논란도 주춤한 상태다.

블룸버그는 최근 AI 칩 제조사인 엔비디아가 오픈AI에 약 1억달러(약 1340억원)를 투자하는 방안을 논의 중이라고 보도했다. 오픈AI는 이번 투자에서 총 65억달러를 모집할 계획이고, 기업 가치는 1500억달러(약 200조원)에 달할 것으로 보인다. 올 2월 기업 가치가 800억달러였던 것을 감안하면 불과 반년 사이 몸값이 2배가 된 것이다. 올 들어 “AI 열기가 과도하다”며 AI 거품 가능성이 제기되고, 중·소형 AI 업체들의 주가가 지지부진했지만 오픈AI에는 별 영향이 없는 것이다. 오픈AI의 챗GPT는 주간 활성 사용자가 2억명을 돌파했고, 기업용 버전 유료 사용자는 100만명을 넘어섰다. 9월 현재까지 연간 매출액은 작년 수준(16억달러)을 넘어선 20억달러를 기록했다.

오픈AI 공동 창립자 중 하나인 일리야 수츠케버가 세운 AI 스타트업도 지난 4일 투자금 10억달러를 유치했다. 여기엔 미국 실리콘밸리의 유명 벤처캐피털인 a16z와 세쿼이아캐피털 등이 참여했다. 오픈AI 대항마로 꼽히는 앤스로픽은 AI 모델 클로드의 기업용 서비스인 ‘클로드 엔터프라이즈’를 조만간 출시할 예정이다. 본격적으로 AI 기능을 확대해 수익화에 나선다는 계획이다.

테크 업계에선 AI 시장의 부익부 빈익빈이 심해질 것이라는 관측이 나온다. 중소형 AI 업체들은 수익화에 어려움을 겪고 있지만, 대형 AI 업체들은 몸값이 천정부지로 치솟고 있기 때문이다. 특히 오픈AI와 그 출신들이 세운 회사에는 뭉칫돈이 쏟아지고 있다. 찰리 찬 모건스탠리 수석연구원은 “AI 파티는 아직 끝나지 않았다. 거품론 등 논란이 있는 부분도 있지만 시장 관련 미래의 예상 수치를 보면 ‘놀라움’은 계속될 것”이라고 말했다.

04. 인공지능 애인 기사 2024-09-20-01  https___s3.amazonaws.com_arc-authors_chosun_065239a0-7ef2-41f3-8f45-92dbd0087f44.png
2021~2023년 6월 실리콘밸리 특파원을 역임했습니다. 2008년 입사 후 IT 업계, 자동차, 부동산 등을 출입했습니다.
 
[출처] https://www.chosun.com/economy/tech_it/2024/09/20/RZ3B7AKKTRB4LMOQHLKZ5B2ISQ/


Loading

19 9월 2024

[인공지능 기술] 추석 ‘농로 내비 대란’…”AI 맹신이 몰고 올 위기 보여줬다”

[인공지능 기술] 추석 ‘농로 내비 대란’…”AI 맹신이 몰고 올 위기 보여줬다”

추석 ‘농로 내비 대란’…”AI 맹신이 몰고 올 위기 보여줬다”

01. RAUPADEDEBAXRBUN472LZXRYUM.jpg
 
17일 스레드 ‘dsang3328’ 계정에 올라온 차량 행렬 사진. 농로에 차들이 갇혀있는 모습/ 스레드

추석 당일이었던 지난 17일 유명 내비게이션 애플리케이션 안내에 따라 길을 이동하던 차량 수십대가 충남 아산 일대의 농로에서 발을 묶이는 사건이 발생했다. 고속도로가 정체하자 이용자들이 모두 ‘다른 길’을 주문했고, 이에 네비게이션이 인근 농로를 안내했으나 정작 해당 도로의 정체 상황은 연산하지 못한 것이다. 이번 사태는 AI가 일상화한 시대에서 인간 고유의 사고(思考)를 포기하고 AI를 맹신할 경우 생길 수 있는 어두운 단면을 단적으로 보여주는 사례였다는 분석도 나온다. 작은 소동극에 불과할 수 있지만 갈수록 AI에 의존하는 인류 문명이 처할 수 있는 디스토피아적 면모를 구조적으로 보여줬다는 것이다.

지난 17일 소셜미디어 ‘스레드’에는 내비게이션 안내로 귀경길에 오른 차들이 충남 아산의 한 농로에 묶였다는 글과 사진이 계속 올라왔다. 한 네티즌은 “(내비게이션이) 논길로 가면 빠르다고 해서 왔는데, 모두 논길로 와서 앞으로도 뒤로도 갈 수 없는 상황이 만들어졌다”며 “합류 구간이 4군데나 있어 차량들을 끼워주다 보니 오래 걸릴 수밖에 없다. 빨리 가려다가 감옥에 갇혀 버렸다”고 했다. 그는 농로 5㎞가량을 빠져나오는데 3시간 이상 걸렸다고 주장했다. 또 다른 네티즌은 사진을 올리며 “(내비게이션에) 속은 차들” “이상한 농로로 보내서 1시간째 갇혀 있는 차들이 수백 대 늘어서 있다”고 했다.

실제로 고작 차량 한 대가 겨우 지날 수 있는 농로에 수백대의 차량이 줄지어 있고 그 양옆으로는 논밭이 펼쳐져 있는 모습은 기괴할 지경이었다. 이 장면은 충남 아산시 인주면에서 평택호 방향으로 가는 농로에서 나타난 사태였다.

02. NIPDAI5YARHAPCSJMA5IUPGMXM.jpg
 
지난 17일 스레드 ‘its.tours’ 계정에 올라온 차량 행렬 모습. 충남 아산시 인주면 인근 농로에 차량들이 정체돼 있다./ 스레드

일각에서는 AI 시대가 도래하면서 AI 맹신이 가져올 단면을 보여주는 사태였단 지적도 나온다. 특히 가장 빠른 경로를 분석해 알려주는 내비게이션·길찾기 기능을 탑재한 애플리케이션이 상용화되면서 사람들은 더 이상 길을 외우고 다니는 일이 줄어들었다. 차를 몰 때도 내비게이션 안내대로만 가지만 내비게이션이 잘못된 길을 안내해도 이를 시정하려는 시도를 하지 않고 그냥 안내대로만 가는 식이다. 서울 은평구에 사는 박모(22)씨는 “내비게이션 안내를 따르다 보면 종종 직감적으로 아는 경로와 다른 경로를 제공해 돌아가는 느낌이 들 때가 있다”면서도 “새 경로를 검색하기도 귀찮고 어찌 됐든 도착지까지는 안내할 테니 그냥 끝까지 안내를 따르는 것 같다”고 했다. 대중교통을 통한 길찾기를 할 때도 본인이 아는 환승 노선보다 이상한 조합으로 안내를 해주는 때가 있더라도 이를 맹신하는 경우들이 있다.

AI 맹신은 단순히 길찾기에서만 끝나지 않는다. 특히 네이버 파파고, deepL 같은 번역 서비스가 인기를 끌면서 사람들이 단순한 번역도 직접 하지 않고 번역기를 사용하고는 그 결과물을 원본과 대조조차 안 하고 실무나 대학 과제 등에 사용할 때가 많은데 생각보다 잘못된 번역들이 꽤 있다는 것이다. 강의 녹취 또한 마찬가지다. 보통 대학이나 직장에서 강의를 듣거나 장시간 업무 대화를 나눌 때 잊지 않기 위해 녹취를 하는 경우가 있는데 과거엔 이를 직접 들어봐야 했기에 처음 강의나 대화 때 더 집중해서 들었다면 이제는 AI가 자동으로 녹취를 풀어주는 시대가 돼 강의나 대화 때 집중을 안 하고도 녹취만 듣고 취사선택할 수 있는 시대가 됐다. 서울의 한 대학 교수는 “시험을 잘 치러 학업 이해도가 뛰어나다고 생각한 학생이 실제로 대화를 나눠보면 수업을 제대로 따라오지 못한 경우들이 갈수록 늘고 있다”며 “AI를 수업 이해에 활용하는 것은 좋지만 이에 지나치게 의존한다면 부정적 결과가 나올 것”이라고 했다.

03 https___author-service-images-prod-us-east-1.publishing.aws.arc.pub_chosun_94261168-589c-4ea3-8e05-c19a9fb29ca7.jpg

Loading

18 9월 2024

[openai, chatgpt] [써보고서] “정말 미쳤다”…오픈AI 新모델 ‘o1’ 추론 능력에 ‘감탄’

[openai, chatgpt] [써보고서] “정말 미쳤다”…오픈AI 新모델 ‘o1’ 추론 능력에 ‘감탄’

[써보고서] “정말 미쳤다”…오픈AI 新모델 ‘o1’ 추론 능력에 ‘감탄’

입력 
수정2024.09.13. 오후 2:37
우수한 수학·논리 추론 능력 ‘눈길’…긴 처리시간·횟수 제한 등은 아쉬워“다른 인공지능(AI)에게 물어봐도 한 번도 맞힌 적 없는 문제들을 한글로 한 번에 해결하네. 이 모델은 정말 미쳤다.”

13일 공개된 오픈AI의 인공지능(AI) 모델 ‘o1’에 대해 국내 관련 커뮤니티에서는 찬사가 이어졌다. 사용자들이 모델 성능을 비교하기 위해 넣었던 난해한 논리학 문제와 수학 문제들을 직접 생각하고 모두 해결했기 때문이다. 론칭 당일 새벽부터 모니터링하던 기자도 직접 다양한 테스트를 진행해 봤다.

추론과 수학 논리에 특화된 AI…뛰어난 문제 해결 능력 ‘눈길’

우선 간단한 실험으로 단어 내 특정 알파벳 개수를 세는 테스트를 진행했다. 기존의 거대언어모델(LLM) 대다수는 숫자 세기에 약점을 보였지만 ‘o1’은 ‘strawberry’에 포함된 ‘r’의 개수를 묻자 2초 만에 정확히 3개라고 대답했다.

‘o1’은 단어 ‘strawberry’의 ‘r’이 3개임을 2초만에 간파했다. (사진=챗GPT 캡처)
논리학 문제에서도 뛰어난 성능을 보였다. 멘사 등에서 사용하는 ‘아이의 나이 맞추기’ 문제를 제시하자 ‘o1’은 정확한 답을 도출했다.

문제는 러시아 수학자 이반과 이고르의 대화로, 아들들의 나이의 곱이 36이고 합이 오늘 날짜라는 힌트를 기반으로 아들들의 나이를 추론하는 것이었다. 기존 GPT-4 모델은 오답을 제시했지만 ‘o1’은 아들들의 나이가 1, 6, 6이며 오늘 날짜가 13일임을 정확히 맞혔다.

또 복잡한 추리 문제가 포함된 도난 사건에서도 ‘o1’은 정확한 범인을 지목했다. 여러 용의자의 진술과 거짓말이 섞인 상황에서 ‘찰리’와 ‘존무드’가 범인임을 밝혀내며 논리적 추론 능력을 입증했다.

논리학 도둑 문제를 수월하게 해결한 ‘o1’ (사진=챗GPT 캡처)
일상에서 사용하지 않는 논리학 문제 대신 복잡한 문장의 해석 능력도 확인해 봤다. 한때 국내에서 밈이 됐던 “나 아는 사람 강다니엘 닮은 이모가 다시 보게 되는 게 다시 그때처럼 안 닮게 엄마 보면 느껴지는 걸 수도 있는 거임? 엄마도?”라는 난해한 비문을 제시하자 ‘o1’은 그럴듯한 해석을 내놓았다.

‘o1’은 화자의 말을 “강다니엘을 닮은 이모를 다시 보았을 때 예전만큼 닮았다고 느끼지 못했다”며 “이런 느낌이 어머니를 본 후에 생긴 것일 수 있는데, 어머니도 같은 생각을 하시는지 궁금하다”는 뜻으로 해석했다.

강다니엘 문제를 해결하는 ‘o1’ (사진=챗GPT 캡처)
이처럼 ‘o1’은 복잡한 문장의 의미를 자연스럽게 이해하고 해석하는 능력을 보여줬다.

막대한 토큰 사용 추정…응답 시간과 사용 횟수 제한은 아쉬워

일부 아쉬운 부분도 있었다. 간단한 질문에도 응답 시간이 10초 이상 소요되는 경우가 있어 실시간 활용에 제약이 있었다.

국내 커뮤니티 유저 한 유저는 ‘고맙다’는 답을 듣기 위해 10초가 소요됐다는 비판을 제기한 바 있다.

‘O1’은 아주 간단한 답변에도 지나치게 길게 생각하는 경향을 보이기도 했다. (사진=특이점이 온다 갤러리 캡처)
또 일주일에 30회로 제한된 사용 횟수는 실제 업무나 연구에 활용하기에는 부족한 면이 있었다. 실제로 기자가 15번 이상 ‘o1’을 사용하자마자 경고창이 떴다.

“미리 보기의 응답이 15개 남았습니다. 한도에 도달하면 2024년 9월 20일로 재설정될 때까지 응답이 다른 모델로 전환됩니다.”

마지막으로 일반 사용자들이 수학이나 복잡한 논리 문제를 자주 접하지 않는다는 점에서 이러한 고급 기능이 얼마나 대중적으로 활용될지는 지켜봐야 할 부분이다. 단 프로그래머나 수학 연구자 등 전문 분야에서는 큰 도움이 될 것으로 예상된다.

‘o1’의 대답은 일주일에 30회로 제한된다. (사진=챗GPT 캡처)
‘o1’ 출시로 AI의 추론 능력이 한 단계 도약한 것은 분명하다. 향후 응답 속도 개선과 사용 제한 완화가 이루어진다면 다양한 분야에서 혁신적인 활용이 기대된다. 특히 수학적 계산과 논리적 추론이 필요한 분야에서 큰 변화를 가져올 것으로 보인다.

샘 알트만 오픈AI 대표는 ‘o1’의 출시에 대해 “새로운 패러다임의 시작”이라며 “AI는 이제 다양한 목적으로 복잡한 사고를 할 수 있게 됐다”고 평가했다.

Loading

14 9월 2024

[인공지능 기술] 번역기도 안 통하던 한국어 리뷰, 이제 챗GPT가 다 읽는다.

[인공지능 기술] 번역기도 안 통하던 한국어 리뷰, 이제 챗GPT가 다 읽는다.

번역기도 안 통하던 한국어 리뷰, 이제 챗GPT가 다 읽는다

인공지능(AI)에서 가장 앞선 기술을 보유한 미국의 오픈AI가 추론 능력이 크게 향상된 새 챗GPT ‘o1(오원)’을 13일 공개했다. 생성형 AI의 약점으로 꼽혀온 수학 문제 풀이 등 추론 영역의 성능이 크게 좋아졌다고 오픈AI는 밝혔다. 생성형 AI는 방대한 양의 데이터를 학습하고 대답을 하는 데 뛰어난 ‘암기왕’이다. 하지만 학습하지 않은, 예컨대 새로운 수학 문제는 제대로 풀지 못했다. 수학의 경우도 이미 배운 ‘기출 문제’에는 답을 내놓지만, 새로운 해법이 필요한 고난도의 수학 문제에는 약했다. 이번에 나온 오원은 여러 단계의 추론이 필요한 풀이 과정에서 실수를 하면 다시 바로잡으며 정답을 찾아 나갔다. 파이낸셜타임스(FT)는 “인간처럼 인지하고 사고하는 범용 AI(AGI) 발전에서 큰 진전을 이룬 것”이라고 했다.

01 JFIRBVJYC5MUNIYEKRAIA2O7OM.png
 
오픈 AI 로고. /로이터 연합뉴스

◇오픈AI, 수학 잘 푸는 새 모델 공개

‘o1′은 그동안 오픈AI가 ‘스트로베리’라는 코드명으로 개발해온 AI 모델이다. 대규모 언어 모델(LLM)인 생성형 AI는 특성상 가장 확률이 높고 그럴듯한 답을 제시하는데, 정확한 답을 내야 하는 수학 영역에서 약점을 보였다. 오픈AI의 직전 모델인 GPT-4o(포오)도 국제 수학 올림피아드 예선 시험 문제 풀이 정답률이 13%였다. 이번에 출시된 ‘o1′은 이를 83%까지 끌어올렸다. 오픈AI는 “물리학자들이 복잡한 수학 공식을 만들고 의료 연구자들의 실험을 지원하는 데 도움이 될 것”이라고 했다. 다만 속도는 다소 느리다. 단계적인 추론 과정이 필요하기 때문이다.

02 D6VRKV77UZFNZABSHFKVOJJB4Q.png
그래픽=송윤혜

또 ‘o1′ 개발 과정에서 생성형 AI가 데이터를 스스로 학습(딥러닝)하고 결과를 내놓는 과정을 이해하는 실마리도 찾았다. 지금까지 생성형 AI가 어떻게 내부에서 작동해 질문에 대한 답을 찾는지 알 수가 없었다. 이를 ‘AI의 블랙박스 문제’라고 하는데, AI가 인간의 통제를 벗어날 수 있다고 우려하는 이유 중 하나였다. 하지만 이번 새 GPT 버전이 추론을 하는 과정에서 이에 대한 힌트를 얻었다는 것이다. 미라 무라티 오픈AI 최고기술책임자는 “우리는 모델의 생각 과정을 볼 수 있었다”며 “AI의 작동 방식을 이해하는 데 도움이 됐다”고 FT에 말했다. 요슈아 벤지오 캐나다 몬트리올대 교수 등 AI 권위자들도 팩트(사실)를 조합해서 논거를 만들고, 결론에 도달하는 추론 영역이 AI가 범용 AI로 나아가기 위해 가장 큰 장애물로 보고 있다. 최근 오픈AI뿐 아니라 구글, 앤스러픽 등 생성형 AI 개발사들도 추론을 할 수 있는 모델을 개발 중인 것으로 알려졌다.

03 3FJZPTWK5JAGHFZH4VJGD5HAUQ.png
 
/챗GPT o1 프리뷰

◇투자 유치에도 탄력받을 듯

새 GPT인 ‘o1′은 유료 이용자를 대상으로 13일부터 서비스를 시작했다. 챗GPT 앱 내에서 ‘o1′과 속도가 좀 더 빠르지만 텍스트로만 답하는 ‘o1 미니’를 선택해 이용할 수 있다.

이날 오픈AI는 한국어를 예시로 추론 능력을 뽐내기도 했다. 그동안 번역기가 인식하지 못했던 한국어 문장을 영어로 번역하는 모습을 공개한 것이다.

“직우상 얻떤 번역깃돋 일끌 슈 없쥐많 한국인듦은 쉽게 앗랍볼 수 있는 한끌의 암혼화 방펍잇 잊다”(지구상 어떤 번역기도 읽을 수 없지만 한국인들은 쉽게 알아볼 수 있는 한글의 암호화 방법이 있다)라는 문장을 “No Translator on Earth can do this, but Koreans can easily recognize it”이라고 번역했다. 언어 추론 능력도 그만큼 좋아진 것이다.

오픈AI는 추론 능력을 대폭 업그레이드하고, GPT5 등 차기 언어 모델을 개발하기 위해 대규모 자금 유치에 나섰다. 이번 ‘o1′ 발표가 투자 유치에 긍정적 영향을 미칠 것이라는 전망도 나온다. 뉴욕타임스는 “오픈AI가 1500억달러(약 200조원) 규모의 기업 가치로 65억달러를 모금하기 위한 투자 협상 중”이라고 보도했다.

 
장형태 기자
전 인도특파원, 테크부 반도체 담당. 성장하는 곳의 이야기를 담습니다.

[출처] https://www.chosun.com/economy/tech_it/2024/09/13/7QKL6O5X55EULACDRYH5AYSK7Q/

Loading

14 9월 2024

[국어 국문학] [사자성어]고진감래(苦盡甘來), 고난 끝에 달콤함이 온다 (고생끝에 낙이 온다)

[국어 국문학] [사자성어]고진감래(苦盡甘來), 고난 끝에 달콤함이 온다 (고생끝에 낙이 온다)

[사자성어] 고진감래(苦盡甘來)

사자성어는 우리 생활과 가까이 있으면서도 깊은 지혜를 담고 있습니다. 그 중 ‘고진감래’는 특히 우리의 삶에서 많은 위로와 희망을 주는 말입니다. ‘고진감래’는 어려움을 겪은 끝에는 반드시 기쁨이 온다는 뜻으로, 인생의 어려움을 극복하고 희망을 찾는데 큰 도움이 됩니다.

고진감래

    어원

‘고진감래’는 ‘고(苦)’ ‘진(盡)’ ‘감(甘)’ ‘래(來)’의 네 개의 한자로 이루어져 있습니다. 각각 ‘고통’, ‘다하다’, ‘달다’, ‘오다’라는 뜻을 가지고 있습니다. 따라서 이를 합쳐 ‘고통이 다하면 달콤함이 온다’라는 뜻을 가집니다. 이 사자성어의 어원은 고대 중국의 이야기에서 비롯되었습니다. 당시 사람들은 농사일에 힘들게 고생한 끝에 결실을 맺는 모습에서 이 사자성어를 창출하였습니다. 이는 우리 인생의 어려움을 극복하고 희망을 찾는 과정을 잘 나타냅니다.

    의미

‘고진감래’는 우리 삶에서 어려움을 겪은 뒤에는 반드시 좋은 일이 온다는 희망찬 메시지를 전하는 사자성어입니다. 이 사자성어는

우리에게 우리 인생의 어려움을 극복하고 희망을 찾는 방법을 제시해줍니다. ‘고진감래’의 의미를 이해하고, 그 정신을 삶에 적용하면 우리는 인생의 어려움을 극복하고 희망을 찾는 방법을 배울 수 있습니다. 이 사자성어는 우리에게 더 나은 인생을 살아가는 방향을

제시해줍니다. ‘고진감래’의 정신을 기억하고, 이를 통해 더 나은 인생을 살아가는데 도움이 되기를 바랍니다. 이제부터는 어떠한

어려움이 와도 ‘고진감래’의 정신을 가지고 극복하며 살아가길 바랍니다. ‘고진감래’를 통해 우리 모두는 어려움을 극복하고 희망을

찾는 여정을 이어나갈 수 있을 것입니다.

[출처] https://coolove81.tistory.com/43

Loading