12 4월 2024

[인공지능 기술] 2024년은 온디바이스 AI 시대, 왜 ‘AI PC’는 지금 주목받나?

[인공지능 기술] 2024년은 온디바이스 AI 시대, 왜 ‘AI PC’는 지금 주목받나?

2024년은 온디바이스 AI 시대, 왜 ‘AI PC’는 지금 주목받나?

입력
인공지능(AI)이 전 세계 컴퓨터 시장을 달구고 있지만, 이는 갑작스러운 전개가 아닌 필연적인 흐름이다. 현대 컴퓨터의 아버지 ‘앨런 튜링’은 AI라는 단어가 등장하기도 전인 1950년, ‘계산 기계와 지능(Computing machinery and intelligence)’이라는 논문을 통해 컴퓨터로 동작하는 가상의 지능이 등장할 것을 시사했고, 1956년 다트머스 회의에서 AI라는 용어와 개념이 자리 잡았다.

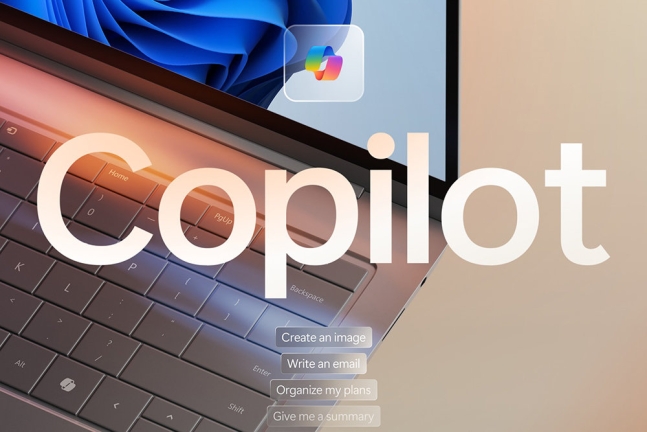
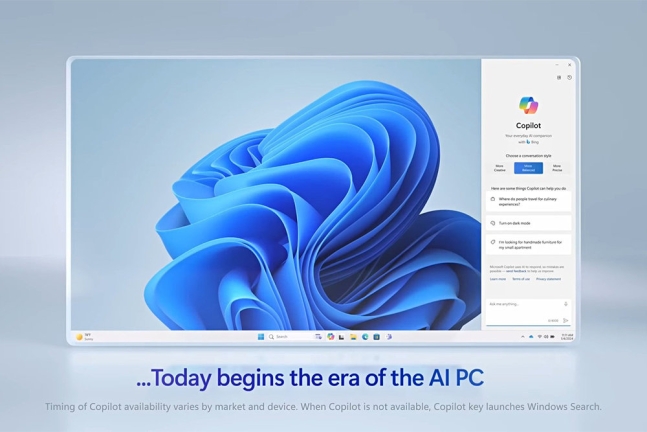
2024년, 거의 모든 PC 관련 기업들이 AI PC를 슬로건으로 밀고 있다 / 출처=마이크로소프트

2024년, 거의 모든 PC 관련 기업들이 AI PC를 슬로건으로 밀고 있다 / 출처=마이크로소프트
물론 반도체가 눈부시게 발전하며 2000년대까지는 슈퍼컴퓨터와 시뮬레이션에 컴퓨터 공학적 역량이 집중되었으나, 90년대 중반부터는 리처드 벨먼 교수의 기계 제어를 위한 강화학습, 제프리 힌튼 교수의 심층신경망 기술 제안 등이 잇따르며 가능성이 커져왔다. 이어서 2016년, 구글 딥마인드와 이세돌의 바둑 대결로 전 세계인이 AI의 가능성을 목격했고, 22년 11월 오픈 AI가 GPT-3를 내놓으며 비로소 AI가 IT 시장의 핵심으로 등장했다. 그 직후 시장에서 제시한 방향성이 바로 온디바이스 AI, AI PC다.

가장 진보한 AI의 발전상, AI PC의 현재 상황은?

2023년 AI 시장의 핵심은 AI 그 자체였다. 엔비디아를 비롯한 AI 하드웨어 기업들은 새로운 기술과 고성능을 갖춘 제품을 내놓기 바빴고, 개발자들은 빅데이터를 수집해 AI 모델을 구축하고, 이를 활용해 추론하고 후처리에 이르는 모든 과정에 투입됐다. 일반인들을 위한 AI 시장이 대중화하진 않았으나, GPT를 비롯한 다양한 생성형 AI들이 모든 산업을 관통했다.

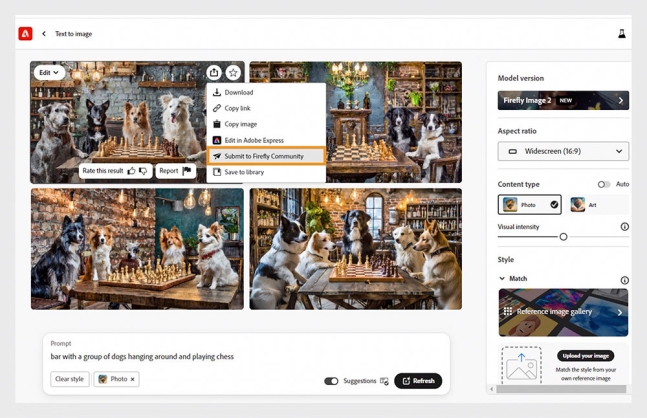
어도비의 생성형 AI 파이어플라이 생성 화면, 온디바이스 AI가 아닌 어도비 클라우드 서비스로 연결해 처리한다 / 출처=어도비

어도비의 생성형 AI 파이어플라이 생성 화면, 온디바이스 AI가 아닌 어도비 클라우드 서비스로 연결해 처리한다 / 출처=어도비
문제는 이 모든 과정이 클라우드 및 데이터 서버를 거쳐야 한다. AI 모델은 데이터를 매개변수 형태로 가공해서 저장하고, 필요할 때 내놓는 형태다. 이를 위해 막대한 양의 저장공간과 실시간 하드웨어 자원, 즉 데이터 서버가 필요하다. 지금도 대다수 AI 기능은 데이터 서버와 클라우드로 연결돼 동작하며, 네트워크가 없으면 AI 기능을 쓰기 어렵다.

하지만 데이터 서버 구축은 대규모 자본은 물론 구동과 냉각을 위한 전력도 계속 필요하다. 장기적으로 AI 제공 기업의 부담은 커지고, 과부하도 생긴다. 그래서 업계에서는 말단 장치가 AI를 자체 구동하는 온디바이스 AI로 데이터 서버의 부하를 분산하고 있으며, AI PC 역시 이를 위해 등장한 제품군이다. 즉 AI PC는 AI 연산 집중에 따른 서버 부하를 줄이고, 사용자가 통신없이도 간단한 AI 소프트웨어나 애플리케이션, 개발 작업에 쓰기 위한 제품이다.

가트너, 2024년 말까지 전체 PC 중 22%가 AI PC로 예상

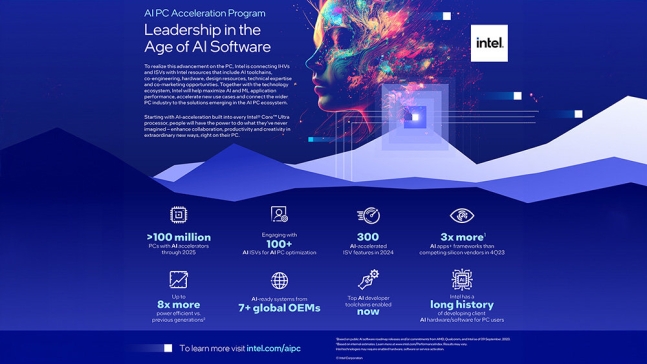
주요 프로세서 제조사들이 AI PC의 가능성에 눈을 뜨면서 시장 점유율은 빠르게 늘고 있다. 글로벌 연구 조사 기업 IDC는 AI PC가 올해 전체 PC 출하량의 약 20%인 5000만 대가 출하될 것으로 예측하며, 2027년에는 전체의 60%인 1억 6700만 대가 출하될 것으로 본다. 이미 지난해 12월 인텔 코어 울트라가 출시되며 신제품 노트북이 AI PC로 판매되기 시작했고, 인텔은 2025년까지 약 1억 대의 AI PC를 출하하겠다고 발표했다.

인텔 AI PC의 핵심은 신경망 처리 장치(NPU)다. 오늘날 많은 AI는 GPU의 부동소수점 연산 처리로 구동된다. 하지만 GPU는 AI 용도가 아닌 그래픽 처리용 반도체여서 전력 효율이 크게 떨어진다. NPU는 AI 처리를 위한 반도체로 전력 및 작업 효율이 훨씬 좋다. 현재 인텔 코어 울트라 등의 AI PC는 기존처럼 CPU와 GPU는 물론 NPU까지 탑재한다.

인텔 코어 울트라 5가 탑재된 PC와 13세대 인텔 코어 i5가 탑재된 PC / 출처=IT동아

인텔 코어 울트라 5가 탑재된 PC와 13세대 인텔 코어 i5가 탑재된 PC / 출처=IT동아
인텔 코어 울트라 라인업은 13세대 인텔 코어 제품군과 비교해 UL 프로키온 AI 추론 기능과 어도비 라이트룸을 활용한 AI 사진 편집은 약 1.5배, 어도비 프리미어 프로 AI 비디오 편집 기능은 약 2.2배, 스펙 뷰포트 2020 SNX 등의 엔지니어링 기능에서는 최대 12.1배까지 성능이 차이 난다. 그러면서도 전력 효율은 에너지스타 8.0 요구사항보다 최대 64% 낮고, 마이크로소프트 팀즈 미팅 시 11% 전력을 덜 쓰는 등의 이점이 있다. GPU 성능이 좋아지면서 실사용 성능이 향상되는 부분도 있지만, AI 처리에 최적화된 NPU의 영향도 상당하다.

점차 늘고 있는 AI PC 활용, 현시점 활용도는?

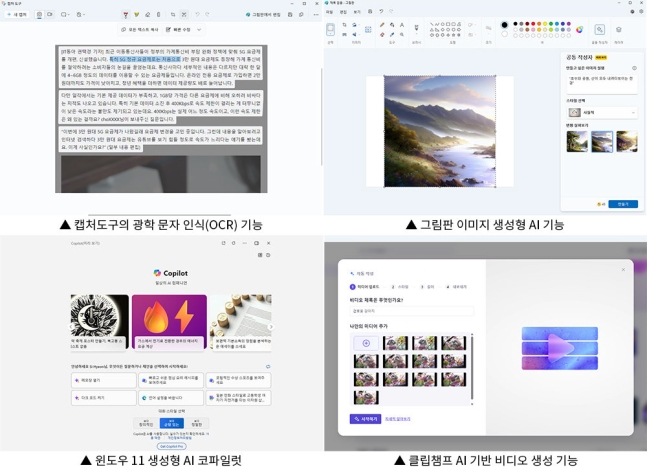
현재 윈도우 11에서 쓸 수 있는 AI 기능, 클라우드에서 연산을 처리하므로 AI PC가 아니더라도 쓸 수 있다. 물론 AI PC 최적화가 적용되면 오프라인에서도 효율적으로 이런 기능들을 쓸 수 있게 된다 / 출처=

현재 윈도우 11에서 쓸 수 있는 AI 기능, 클라우드에서 연산을 처리하므로 AI PC가 아니더라도 쓸 수 있다. 물론 AI PC 최적화가 적용되면 오프라인에서도 효율적으로 이런 기능들을 쓸 수 있게 된다 / 출처=IT동아
사용자들 사이에서는 여전히 AI 기능이 시기상조라는 시각도 있지만, 윈도우 11처럼 발빠르게 AI PC 시대를 준비하는 플랫폼도 있다. 예를 들어 윈도우 11에는 코파일럿을 비롯한 다양한 AI 기능이 내장되고 있으며, 누구나 쓸 수 있다. 코파일럿은 GPT 기반의 생성형 AI로 대화를 통한 질문, 검색이나 글 작성, 이미지 콘텐츠 제작, 윈도우 기능 실행 등을 수행한다. 또 캡처 도구에는 AI 기반의 광학 문자 인식이 탑재돼 이미지 내 글씨를 복사할 수 있고, 그림판에도 AI 배경 제거나 명령어 기반의 이미지 생성형 AI 기능이 추가됐다. 이외에도 많은 AI 기능들이 단계적으로 추가될 예정이다. 현재 시점에서는 네트워크가 필수지만, 추후 NPU에 최적화되면 장치 자체에서 수행한다.

올해 말이면 오프라인 AI PC에서 쓸 수 있는 AI 기능들이 많아질 전망이다 / 출처=마이크로소프트

올해 말이면 오프라인 AI PC에서 쓸 수 있는 AI 기능들이 많아질 전망이다 / 출처=마이크로소프트
아울러 챗GPT나 클로드AI, 라마(Llama), 구글 재미나이 같은 언어 모델을 개발하는 조건에도 앞으로는 AI PC가 더 유리해질 것이다. AI 개발 자체는 이전 세대 고성능 PC로도 할 수 있지만 전력 효율이 떨어진다. 가벼운 작업이고, 전력 효율까지 고려한다면 NPU를 내장한 AI PC에서의 작업이 더 유리하다. AI 기업 업스테이지는 지난 2월, LG전자와 손을 잡고 자체 언어모델 ‘솔라’를 LG 그램에서 온디바이스 AI로 적용하겠다는 발표도 했다. 올해 혹은 내년에는 챗 GPT같은 언어모델을 오프라인 AI PC에서도 쓰게 될 전망이다.

추후 PC 생태계는 AI인가, AI가 아닌가로 나뉠 것

지금까지 PC 성능을 결정짓는 요소는 컴퓨터의 처리 성능이었다. 하지만 AI PC 시대가 도래한 시점부터는 PC 성능은 물론 얼마나 많은 AI 기능과 소프트웨어를 지원하는지도 중요해질 것이다. AI PC 생태계가 올해 막 시작된 만큼 여전히 보여줄 게 많진 않으나, 챗GPT가 보여준 것처럼 PC 기반 작업에서 기대 이상의 결과와 혜택을 제공할 것이다. 이를 누리려면 새 PC를 살 때 NPU를 탑재한 AI PC를 선택하는 게 합당하다.

인텔은 오는 2025년까지 1억 대 이상의 PC에 AI 기능을 제공하겠다는 목표를 세웠다 / 출처=인텔

인텔은 오는 2025년까지 1억 대 이상의 PC에 AI 기능을 제공하겠다는 목표를 세웠다 / 출처=인텔
이미 인텔은 물론 AMD에서도 라이젠 AI 엔진을 탑재한 노트북을 출시했고, 퀄컴 역시 올해 중 스냅드래곤 X 엘리트 기반의 AI PC를 출시한다. 애플 역시 하반기 중 AI 기능을 내재한 차세대 애플 실리콘으로 매킨토시 라인업을 재단장할 예정이다. 과거 어도비가 크리에이티브 클라우드를 도입하면서 소프트웨어 생태계가 SaaS 중심으로 재편된 것처럼, PC 업계 역시 AI PC로 나아가는 것이다.

단순히 마케팅 용어라며 경계하는 시각은 있다. 그럼에도 불구하고 AI는 여러 분야에서 제 기능을 증명했고, 발 빠른 이들은 이미 챗GPT를 비롯한 생성형 AI의 활용법과 시각을 공유하며 우위에 서고 있다. 여전히 많은 기능이 AI PC가 아닌 일반 PC로도 구현이 되지만, 변곡점을 지나면 AI PC의 활용도가 우세해질 것이다. AI PC의 세계는 누구에게나 열려있고, AI PC를 통해 더 많은 일들을 할 수 있다. 올해가 지나면, 더 이상 AI PC는 선택이 아닌 필수가 될 것이다.

IT동아 남시현 기자 (sh@itdonga.com)

[출처] https://n.news.naver.com/mnews/article/020/0003558763

Loading

7 4월 2024

[알아봅시다] 2024년 AI 업계를 달굴 핫 키워드 LAM(대규모 행동 모델)

[알아봅시다] 2024년 AI 업계를 달굴 핫 키워드 LAM(대규모 행동 모델)

[그림 1] LAM을 상상한 이미지 (출처 : 미드저니)

“2024년엔 진정한 에이전트(Agent, 복잡한 동적인 환경에서 목표를 달성하려고 시도하는 시스템)가 몰려온다.”

2023년은 대규모 언어 모델(LLM, Large Language Model, 이하 LLM) 기반의 생성형 AI(Generative AI)가 큰 물결을 일으켰던 해였습니다. 이제 AI는 이메일 작성, 이미지 생성, 검색, 코딩 등 다양한 분야에서 빼놓을 수 없는 기술로 자리 잡았는데요. 2024년, AI 업계에는 또 다른 물결이 일 것으로 보입니다. 바로 대규모 행동 모델(LAM, Large Action Model, 이하 LAM)입니다. LAM은 문자 그대로 사용자 행동 패턴을 학습해 웹과 앱을 직접 작동시킬 수 있는 AI입니다. LLM이 문장과 그림, 비디오 등을 생성하는 데에 특화돼 있다면, LAM은 언어적 유창성과 독립적 작업 수행 능력을 결합해 단순히 무언가를 생성하는 데 그치지 않고 직접 작업을 수행하며 인간을 대신해 줄 에이전트입니다.

이번 글에서는 LAM 기반의 제품 사례와 LAM의 등장으로 바뀔 미래 모습 그리고 LAM의 특징에 대해 살펴보겠습니다.

래빗 R1으로 본 디바이스의 미래

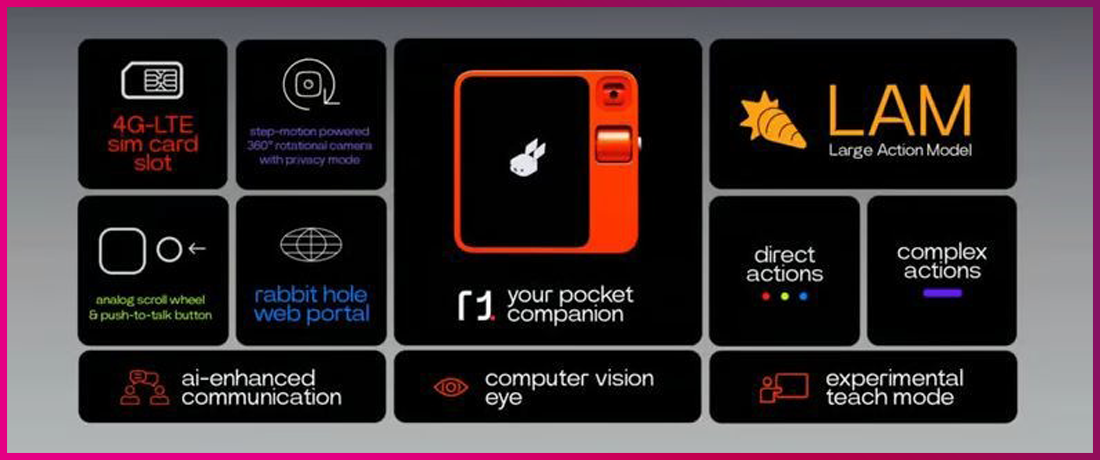
[그림 2] 래빗 R1의 스펙 : LAM, 음성인식, 컴퓨터 비전을 제공 (출처 : 래빗)

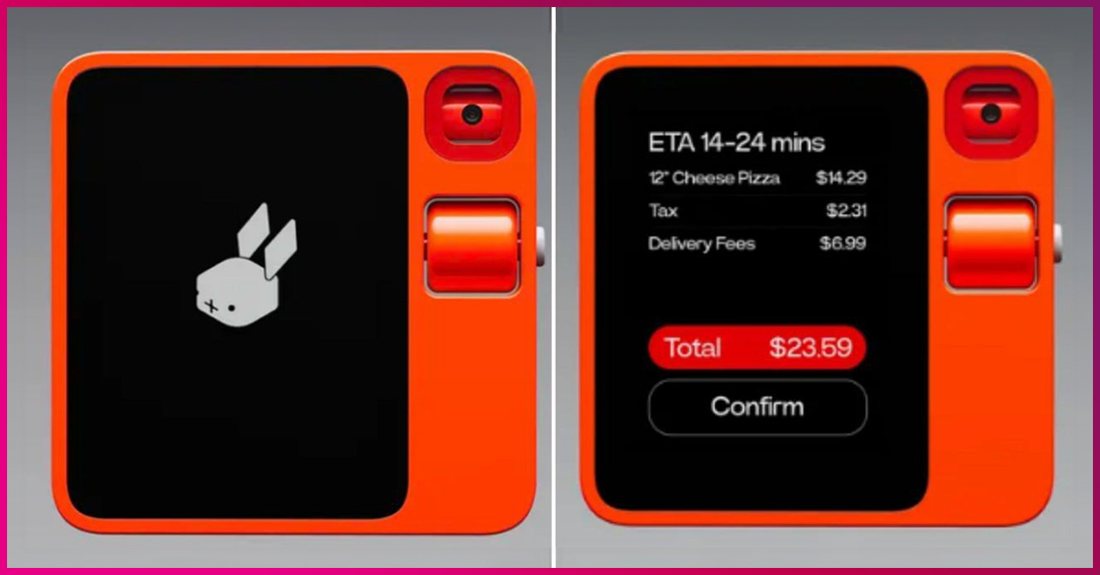
미국 라스베이거스 컨벤션센터에서 지난 1월 9일부터 12일까지 열린 세계 최대 IT 박람회 ‘CES 2024’에서 ‘래빗(Rabbit) R1(이하 래빗 R1)’이 AI 업계의 눈길을 끌었습니다. ‘래빗 R1’의 가격은 199달러로, 저렴한 대신 2.88인치의 터치스크린과 회전식 카메라, 휠로 움직이는 물리 버튼 등 장치 곳곳에 비용을 줄인 흔적이 있습니다. 프로세서는 2.3GHz 미디어텍(Media Tek)을 사용했고, 4GB 메모리에 128GB 스토리지를 장착했습니다. 또한 ‘래빗 R1’의 온스크린 인터페이스는 음악, 교통, 화상 채팅 등 카테고리별 카드로 구성된 것이 특징입니다.

현장 테크 관계자들의 미래 기술을 엿보았다는 평가와 함께, ‘래빗 R1’은 2024 CES에서 1만대 판매를 기록했습니다. ‘래빗 R1’은 LAM 기반으로 작동하는 자체 운영체제인 ‘래빗OS’를 탑재했는데요. 웹사이트, 앱, 플랫폼, 데스크톱 상관없이 서비스를 작동할 수 있는 콘트롤러의 역할을 합니다. ‘래빗 R1’을 활용해 음악을 재생하고, 식료품을 구매할 수 있으며, 문자 메시지를 보낼 수 있습니다. 예를 들어, 휴대폰으로 택시를 부른다면 우리는 앱을 열어 위치를 입력하고 차량을 확인한 뒤 기사를 호출해야 하는 등 수많은 클릭을 해야 하는데요. ‘래빗 R1’은 음성만으로 곧바로 택시를 호출할 수 있습니다.

[그림 3] ‘래빗 R1’에서 음성으로 피자를 주문하는 모습 (출처: 래빗)

‘래빗 R1’이 즉석에서 앱을 작동시킬 수 있는 이유는 사용자의 앱 사용 패턴을 AI가 학습했기 때문입니다. ‘래빗 R1’은 택시 호출 앱의 아이콘 모습, 주문 시점, 검색 메뉴, 위치 등을 학습했습니다. 아울러 ‘래빗 홀(Rabbit Hole)’이라는 웹 포털을 통해 다양한 작업을 수행할 수 있도록 지원하는데요. 음성 인식 기능을 갖춰 음성만으로 앱을 제어할 수 있고, 전용 트레이닝 모드로 각종 앱을 직접 훈련시킬 수 있습니다.

이런 디바이스가 현실 세계를 얼마나 파고들지는 알 수 없으나, 테크 업계에서는 이를 또 하나의 혁신적인 이벤트로 받아들였습니다. 챗GPT가 2023년 11월에 LLM이라는 새로운 세상을 열었듯, ‘래빗 R1’이 LAM의 시대를 여는 게 아니냐는 기대를 품고 있습니다. 아직은 단정 짓기 어렵지만 디바이스에 LAM이 부착되면 모든 행동이 자동화될 가능성이 큽니다.

인터넷을 바꿀 어뎁트의 ACT-1 LAM

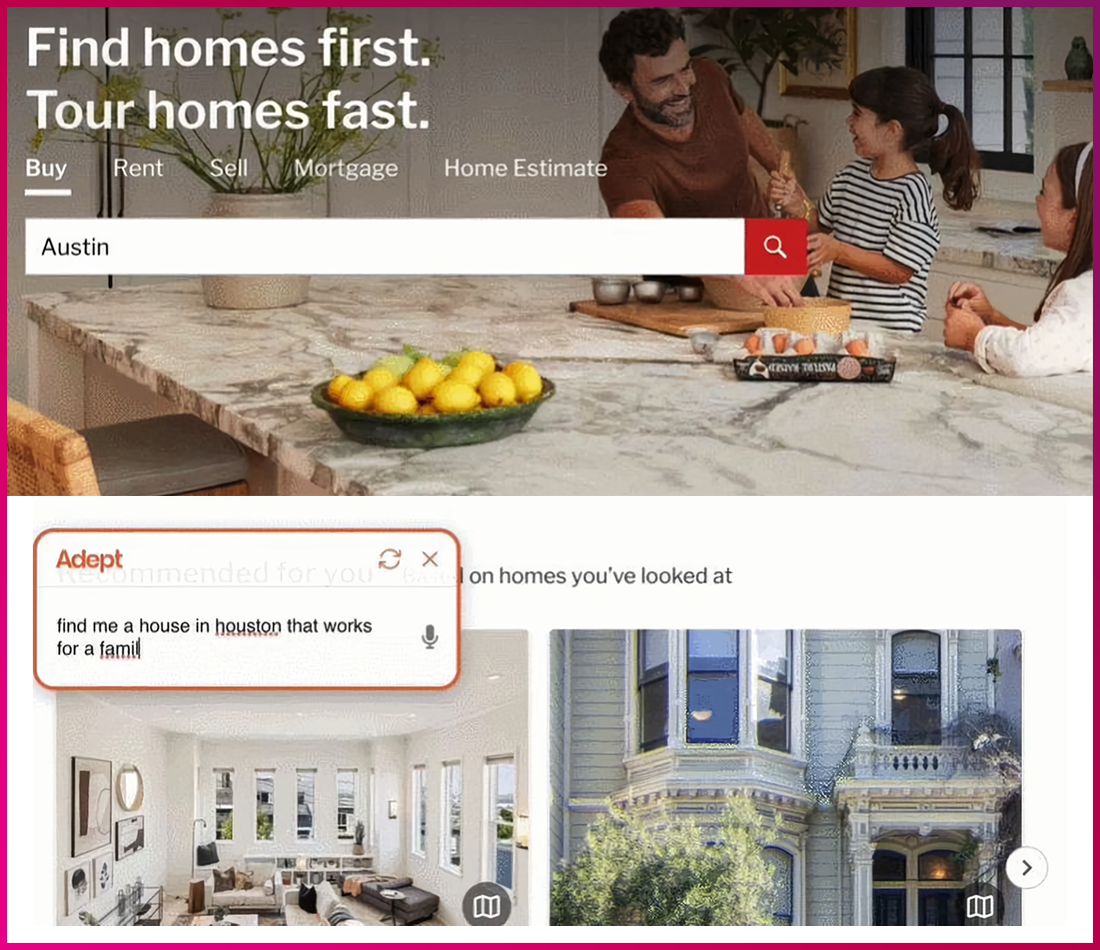
[그림 4] 어뎁트 ACT-1이 부동산 사이트를 작동시키는 모습 (출처 : ADEPT)

오픈AI에서 부사장으로 근무했던 데이비드 루안이 2022년 창업한 스타트업 어뎁트(ADEPT, 이하 어뎁트)도 있습니다. 어뎁트는 얼마 전 LAM 모델인 액션트랜스포머 ‘ACT-1’을 런칭했습니다.

‘ACT-1’은 디지털 도구를 사용할 수 있도록 훈련된 대규모 트랜스포머입니다. 특히 웹 브라우저 사용법을 학습해 주목을 받았는데요. 현재 ‘ACT-1’은 크롬 확장 프로그램에 연결돼 있습니다. 브라우저에서 일어나는 태스크(task, 작업 단위의 실행 단위)를 모니터링하고 클릭, 입력, 스크롤 등 다양한 동작을 수행할 수 있습니다. 어뎁트는 “모델링 측면과 소프트웨어 측면 모두에서, 더 빠르게 만들 수 있는 여지가 충분하다. 앞으로 인터넷에서 벌어질 일들은 사람이 거의 감지할 수 없을 것이고, 사용자가 원하는 것들은 입력 없이 실시간으로 이뤄질 것이다.”라고 설명했습니다.

1.png
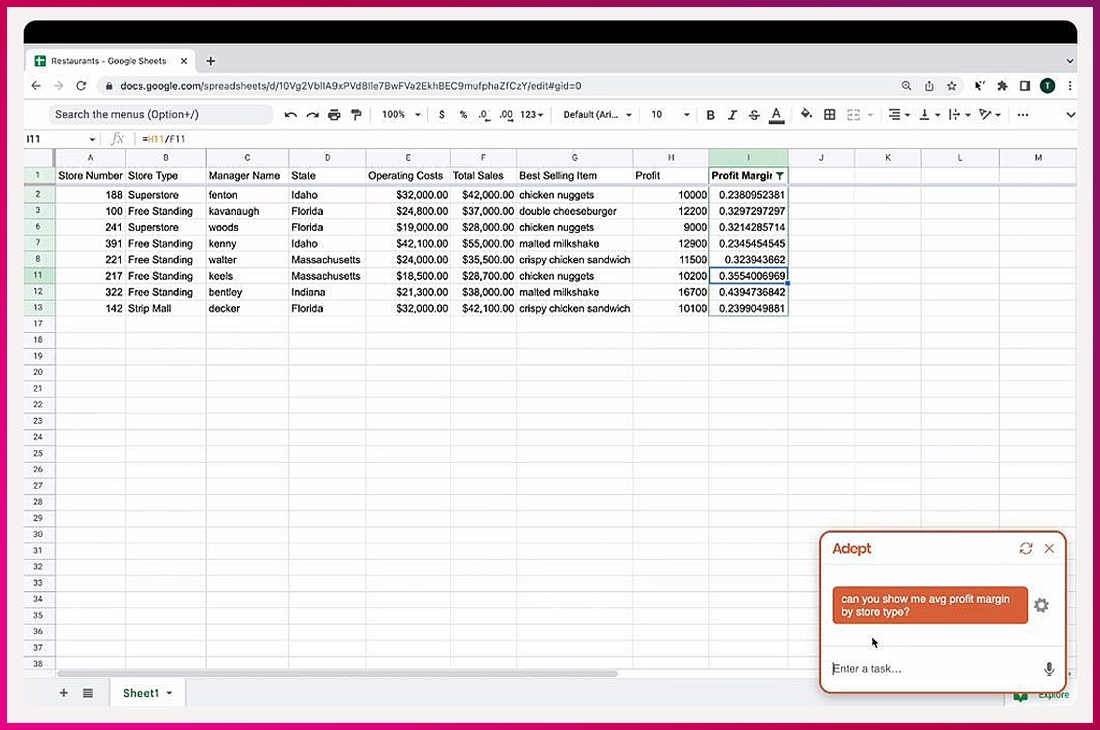
[그림 5] ACT-1에서 스프레드시트를 작동시켜 가게 별 영업 마진을 보여 달라고 요청해 엑셀을 정렬시킨 모습 (출처 : ADEPT)

현재 어뎁트의 ‘ACT-1’은 위젯 형태의 챗봇으로 사용 가능합니다. 사용자가 해당 웹페이지에서 원하는 것을 입력하면 ‘ACT-1’이 알아서 나머지를 처리하는 방식인데요. 예를 들어, 부동산 웹페이지인 레드핀(Redfin.com)에 접속해 원하는 매물을 찾는다고 가정하겠습니다. 그동안 매물을 찾을 땐 사람이 직접 원하는 가격대, 지역, 방 개수 등을 입력한 검색 결과로 판단해야 했는데요. ‘ACT-1’의 위젯 형태의 챗봇은 사용자가 원하는 조건을 입력하기만 하면 원하는 매물을 콕 집어서 추천합니다. 10회 이상 클릭해야 찾을 수 있던 부동산 매물 검색을 이제 문장 입력 한 번에 해결할 수 있게 된 것입니다.

더 놀라운 점은 생산성 도구에도 ‘ACT-1’을 사용할 수 있다는 사실입니다. 예를 들어 스프레드시트를 작업하려면 수많은 클릭과 수많은 입력이 필요하고, 스프레드시트의 고급 기능을 쓰려면 별도로 함수를 배워야 했습니다. 하지만 ‘ACT-1’은 문장을 입력하는 것만으로 셀을 정렬하고 원하는 코드를 삽입할 수 있습니다. 또 지메일에 ‘ACT-1’을 부착해 사용할 경우, 예약 이메일을 자동 발송할 수 있고, 위키피디아에 부착할 경우엔 원하는 정보를 추출할 수 있습니다. 앞으로는 LAM 챗봇으로 원하는 답변만 찾아낼 수 있습니다.

인간을 대신할 AI, LAM의 특징과 미래

지금까지 살펴봤듯이, LLM과 LAM이 결합될 경우 인간의 행동을 대신할 AI 에이전트가 탄생할 수 있습니다. 일례로, 마케팅 분야에서 LLM이 카피 작성, 이미지 생성, 웹 레이아웃 생성 등의 역할을 하면, LAM은 이 과정을 자동화할 수 있습니다. 즉, 음성이나 문자 입력만으로 AI가 마케팅 자료, 고객 데이터, LLM 등에 접근해 이를 직접 다루는 게 가능해지는 것입니다. LAM의 특징은 크게 세 가지입니다.

1. 고급 데이터 처리: LAM은 방대한 데이터 세트를 처리하고 분석할 수 있습니다. 광범위한 데이터 해석이 필요한 애플리케이션에 효과적입니다.

2. 효율적인 의사 결정: LAM은 정교한 알고리즘을 통해 의사 결정 과정을 자동화합니다. AI 시스템이 더 복잡한 작업을 효과적으로 실행할 수 있도록 지원합니다.

3. 확장성과 유연성: LAM은 확장성이 매우 뛰어납니다. 간단한 자동화부터 복잡한 문제 해결까지 다양한 앱에 적용할 수 있습니다.

이와 같은 특징을 가진 LAM을 챗봇에 접목한다면 어떻게 될까요? 현재 자동차 판매 사이트에 부착된 AI 챗봇은 학습한 데이터를 기반으로 사용자 질문에 답변하지만, LAM을 결합한 챗봇은 소비자가 원하는 차량을 판별해 예약 주문까지 수행합니다. 즉, 개인화가 가능해지는 건데요. 사용자의 인터넷 활용 패턴을 학습해 일상 업무를 자동화할 수도 있습니다. LLM이 은행 대출 초안을 작성했다면, LAM은 은행에 대출 서류를 발송하는 일까지 대신하게 되는 것이죠.

LAM 기술은 휴먼 컴퓨터 인터페이스(HCI, Human Computer Interface, 사람의 음성, 뇌파, 근육, 동작 등을 기계가 인식하는 것) 영역을 크게 뒤바꿀 것으로 보입니다. 지금까지 컴퓨터와의 상호작용은 그래픽 유저 인터페이스(GUI, Graphical User Interface, 사용자가 컴퓨터와 정보를 쉽게 교환하고 상호 작용하기 위해 아이콘 등과 같은 그래픽을 이용한 사용자 인터페이스)를 통해 이뤄졌는데요. 버튼의 위치, 하위 레이어의 위치 등을 알고, 이를 작동하기 위해 직접 사람이 움직여야 했습니다. LAM과같이 복잡한 소프트웨어는 시간을 들여 학습해야 하기 때문에 초기에는 오히려 구식으로 느껴질 수 있습니다. 하지만 앞으로의 LAM 기술은 초보자도 전문 지식 없이 자유자재로 사용할 수 있고, 고령자나 장애인도 디지털 장벽 없이 소프트웨어를 작동할 수 있도록 만들 것입니다. LAM이 AI 에이전트의 서막이라고 불리는 이유입니다.

[출처] https://www.lgcns.com/blog/it-trend/52597/

Loading

7 4월 2024

[알아봅시다] 디바이스에 들어온 AI, 빅테크 기업이 온디바이스 AI를 활용하는 방법

[알아봅시다] 디바이스에 들어온 AI, 빅테크 기업이 온디바이스 AI를 활용하는 방법

“웹은 사회적인 창조물에 가깝다. 웹의 힘은 모든 사람이 접근할 수 있는 그 보편성에 있다.”

월드와이드웹(WWW, World Wide Web, 인터넷을 통해 접근 가능한 공용 웹 페이지의 상호연결 시스템)을 창시한 ‘웹의 아버지’ 팀 버너스리(Sir Timothy John Berners-Lee)는 웹 3.0을 플랫폼이 아닌 ‘개인이 소유한 인터넷’으로 규정한 바 있습니다. 웹3 시대에는 피트니스 정보에서 쇼핑 패턴까지 모든 데이터를 ‘나만의 스토리지’에 저장하고, ‘나만의 인공지능(AI)’을 활용해 ‘나만의 삶’을 누릴 수 있을 것이라 본 것인데요. AI와 함께 대규모 언어 모델(LLM, Large Language Model)이 등장하면서 우리는 이러한 미래 인터넷의 가능성을 미리 엿볼 수 있었습니다. 인터넷 포털 검색이 아닌, 챗봇을 통해 문답을 주고받고, 자신만의 데이터를 활용해 나만을 위한 업무를 할 수 있게 된 것입니다.

AI 시대가 본격화되며 ‘온디바이스 AI’가 주목받고 있습니다. 간단한 AI는 디바이스와 에지 컴퓨팅에서 구동 시키려는 움직임이 나타나고 있는 건데요. 서버 기반의 AI는 막대한 전력을 소모하기 때문입니다. 오늘날 데이터센터는 전 세계 전력 사용량의 1~1.5%를 차지고 있는데요. 이에 전문가들은 향후 AI가 클라우드 / 에지 컴퓨팅 / 디바이스 3개 축으로 분화될 것으로 내다보고 있습니다. 그동안 AI가 클라우드 중심이었다면 이제는 하이브리드 AI로의 전환점을 맞이하고 있는 것이지요.

생태계를 확산시켜라! 빅테크 기업의 온디바이스 AI 전략

온디바이스 AI는 디바이스 자체 하드웨어를 활용해 AI 작업을 처리합니다. 이는 개별 디바이스에 가속기를 장착해 AI 모델을 더욱 효율적으로 구동시킬 수 있습니다. 또, 기존에는 클라우드 기반 AI에서 그래픽 처리 장치인 GPU(Graphics Processing Unit)가 중요했다면, 온디바이스 AI에서는 인공신경망인 NPU(Neural network Processing Unit) 칩이 중요합니다. NPU 칩을 활용하면 서버와 통신 없이 소모 전력을 적게 들이며 AI를 이용할 수 있기 때문입니다. 온디바이스 AI 생태계 확산을 위해 빅테크 기업들은 어떤 전략을 구사하고 있을까요?

• 구글

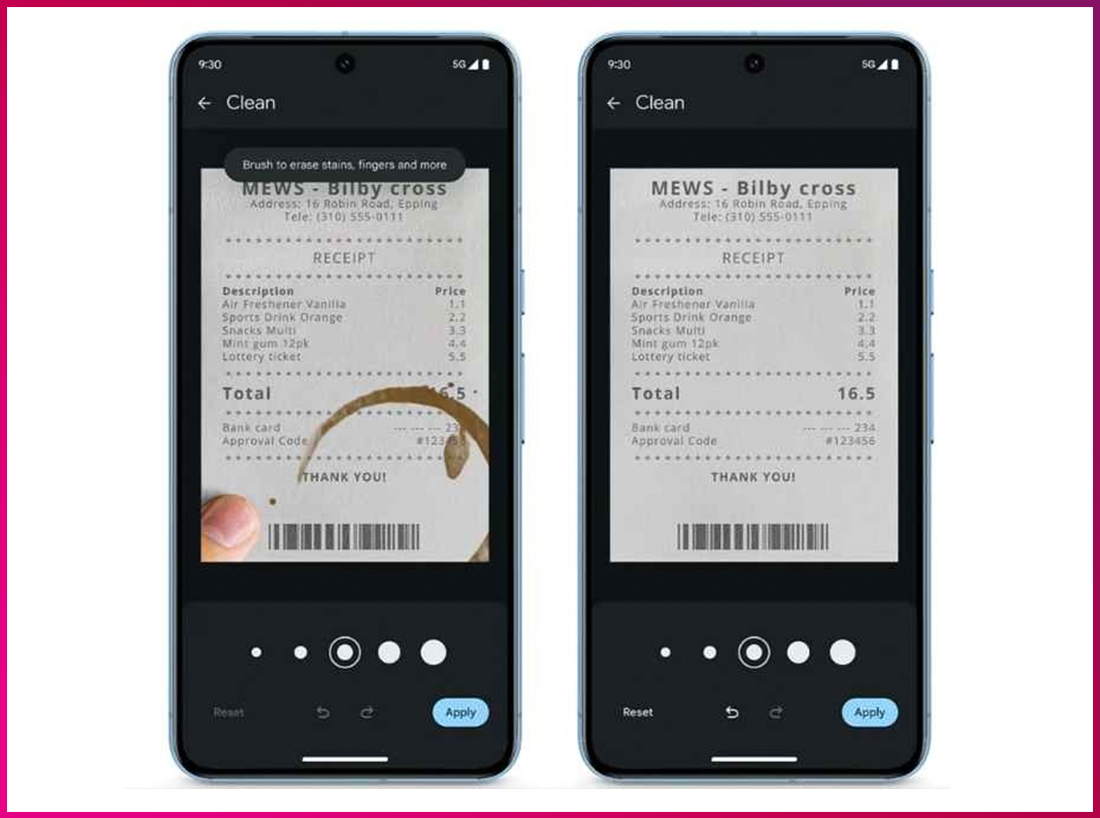
[그림 1] 구글 픽셀8 프로에 탑재된 AI ‘제미나이’ 나노를 활용해 영수증에 묻은 커피 얼룩을 삭제하는 모습

구글은 차세대 생성형 AI인 ‘제미나이(Gemini)’ 나노 모델을 스마트폰 픽셀8 프로에 탑재했습니다. 사용자의 민감한 데이터가 휴대폰을 벗어나지 않게 보호하고, 네트워크 연결 없이도 AI 기능을 사용할 수 있는데요. 특히 픽셀8 프로에는 ‘녹음 요약’과 ‘지보드(Gboard) 스마트 답장’ 기능이 강화됐습니다. ‘녹음 요약’ 기능은 녹음된 대화나 인터뷰, 발표 등을 요약하고, ‘스마트 답장’은 왓츠 앱 등에서 대화 내용을 자동 인식해 고품질의 응답을 제안합니다. 또한 새로운 AI 기반 도구들을 활용해 사용자에게 보다 더 많은 도움을 제공합니다. 예를 들면, 구글 텐서 G3를 이용해 비디오 색상, 조명 등을 조정하는 ‘비디오 부스트’, AI를 사용해 저조도나 야간에 촬영된 비디오의 선명한 디테일과 색상 제공하는 ‘야간 시야 비디오’와 같은 기능인데요. 구글은 애플의 iOS 생태계 확장에 제동을 걸기 위해 픽셀 스마트폰을 넘어 향후 태블릿, 스마트워치로 대상을 넓힐 예정입니다.

• 마이크로소프트(MS)

마이크로소프트(MS) 역시 AI를 활용해 윈도우 서비스와 검색 엔진 ‘빙(Bing)’ 강화에 나섰습니다. 특히 MS는 2024년 6월 차세대 AI PC ‘서피스 프로(Surface Pro)’ 태블릿과 ‘서피스 랩톱(Surface Laptop)’ 노트북을 출시할 예정입니다. 해당 제품 군은 생성형 AI ‘코파일럿’과 온디바이스 AI를 지원하는 것이 가장 큰 특징인데요. 윈도우 센트럴(Windows Central)에 따르면 서피스 프로 10과 서피스 랩톱 6에는 NPU가 장착됩니다. 윈도우 센트럴은 “130억 개 파라미터 AI 모델을 노트북에서 네트워크 없이 구동할 수 있다”고 설명했습니다. MS가 지난해는 ‘코파일럿’을 중심으로 한 AI 구축에 전력을 다했다면, 2024년에는 하드웨어 영역으로 확장할 것으로 보입니다.

• 애플

애플은 AI 영역에서 오픈소스 개방형 전략을 취하고 있습니다. 2023년 10월 차세대 AI 칩 ’M3’를 공개하며 온디바이스 AI 시대를 예고했는데요. 애플은 “M3 칩에 있는 뉴럴 엔진은 M1 칩보다 최대 60% 더 빠르다”며 “개인정보 보호를 위해 데이터를 개별 장치에 머무르게 하면서 AI와 머신 러닝 작동 흐름을 더욱 빠르게 만든다”고 강조했습니다. 특히 M3는 인간 두뇌에 해당하는 파라미터 수를 최대 수십억 개 지원합니다. IT 업계는 애플이 이를 기반으로 각종 AI 서비스를 구현할 것으로 전망하고 있습니다

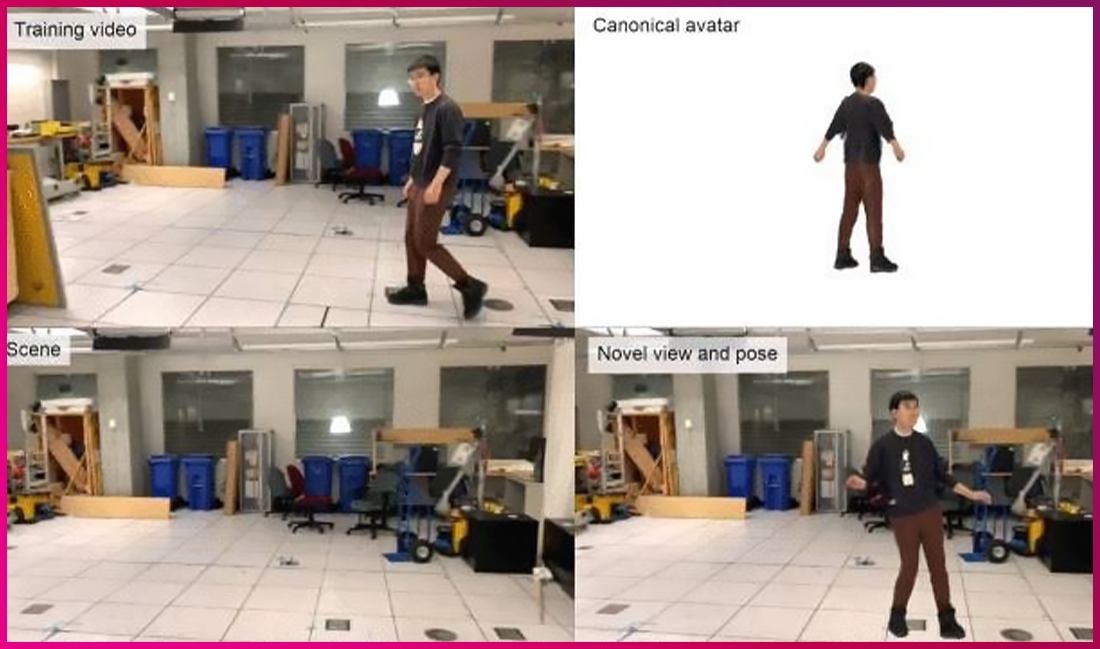
애플은 두 편의 논문을 아카이브에 공개하기도 했습니다. 첫 번째 논문은 휴먼 ‘가우시안 스플랫(HUGS, Human Gaussian Splats)’ 기술 사례가 대표적입니다. 동영상에서 배경과 인물을 분리하고 이를 다시 재활용하는 기술인데요. 예를 들어 눈밭을 걸어가는 사람 영상을 학습한 AI가 인물과 배경을 마음대로 조합할 수 있는 것입니다. 두 번째 논문은 ‘제한된 메모리로 효율적인 대규모 언어 모델을 추론하는 법(Efficient Large Language Model Inference with Limited Memory)’입니다. 이는 메모리가 제한된 기기에 LLM을 구축하는 기술입니다. 연구진은 이 방법을 활용해 애플 M1 맥스 CPU(Central Processing Unit, 컴퓨터 시스템을 통제하고 프로그램의 연산을 실행, 처리하는 가장 핵심적인 컴퓨터 제어 장치 혹은 그 기능을 내장한 칩)에서 추론 시간을 4~5배 앞당기고, 속도는 20~25배까지 향상할 수 있다고 설명했습니다.

[그림 2] 휴먼 가우시안 스플랫(HUGS, Human Gaussian Splats)을 활용해 동영상에서 인물과 배경을 분리하고 AI를 통해 인물을 조정하는 모습

또한, 깃허브를 통해 M3 칩에서 실행할 수 있는 프레임워크와 모델 라이브러리를 공개했습니다. 바로 MLX라 불리는 AI 개발 툴킷인데요. 애플의 머신 러닝 연구자인 아우니 한눈은 X(구 트위터)를 통해 MLX 데이터를 “데이터 로딩을 위한 프레임워크에 구애 받지 않는 효율적이고 유연한 패키지”라며 “MLX, 파이토치, JAX 프레임워크에서 함께 작동한다”고 설명했습니다. MLX는 파이토치, JAX와 같은 AI 프레임워크에서 영감을 얻은 것으로 보여집니다. 다만 공유 메모리에 대한 내용이 없다는 점에서 애플 반도체를 사용하는 맥북에 적합할 것이라는 평가도 있습니다.

온디바이스 AI 흐름에 응하는 LG

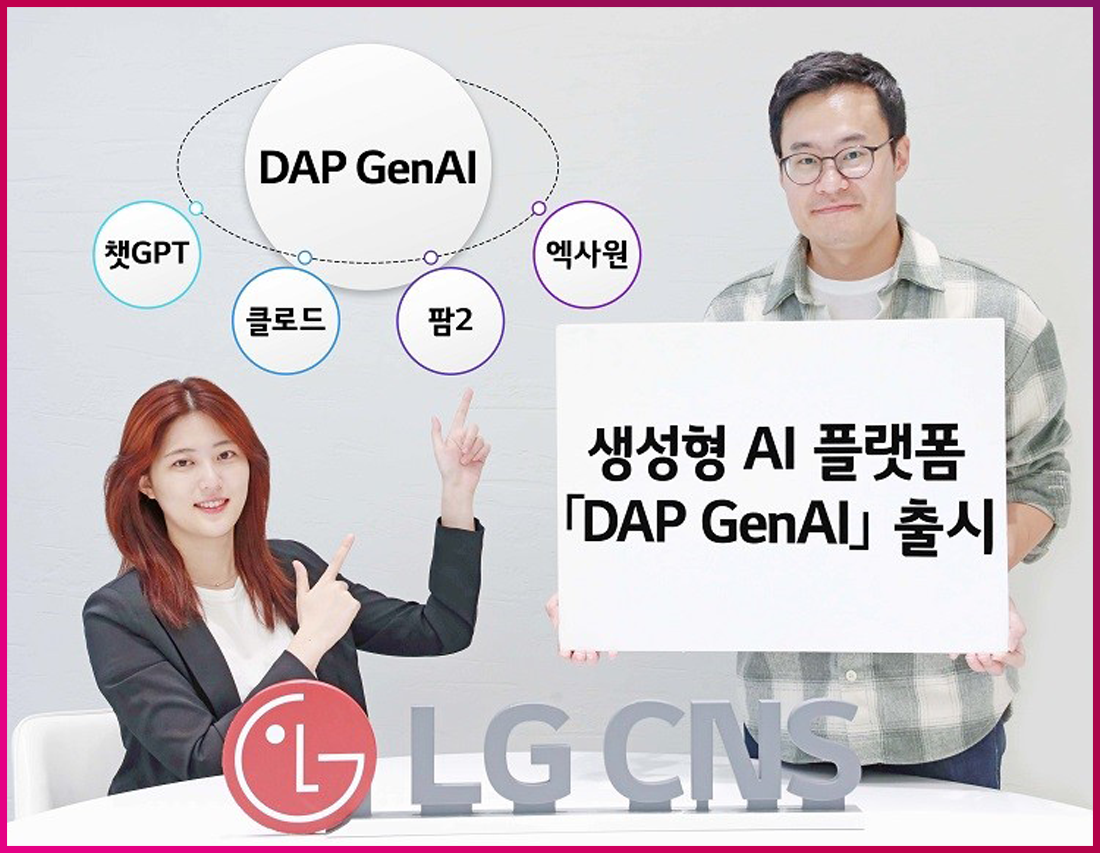
2020년 8월, LG CNS는 온디바이스 AI 솔루션 업체 ‘노타’에 일찌감치 투자했습니다. 노타는 딥 러닝 모델 경량화ᆞ자동화 솔루션인 넷츠프레소(NetsPresso)를 공개한 스타트 업인데요. 넷츠프레소는 성능 저하를 최소화해 스마트폰과 소형 IoT 기기에서 독립적으로 AI를 구동시킬 수 있다는 평가를 받고 있습니다. 최근에는 기업용 AI 서비스를 잇따라 선보이고 있는데요. 대표적으로 기업용 생성형 AI 플랫폼인 ‘DAP GenAI’가 있습니다. DAP GenAI는 기업이 가진 내부 정보만을 활용하고, 다양한 보안 필터 등을 적용해 거짓이나 왜곡된 내용을 생성하는 정보 왜곡현상(Hallucination)을 줄여 업무 효율을 높인 AI입니다. 이를 통해 오픈AI ‘챗GPT’, 엔스로픽의 ‘클로드(Claude), 구글의 ‘팜2(PaLM2), LG AI연구원의 ‘엑사원(EXAONE)’ 등 다양한 LLM을 활용해 서비스를 구축할 수 있습니다. 예를 들어 금융사가 보험상품 추천 AI 서비스를 개발하고 싶다면 고객 정보 데이터베이스를 연동해 알맞은 프롬프트를 구성하며 추천과 답변에 적합한 LLM을 각각 선택해 설정합니다.

[그림 3] LG CNS 직원들이 생성형 AI 플랫폼 DAP GenAI 출시를 소개하는 모습

2022년 LG전자는 스마트 온디바이스 AI칩인 ‘LG8111’을 개발해 공개했습니다. LG8111은 다양한 AI 가속 하드웨어 내장은 물론 2.4GHz와 5GHz 듀얼 밴드 와이파이를 지원해 인터넷에도 연결할 수 있습니다. 예를 들어 LG8111을 장착한 냉장고는 사용자 음성을 인식해 동작합니다. LG8111은 가전제품뿐만 아니라 스마트카, 스마트팩토리 등 다양한 영역에서 사용 가능합니다.

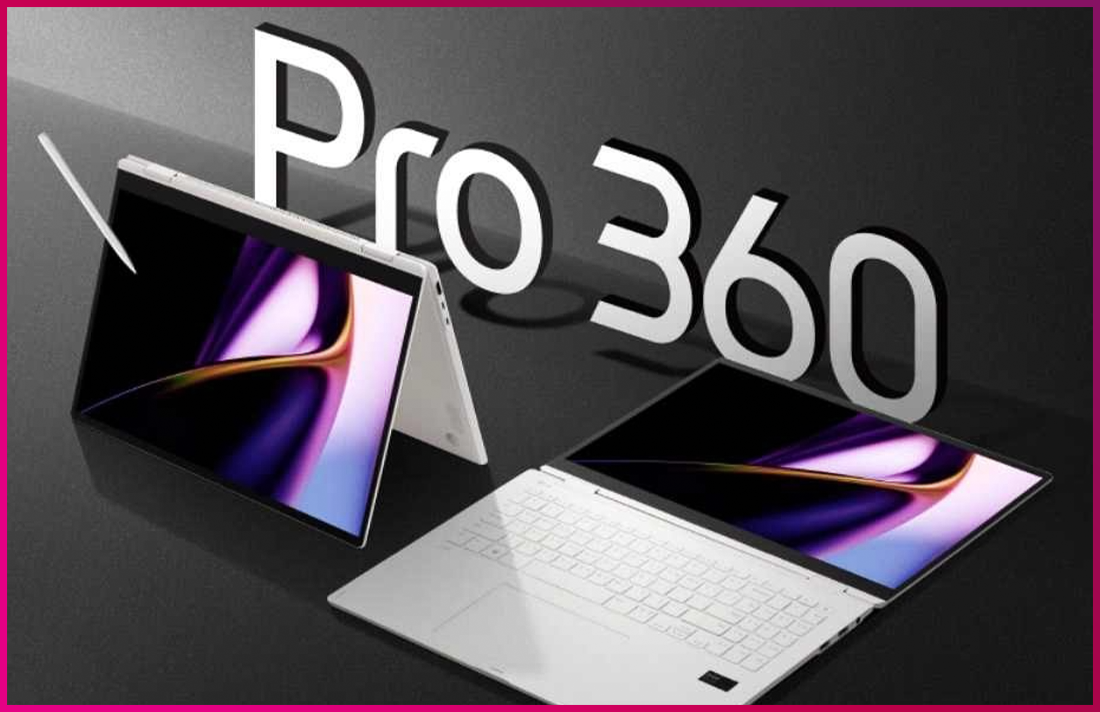
또한 LG전자는 AI 프로세서를 탑재한 2024년형 LG 그램 신제품 ‘LG 그램 프로’를 런칭할 예정입니다. LG 그램 프로(모델명: 17Z90SP/16Z90SP)에는 차세대 프로세서인 인텔 코어 울트라 CPU가 탑재됐습니다. 인공지능 연산에 특화된 NPU인 AI 부스트가 내장된 CPU인데, 네트워크 연결 없이도 AI를 구동할 수 있다는 장점이 있습니다. 예를 들어 사진을 분석해 인물 장소, 날짜 등 38개 카테고리에 따라 자동으로 분류해 낼 수 있습니다. 또한 제품에 탑재된 ‘AI 그램 링크’ 기능은 최대 10대까지 안드로이드 및 iOS 기기와 파일, 사진 등 파일을 편리하게 주고받거나 화면을 공유할 수 있도록 지원합니다. 여기에 더해 엔비디아의 지포스 RTX™ 3050 랩톱 GPU 외장 그래픽 카드를 탑재한 모델은 1초에 5장에 달하는 AI 이미지를 생성할 수 있는데요. 이는 내장 그래픽 모델에 비해 약 3배 빠른 속도입니다. LG전자 이윤석 IT 사업부장은 “AI 성능을 강화한 그램 최상위 라인업 LG 그램 프로를 앞세워 휴대성과 타협하지 않는 고성능을 원하는 고객에게 최적의 사용 경험을 제공하겠다”고 말했습니다.

[그림 4] AI 프로세서를 탑재한 2024년형 LG 그램 신제품 ‘LG 그램 프로’

하이브리드 AI, 새로운 AI시대 열까

이제 AI가 클라우드, 에지 컴퓨팅, 디바이스 영역에 걸쳐 뿌리내릴 것으로 보입니다. 이른바 ‘하이브리드 AI시대’가 도래하려는 모습인데요. 특히 하드웨어를 보유한 빅테크 기업은 온디바이스 AI에 힘을 싣는 분위기입니다. 인터넷 연결 없이도 가전제품이 AI를 활용해 각종 서비스를 제공할 수 있기 때문입니다. 클라우드 AI 시대의 절대 강자가 엔비디아였다면, 온디바이스 AI 시대에는 새로운 칩의 강자가 나타날 수 있을 조짐입니다. 특히 퀄컴과 같은 반도체 기업이 이 틈을 파고들고 있습니다. 퀄컴은 2023년 10월에 열린 스냅드래곤 서밋 2023에서 메타의 라마2를 압축한 모델을 퀄컴 칩이 장착된 디바이스에서 구동하는 기술을 시연했습니다. 인터넷이나 와이파이 연결 없이 맛집 등의 정보를 확인할 수 있는 기술이었습니다. 퀄컴은 앞서 ‘AI의 미래 하이브리드(The future of AI is hybrid)’라는 보고서에서 가까운 미래에 AI가 온디바이스와 클라우드에서 병렬적으로 작동할 것으로 내다봤는데요. 향후 AI는 클라우드와 디바이스를 오가며 고객이 원하는 데이터를 적재적소에 처리하는 하이브리드 AI로 거듭날 것이라는 관측입니다.

이러한 하이브리드 AI는 팬데믹을 정점으로 위축되었던 IT 가전 산업을 다시 부활시킬 것으로 보입니다. 모건스탠리에 따르면 스마트폰 출하량은 온디바이스 AI에 힘입어 지속적으로 성장할 전망입니다. 또한, PC 산업 역시 큰 폭으로 성장할 전망인데요. 캐널리스에 따르면 “2024년 PC 산업은 8% 성장할 전망이며 새로운 AI 기능 장치가 등장하면서, 고객들이 팬데믹 시대에 사들인 PC를 새롭게 교체할 것”이라고 설명했습니다. HP의 최고 경영 책임자(CEO)인 엔리케 로레스(Enrique Lores)는 CNBC를 통해 “AI PC가 PC 시장의 성장을 가속할 것”이라며 “AI PC를 처음에는 특정 기업만 구입하겠지만, 향후에는 더 많은 고객이 구입할 수밖에 없을 것”이라고 말했습니다.

[출처] https://www.lgcns.com/blog/it-trend/51820/

Loading

13 3월 2024

[비지니스 경영] 고객사에서 돈 안 줄 때 프리랜서가 해야 할 일 (프리랜서 임금체불) 프리랜서 임금체불 시 대응 메뉴얼

[비지니스 경영] 고객사에서 돈 안 줄 때 프리랜서가 해야 할 일 (프리랜서 임금체불) 프리랜서 임금체불 시 대응 메뉴얼

고객사에서 돈 안 줄 때 프리랜서가 해야 할 일 (프리랜서 임금체불)

프리랜서 임금체불 시 대응 메뉴얼

프리랜서로 생활하다 보면 종종 임금체불을 겪게 돼요. 흔하게 마주할 수 있으면서도, 골치 아픈 일이죠.

프리랜서는 근로자와 달리, 고용노동부의 법적 보호를 받을 수 없어요. 그래서 곤란한 일을 마주할 때마다 오로지 자신의 힘으로 해결해야 하죠. 그래서 삼쩜삼이 여러분께 힘을 보태드리려고 해요. 프리랜서 임금체불! 어떻게 해야 하는지 그 예방책과 법적 조치까지 알려드릴게요.

고객사_임금체불시_프리랜서_대응법_증빙서류_청구서_전자소송_내용증명_소송.png

증빙 서류 챙기기(증거 남기기)

1) 용역 이행 전, 계약서 작성하기

프리랜서가 프로젝트를 수주받을 때는 정식 계약서보다는 구두를 통해 계약하는 경우가 많아요. 하지만 구두 계약만으로는 나중에 용역을 제공했다는 사실을 증명하기 어려워요.

만약 채무자가 용역을 제공한 사실을 부인한다면? 일이 복잡해지기 시작하죠. 그러니 프로젝트를 시작하기 전에, 최소한의 객관적 근거를 남기는 게 좋아요.

예를 들자면 가장 쉬운 방법은 문자예요. ‘일의 시작, 종료 시점, 용역비, 지급 기한’ 등이 표시된 텍스트를 남기고 상대방의 답변을 받으면 된답니다! 정식 계약서를 쓰면 더 좋고요.

2) 용역 이행 후, 증빙 서류 챙기기

프로젝트 결과물을 넘긴 후, 고객사에서 묵묵부답이라면 너무 답답하겠죠. 용역을 이행했다는 사실을 확인하는 서류를 작성하면 고객사에게 당당하게 대응할 수 있어요.

서류에는 사업자 정보, 프리랜서 정보, 계약명, 이행 기간, 프로젝트 내용 등이 적혀 있어야 해요. 거기다 용역을 제공한 사실을 확인했다는 고객사의 날인을 받아두세요. 이렇게 하면 고객사도 더 이상 발뺌할 수 없어요. 이렇게 서류를 작성하면 문제가 발생했을 때 책임 소지가 분명해지고, 의사소통 상의 오류가 줄어들 수도 있어요.

고객사_임금체불시_프리랜서_대응법_증빙서류_청구서_전자소송_내용증명_소송1.jpg

프리랜서 임금체불시 정중히 입금 청구하기

임금은 시간을 들여 프로젝트를 수행한 것에 대한 정당한 대가예요. 그러니 입금 요구 또한 정당한 거죠. 정중하게 요청한다면, 문제가 될 것은 전혀 없답니다! 이런 절차를 거치면 법적인 문제로 번지는 걸 막을 수도 있어요.

1) 청구서 보내기

프로젝트 계약을 할 당시에 이미 고객사와 임금 입금 관련 이야기를 나누셨을 거예요. 앞서 말했듯 이러한 계약은 보통 구두로 이루어지는데요. 그렇기 때문에 고객사가 입금 날짜를 깜박할 수도 있어요.

이때를 대비해서 입금 날짜를 상기하는 청구서를 작성하고 전송하는 게 좋아요. 청구서에는 기본 인적 사항과 작업 내역, 그리고 임금을 명시하면 됩니다.

2) 독촉 메일 보내기

임금체불이 될 때에는 고객사의 사정을 일단 알아봐야 합니다. 즉, 고객사와 연락을 취해야 해요. 이때, 텍스트 상의 증거가 남는 메일을 통하는 게 가장 좋아요.

부득이하게 전화로 연락을 하는 경우에도 전화 내용을 메일로 정리해 보내야 해요. 메일을 쓸 때는 최대한 간결하고 정중하게, 감정을 배제해야 한다는 것, 잊지 마세요!

고객사_임금체불시_프리랜서_대응법_증빙서류_청구서_전자소송_내용증명_소송2.jpg

법적인 액션 취하기

만약 위의 조치를 다 했는데도 여전히 고객사에서 응답이 없다면, 법의 힘을 빌려야 해요.

1) 내용증명 보내기

내용증명이란 “어떤 내용의 것을 언제 누가 누구에게 발송하였는가 하는 사실을, 발송인이 작성한 등본에 의하여, 우체국장이 공적인 입장에서 증명하는 제도”에요.

내용증명 자체로 채무가 불이행되고 있다는 사실을 기록할 수도 있고, 고객사는 심적 압박을 느껴요. 그러니 소송 전 단계에서 문제가 마무리될 가능성이 높아지죠.

2) 전자소송 활용하기

내용증명을 보냈는데도 여전히 임금체불 상태라면, 전자소송을 활용하세요. 정식 소송을 거치는 것보다 비교적 간편하고 효율적이에요. 그중에서도 ‘지급명령’은 민사소송보다 신속하고 저렴해요. 프리랜서 임금체불 시 규모가 그리 크지 않으신 분들은(1000만 원 이하) 이 방법을 활용하는 것을 추천해요.

그런데 이 지급명령은 확정이 되었더라도 고객사, 즉 채무자가 소를 제기할 수 있어요. 그러니 고객사에서 이의를 제기할 거라고 예상된다면 바로 민사소송을 제기하는 게 오히려 좋을 수 있어요.

고객사_임금체불시_프리랜서_대응법_증빙서류_청구서_전자소송_내용증명_소송3.jpg

피땀 흘려서 일했는데, 거기에 대한 대가를 받지 못한다면 너무 속상하겠죠. 만약 그런 일이 발생한다면, 고객사 눈치 보지 말고 여러분의 권리를 당당하게 챙기세요. 그럴 자격은 충분하니까요!

​​- 해당 콘텐츠는 2023.03.21 기준으로 작성되었습니다.

– 해당 콘텐츠의 내용은 일반적인 정보를 참고 목적으로만 제공하고 있으며, 개개인의 상황에 따라 달리 적용될 수 있습니다.

따라서 콘텐츠를 통해 취득한 일반적인 정보로 인한 직간접적 손해에 대해서 당사는 법적 책임을 지지 않음을 알려드립니다.

[출처] https://help.3o3.co.kr/hc/ko/articles/16733969105433-%EA%B3%A0%EA%B0%9D%EC%82%AC%EC%97%90%EC%84%9C-%EB%8F%88-%EC%95%88-%EC%A4%84-%EB%95%8C-%ED%94%84%EB%A6%AC%EB%9E%9C%EC%84%9C%EA%B0%80-%ED%95%B4%EC%95%BC-%ED%95%A0-%EC%9D%BC-%ED%94%84%EB%A6%AC%EB%9E%9C%EC%84%9C-%EC%9E%84%EA%B8%88%EC%B2%B4%EB%B6%88

Loading

24 2월 2024

[인공지능 기술] ‘인공지능 판사’에게 꼭 필요한 능력

[인공지능 기술] ‘인공지능 판사’에게 꼭 필요한 능력

‘인공지능 판사’에게 꼭 필요한 능력

입력

게티이미지뱅크 제공

챗GPT가 몰고 온 생성 인공지능(AI) 충격파의 위력은 검색 제국 ‘구글’이 휘청할 정도로 엄청나다. 생성 AI의 대표선수로 자리잡은 챗GPT는 기존의 AI 모델과는 비교가 안되는 엄청난 파라미터를 자랑한다. 강력해진 생성 AI가 변호사나 판사 같은 법률 전문가를 대신할 수 있을까.

생성 AI의 성능은 파라미터가 좌우한다. 파라미터는 AI 모델이 학습할 때 조정되는 가중치로, 파라미터가 수천억 개 이상인 언어모델을 대규모 언어모델(LLM)이라고 한다. 챗GPT는 대규모 언어모델 중 하나인 GPT를 기반으로 작동하므로, 사람의 언어를 이해해 문장을 자유자재로 생성한다.

이런 이유로 우리는 챗GPT에 열광하며 변호사 같은 지식 전문가도 생성 AI의 강력한 언어능력에 빠져든다. 2023년 6월 미국 뉴욕에서 민사소송을 수임한 한 변호사는 챗GPT가 작성한 의견서를 맨해튼 연방법원에 제출했다가 근거로 인용한 판례가 실존하지 않는 가짜라는 사실이 드러나 벌금형을 선고받았다.

● AI 도움을 받아 재판한 판사

언어와 지식이 있는 곳엔 어김없이 GPT가 출몰해 산업, 문화, 예술, 교육 등 모든 분야를 빠른 속도로 바꾸고 있다. 그리고 드디어 언어 기반의 지식 세계에 남은 마지막 성지 격인 ‘재판’까지 챗GPT와 같은 AI가 침투하기 시작했다.

2023년 2월 콜롬비아의 후안 마누엘 파디야 판사는 자폐아의 의료권 관련 소송의 판결문을 작성하면서 챗GPT에게 도움을 받았다고 고백했다. 파디야 판사는 자폐증 어린이의 진료 접수비와 치료비, 교통비를 면제해달라고 청구한 이 사건에 대한 챗GPT의 답변을 참고해서 판결문을 작성했다고 밝혔다. 많은 비난이 쏟아졌지만 파디야 판사는 세계 최초로 AI의 도움을 받아서 재판한 판사로 역사에 이름을 남겼다.

그런가 하면 미국의 한 판사는 최근 변호사들이 챗GPT가 작성한 변론서를 제출하는 사건이 증가하자, GPT를 이용해 문장을 만드는 행위를 일절 금지시키기도 했다.

AI는 방대한 양의 법조문과 판례, 사건 관련 기록, 문서 등을 읽고 기억하고 추론해야 하는 법률 업무에 큰 도움이 된다. 판사나 변호사까지도 챗GPT의 유혹에 빠져드는 이유다. 복잡한 법률 문서를 이해해 법적 판단을 내리고, 판결문까지 작성할 수 있는 AI 판사가 등장하길 기대하는 법조인들이 점점 늘어나는 것도 무리가 아니다.

● 재판 예측 알고리즘의 역사는 무려 60년

학술적인 의미에서 AI 판사는 일반적으로 재판을 ‘예측’하는 알고리즘을 말한다. 사실 재판 예측을 연구한 역사는 매우 길다. 1963년에 리드 롤러라는 학자가 컴퓨터를 이용한 재판 예측 기법에 대한 논문을 발표하면서 이 분야 연구가 본격적으로 시작됐다. 재판 예측 연구에는 그동안 다양한 방법과 기술이 동원됐다. 그중 의미 있는 성과는 2004년에 앤드류 마틴 등이 개발한 미국 연방대법원 재판 예측 알고리즘이었다. 이 알고리즘은 의사결정나무(decision tree)라는 기계학습 기법으로 재판 결과를 예측했다.

그러나 당시의 판사나 법률가들은 기술이 법률에 응용되는 데 대해 매우 회의적이었다. 법률가들의 엄청난 저항에 직면한 롤러 연구팀은 경진대회를 열어 연방대법원 재판에 대한 법률 전문가의 예측과 알고리즘의 예측을 직접 비교했다. 결과는 놀랍게도 법률 전문가의 참패였다. 인간 법률가들이 예측한 재판 예측의 정확도는 59%에 머물렀지만 알고리즘의 예측은 무려 75%의 정확도를 보였다.

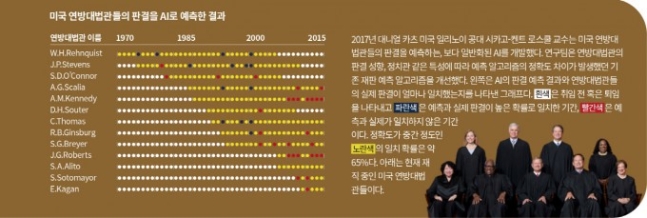
이 충격의 재판 예측 대회 이후, 미국의 연방대법원 재판 예측 연구는 대니얼 카츠 미국 일리노이공대 시카고-켄트 로스쿨 교수의 노력에 힘입어 크게 발전했다. 카츠 교수팀은 2014년도에 연방대법원 판결을 약 70%의 정확도로 예측하는 알고리즘을 개발했다. 그리고 2017년엔 연방대법관 개개인의 개성에 좌우되지 않는, 보다 일반화된 예측 방법까지 제안했다. 이때 AI의 학습데이터는 1816~2015년의 모든 미국 연방대법원 자료였다.

2016년의 알파고와 이세돌 대국 이후 딥러닝이란 AI 기술이 널리 세상에 알려질 무렵, 영국 유니버시티칼리지 런던, 셰필드대, 미국 펜실베이니아주립대의 공동 연구팀도 새로운 재판 예측 시스템을 개발했다. 이때 ‘AI 판사’라는 단어도 언론에 공식적으로 등장했다.

이 재판 예측 시스템은 기계학습 알고리즘을 기반으로 유럽인권재판소(ECHR)의 판결 사례를 학습했다. 알고리즘의 예측은 유럽인권재판소의 실제 판결과 약 79% 일치했다.

미국 연방대법관들의 판결물 AI로 예측한 결과. Daniel Katz, Fred Schilling, Collection of the Supreme Court of the United States 제공

● GPT, 미국 변호사시험 합격하다

재판을 예측하는 AI 판사에 관한 이론적 연구가 이처럼 활발했음에도 AI 판사는 실제 재판 제도에 정착되거나 확산되진 못했다. 판결을 할 수 있을 정도의 성능이나 법적, 사회적 신뢰성 등의 문제로 현실에 곧바로 적용하기 어려웠기 때문이다.

그러나 질문을 하면 법적으로 타당하게 답하는 ‘AI 변호사’는 현실에 적용될 가능성이 상대적으로 높다. AI 변호사란 엄밀한 의미에선 법적 추론이 가능한 기계지만 산업계에선 이용자를 법적으로 도울 수 있는 다양한 형태의 법률 AI를 폭넓게 지칭한다.

법률 AI의 목표는 과거의 사법시험이나 현재의 변호사시험을 통과하는 것이었다. 변호사시험 합격은 AI가 인간 언어능력이란 오랜 장벽을 극복했다는 상징적 의미가 있다. 그래서 언어 지능의 완성형에 가까운 챗GPT가 등장하자마자 사람들은 챗GPT가 법률 추론이라는 마지막 벽까지 넘을 수 있을지 큰 관심을 보였다. 그

리고 마침내 확인할 기회가 왔다. 카츠 교수와 마이클 봄마리토 미국 미시간주립대 로스쿨 교수의 공동연구팀이 2022년 12월 챗GPT로 미국 변호사시험을 쳤다. 결과는 불합격. 이 챗GPT는 미국변호사시험위원회(NCBE)의 객관식 시험에서 하위 10%의 성적으로 불합격했다.

그로부터 몇 달 후에 공동연구팀은 미국 스탠퍼드대 법률정보센터 등과 협력해 기존 챗GPT(GPT-3.5)보다 진화한 GPT-4로 다시 미국 변호사시험에 응시했다. 이때는 놀랍게도 상위 10%의 성적으로 합격선에 가뿐히 들었다. GPT-4의 성적은 같은 시험에 응시한 로스쿨 학생들보다도 더 우수했다. 갑자기 나타난 AI의 실력에 미국 변호사들은 충격에 휩싸였다.

● AI 판사의 필수 능력, 검색 증강 해석(RAG)

GPT-4가 미국 변호사시험에 합격했다는 소식이 전 세계로 전해질 무렵 법률과 관련된 다양한 기술들을 개발하는 리걸테크 기업들은 앞다퉈 AI 판사변호사 개발에 뛰어들었다.

인간 판사처럼 의사 결정을 하는 AI는 먼 미래의 일이지만 판사를 위한 법률 정보를 제공하고 판결문 작성을 보조하는 AI는 현재 기술에서 개발이 어렵지 않다. 또한 일반 시민들의 나홀로 소송 절차를 도와주는 다양한 재판 도우미 서비스도 기대할 수 있다. 예를 들어 소장, 고소장 같은 법률 문서 작성, 상황에 따른 법률의 질의 응답, 이혼이나 상속에서 발생하는 재화 계산 등 여러 재판 도우미 서비스가 가능하다.

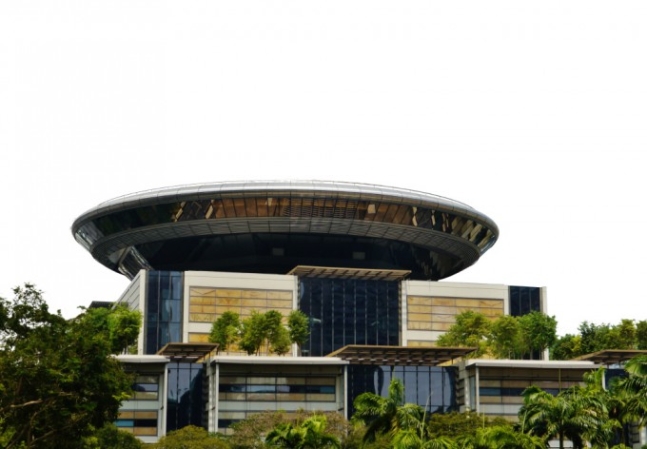
현재 선진국들은 이런 유형의 AI 판사 개발을 검토하기 시작했다. 2023년 9월 싱가포르 법원은 세계 최초로 GPT 기반의 AI 판사 시스템을 구축할 것이라고 발표했다. 싱가포르 법원이 계획하는 이 AI 판사는 소액 민사 재판을 위한 대국민 재판 도우미다. 예를 들면 세탁기를 구입한 후 제품의 하자로 소비자와 기업 간에 분쟁이 발생한 경우 AI 판사의 도움을 받아 재판을 진행할 수 있다. 이 AI 판사는 재판 절차, 법적 권리, 받을 수 있는 배상 혹은 보상 금액 등을 자세히 설명해주고 서류 작성까지 도와준다.

싱가포르 법원이 기획한 AI 판사는 보편적, 효율적인 AI 법률 서비스라고 보면 적절하다. 일반적인 시민의 입장에서는 인간 변호사처럼 법적 상담을 해주거나 법적 질문을 하면 적절하게 답변해주는 AI 변호사를 선호할 것이다. 사람들이 기대하는 AI 판사의 역할은 재판의 결론을 예측하는 데만 국한되지 않는다.

한편 GPT 자체는 과거 데이터로 학습한 지식에 근거한 확률적 답변을 할 뿐이다. 따라서 GPT는 필연적으로 거짓말을 할 수 있다. 이것을 환각 현상이라고도 한다. 고성능 법률 AI의 개발은 이런 환각 현상을 줄이는 것이 핵심이다.

이를 위한 다양한 연구가 진행 중인데, AI 답변의 근거를 제시하는 검색 증강 생성(RAG)이 최근 주목받고 있다. 이것은 GPT란 뇌에 최신 정보를 외부 기억처럼 결합해서, 질문을 받으면 관계 있는 정보를 검색하고 그 결과를 근거로 답하게 하는 기술이다.

국민들이 신뢰할 수 있는 AI 판사는 방대한 이미지, 사운드, 텍스트를 동시에 이해, 생성할 수 있는 멀티모달 특성(시각, 청각 등 여러 감각으로 정보를 주고받는 특성)과 최신 법률, 판례를 검색해 그 결과를 바탕으로 응답하는 능력을 동시에 갖춘 ‘하이브리드 AI’(예를 들면 RAG-multimodal GPT)일 것이다. 예전엔 상상도 못했던 AI 판사가 현실로 다가오며, 새로운 법률의 풍경을 만들기 시작했다.

2023년 9월 소액 민사 재판을 위한 AI 판사 도입 계획을 발표한 싱가포르 대법원 청사. 이 AI 판사는 재판 당사자에게 절차와 보호받을 법적 권리, 쟁점이 되는 금액 등을 자세히 설명해주고 서류 작성까지 도와주는 역할을 할 것이다. Zairon(W) 제공

※필자소개
임영익
 서울대 생명과학과를 졸업하고 52회 사법시험에 합격해 변호사가 됐다. 현재 (주)인텔리콘연구소의 대표이사로 AI 기반의 리걸테크 솔루션 개발 및 컴퓨테이션 법률학 연구를 진행하고 있다. 2015년 한국 최초로 AI 법률정보 시스템과 법률 챗봇을 개발했다.

임영익 인텔리콘대표·변호사 ceo@intellicon.co.kr
[출처] https://n.news.naver.com/article/584/0000026047?cds=news_media_pc

Loading

5 2월 2024

[ETC.] 충전 하세월, 단독근무 불능… 뉴욕 ‘로보캅’ 4개월 만에 해고

[ETC.] 충전 하세월, 단독근무 불능… 뉴욕 ‘로보캅’ 4개월 만에 해고

충전 하세월, 단독근무 불능… 뉴욕 ‘로보캅’ 4개월 만에 해고

뉴욕로봇경찰 해고됨 사진.png
 
뉴욕 타임스스퀘어 지하철 역 내에 로봇경찰(K5)이 근무 서고 있는 모습. 뉴욕경찰은 로봇경찰을 시범운영 4개월 만에 조기 종료하기로 했다. /윤주헌 특파원

“사람을 위한 로봇인지, 로봇을 위한 사람인지 모를 지경.”(뉴욕타임스 인터뷰 중)

뉴욕경찰(NYPD)이 지난 2일 뉴욕 맨해튼 지하철역에 배치해온 로보캅(경찰 로봇) ‘K5′에 대한 시범 운영을 중단한다고 발표하자 현지 언론에서 이런 보도가 나왔다. NYPD는 “K5를 활용할 수 있는 새로운 방법을 찾아보겠다”고 했지만 다시 사람들 앞에 나올 수 있을지는 미지수다. K5는 지난해 9월부터 맨해튼에서 가장 붐비는 타임스스퀘어 역에 배치됐다. NYPD는 K5의 활용도를 확인한 뒤 뉴욕시 전역으로 사업을 확대하려 했다. 그런데 막상 일을 시켜보니 기대에 한참 못 미쳐 운영 4개월 만에 계획을 접었다. 현지 언론들은 “K5가 예상보다 빨리 해고됐다”고 했다.

K5는 약 159cm 키에 몸무게는 180kg에 달한다. 거대한 달걀처럼 매끈하게 생겼고, 흰색 바탕에 파란색 경찰 마크가 새겨졌다. 4개의 HD 카메라, 1개의 적외선 열화상 카메라 등이 달렸다. 별도로 조종하지 않아도 긴급 상황이나 범죄 발생 시 영상을 자동 녹화하고 지하철 이용객이 로봇의 버튼을 누르면 실시간으로 상담원에게 연결돼 신고도 가능하다. 최고 속도는 사람의 보행 속도와 비슷한 시속 4.8km다.

자칭 ‘신기술 마니아’인 에릭 애덤스 뉴욕시장은 지난해 9월 시범 운영 계획을 발표하며 “우리는 뉴욕을 미국에서 가장 안전한 도시로 만들기 위해 혁신적인 도구를 탐구하는 데 전념하고 있고 로봇 경찰 K5는 중요한 역할을 할 것”이라고 했다.

배치 초반에는 뉴요커와 여행객들이 K5 옆에서 ‘셀카’를 찍는 등 인기를 끌었다. 그런데 사람들이 흔히 기대하는 ‘로봇’처럼 자유자재로 다니며 순찰을 하지 못했다. 계단도 내려가지 못해 지하철역 구석에 우두커니 서 있었다. 게다가 K5를 혼자 두면 사람들이 고장 낼 수 있어 ‘사람’ 경찰관 한 명과 늘 짝을 이뤄 근무했다. 이 때문에 “경찰이 로봇을 챙기느라 오히려 일이 늘었다”는 불만도 나왔다.

실전 배치 전 뉴욕시는 “로봇은 사람과 달리 밥을 먹지 않아도 된다”고 했지만, 실제로는 ‘충전 스테이션’에서 상당한 시간을 보내기도 했다.

많은 뉴요커들 사이에서 ‘로봇의 감시를 받는다’라는 강한 거부감이 있었던 것도 조기 퇴출의 원인이 됐다. 처음 등장 때부터 인권 단체는 ‘로봇이 사람의 얼굴을 찍어 보관할 것’이라면서 인권 침해 우려를 제기했다. 법률구조협회 등 단체가 “경찰청의 감시 기술 사용을 조사해야 한다”고 주장하는 등 반발이 거세 뉴욕시에도 부담으로 작용했다. 이 때문에 뉴욕시는 로봇에 안면 인식 기능을 뺐다.

결국 많은 관심을 받던 로봇 경찰은 쓸쓸하게 퇴장했다. 뉴욕시가 로봇 회사와 맺은 계약 기간은 아직 남아 있지만, 이 로봇은 현재 지하철역 창고에 들어가 있다고 한다.

[출처] https://www.chosun.com/international/international_general/2024/02/04/YTKQ3B5YNJEIHJ4S3XXJUOUR5M/

Loading

25 1월 2024

[비지니스 경영] 간부가 꼭 알아야 할 50가지 부하 지도 기술

[비지니스 경영] 간부가 꼭 알아야 할 50가지 부하 지도 기술

간부가 꼭 알아야 할 50가지 부하 지도 기술

경영조직이 살아있는 조직이 되려면 필요한 것이 상하위계질서 속에서 능률적으로 업무를 수행할 수 있게 훈련된 조직이 되어야한다. 그러나 인간관계가 어려운 만큼 경영에서도 사람을 다루는 방법이 가장 어렵다고들 하는데 의사소통을 원활히 하는 방법과 개인지향적인 젊은세대’를 읽는 법, 부리는 법등, 특별히 간부가 부하를 지도할 때 필요한 기술들을 소개한다.

제 1 장 부하와의 의사 소통을 원활히 하는 방법

1. 입 다물고 앉아 있는 시대는 벌써 지나갔다.
2. 현대의 부하는 상사의 뜻을 헤아리지 않는다고 생각하라.
3. 말 이외의 커뮤니케이션을 활용하자.
4. 말은 상사 쪽에서 먼저 걸어야 한다.
5. 대화의 센스를 연마하는 두 가지 힌트
6. 질문으로 부하의 현황을 관찰하는 법
7. 의사 소통이 잘 되지 않을 때의 유의 사항
8. 커뮤니케이션 10원칙
자기 쪽에서 먼저 말을 건다.
기꺼이 응한다.
선입관을 갖지 않도록 노력한다.
감정적이 되었을 때는 한 호흡 여유를 갖는다.
긍정적인 태도로 대한다.
이질적인 것을 받아들인다.
풍부한 표정을 짓도록 노력한다.
확인을 게을리 하지 않는다.
쉽게 체념하지 않는다.
자기의 특성을 살린다.

제 2 장 이것이 개인 지향적인 젊은 세대를 읽는 법·부리는 법
9. 젊은이, 정말 변했는가
10. 아는 척도 모르는 척도 하지 않는다.
11. 젊은이들의 말 뒤에 숨어 있는 것을 간파하라.
12. 피로가 남지 않는 분위기 조성이 포인트
13. 안내서를 활용하여 구체적으로 지도한다.
14. 계획 단계부터 시키면 젊은 사람도 의욕적이 된다.
15. 젊은 사람은 매사에 얕게·좁게 관여하려 한다.
16. 즐거움을 연출하는 두 가지 포인트
17. 두드러지게 않게, 아무렇지도 않게 젊은이들과의 접촉 비결
18. ‘젊은 사람들은 일하려는 열성이 없다’고 몰아 붙여서는 안된다.

제 3 장 육성법·교육법은 원리 원칙에 따라
19. ‘가르친다’와 ‘기른다’의 차이를 알자
20. 사람을 기를 때의 사고 방식
21. 잘 기르는 3가지 조건
끈기있게 꾸준히, 일을 통하여 사람을 기른다, 주의 깊게 관찰하고, 기억한다.

22. 사람을 기를 때의 금기 사항
자기 일에만, 당면한 일에 쫓기고 있거나, 부하를 이용하거나
23. 일을 통해서 부하를 육성한다.
24. 계획을 세워서 부하를 육성한다.
25. 분위기를 연출하여 부하를 육성한다.
26. 매사를 상세히 지시하여 부하를 육성한다.
27. 설명 기술을 마스터하고 부하를 육성한다.
알기 쉽게 : 내용을 정리, 아웃라인을 명시, 관계를 명확히,

28. 설명 기술을 마스터하고 부하를 육성한다.2
간결하게 : 단축시킨다. 짧은 센텐스, 한 마디로 말하는 습관
분명하게 : 이미지가 떠오르게

제 4 장 ‘칭찬하는 법’·’꾸짖는 법’ 이것이 포인트
29. ‘칭찬하는 법’·’꾸짖는 법과의 관계
30. 능숙한 칭찬자가 되기 위한 유의 사항
31. 칭찬하는 것을 알도록 칭찬한다.
32. 평범한 일을 칭찬한다.
33. 난처한 일을 도와주기 위해서 칭찬한다.
34. 칭찬하는 말 25가지
잘했어, 정말 잘했어, 대단히 솜씨군, 달라졌어, 훌륭해, 착실한 근무태도, 직장 분위기가 밝아져, 시원시원해, 따뜻한 맛이 있어, 역시 실력자야, 등등

35. 꾸짖는 방법·3가지 요령
36. 나쁜 점을 깨닫게 하는 방법
37. 지루한 꾸중은 금물
38. 젊은 부하를 질책할 때의 유의 사항
39. 꾸짖을 때는 필요한 연구를
40. 꾸짖는 말 25선

제 5 장 미래지향적인 상사의 조건
41. 높은 지위에 있을 때 평가를 이겨내라.
42. 생각하고 있는 것을 언명할 수 있도록
43. 확실한 행동력을 갖춘다.
44. 최종적인 책임을 져라.
45. 진정한 개성과 자폐적 개성을 분별하라.
46. 사회 규범의 중요성을 가르친다.
47. 숙고하는 여유를 가져라.
48. 멋을 아는 상사가 되라.
49. 변하지 않는 것과 변하는 것을 확실히 구분하자.
50. 부하에게도 배워야 할 것은 배워라.
– 김광준 –


Loading

24 1월 2024

[국어 국문학] 君子不論人之短[군자는 남의 단점을 논하지 않는다].

[국어 국문학] 君子不論人之短[군자는 남의 단점을 논하지 않는다].

君子不論人之短[군자는 남의 단점을 논하지 않는다].

  子貢曰 君子亦有惡乎?

子曰 有惡. 惡稱人之惡者,

惡居下流而訕上者, 惡勇而無禮者, 惡果敢而窒者

[자공왈 군자역유오호? 자왈 유오. 오칭인지악자,

오거하류이산상자, 오용이무례자, 오과감이질자].

자공이 여쭈었다. “군자도 미워하는 게 있습니까?”

공자께서 말씀하셨다. “미워하는 게 있지. 남의 나쁜

점을 들춰내는 것을 미워하고, 낮은 자리에 있으면서

윗사람을 誹謗[비방]하는 것을 미워하고, 용기는 있지만

無禮한 것을 미워하고, 果敢하지만 꽉 막힌 것을

미워한다.”

子曰 賜也, 亦有惡乎? 惡謠以爲知者, 惡不孫以爲勇者,

惡謁以爲直者

[자왈 사야, 역유오호? 오요이위지자, 오불손이위용자,

오알이위직자].

이번엔 공자가 물었다. “사야(자공)! 너도 미워하는 게 있느냐?”

자공은 “남의 생각을 알아내어 자기 생각처럼 내세우면서 智慧가

있다고 여기는 것을 미워하고, 不遜한 것을 가지고 용감하다

여기는 것을 미워하고, 남의 비밀을 캐내 攻擊하면서 正直하다

여기는 것을 미워합니다.” -論語 陽貨 篇[논어 양화 편].

다른 사람의 잘못된 점을 낱낱이 들춰내는 것, 윗사람을 誹謗하는,

그러나 절대로 그 앞에서는 하지 못하는 것, 그리고 勇敢하지만

無禮한 것, 果敢하지만 꽉 막힌 것…. 이런 것들을 미워하는 것은

예나 지금이나 변함없는 것 같다. 자공 역시 남의 意見이나

아이디어를 알아내곤 그것을 내 생각처럼 내세우는 것,

不遜을 勇氣 있는 것이라 여기고, 다른 사람의 비밀을 캐내어

攻擊하면서 마치 그런 일이 正直하다고 생각하는 사람들을

미워한다고 告白하고 있다.

情報化시대에 살면서 남의 一擧手一投足을 일일이 찾아내

세상에 알리는 할 일 없는 사람들이 많다. 또 아랫사람으로서

윗사람을 誹謗하면서 公·私를 莫論하고 사실이 아닌 말까지

지어내 사회를 어지럽히기도 한다. 또 禮儀가 缺如[결여]된

용기나 疏通不能인 果敢性은 자칫 사회를 不通의 세상으로

만들기 쉽다. 指導者의 리더십이 不足하면 예나 지금이나

이런 混亂[혼란]스러운 일이 발생하고 민심이 흉흉해진다.

어떤 組織에서도 이를 警戒해야 하지만, 지금 우리 社會와

政治가 여기에서 자유롭지 못한 것 같아 안타깝기만 하다.

정말 君子가 남의 잘못를 曰可 曰不하지 않는 세상은 오지

않을 것인지 그저 아쉽고 답답해서 하는 말이다…..

 [출처] https://m.cafe.daum.net/bsj5/LfO2/343?listURI=%2Fbsj5%2FLfO2

Loading

22 1월 2024

[인공지능 기술] 5가지 최고의 오픈 소스 LLM(2024년 XNUMX월)

[인공지능 기술] 5가지 최고의 오픈 소스 LLM(2024년 XNUMX월)

오픈 소스 LLM

빠르게 진화하는 인공 지능(AI) 세계에서 LLM(Large Language Models)은 혁신을 주도하고 기술과 상호 작용하는 방식을 재구성하는 초석으로 부상했습니다.

이러한 모델이 점점 더 정교해짐에 따라 이에 대한 액세스를 민주화하는 데 점점 더 중점을 두고 있습니다. 특히 오픈 소스 모델은 이러한 민주화에서 중추적인 역할을 하며 연구원, 개발자 및 애호가 모두에게 복잡성을 깊이 탐구하고 특정 작업에 맞게 미세 조정하거나 기반을 구축할 수 있는 기회를 제공합니다.

이 블로그에서는 AI 커뮤니티에서 파장을 일으키고 있으며 각각 고유한 강점과 기능을 테이블에 제공하는 최고의 오픈 소스 LLM 중 일부를 살펴보겠습니다.

1. 라마 2

 
Llama 2 알아보기: 조립을 시작하는 데 필요한 모든 것


Meta의 Llama 2는 AI 모델 라인업에 획기적인 추가 기능입니다. 이것은 단지 다른 모델이 아닙니다. 다양한 최신 응용 프로그램에 연료를 공급하도록 설계되었습니다. Llama 2의 훈련 데이터는 방대하고 다양하여 이전 모델에 비해 크게 발전했습니다. 이러한 교육의 다양성은 Llama 2가 단순한 점진적인 개선이 아니라 AI 기반 상호 작용의 미래를 향한 기념비적인 단계임을 보장합니다.

Meta와 Microsoft 간의 협업은 Llama 2의 지평을 넓혔습니다. 오픈 소스 모델은 이제 Azure 및 Windows와 같은 플랫폼에서 지원되며, 개발자와 조직에 생성적 AI 기반 경험을 생성할 수 있는 도구를 제공하는 것을 목표로 합니다. 이 파트너십은 모두가 AI에 보다 쉽게 ​​접근하고 개방할 수 있도록 하기 위한 두 회사의 헌신을 강조합니다.

Llama 2는 원래 Llama 모델의 후속 제품이 아닙니다. 이는 챗봇 분야의 패러다임 전환을 나타냅니다. 첫 번째 Llama 모델은 텍스트와 코드를 생성하는 데 있어 혁신적이었지만 오용을 방지하기 위해 가용성이 제한되었습니다. 반면에 Llama 2는 더 많은 청중에게 다가갈 예정입니다. AWS, Azure, Hugging Face의 AI 모델 호스팅 플랫폼과 같은 플랫폼에 최적화되어 있습니다. 또한 Meta와 Microsoft의 협력을 통해 Llama 2는 Windows뿐만 아니라 Qualcomm의 Snapdragon 시스템 온 칩으로 구동되는 장치에서도 명성을 떨칠 준비가 되어 있습니다.

안전은 Llama 2 설계의 핵심입니다. 때때로 오해의 소지가 있거나 유해한 콘텐츠를 생성하는 GPT와 같은 초기 대규모 언어 모델이 직면한 문제를 인식하여 Meta는 Llama 2의 안정성을 보장하기 위해 광범위한 조치를 취했습니다. 이 모델은 ‘환각’, 잘못된 정보 및 편견을 최소화하기 위해 엄격한 훈련을 거쳤습니다.

LLaMa 2의 주요 기능:

  • 다양한 학습 데이터: Llama 2의 교육 데이터는 광범위하고 다양하여 포괄적인 이해와 성능을 보장합니다.
  • 마이크로소프트와의 협업: Llama 2는 Azure 및 Windows와 같은 플랫폼에서 지원되므로 적용 범위가 확장됩니다.
  • 가용성: 이전 버전과 달리 Llama 2는 더 많은 사용자가 사용할 수 있으며 여러 플랫폼에서 미세 조정할 준비가 되어 있습니다.
  • 안전 중심 설계: Meta는 안전을 강조하여 Llama 2가 유해한 출력을 최소화하면서 정확하고 신뢰할 수 있는 결과를 생성하도록 합니다.
  • 최적화된 버전: Llama 2는 Llama 2와 Llama 2-Chat의 두 가지 주요 버전으로 제공되며 후자는 양방향 대화를 위해 특별히 설계되었습니다. 이러한 버전의 복잡성은 7억에서 70억 매개변수에 이릅니다.
  • 향상된 교육: Llama 2는 원래 Llama의 1.4조 XNUMX천억 개 토큰에서 크게 증가한 XNUMX만 토큰으로 훈련되었습니다.

2. 

 
오픈소스 Bloom AI 소개


2022년, 70개국 이상 자원봉사자와 Hugging Face 전문가가 참여한 글로벌 협업 끝에 BLOOM 프로젝트가 공개되었습니다. XNUMX년에 걸친 계획을 통해 만들어진 이 LLM(대형 언어 모델)은 자동 회귀 텍스트 생성을 위해 설계되었으며 주어진 텍스트 프롬프트를 확장할 수 있습니다. 상당한 계산 능력을 활용하여 방대한 텍스트 데이터 모음을 학습했습니다.

BLOOM의 데뷔는 생성 AI 기술의 접근성을 높이는 데 있어 중요한 단계였습니다. 오픈 소스 LLM으로서 176억 개의 매개변수를 자랑하며 동급에서 가장 강력한 LLM 중 하나입니다. BLOOM은 46개 언어와 13개 프로그래밍 언어에 걸쳐 일관되고 정확한 텍스트를 생성하는 능력을 갖추고 있습니다.

이 프로젝트는 투명성을 강조하여 소스 코드와 훈련 데이터에 대한 대중의 접근을 허용합니다. 이러한 개방성은 모델의 지속적인 검토, 활용 및 향상을 유도합니다.

Hugging Face 플랫폼을 통해 무료로 액세스할 수 있는 BLOOM은 AI 분야의 협력적 혁신을 보여주는 증거입니다.

Bloom의 주요 기능:

  • 다국어 기능 : BLOOM은 46개 언어와 13개 프로그래밍 언어로 텍스트를 생성하는 데 능숙하여 광범위한 언어 범위를 보여줍니다.
  • 오픈 소스 액세스: 모델의 소스 코드와 교육 데이터는 공개적으로 제공되므로 투명성과 협업 개선이 촉진됩니다.
  • 자동회귀 텍스트 생성: 주어진 프롬프트에서 텍스트를 이어가도록 설계된 BLOOM은 텍스트 시퀀스를 확장하고 완성하는 데 탁월합니다.
  • 대규모 매개변수 개수: 176억 개의 매개변수를 갖춘 BLOOM은 현존하는 가장 강력한 오픈 소스 LLM 중 하나입니다.
  • 글로벌 협업: 70개 이상 국가의 자원봉사자와 Hugging Face 연구자들의 기여로 XNUMX년간의 프로젝트를 통해 개발되었습니다.
  • 무료 접근성: 사용자는 Hugging Face 생태계를 통해 BLOOM에 무료로 액세스하고 활용할 수 있어 AI 분야의 민주화가 강화됩니다.
  • 산업 규모 교육: 이 모델은 상당한 계산 리소스를 사용하여 방대한 양의 텍스트 데이터에 대해 학습되어 강력한 성능을 보장합니다.

3. MPT-7B

 
MPT-7B – 최초로 상업적으로 사용 가능한 완전히 훈련된 LLaMA 스타일 모델


MosaicML Foundations는 최신 오픈 소스 LLM인 MPT-7B를 도입하여 이 공간에 크게 기여했습니다. MosaicML Pretrained Transformer의 약어인 MPT-7B는 GPT 스타일의 디코더 전용 변환기 모델입니다. 이 모델은 성능 최적화된 레이어 구현 및 더 큰 교육 안정성을 보장하는 아키텍처 변경을 포함하여 몇 가지 향상된 기능을 자랑합니다.

MPT-7B의 뛰어난 기능은 1조 개의 텍스트 및 코드 토큰으로 구성된 광범위한 데이터 세트에 대한 교육입니다. 이 엄격한 교육은 9.5일 동안 MosaicML 플랫폼에서 실행되었습니다.

MPT-7B의 오픈 소스 특성은 상용 애플리케이션을 위한 귀중한 도구로 자리매김합니다. 비즈니스 및 조직의 예측 분석 및 의사 결정 프로세스에 상당한 영향을 미칠 가능성이 있습니다.

기본 모델 외에도 MosaicML Foundations는 짧은 형식의 지침을 따르는 MPT-7B-Instruct, 대화 생성을 위한 MPT-7B-Chat 및 MPT-7B-StoryWriter-65k+와 같은 특정 작업에 맞춤화된 특수 모델도 출시하고 있습니다. 긴 형식의 스토리 생성을 위해.

MPT-7B의 개발 여정은 MosaicML 팀이 데이터 준비에서 배포까지 모든 단계를 몇 주 내에 관리하는 포괄적인 과정이었습니다. 데이터는 다양한 리포지토리에서 제공되었으며 팀은 EleutherAI의 GPT-NeoX 및 20B 토크나이저와 같은 도구를 활용하여 다양하고 포괄적인 교육 믹스를 보장했습니다.

MPT-7B의 주요 기능 개요:

  • 상업용 라이선스: MPT-7B는 상업적 사용이 허가되어 비즈니스에 귀중한 자산이 됩니다.
  • 광범위한 교육 데이터: 이 모델은 1조 토큰의 방대한 데이터 세트에 대한 교육을 자랑합니다.
  • 긴 입력 처리: MPT-7B는 손상 없이 매우 긴 입력을 처리하도록 설계되었습니다.
  • 속도와 효율성: 이 모델은 신속한 교육 및 추론에 최적화되어 시기 적절한 결과를 보장합니다.
  • 오픈 소스 코드: MPT-7B는 효율적인 오픈 소스 교육 코드와 함께 제공되어 투명성과 사용 편의성을 높입니다.
  • 비교 우수성: MPT-7B는 LLaMA-7B와 일치하는 품질로 20B-7B 범위의 다른 오픈 소스 모델보다 우수함을 입증했습니다.

4. 

 
FALCON-180B를 즉시 배포하세요! 새로운 #1 오픈 소스 AI 모델


Falcon LLM은 LLM 계층 구조의 최상위로 빠르게 올라간 모델입니다. Falcon LLM, 특히 Falcon-40B는 40억 개의 매개변수를 갖춘 기본 LLM이며 인상적인 3조 개의 토큰에 대해 교육을 받았습니다. 이는 자동 회귀 디코더 전용 모델로 작동합니다. 즉, 본질적으로 이전 토큰을 기반으로 시퀀스에서 후속 토큰을 예측합니다. 이 아키텍처는 GPT 모델을 연상시킵니다. 특히, Falcon의 아키텍처는 GPT-75보다 우수한 성능을 보여주었고, 훈련 컴퓨팅 예산의 XNUMX%만으로 이 위업을 달성했으며 추론 중에 훨씬 적은 컴퓨팅이 필요합니다.

Technology Innovation Institute의 팀은 Falcon을 개발하는 동안 데이터 품질에 중점을 두었습니다. 교육 데이터 품질에 대한 LLM의 민감도를 인식하여 수만 개의 CPU 코어로 확장되는 데이터 파이프라인을 구성했습니다. 이를 통해 광범위한 필터링 및 중복 제거 프로세스를 통해 웹에서 고품질 콘텐츠를 신속하게 처리하고 추출할 수 있었습니다.

TII는 Falcon-40B 외에도 7억 개의 매개변수를 보유하고 7조 1,500억 개의 토큰에 대해 훈련된 Falcon-40B를 비롯한 다른 버전도 도입했습니다. 특정 작업에 맞게 조정된 Falcon-7B-Instruct 및 Falcon-XNUMXB-Instruct와 같은 특수 모델도 있습니다.

훈련 Falcon-40B는 광범위한 과정이었습니다. 이 모델은 TII가 구축한 대규모 영어 웹 데이터 세트인 RefinedWeb 데이터 세트에서 훈련되었습니다. 이 데이터 세트는 CommonCrawl 위에 구축되었으며 품질을 보장하기 위해 엄격한 필터링을 거쳤습니다. 모델이 준비되면 EAI Harness, HELM 및 BigBench를 포함한 여러 오픈 소스 벤치마크에 대해 검증되었습니다.

Falcon LLM의 주요 기능 개요:

  • 광범위한 매개변수: Falcon-40B는 40억 개의 매개변수를 갖추고 있어 포괄적인 학습 및 성능을 보장합니다.
  • 자기회귀 디코더 전용 모델: 이 아키텍처를 통해 Falcon은 GPT 모델과 유사하게 이전 토큰을 기반으로 후속 토큰을 예측할 수 있습니다.
  • 우수한 성능: Falcon은 교육 컴퓨팅 예산의 3%만 활용하면서 GPT-75보다 성능이 뛰어납니다.
  • 고품질 데이터 파이프라인: TII의 데이터 파이프라인은 웹에서 모델 교육에 중요한 고품질 콘텐츠 추출을 보장합니다.
  • 다양한 모델: Falcon-40B 외에도 TII는 Falcon-7B 및 Falcon-40B-Instruct 및 Falcon-7B-Instruct와 같은 특수 모델을 제공합니다.
  • 오픈 소스 가용성: Falcon LLM은 오픈 소스로 제공되어 AI 도메인에서 접근성과 포괄성을 촉진합니다.

5. 비쿠나-13B

 
로컬 컴퓨터에서 Vicuna-13B를 실행하세요 ???? | 튜토리얼(GPU)


LMSYS ORG는 Vicuna-13B를 도입하여 오픈 소스 LLM 영역에서 중요한 족적을 남겼습니다. 이 오픈 소스 챗봇은 ShareGPT에서 가져온 사용자 공유 대화에서 LLaMA를 미세 조정하여 세심하게 훈련되었습니다. GPT-4가 심사위원으로 참여한 예비 평가에서 Vicuna-13B는 OpenAI ChatGPT 및 Google Bard와 같은 유명한 모델의 90% 이상의 품질을 달성하는 것으로 나타났습니다.

인상적으로, Vicuna-13B는 사례의 90% 이상에서 LLaMA 및 Stanford Alpaca와 같은 다른 주목할만한 모델을 능가합니다. Vicuna-13B에 대한 전체 교육 프로세스는 약 $300의 비용으로 실행되었습니다. 기능 탐색에 관심이 있는 사람들을 위해 코드, 가중치 및 온라인 데모가 비상업적 목적으로 공개되었습니다.

Vicuna-13B 모델은 70K 사용자 공유 ChatGPT 대화로 미세 조정되어 보다 상세하고 잘 구성된 응답을 생성할 수 있습니다. 이러한 응답의 품질은 ChatGPT와 비슷합니다. 그러나 챗봇을 평가하는 것은 복잡한 작업입니다. GPT-4가 발전함에 따라 벤치마크 생성 및 성능 평가를 위한 자동화된 평가 프레임워크 역할을 할 가능성에 대한 호기심이 커지고 있습니다. 초기 결과는 GPT-4가 챗봇 응답을 비교할 때 일관된 순위와 자세한 평가를 생성할 수 있음을 시사합니다. GPT-4를 기반으로 한 예비 평가에서는 Vicuna가 Bard/ChatGPT와 같은 모델의 90% 기능을 달성하는 것으로 나타났습니다.

Vicuna-13B의 주요 특징 개요:

  • 오픈 소스 특성: Vicuna-13B는 공개 액세스가 가능하여 투명성과 커뮤니티 참여를 촉진합니다.
  • 광범위한 교육 데이터: 이 모델은 70개의 사용자 공유 대화에 대해 학습되어 다양한 상호 작용에 대한 포괄적인 이해를 보장합니다.
  • 경쟁력 있는 성능: Vicuna-13B의 성능은 ChatGPT 및 Google Bard와 같은 업계 리더와 동등합니다.
  • 비용 효율적인 교육: Vicuna-13B에 대한 전체 교육 프로세스는 약 $300의 저렴한 비용으로 실행되었습니다.
  • LLaMA 미세 조정: 이 모델은 LLaMA에서 미세 조정되어 향상된 성능과 응답 품질을 보장합니다.
  • 온라인 데모 가용성: 사용자는 대화식 온라인 데모를 통해 Vicuna-13B의 기능을 테스트하고 경험할 수 있습니다.

대규모 언어 모델의 확장 영역

대규모 언어 모델의 영역은 방대하고 지속적으로 확장되며 새로운 모델이 나올 때마다 가능성의 한계를 뛰어넘습니다. 이 블로그에서 논의된 LLM의 오픈 소스 특성은 AI 커뮤니티의 협력 정신을 보여줄 뿐만 아니라 미래 혁신을 위한 길을 열어줍니다.

Vicuna의 인상적인 챗봇 기능에서 Falcon의 우수한 성능 메트릭에 이르기까지 이러한 모델은 현재 LLM 기술의 정점을 나타냅니다. 이 분야의 급속한 발전을 계속 목격하면서 오픈 소스 모델이 AI의 미래를 형성하는 데 중요한 역할을 할 것이 분명합니다.

당신이 노련한 연구원이든, 신진 AI 애호가이든, 이러한 모델의 잠재력에 대해 궁금한 사람이든, 그들이 제공하는 방대한 가능성에 뛰어들어 탐구하기에 더 좋은 시간은 없습니다.

Alex McFarland는 인공 지능의 최신 개발을 다루는 브라질 기반 작가입니다. 그는 전 세계 최고의 AI 회사 및 출판물과 함께 일했습니다.

unite.AI의 창립 파트너이자 포브스 기술 위원회, 앙투안은 미래파 예술가 AI와 로봇공학의 미래에 열정을 갖고 있는 사람입니다.

그는 또한 증권.io 투자 웹사이트, 제너레이티브 AI 플랫폼 이미지.ai, & 그는 현재 출시 작업 중입니다. 천재.ai 프롬프트를 하위 작업으로 나누어 자율 에이전트를 구성하고 배포할 수 있는 기능을 사용자에게 제공하는 플랫폼입니다.

[출처] https://www.unite.ai/ko/%EC%B5%9C%EA%B3%A0%EC%9D%98-%EC%98%A4%ED%94%88-%EC%86%8C%EC%8A%A4-LLM/

Loading