6 9월 2024

[사회과학] [형사고소 변호사 / 고소대리] 고소장 제출 전에 고민해야 할 것들

[사회과학] [형사고소 변호사 / 고소대리] 고소장 제출 전에 고민해야 할 것들

[형사고소 변호사 / 고소대리] 고소장 제출 전에 고민해야 할 것들


01 snow-2952307_1920.jpg


​

고소·고발 사건이 많다는 말은 항상 있어 왔지만, 체감하는 고소사건은 더 늘어가는 것 같습니다. 최근 구치소에 방이 모자라 실형을 잘 선고하지 않는다는 검증되지 않은(!) 카더라 통신까지 들립니다. 법률상담 오시는 의뢰인들도 형사고소에 적극적인 분들이 많습니다.

​

사실 법적 분쟁의 상당수는 돈거래와 관련되어 있고, 돈거래라는게 대개 친인척이나 친구 등 어느정도 친분이 있는 사이에서 생깁니다. 결국 ‘친한(친했던) 사람’을 경찰서에 끌고 가는 셈이 되는데, 두 가지 심정이 교차합니다. ‘내가 돈 때문에 친구를 쇠고랑 채워야 하나’는 망설임, 그리고 반대로 ‘모르는 사람도 아닌 친구간에 어떻게 나에게 이럴 수 있냐’는 분노입니다.

​

심정적인 부분이야 본인이 스스로 정리하고 결단내릴 부분이지만, 사실 전략적인 면에서도 형사고소는 상당한 고민이 필요합니다. 고소장을 수사기관에 출하는 것은 돌이킬 수 없는 중요한 액션(!)이므로, 고소장 제출 전에 반드시 체크해야 할 사항들이 있습니다.

​

1. 친고죄 혹은 반의사불벌죄에 해당하는지 확인한다.

​

매우 중요한 사항인데, 생각 외로 일반인들(비법률가)이 잘못 알고 있는 경우가 많습니다. 고소인은 언제든지 고소를 취하함으로써 사건을 마음대로 종결시킬 수 있다고 생각하시던데, 어디까지나 ‘극히 일부 범죄’에 한하여만 맞는 말입니다.

​

우리가 실생활에서 흔히 접하는 폭행, 명예훼손 등의 범죄, 그리고  최근 개정 전 상당수 성범죄가 친고죄/반의사불벌죄에 해당하(였)고, 뉴스에서도 “피해자가 고소를 취하해 사건이 종결되었다”라는 보도가 자주 나와 아마도 그런 오해가 생기는 것 같습니다.

​

우선 친고죄는 범죄의 피해자 기타 법률이 정한 자의 고소가 있어야 공소를 제기할 수 있는 범죄이고, 반의사불벌죄는 피해자가 가해자의 처벌을 원하지 않는다는 의사를 표시하면 처벌할 수 없는 범죄입니다. 뭐가 다른지 어렵지요? 

법률상 개념의 차이는 분명히 있지만, 고소인 입장에서 중요한 효과는 공통적입니다. 바로 ‘낙장불입’​이 적용되느냐 여부이지요.

​

우리 법이 정하는 범죄들 대부분은 ‘낙장불입’이 적용됩니다. 일단 고소장을 내면, 아무리 고소를 취하하고 “합의했으니 벌하지 말고 집에 보내주세요”해도  검사가 유죄라고 판단하면 기소되어 재판을 받습니다.

​

다만 ‘예외적으로’ 일부 범죄는 친고죄/반의사불벌죄로 정하여 피해자(고소권자)가 고소를 취하하거나 처벌을 원하지 않는다는 의사를 명시하면 형사절차를 그대로 종결시키는 것입니다(수사단계라면 기소하지 않고, 재판단계라면 유/무죄 판단을 하지 않고 공소를 기각합니다). 

​

정리하자면 전체 범죄 중 극히 일부인 몇몇 친고죄/반의사불벌죄를 제외하고는, 고소장은 한 번 제출하면 돌이킬 수 없습니다.

​

2. ‘낙장불입’이 왜 중요한가?

​

고소 전 상태로 되돌릴 수 있느냐 여부에 따라 고소장 제출 후 고소인의 협상력에 큰 차이가 있기 때문입니다. 

​

예를 들어 사기죄는 친고죄도 반의사불벌죄도 아닙니다. 친구가 1억을 안 갚아서 고소했다고 칩시다. 친구한테 “돈 갚으면 고소 취하해줄게” 하면 뭐라고 할까요?

​

양심이 남아있는 사람이라면 “최대한 갚을테니 부탁해” 하겠지만, 전과 좀 있고 법을 아는 사람이라면 이렇게 말할 겁니다. “내가 1억 다 갚으면 집행유예를 기대해볼 수 있겠지만 지금 그럴 돈도 없고 기껏 2,3천 갚아봤자 어차피 실형에 2개월 줄어드는 정도야. 니가 감히 나를 고소해? 나는 감방가면 그만이야. 너한테는 1원도 못 갚아.”

​

이는 일단 고소장이 접수된 이상 피해자가 고소를 취하하더라도 기소되어 재판받는 것을 막을 수 없고 단지 양형 참작 사유에 불과하기 때문입니다. 

물론 사기꾼에게 돈이 많으면 되도록 갚아서 실형을 피하려는 노력을 할 겁니다. 하지만 돈이 없어서 누구에게라도 빌려야 하는 상황이라면, ‘어차피 다 못갚으면 실형인데 뭐하러 갚냐’며 배째라고 나오는 사람들도 꽤 있습니다. 따라서 이런 반응이 예상된다면 형사고소 시점을 신중히 결정해야 합니다.

​

요컨대 고소장을 제출하면 형사사건이 본격화 되어 자신의 협상력이 더 커진다고 생각하기 쉽지만, 모든 경우에 그렇지는 않다는 말입니다. 상대방이 어떤 사람이냐를 파악한 후 고소 시점을 결정해야 합니다. 

​

​친고죄/반의사불벌죄인 경우에는 위와 달리 고소 후에도 협상력을 상당수준 유지할 수 있습니다.

​

​

3. 형사고소 이외의 방법을 미리 알아보고 순서를 정한다.

​

형사고소 외의 방법을 무조건 선행해야 한다는 뜻은 아닙니다. 사안에 따라 그 순서는 달라지는 것이지요, 다만 형사고소의 파급효과가 워낙 크므로 다른 방법이 있다면 고소장 제출 전에 모두 파악하여 순서를 결정한 후 행동에 나가라는 것입니다.

​

예를 들어 변호사 명의의 내용증명을 보내어 압박한다거나, 회사 내의 사건이라면 우선 내부 감사팀에 알려 공론화시킨다거나, 가족간의 일이라면 영향력 있는 중재자를 포섭한다거나, 상대방의 가족/지인과 연락하는 방법 등이지요.

​

사람이라는 게 비슷한 듯 하지만 또 다 제각각입니다. 딱 봐도 ‘꾼’이다 싶고 재산도 다 빼돌려 놓아 별 기대 없이 내용증명을 보냈는데 곧바로 돈을 갚는 사람도 있고, 반대로 점잖고 사회적 지위도 있어 보이는데 고소하라고 배째라는 사람도 있지요. 해 보기 전에는 모를 일입니다.

​

특히 민사소송과 관련하여 고민하게 됩니다. 형사 고소의 최종 목적이 돈을 받는 일인 경우에 더 그렇습니다. 형사고소부터 덜컥 하면 무조건 민사 소송에 도움이 될까요? 단정할 수 없습니다. 이에 관하여는 기존에 쓴 글에 자세히 적었으므로 관심있는 분은 아래 링크를 참고바랍니다.


4. 형사고소가 상대방에게 어떤 타격을 입힐지 ‘구체적으로’ 예상해 본다.

​

단순히 ‘고소하면 벌 받는다’의 단선적 사고가 아니라, 고소를 한 후 단계별로 어떤 상황이 벌어질지 구체적으로 예상해야 합니다. 고소할 범죄명, 처벌수위, 수사기간, 상대방의 직업이나 상황에 따른 변수 등을 고려합니다.

이 과정을 거쳐야 내가 가진 ‘형사 고소’카드를 언제 어떻게 ‘얼마나’ 활용할지 결정할 수 있습니다.

 예를 들어 고소해 처벌받아봤자 벌금형 얼마 정도는 별로 겁도 안 먹는 상대방이라면 단순히 ‘고소하겠다’는 엄포만으로는 부족하겠지요. 또 상황에 따라서는 형사처벌 자체보다 고소에 따른 다른 파급효과를 겁내는 경우도 있습니다.


5. 분쟁이 본격화되기 전에 증거를 수집한다.

​

기소 가능성을 높이기 위해서는 고소인이 중요 증거를 고소장 단계에서부터 최대한 수집해 제출해야 합니다. 고소장 자체는 민원센터에서 주는 종이에 슥슥 적어 내도 법적으로 전혀 문제가 없지만, 수사관이 사건을 대하는 태도 역시 딱 그 정도가 될 가능성이 높지요.

​

​사실 이혼소송이랑 비슷합니다. 열받아서 이혼소장부터 날리는 사람은 하수입니다. 주도면밀한 사람은 귀책사유 입증이나 양육권, 재산분할에 대비해 장기간 조용히 준비한 후 유리한 고지를 점하고 나면 비로소 소장을 제출하지요. 이빨을 드러내기기에 앞서 (상대방이 나를 아직 마음 약한 착한 사람으로 얕보고 있을 때) 증거를 수집해야 합니다.

​

증거 수집이라는 게 별 게 아닙니다. 예를 들어 차용금사기의 경우 빌려갈 때 말한 명목과 실제 사용처가 다르다는 사실, 또 자신의 재력에 대해 거짓말을 했느냐 여부 등이 기소 여부에 중요하게 고려됩니다. 

따라서 “저번에 7월 곗돈 타면 준다고 했잖아?”, “그때 빌려서 병원비 쓴다더니 제수씨한테 물어보니 실손보험 다 탔다던데 어찌된거야?”라고 물어보고 (뭐라고 하든) 답을 들어 문자나 카톡을 저장해놓는 간단한 작업도 훌륭한 증거가 됩니다.  

​이상적으로는 이 준비단계에서 변호사의 조언을 받는 것이 가장 좋습니다. 이제까지 진행된 상황을 변호사가 살펴본 후 이런 것은 기소하는 데 필요한 좋은 증거다, 저것은 상대방에 유리한 내용이다. 이런 것을 추궁해 대답을 녹취해라. 이런 의문점이 있으니 해소되어야 검사를 설득할 수 있다, 이런 서류를 떼 봐라 등의 구체적 조언을 해 줄 수 있습니다.

​

6. 고소대리 : 고소장 제출 전 단계가 승패를 가른다.

​

사실 ‘고소대리’라는 말이 아직 생소한 분들이 많을 겁니다. 다른 글에서도 언급(푸념?)했지만, 변호사들끼리 만나면 서로 자기가 더 고생했다고 징징대는 사건 중에 상당수가 고소대리입니다. 

재판 사건에 비해 비정형적인 일이 많아 손은 많이 가는데, 정작 의뢰인들은 ‘수사는 검사가 하는 거 아니냐’는 생각에 수임료에도 인색하고 공을 잘 안 알아주거든요. 그리고 기소 여부 예측은 재판 결과보다 더 어려운 경우가 많아서, 열심히 준비했는데 싱겁게 불기소가 되어 의뢰인 앞에서 면을 못 세우는 경우도 많습니다(또 푸념입니다).

​

일단 고소장이 제출되고 나면 상대방도 정신 바짝 차리고 변호인을 선임해 방어하므로 일이 까다로워집니다. 고소장 작성 단계에서 충실한 준비가 필요하며, 고소장을 언제 어떻게 낼 지에 대한 고민 자체도 중요하다는 점을 기억하세요.

​​


 [출처] https://blog.naver.com/mujinlaw/221291330146


Loading

5 9월 2024

[사회과학][형사 전문 변호사] 형사사건의 수사 및 재판 절차 – 고소장 제출부터 재판까지

[사회과학][형사 전문 변호사] 형사사건의 수사 및 재판 절차 – 고소장 제출부터 재판까지


01 대법원_로비1-004.png

​

​안녕하세요. 김기용 형사전문변호사입니다.

​

1. 고소단계 및 경찰 수사 단계

​

가. 고소인이 고소장을 경찰서에 제출하는 경우

​

고소인이 고소장을 경찰서에 제출하면 일반적으로 담당수사관은 고소인을 불러 조사를 하고, 그 후에 피고소인을 소환하여 조사합니다. 필요한 경우 고소인과 피고소인을 대질 조사하고, 계좌내역, 통화내역, 관련 서류를 조사합니다. 담당수사관이 조사를 완료하였다고 판단하는 경우 관할 검찰청에 송치합니다. 담당수사관은 송치의견서에 피고소인을 기소해야하는지, 불기소처분을 해야 하는지에 관하여 의견을 기재합니다. 보통 이러한 수사과정은 약 2~3개월 정도 소요됩니다. ​

​

검찰청에 고소장을 제출하는 것과 가장 큰 차이점은 일반적으로 담당경찰관이 송치 전에 검사에게 지휘를 받지 않는다는 것입니다. 지휘를 받지 않기 때문에 비교적 신속하게 수사가 진행된다는 장점이 있습니다. 반면에 검사의 지휘를 받지 않으므로 수사가 미진할 가능성이 있습니다.

​

나. 고소인이 고소장을 검찰청에 제출하는 경우

​

고소인이 고소장을 검찰청에 제출하면, 담당 검사가 고소장을 검토한 후 관할 경찰서에 사건을 내려 보냅니다. 경찰서의 담당수사관은 고소인 조사, 피고소인 조사, 대질 조사 등의 수사과정을 거쳐서 담당 검사에게 일단 기록을 보내 수사지휘를 받습니다. 담당 검사는 기본적으로 필요한 조사가 모두 이루어졌다고 판단하면 송치하도록 지휘하고, 만약 보충 수사가 필요하다고 판단한 경우에는 보강 수사를 지휘합니다. 담당수사관은 검사의 지휘에 따라 송치하거나 보강 수사를 실시한 후 다시 검사의 지휘를 받습니다. 이 경우에도 경찰의 담당수사관이 검사에게 송치하는 데는 약 2~3개월 정도가 소요됩니다.

​

경찰서에 고소장을 제출하는 것과 가장 큰 차이점은 일반적으로 담당경찰관이 송치 전에 검사의 지휘를 받는다는 것입니다. 지휘를 받기 때문에 송치까지 시간이 많이 소요되지만, 송치 전에 검사가 충분한 수사를 지휘할 가능성이 많아 수사가 철저히 진행될 수 있습니다.

​

​02 20160329-276.jpg

​

2. 검찰 수사 단계

​

가. 검찰 수사 진행

​

담당 검사는 송치된 기록을 보고 바로 기소, 불기소의 처분을 하기도 하고, 만약 보강 수사가 필요하다고 판단한다면 직접 수사를 진행하기도 합니다. 담당 검사는 필요한 경우 고소인, 피고소인을 다시 불러 조사를 진행하기도 합니다. 만약 피고소인을 구공판(정식재판, 일반적으로 검사가 법정에서 피고소인에게 징역형이나 징역형의 집행유예를 구형하는 경우) 해야 하는 경우라면 검사가 적어도 피고소인을 다시 불러 직접 조사하는 것이 일반적입니다.

​

나. 검사의 처분

​

담당 검사는 수사가 모두 완료되었다고 판단하면 피고소인에 대하여 불기소처분(혐의 없음, 죄가 안됨, 공소권 없음, 각하, 기소유예 등)을 하거나 기소(구속구공판, 불구속구공판, 약식명령)을 하게 됩니다. 검사가 사건을 송치 받고 위와 같은 최종적인 결정을 하는데는 약 1~3개월 정도가 소요됩니다. 다만, 매우 간단한 사안의 경우에는 송치받은 당일 처분을 하는 경우도 있고, 반대로 사건이 매우 복잡하거나 보강 조사가 많이 필요한 경우에는 3개월을 초과하기도 합니다.

​

만약 고소인이 불기소처분에 대하여 불복하고자 하는 경우에는 고등검찰청에 ‘항고‘를 하면 되고, 항고 사건조차 기각되는 경우에는 고등법원에 ‘재정신청‘을 할 수 있습니다

​

03 20160329-316.jpg

​

3. 법원의 재판단계

​

가. 약식명령

​

검사가 피고소인을 벌금형으로 처벌하려고 하는 경우에는 검사는 벌금액수를 지정하여 법원에 약식명령을 청구합니다. 법원은 약식명령을 받게 되면 특별한 사정이 없는 한 검사의 벌금액수 대로 약식명령을 발령합니다. 법원은 약식명령이 청구되면 보통 1개월 이내에 약식명령을 발령합니다. 다만 판사가 기록을 검토하였는데 범죄의 형의가 없다고 판단하거나 반대로 벌금이 아닌 징역형으로 처벌한다고 판단한다면 직권으로 정식재판회부 결정을 하게 됩니다. 정식재판회부가 되면 아래에서 보는 바와 같이 일반적인 정식 재판 절차가 진행됩니다.

​

만약 피고소인이 법원으로부터 약식명령을 받았는데, 자신이 범죄를 저지르지 않았다고 생각하거나 벌금액수가 많다고 생각한다면 약식명령을 받은 날로부터 7일 이내에 정식재판청구를 하시면 됩니다. 그러면 정식재판절차로 법정에서 재판을 다시 받을 수 있습니다. 다만 이 경우에는 불이익변경금지 원칙이 적용되어 피고소인은 약식명령보다 무거운 형으로 처벌받지는 않습니다.

​

검사가 약식명령을 청구한 경우에도 다시 ‘정식재판청구‘를 할 수 있지만 실제 이러한 경우는 극히 예외적인 경우입니다. 자신이 한 번 약식명령을 청구한 것을 뒤집고 정식재판청구를 하기는 여러모로 곤란하기 때문입니다.

​

안타깝게도 고소인이 피고소인에 대한 검사의 약식명령청구가 지나치게 형이 낮다고 생각하여 불복할 수 있는 방법은 없습니다. 다만 고소인은 담당 검사나 약식명령 담당 판사에게 탄원서 등을 제출할 수는 있으나 쉽지는 않습니다.

​

나. 정식재판

​

검사가 피고소인을 구속 구공판, 불구속 구공판하게 되면, 일반적인 재판절차가 진행됩니다(정식재판회부되거나 정식재판청구 된 사건도 마찬가지입니다). 보통 영화에서 보는 것과 같은 재판절차가 진행되는 것입니다. 이러한 정식재판은 검사의 모두진술, 피고인의 공소사실에 대한 의견, 증인신문, 기타 증거조사, 피고인 신문 등의 순서대로 진행됩니다.

​

법원은 증거조사 절차를 모두 마쳤다고 판단하는 경우 변론을 종결(결심)하게 되는데, 마지막으로 검사가 구형을 하고 피고인과 변호인이 최후진술을 합니다. 법원은 보통 결심 후 2주 정도 후에 판결을 선고합니다.

​

피고인이나 검사는 1심의 판결에 불만이 있으면 항소하게 됩니다. 항소심 절차도 1심 절차와 비슷하지만 1심에서 어느 정도 증거조사가 이루어졌기 때문에 간단하게 끝나는 경우가 많습니다. 피고인이나 검사는 2심 판결에 대해서도 불만이 있으면 상고를 하면 됩니다. 다만 상고심의 경우에는 법리적인 문제만을 다툴 수 있고, 양형에 대해서는 다툴 수 없습니다. 즉 대법원은 피고인에 대한 형량이 높은지 낮은지에 대해서는 심리하지 않습니다.

​

04 김기용_변호사_소개.png

​


Loading

2 9월 2024

[인공지능 기술] RAG(검색 증강 생성)란? – LLM 단점을 보완하는 기술

[인공지능 기술] RAG(검색 증강 생성)란? – LLM 단점을 보완하는 기술

RAG(검색 증강 생성)란? – LLM 단점을 보완하는 기술

LLM(Large Language Model)의 많은 장점에도 불구하고 단점을 보완하기 위한 RAG(검색 증강 생성)이 많은 관심을 받고 있습니다. RAG의 기본 개념, 등장 배경, 원리, 적용 사례 등을 알아보겠습니다.

2024-05-07 | 박성돈

최근 인공지능 기술의 발전은 다양한 분야에서 혁신을 일으키고 있으며, 그 중에서도 텍스트 생성 AI는 특히 주목받고 있습니다. 하지만 이러한 기술이 가진 정확성과 신뢰성의 문제는 사용자와 개발자 모두에게 중요한 과제로 남아 있습니다. 이 문제를 해결하기 위해 등장한 기술 중 하나가 바로 RAG(Retrieval-Augmented Generation)입니다.

본문에서는 RAG의 기본 개념, 등장 배경, 원리, 적용 사례 등에 대해 살펴보겠습니다. 먼저 LLM이 무엇인지, 특징과 장/단점에 대해 알아보겠습니다.

LLM이란?

LLM은 Large Language Model의 약자로, 자연어 처리(NLP)에서 사용되는 인공지능 기술의 한 종류입니다. 이 모델들은 대규모의 텍스트 데이터를 학습하여 언어의 구조와 의미를 이해하고, 그 학습을 바탕으로 텍스트 생성, 번역, 요약, 질문에 대한 답변 등 다양한 언어 관련 작업을 할 수 있습니다.

LLM의 주요 특징은 다음과 같습니다.

  • 방대한 지식 보유: 다양한 분야의 텍스트를 학습하여 광범위한 지식을 갖추고 있습니다.
  • 문맥 이해 능력: 단순히 단어를 매칭하는 것이 아니라 전후 맥락을 고려하여 언어를 이해할 수 있습니다.
  • 자연어 생성 능력: 문장 생성, 질문 응답, 요약, 번역 등 다양한 자연어 처리 태스크를 수행할 수 있습니다.
  • 전이 학습 능력: 한 분야에서 학습한 지식을 다른 유사 태스크에 활용하는 등 전이 학습이 가능합니다.
  • 확장성: 더 많은 데이터와 컴퓨팅 자원을 활용하면 계속 성능을 향상시킬 수 있습니다.

LLM은 챗봇, 검색 엔진, 콘텐츠 생성 등 다양한 분야에서 활용되고 있으며, 인간과 유사한 수준의 언어 이해와 생성 능력을 보여주고 있습니다. 하지만 편향성 문제, 사실 관계 오류 등의 한계점도 지적되고 있어 해결해야 할 과제도 남아있는 상황입니다.

LLM의 장점

LLM(Large Language Model)은 다음과 같은 다양한 장점을 가지고 있습니다:

  1. 광범위한 지식 활용
    • 방대한 양의 텍스트 데이터를 학습하여 다양한 분야의 지식을 습득
    • 학습한 지식을 바탕으로 사용자의 질문에 폭넓고 심도 있는 답변 가능
  2. 뛰어난 언어 이해 및 생성 능력
    • 단어 간의 관계와 문맥을 고려하여 자연스러운 언어 이해 가능
    • 문법적으로 정확하고 의미 있는 문장 생성 능력
  3. 다양한 태스크 수행 가능
    • 텍스트 분류, 질의응답, 요약, 번역, 문장 생성 등 다양한 NLP 태스크 처리 가능
    • 하나의 모델로 여러 태스크를 수행할 수 있어 범용성이 높음
  4. 사용자 친화적인 인터페이스
    • 자연어로 된 사용자 입력을 이해하고 응답할 수 있어 접근성이 좋음
    • 챗봇, 가상 어시스턴트 등으로 활용되어 사용자 경험 향상
  5. 다양한 분야에서의 활용
    • 고객 서비스, 콘텐츠 제작, 교육, 의료 등 다양한 산업 분야에서 활용 가능
    • 사람과 기계 간의 상호작용을 향상시키고 업무 효율성 증대에 기여

LLM의 단점

LLM(Large Language Model)은 많은 장점에도 불구하고 다음과 같은 단점과 한계점을 가지고 있습니다:

  1. 편향성 문제
    • 학습 데이터에 내재된 편향성을 그대로 반영할 수 있음
    • 성별, 인종, 종교 등에 대한 고정관념이나 차별적 표현을 생성할 위험 존재
  2. 사실 관계 오류 가능성
    • 방대한 데이터를 학습하지만, 항상 정확한 정보를 제공하지는 않음
    • 잘못된 정보나 허위 정보를 진실로 간주하고 전파할 수 있음
  3. 맥락 이해의 한계
    • 문장 단위의 이해는 가능하지만, 장문의 글이나 복잡한 맥락 파악은 어려울 수 있음
    • 세계 지식과 상식 추론 능력이 부족하여 심층적인 이해에 한계 존재
  4. 일관성 문제
    • 동일한 입력에 대해 일관된 답변을 생성하지 않을 수 있음
    • 모델의 확률적 특성상 생성 결과가 매번 달라질 수 있어 신뢰성 저하
  5. 윤리적 문제
    • 악용 가능성이 존재하며, 책임 소재 파악이 어려울 수 있음
    • 모델의 출력 결과에 대한 통제와 검증 체계 마련 필요

RAG는 LLM의 단점 중 무엇을 개선하는가?

RAG(Retrieval-Augmented Generation)는 LLM의 단점 중 ‘사실 관계 오류 가능성’과 ‘맥락 이해의 한계’를 개선하는 데 초점을 맞춘 방법입니다. RAG는 LLM에 외부 지식 베이스를 연결하여 모델의 생성 능력과 사실 관계 파악 능력을 향상시키는 기술입니다.

구체적으로 RAG는 다음과 같은 방식으로 LLM의 한계를 보완합니다:

  1. 외부 지식 활용
    • 대규모의 구조화된 지식 베이스(예: 위키피디아)를 모델에 연결
    • 주어진 질의에 대한 관련 정보를 지식 베이스에서 검색 및 추출
  2. 증거 기반 생성
    • 검색된 지식 정보를 증거로 활용하여 보다 사실에 기반한 답변 생성
    • 생성된 답변의 출처를 명시함으로써 신뢰성 향상
  3. 맥락 이해력 향상
    • 외부 지식을 통해 질의에 대한 배경 지식과 맥락 정보를 파악
    • 단순한 패턴 매칭이 아닌 추론 능력을 바탕으로 한 답변 생성

RAG는 기존 LLM의 생성 능력과 외부 지식 베이스의 정보를 결합함으로써, 보다 정확하고 사실에 기반한 답변을 제공할 수 있습니다. 또한 모델의 출력 결과에 대한 증거를 제시할 수 있어 설명 가능성과 신뢰성을 높일 수 있습니다.

RAG 기술은 질의응답, 정보 검색, 팩트 체킹 등의 태스크에서 활발히 연구되고 있으며, 구글의 LaMDA, OpenAI의 WebGPT 등 최신 LLM에도 적용되고 있습니다. 다만 RAG 모델의 성능은 연결된 지식 베이스의 품질과 커버리지에 크게 의존하므로, 고품질의 지식 베이스 구축이 중요한 과제로 남아 있습니다.


RAG의 기본 개념

RAG(Retrieval-Augmented Generation)는 대규모 언어 모델(LLM)의 한계를 극복하기 위해 제안된 새로운 자연어 처리 기술입니다. LLM은 방대한 양의 텍스트 데이터를 사전 학습하여 강력한 언어 이해 및 생성 능력을 갖추고 있지만, 학습 데이터에 없는 최신 정보나 특정 도메인 지식은 제공하기 어렵다는 단점이 있습니다.

RAG는 이러한 LLM의 한계를 극복하기 위해 ‘지식 검색’과 ‘언어 생성’을 결합한 프레임워크입니다. RAG의 기본 아이디어는 질문에 답하기 위해 필요한 지식을 외부 데이터베이스에서 검색하여 활용하는 것입니다.

RAG의 주요 구성 요소

  1. 질의 인코더(Query Encoder): 사용자의 질문을 이해하기 위한 언어 모델입니다. 주어진 질문을 벡터 형태로 인코딩합니다.
  2. 지식 검색기(Knowledge Retriever): 인코딩된 질문을 바탕으로 외부 지식 베이스에서 관련 정보를 검색합니다. 예를 들어 Wikipedia, 뉴스 기사, 전문 서적 등 방대한 문서 집합에서 질문과 연관된 문단이나 구절을 찾아냅니다.
  3. 지식 증강 생성기(Knowledge-Augmented Generator): 검색된 지식을 활용하여 질문에 대한 답변을 생성하는 언어 모델입니다. 기존의 LLM과 유사하지만, 검색된 지식을 추가 입력으로 받아 보다 정확하고 풍부한 답변을 생성할 수 있습니다.

RAG의 동작 과정 요약

  1. 사용자의 질문이 주어지면 질의 인코더가 이를 이해하기 쉬운 형태로 변환합니다.
  2. 지식 검색기가 인코딩된 질문을 바탕으로 외부 지식 베이스에서 관련 정보를 검색합니다.
  3. 검색된 지식은 지식 증강 생성기의 입력으로 전달됩니다.
  4. 지식 증강 생성기는 검색된 지식을 활용하여 사용자 질문에 대한 답변을 생성합니다.

RAG는 LLM의 강력한 언어 이해 및 생성 능력과 외부 지식 활용을 결합함으로써, 보다 정확하고 풍부한 정보를 제공할 수 있습니다. 특히 최신 정보나 특정 도메인 지식이 필요한 질문에 효과적으로 대응할 수 있다는 장점이 있습니다.

RAG의 등장 배경과 필요성

RAG는 자연어 처리와 인공지능 기술의 발전, 그리고 증가하는 사용자의 요구에 따라 등장하게 되었습니다. RAG의 등장 배경과 필요성을 다음과 같이 정리할 수 있습니다.

  1. 지식 기반 질의응답 시스템의 한계
    • 초기의 질의응답 시스템은 주로 제한된 도메인의 구조화된 데이터를 기반으로 동작했습니다. 이는 시스템이 다룰 수 있는 주제와 질문의 유형이 한정적이라는 문제가 있었습니다.
    • 사용자의 다양한 정보 요구를 충족시키기 위해서는 보다 광범위한 지식을 활용할 수 있는 시스템이 필요하게 되었습니다.
  2. 비정형 텍스트 데이터의 폭발적 증가
    • 인터넷의 발달과 디지털 기기의 보급으로 웹페이지, 뉴스 기사, 소셜 미디어 게시물 등 비정형 텍스트 데이터가 기하급수적으로 증가하고 있습니다.
    • 이러한 대규모 텍스트 데이터는 방대한 지식을 포함하고 있어, 질의응답 시스템의 지식 베이스로 활용할 수 있는 잠재력이 높습니다.
    • 그러나 비정형 데이터를 효과적으로 처리하고 활용하기 위해서는 기존과는 다른 접근 방식이 필요했습니다.
  3. 사전 학습된 언어 모델의 발전
    • BERT, GPT 등 사전 학습된 대규모 언어 모델의 등장은 자연어 처리 분야에 큰 변화를 가져왔습니다.
    • 이러한 언어 모델은 방대한 텍스트 데이터로부터 언어의 구조와 의미를 학습하여, 다양한 언어 이해 및 생성 태스크에서 뛰어난 성능을 보여주었습니다.
    • 사전 학습된 언어 모델을 질의응답 시스템에 활용함으로써, 보다 자연스럽고 문맥을 고려한 답변 생성이 가능해졌습니다.
  4. 실시간 정보 제공에 대한 사용자의 요구 증대
    • 인터넷과 모바일 기기의 발달로 사용자들은 언제 어디서나 필요한 정보를 즉시 얻고자 하는 요구가 커지고 있습니다.
    • 단순히 정보를 검색하는 것을 넘어, 대화형 인터페이스를 통해 원하는 정보를 직관적으로 얻고자 하는 사용자가 늘어났습니다.
    • 이에 따라 사용자의 질문을 이해하고 적절한 답변을 실시간으로 제공할 수 있는 지능형 질의응답 시스템의 필요성이 대두되었습니다.
  5. 지식 검색과 답변 생성의 통합 필요성
    • 기존의 질의응답 시스템은 지식 검색과 답변 생성을 별도의 단계로 처리하는 경우가 많았습니다. 이로 인해 검색된 정보와 생성된 답변 사이의 정합성이 떨어지는 문제가 발생했습니다.
    • 지식 검색과 답변 생성을 통합적으로 수행할 수 있는 프레임워크의 필요성이 제기되었고, 이는 RAG 아키텍처의 등장으로 이어졌습니다.

이러한 배경과 필요성 속에서 RAG는 대규모 비정형 텍스트 데이터를 활용하고, 사전 학습된 언어 모델과 통합 프레임워크를 통해 보다 진보된 형태의 질의응답 시스템을 구현하고자 합니다. RAG는 사용자의 다양한 정보 요구를 만족시키고, 인간과 자연스럽게 상호작용할 수 있는 지능형 대화 시스템의 발전에 기여할 것으로 기대됩니다.

RAG 기술을 적용한 상용 서비스 사례

RAG 기술을 적용한 상용 서비스는 아직 많지 않지만, 몇몇 대표적인 사례들이 있습니다.

  1. Microsoft Bing Search
    • 2023년 2월, Microsoft는 Bing 검색 엔진에 RAG 기술을 적용한 대화형 AI 기능을 추가했습니다.
    • 사용자의 검색 질의에 대해 웹 페이지의 정보를 활용하여 자연어로 응답을 생성합니다.
    • 제공된 응답의 근거가 되는 웹 페이지 링크를 함께 제시합니다.
  2. Anthropic’s Constitutional AI (CAI)
    • Anthropic사는 RAG 기술을 활용한 대화형 AI 모델인 CAI를 개발했습니다.
    • CAI는 대화 과정에서 외부 지식을 활용하여 사용자의 질문에 답변을 생성합니다.
    • 생성된 응답의 근거가 되는 출처를 명시하여 신뢰성을 높였습니다.
  3. Perplexity AI
    • Perplexity AI는 RAG 기반의 질의응답 서비스를 제공하는 스타트업입니다.
    • 사용자의 질문에 대해 웹 검색을 통해 관련 정보를 수집하고, 이를 바탕으로 응답을 생성합니다.
    • 제공된 응답의 출처와 검색 과정을 사용자에게 투명하게 공개합니다.
  4. OpenAI’s WebGPT (in development)
    • OpenAI는 GPT 모델에 RAG 기술을 적용한 WebGPT를 개발 중입니다.
    • WebGPT는 웹 검색을 통해 획득한 지식을 활용하여 사용자의 질의에 대한 응답을 생성할 것으로 예상됩니다.
    • 아직 공개된 서비스는 아니지만, 향후 RAG 기술의 발전 방향을 보여주는 사례로 주목받고 있습니다.

위의 사례들은 RAG 기술의 초기 적용 단계라고 볼 수 있습니다. RAG의 잠재력이 입증됨에 따라 앞으로 더 많은 분야에서 RAG 기반의 서비스들이 등장할 것으로 예상됩니다. 특히 검색 엔진, 가상 어시스턴트, 고객 서비스 등의 분야에서 RAG 기술이 활발히 도입될 것으로 보입니다.

다만 RAG 기술의 상용화를 위해서는 지식 베이스의 품질 관리, 프라이버시 보호, 책임 소재 등의 이슈들이 선결되어야 할 것입니다. 기술적 진보와 함께 사회적, 윤리적 문제에 대한 고민이 병행되어야 RAG가 실생활에 안전하게 적용될 수 있을 것입니다.

참고 자료

[출처] https://modulabs.co.kr/blog/retrieval-augmented-generation/

Loading

1 9월 2024

[천체물리 – 우주(과학)] 부모 없는 떠돌이 행성, 알고 보니 이렇게 생긴다 [아하! 우주]

[천체물리 – 우주(과학)] 부모 없는 떠돌이 행성, 알고 보니 이렇게 생긴다 [아하! 우주]

부모 없는 떠돌이 행성, 알고 보니 이렇게 생긴다 [아하! 우주]

입력
[서울신문 나우뉴스]

Credit: ESA/Webb, NASA & CSA, A. Scholz, K. Muzic, A. Langeveld, R. Jayawardhana

Credit: ESA/Webb, NASA & CSA, A. Scholz, K. Muzic, A. Langeveld, R. Jayawardhana

태양계의 행성과 소행성, 혜성 등은 모두 태양이라는 부모가 있다. 이들은 모두 태양이 생길 때 주변에 모인 가스와 먼지가 뭉쳐 만든 원시 행성계 원반에서 태어났다. 원시 행성계 원반에서 덩어리가 크게 뭉치면 행성이 되고 작게 뭉치면 소행성이 되는 식으로 태양계의 수많은 형제가 태어난 것이다.

하지만 모든 행성이 별 주변을 공전하는 건 아니다. 과학자들은 어떤 별 주변도 공전하지 않는 떠돌이 행성(rogue planet)도 발견했다. 물론 스스로 빛나지 않는 천체인 행성은 너무 어둡기 때문에 관측이 어렵지만, 다른 별 앞을 우연히 지나면서 빛이 어두워지거나 중력에 의해 빛이 휘어지는 마이크로 중력렌즈 효과를 통해 숨어 있는 떠돌이 행성을 몇 개 포착하는 데 성공했다.

떠돌이 행성이 처음부터 혼자 태어난 행성인지, 아니면 본래는 어미 별이 있었는데 다른 별이나 행성의 중력 간섭으로 인해 튕겨 나온 행성인지는 확실치 않다. 그리고 관측이 어렵기 때문에 우주에 얼마나 많은 떠돌이 행성이 있는지도 파악하기 힘들다. 그런데 최근 과학자들은 제임스 웹 우주 망원경의 도움으로 떠돌이 행성이 스스로 생성될 수 있을 뿐 아니라 숫자도 많을 수 있다는 증거를 발견했다.

존스 홉킨스 대학의 천체물리학자인 아담 랑지벨드와 동료들은 제임스 웹 우주 망원경을 이용해서 지구에서 1,000광년 떨어진 가스 성운인 NGC 1333을 관측했다. 이 가스 성운에서는 가스가 뭉쳐 여러 개의 별이 생성되고 있다.

과학자들은 NGC 1333에서 새로 태어나는 별은 물론이고 일반적인 별보다 작은 천체인 갈색왜성도 관측했지만, 관측 기술의 한계로 행성 질량 천체가 혼자 태어나는 모습은 확인할 수 없었다.

연구팀은 제임스 웹 우주 망원경 관측 결과를 토대로 NGC 1333에 적어도 6개의 행성급 천체가 혼자 태어나고 있다는 사실을 발견했다. (사진에서 녹색 원) 이들의 질량은 목성의 5-10배 정도로 태양계 행성보다는 크지만, 별이나 갈색왜성보다는 분명히 작아 행성으로 분류할 수 있다.

이번 관측 결과에 따르면 별, 갈색왜성, 행성은 질량에 차이가 있을 뿐 생성되는 방식은 비슷했다. 가스 성운 안에서 중력에 의해 뭉친 가스와 먼지의 덩어리가 크면 별이 되고 그보다 작으면 갈색왜성, 더 작으면 행성이 될 뿐이었다. 사실 행성은 질량이 적어서 더 많이 생겨날 수 있다.

연구팀은 제임스 웹 우주 망원경의 강력한 성능으로도 목성 질량의 5배 이하의 행성은 관측이 어렵다고 보고 있다. 따라서 NGC 1333 내부에 더 많은 행성이 존재할 가능성이 있다. 우리 은하에 떠돌이 행성이 생각보다 훨씬 흔할 가능성을 시사하는 대목이다.

태양계의 목성이나 토성 같은 거대 가스 행성은 여러 개의 위성을 거느리고 있으며 이 가운데는 목성의 위성 유로파처럼 내부에 바다를 지닌 위성도 존재할 수 있다. 그리고 어쩌면 이 가운데 일부는 생명체를 품고 있을지도 모른다. 이런 떠돌이 행성이 태양계 가까운 곳에 숨어 있다면 외계 생명체를 탐사하는 과학자들의 새로운 목표가 될 것이다.

Loading

1 9월 2024

[사회과학] [박진영의 사회심리학] ‘나’는 일을 미루는 사람일까

[사회과학] [박진영의 사회심리학] ‘나’는 일을 미루는 사람일까

[박진영의 사회심리학] ‘나’는 일을 미루는 사람일까

입력
게티이미지뱅크 제공

게티이미지뱅크 제공

많은 사람들은 미루기 천재다. 금방 할 수 있을 거라는 둥 다양한 이유를 붙여가며 마지막까지 미루다가 데드라인 직전에 고통을 맛보며 심지어 우는 일을 많이 겪어봤을 것이다. 필자 역시 미루기에 대한 원고를 미루면서 작성했음을 밝힌다. 뻔히 더 고통받을 것을 알면서 우리는 왜 자꾸 미루는 걸까. 어떻게 하면 일을 미루지 않을 수 있을까.

우선 예상할 수 있겠지만 일이 지루하거나, 전혀 중요하게 여겨지지 않거나, 너무 어렵고 힘든 일이 그 자체로 부정적인 특성을 가지고 있을 때 미루기가 나타난다. 주로 하기 싫은 일을 미룬다는 것이다. 캘거리대의 심리학자 피어스 스틸에 의하면 그 외에 미루기와 관련이 있는 요소들은 다음과 같다.

① 부정적 정서 신경증: 미루기는 기본적으로 ‘지금’ 스트레스를 피하기 위해 현재 직면해야 할 괴로움을 내일로 토스하는 행위다. 미루기를 뜻하는 영단어 procrastination에서 ‘pro’는 라틴어로 ‘앞으로’라는 의미이고 ‘crastinus’는 ‘내일’을 뜻한다고 한다. ‘(오늘 일을) 내일로’라는 뜻이다.

이렇게 미루기는 눈 앞의 괴로움으로부터 도피하는 행위이기 때문에 이미 잔뜩 괴로운 상태인 경우 부정적 정서가 넘칠 때 그렇지 않을 때에 비해 더 일을 많이 미루는 현상이 나타난다.

따라서 몇몇 학자들은 미루기가 기본적으로 기분을 낫게 만들기 위한 또는 적어도 더 힘들어지지 않게 하기 위한 ‘정서 조절’ 전략이라고 본다. ‘도피’ 같은 부적응적인 스트레스 대처법들이 그러하듯 미루기 또한 내 마음이 나를 지키려고 고군분투하다보니 생긴 부작용 같은 것이라는 얘기다. (그러니 미루고 싶은 마음이 드는 것을 너무 미워하지는 말도록 하자). 이는 한편 평소 삶이 행복하고 마음이 괴롭지 않아야 미루지 않을 수 있다는 얘기이기도 하다.

관련해서 성격 특징 중 신경증(Neuroticism)은 부정적 정서성, 정서적 불안정성이라고도 불리는 특성으로 신경증이 높은 사람들은 기본적으로 그렇지 않은 사람들에 비해 늘 걱정이 많고 불안하며 스트레스를 쉽게 받는 경향을 보인다. 이렇게 성격적으로 스트레스에 취약할수록 도망치고 싶은 순간이 많은 편이고 따라서 미루기를 많이 하는 현상이 나타난다.

하지만 문제는 부정적 정서를 피하기 위해서 일을 미루는데 미루는 행위 자체가 미래의 더 큰 부정적 정서의 원천이 되고 만다는 것이다. 기분이 언짢고 스트레스가 많음 -> 미룬다 ->더 기분이 언짢아지고 더 스트레스 받음 -> 또 다시 미룬 결과 일이 망함으로써 더더 큰 스트레스를 받는 악순환이 발생하곤 한다.

② 미루는 행위 자체를 즐기는 것: 부정적 정서를 피하기 위해서 미루기를 한다는 사실과 관련해서 미루고 나면 일단 마음이 엄청 편해질 것이라거나 엄청 즐거워질 것이라며 미루기가 가져올 ‘긍정적 정서’의 크기를 과대평가할수록 더 자주 미루는 모습이 나타난다.

미루고 나면 이후 괴로움이 더 클 것이라고 예상하는 것보다 미뤄도 생각보다 별로 ‘즐겁지 않을 것’이라고 생각하는 것이 더 효과적으로 미루기를 줄여줬다는 발견이 있다[2]. 미루는 행위 자체를 삶의 낙으로 삼으면 안 된다는 것이다.

③ 실패에 대한 두려움, 완벽주의, 자기 의식, 평가에 대한 두려움: 기본적으로 일을 잘 해내야만 한다는 압박이 심하고 다른 사람이나 내가 생각하는 나의 이미지에 크게 신경 쓰는 사람들은 그렇지 않은 사람들에 비해 무엇을 하든 부담감이 큰 편이다.

이로 인해 일을 하기 ‘전’부터 일을 할 생각만 해도 스트레스를 받게 되고 그 결과 일을 시작하기도 전에 (스트레스는 다 받으면서) 일을 피하는 경향을 보인다. 적어도 남들이 보기에 완벽하게 해내야 한다든가 조금도 실수하면 안 된다는 부담감이 크면 일을 더 일찌감치 착착 해낼 것 같지만 의외로 일을 시작하기까지 많은 용기가 필요해서 손도 대지 못할 가능성이 크다는 것이다.

④ 자신에 대한 의심: 자신의 능력에 대한 의심이 많은 사람들은 그렇지 않은 사람들에 비해 실제 능력 수준은 비슷해도 어차피 해도 안 될 거라며 포기가 빠른 경향을 보인다.

못 할 거라고 생각하면 더 열심히 할 것 같지만 반대로 노력해도 소용없을 거라고 생각하기 때문에 밑 빠진 독에 물 붓는 격이라며 노력을 ‘덜’ 들이는 경향을 보이기도 한다. 그러다 보니 한 달 동안 준비해도 모자랄 일을 (어차피 안 될 거) 하는 시늉만 하자며 대충대충 벼락치기를 하는 모습을 보이곤 한다.

⑤ 자기 핸디캐핑(Self-handicapping): 하루 이틀 벼락치기하고도 이 정도 성적을 받은 건 꽤 잘 한 거라고 생각하기 위해 계속 공부를 안 하다가 마지막에 벼락치기를 하는 학생을 상상해 보자. 미리미리 열심히 해놓고도 실패했다는 사실을 직면하면 ‘내가’, ‘나의 능력이’ 부족하다는 결론이 나오게 된다.

이렇게 되면 자존감에 직격탄을 맞으므로 스스로 자신의 앞길에 장애물을 가져다 놓고서는 내가 못 한 게 아니라 장애물 때문에 어쩔 수 없었다고 변명하고 자존감을 수호하는 행위다. 내가 나를 좋게 생각하는 게 뭐 그렇게 중요하다고 자신의 앞길을 망쳐가며 자존감을 수호하는 것인지 인간은 참으로 슬픈 동물이다.

벼락치기로 해낼 수 있을 리가 없음을 충분히 알고 있으면서 마지막까지 사람들과 약속을 만들고 술을 진탕 마시는 등 ‘약속 때문에, 술 때문에 어쩔 수 없었다’고 하는 것이 흔한 예다.

⑥ 우울, 낮은 에너지 수준, 학습된 무기력, 비관주의: 무엇을 하든 즐거움을 찾기 어렵고 기력도 없고 집중하기도 어려운 경우다. 동기 부여가 어렵고 버틸 에너지도 부족해서 일을 시작하기도 어렵고 시작해도 ‘완성’하기는 더더욱 어렵다. 우울증을 측정하는 문항 중 ‘결정을 잘 내리지 못하고 마지막까지 미룬다’는 문항이 있을 정도이다. 위에서 살펴본 부정적 정서와도 큰 관련을 보인다.

⑦ 원만하지 않은 반항적인 성격: 이 경우는 조금 다른데 반항적이고 속박을 싫어하는 사람들의 경우 외부에서 정한 스케줄과 데드라인에 불쾌함을 느끼는 경향을 보인다. 그래서 정해진 스케줄을 거부하고 마음대로 일을 진행하기도 한다. 그래서 이들에게는 거꾸로 일을 ‘최대한 늦게’ 하라고 압박을 주면 청개구리처럼 일찍 해낸다는 발견이 있었다.

⑧ 충동성이 높고 지루함을 잘 참지 못하는 경우: 이 경우 미래나 장기적인 결과 책임 같은 걸 별로 생각하지 않고 지금 이 순간만 사는 경향을 보인다. 주의 집중도 잘 못해서 하던 일을 까먹고 다른 일을 하다가 정작 급한 일을 못 마치는 경우도 많다. 이런 사람들의 경우 주의를 분산시킬 수 있는 자극(스마트폰과 같은)이 많은 환경은 피하는 것이 좋다.

⑨ 자극 추구성: 자극 추구성이 높은 사람들의 경우 조금 다른 이유로 미루는 행동을 보인다. 이들은 일을 마지막 한 두 시간 남겨놓고 후달리면서 하는 스릴을 즐기는 또는 중독된 듯한 모습을 보인다. 긴장해서 빠짝하면 평소보다 더 높은 생산성을 보이기도 한다.

하지만 스릴은 짧지만 후회는 오래 갈 가능성이 있다. 관련해서 한 연구에 의하면 상습적으로 벼락치기를 하는 학생들은 벼락치기에서 높은 생산성을 보여줬지만 학기말 건강 상태나 성적, 삶의 만족도가 전반적으로 더 낮은 것으로 나타났다. 해당 연구자들에 의하면 “미루기의 이득은 짧고 비용은 오래간다”고 한다.

⑩ 체계성: 일을 계획하고 목표를 수립하며 목표 달성까지의 상황이 순조로운지 모니터링 하는 과정에 문제가 있어도 의도치 않게 미루는 현상이 발생한다. 어떤 일을 언제 해야 적절한지에 대한 청사진을 짜지 못하기 때문에 주먹구구식으로 한 달 걸릴 일을 일주일이면 할 수 있겠지~ 하다가 나중에 울고 만다. 미루려고 미룬 게 아니고 일 하는 과정이 체계적이지 못해서 미루게 되는 경우다.

⑪ 낮은 성취욕(achievement motivation): 별로 일을 잘 하고 싶은 마음이 없고 일의 즐거움을 잘 느끼지 못하는 경우다. 일을 너무 잘 하고 싶어하는 것도 문제지만 조금도 잘 할 마음이 없는 것도 문제일 수 있다는 것이다.

위의 원인들 중 몇 가지나 해당되는 것 같은가. 원인을 알면 해결책이 보이는 법이다. 미루기를 줄이기 위해서는 우선 즐거운 일을 많이 만들어 행복도를 높이고 부정적 정서, 스트레스, 불안, 우울을 줄일 것, 잘 해야만 한다는 부담감을 내려 놓을 것, 할 수 없는 부분에 대해서는 도움을 청하고 알게 될 때까지 연습 또 연습하기, 할 수 있는 부분은 정확하게 인식함으로써 자신감 높이기, 충동성이 높다면 유혹이 많은 환경은 피하기 등을 생각해 볼 수 있다.

기원전 300년 전에도 오늘 할 일을 내일로 미루는 행태의 사악함을 강조하는 글들이 쓰여졌다고 한다. 애초에 한정된 에너지를 가지고 살아가는 존재로써 에너지 보존을 위해서라도 때때로 일을 미루는 것은 자연스러운 일일 것이다.

하루하루 살아가는 것만으로도 상당히 벅찬 일이라서 모든 일을 제 때 처리한다는 것은 애초에 불가능하기도 하다. 따라서 또 일을 미루는 나를 보았을 때 자꾸 미룬다고 너무 자책하지 말고 그 이유를 찾아 내가 나의 힘듦을 조금이라도 덜어내자는 태도로 접근한다면 좋을 것 같다.

[1] Steel, P. (2007). The nature of procrastination: A meta-analytic and theoretical review of quintessential self-regulatory failure. Psychological Bulletin, 133, 65–94.
[2]Sirois, F., & Pychyl, T. (2013). Procrastination and the priority of short‐term mood regulation: Consequences for future self. Social and Personality Psychology Compass, 7, 115-127.
[3]Saddler, C. D., & Sacks, L. A. (1993). Multidimensional perfectionism and academic procrastination: Relationships with depression in university students. Psychological Reports, 73(3, Pt 1), 863–871.
[4]Tice, D. M., & Baumeister, R. F. (2018). Longitudinal study of procrastination, performance, stress, and health: The costs and benefits of dawdling. In Self-Regulation and Self-Control (pp. 299-309). Routledge.

Loading

24 8월 2024

[사회과학] [박진영의 사회심리학] 소속 욕구가 강할수록 상처받는다

[사회과학] [박진영의 사회심리학] 소속 욕구가 강할수록 상처받는다

[박진영의 사회심리학] 소속 욕구가 강할수록 상처받는다

입력
게티이미지뱅크 제공

게티이미지뱅크 제공

● 어떤 사람이 갈등을 잘 풀어갈까

어떤 관계에서든 아무리 좋은 사람을 만나더라도 적어도 한 번 이상 부딪힐 일이 반드시 생기기 때문에 인간관계에서는 어떤 사람을 만나느냐 하는 ‘선택’의 문제 못지않게 어떻게 관계를 ‘유지’해 나갈 것인가가 중요한 문제가 된다.

비슷한 갈등을 마주하게 되어도 어떤 사람들은 인간관계에서 갈등은 자연스러운 일이며 잘 얘기해서 풀어나가면 된다고 담담하게 받아들이는 반면 어떤 사람은 “어떻게 이런 일이!”라며 갈등은 결코 존재해선 안 되는 양 호들갑을 떨고 상대의 가벼운 실수에도 ‘나를 해치려고 일부러’ 그랬다거나 ‘원래 저것밖에 안 되는 사람’이라며 파괴적인 해석을 내려 결국 다른 사람들보다 더 쉽게 파국을 맞이하곤 한다. 이 차이는 어디서 나오는 걸까.

우선 연구들에 의하면 기본적인 성격 특성(높은 신경증)과 애착 유형(불안정 애착), 사람은 (따라서 관계 또한) 잘 변하지 않는다는 믿음(관계에 대한 성장적 관점과 운명론적 관점), 자기 자신이나 타인을 향한 비판적 완벽주의, 또 여러 상황적 요소(많은 스트레스와 걱정거리로 인해 정신적 소모가 심한 상태, 소외감) 등이 한몫하는 걸로 알려져 있다. 이들은 지금까지의 글에서 함께 살펴본 것들이기도 하다.

인격과 사회심리학 공보(Personality and Social Psychology Bulletin)에 실린 한 연구에 의하면 지나치게 강한 ‘소속 욕구’ 또한 너그럽지 않은 모습과 관련을 보인다고 한다.

● 소속 욕구가 강할수록 쉽게 상처받고 상처가 오래간다

“다른 사람들이 나를 받아들여 줬으면 좋겠다”, “나는 소속되고 인정받고자 하는 욕구가 강하다”, “사람들이 나를 받아들여 주지 않으면 나는 쉽게 상처받는다”, “사람들이 나를 빼고 뭔가를 하는 것이 싫다” 이는 소속 욕구(need to belong)를 묻는 문항들이다.

사회적 동물인 이상 인간은 누구나 어느 정도 애정과 인정을 갈구하기 마련이다. 다만 그 ‘정도’가 사람마다 달라서 위의 문항들에 높은 점수를 기록하는 사람이 있는 반면 비교적 그렇지 않은 사람이 있다.

모리시오 카발로 등의 연구자들은 사람들에게 지난 3개월 사이에 가족, 친구, 연인, 직장 동료 등에 의해 상처받거나 화가 났던 일에 대해 적어보라고 했다. 그런 뒤 상대에게 얼마나 보복하고 싶은지, 상대가 얼마나 망했으면 좋겠는지, 앞으로도 계속 볼 것인지 아니면 피해 다닐 것인지 등에 대해 물었다.

그 결과 소속 욕구가 강한 사람들이 그렇지 않은 사람에 비해 상대에게 화가 많이 났고 사건의 심각성을 크게 지각하며 그 사람을 용서할 수 없다고 응답하는 경향을 보였다. 소속 욕구가 강한 사람들은 그렇지 않은 사람들에 비해 이 사람과 계속 관계를 유지하면 미래에 비슷한 일이 또 일어날 것이라고 예상하는 것으로 나타났다.

● ‘내가’ 채워지는 것이 목적일 때 나타나는 보상 심리

언뜻 생각해 보면 사람들에게 사랑받고 인정받고자 하는 욕구가 강하면 상대가 잘못을 저질렀더라도 더 잘 포용하고 관계를 다시 제자리로 돌려놓기 위해 많은 노력을 할 것 같다. 하지만 정반대의 현상이 나타난 이유는 무엇일까.

일반적으로 목표가 간절할수록 많은 애를 쓰기 때문에 목표 달성률이 높아질 것으로 예상할 수 있다. 하지만 간과되는 점은 간절할수록 그것이 좌절되었을 때의 ‘실망’이 크며 때로는 자신의 실패를 받아들이지 못해 ‘이게 다 xx 때문’이라고 외부에 책임을 돌리는 현상도 나타난다는 것이다(Mauss et al., 2011).

인간관계 또한 그렇다. 적당히 애를 쓰는 것은 좋지만 강박적으로 애를 쓰는 경우 자연스러운 갈등과 내리막에도 필요 이상의 충격을 받으며 자신 외에 비난할 무언가를 찾으러 다닐 수 있다는 것이다.

또한 (나의) 소속 욕구를 채우고 싶다거나 (내가) 외로운 게 싫다는 다소 자기중심적인 이유가 관계의 핵심 동기가 되면 관계에 과한 노력을 쏟고서도 정작 상대는 요청한 적 없는 ‘필요 없는 오지랖’이나 ‘부담스러운 친절’이라는 결과를 낳게 되기도 한다(Feeney & Collins, 2001).

이 과정에서 나는 이만큼 했는데 상대가 하나도 알아주지 않는다던가 되려 나를 피한다는 사실에 큰 배신감을 느끼기도 한다. 더 많이 받고자 할수록 보상 심리도, 서운함도 커지는 법이다.

관계를 위한 노력과 자신의 희생에 주로 억울함을 먼저 느끼는 사람이 있는 반면 애초에 내가 좋아서 하는 것이고 사랑을 주는 것 자체가 내게는 기쁨이라고 하는 사람이 있다. 나 역시 서운함이 컸던 관계를 돌아보면 그 중의 상당수가 상대에게 주기보다 내가 받아내고자 하는 욕구가 더 컸던 관계들이다.

내 안의 결핍은 내가 알아서 채워야 한다. 누가 시켜서 또는 외로워지기 싫다는 수동적 이유가 아니라 내가 주길 원해서 내가 주고 싶은 만큼 맘껏 주고 그 자체로 기뻐할 수 있는 성숙한 사랑을 할 것을 기억해 보자.

Amitay, O. A., Mongrain, M., & Fazaa, N. (2008). Love and control: Self-criticism in parents and daughters and perceptions of relationship partners. Personality and Individual Differences, 44, 75-85.
Feeney, B. C., & Collins, N. L. (2001). Predictors of caregiving in adult intimate relationships: An attachment theoretical perspective. Journal of Personality and Social Psychology, 80, 972-994.
Jensen-Campbell, L. A., Knack, J. M., & Rex-Lear, M. (2009). Personality and social interactions. In P.J. Corr & G. Matthews (Eds.), The Cambridge handbook of personality psychology (pp. 506–523). Cambridge: Cambridge University Press.
Knee, C. R. (1998). Implicit theories of relationships: Assessment and prediction of romantic relationship initiation, coping, and longevity. Journal of Personality and Social Psychology, 74, 360-370.
Mauss, I. B., Tamir, M., Anderson, C. L., & Savino, N. S. (2011). Can seeking happiness make people unhappy? Paradoxical effects of valuing happiness. Emotion, 11, 807-815.
Shaver, P. R., Mikulincer, M., Sahdra, B. K., & Gross, J. T. (2016). Attachment security as a foundation for kindness towards self and others. In K. W. Brown & M. R. Leary (Eds.), The Oxford handbook of hypo-egoic phenomena (p. p223-242). New York, NY: Oxford University Press.

※필자소개
박진영. 《나, 지금 이대로 괜찮은 사람》, 《나를 사랑하지 않는 나에게》를 썼다. 삶에 도움이 되는 심리학 연구를 알기 쉽고 공감 가도록 풀어낸 책을 통해 독자와 꾸준히 소통하고 있다. 온라인에서 ‘지뇽뇽’이라는 필명으로 활동하고 있다. 현재 미국 듀크대에서 사회심리학 박사 과정을 밟고 있다

Loading

23 8월 2024

[물리] 韓 과학자들, 암흑물질 유력 후보 ‘액시온’ 수사망 좁혔다

[물리] 韓 과학자들, 암흑물질 유력 후보 ‘액시온’ 수사망 좁혔다

韓 과학자들, 암흑물질 유력 후보 ‘액시온’ 수사망 좁혔다

입력
물리학에서 우주를 설명하는 표준 모델에 따르면 우주의 구성 성분 중에 우리가 이해할 수 있는 물질은 약 5%뿐이다. 26.8%는 암흑물질이, 나머지는 암흑에너지가 차지한다. 게티이미지뱅크 제공

물리학에서 우주를 설명하는 표준 모델에 따르면 우주의 구성 성분 중에 우리가 이해할 수 있는 물질은 약 5%뿐이다. 26.8%는 암흑물질이, 나머지는 암흑에너지가 차지한다. 게티이미지뱅크 제공

표준 우주론 모델에 따르면 우주의 26.8%는 암흑물질이 차지하지만 암흑물질의 정체는 명확히 밝혀지지 않았다. 과학자들은 이론으로 예측된 범위에서 암흑물질이 존재하지 않는 영역을 배제하는 식으로 암흑물질을 찾는다.

특히 액시온(Axion)은 유력한 암흑물질 후보다. 질량이 매우 작으며 다른 입자와 상호작용을 거의 하지 않는 것으로 추정되는 입자다. 최근 기초과학연구원(IBS) 액시온 및 극한상호작용연구단은 액시온 존재 여부를 판단할 수 있는 범위를 좁힌 연구 결과를 최근 잇따라 공개해 주목을 받고 있다.

일반적으로 과학자들은 강력한 자석을 사용해 액시온의 존재 여부를 판단한다. 이론에 따르면 액시온은 자기장과 만나면 질량에 따른 주파수를 나타내는 광자(빛의 입자)로 변환된다. 이때 공진기를 이용해 주파수를 증폭하고 검출하면 해당 관찰 영역의 액시온 존재 여부를 파악할 수 있다.

핵심은 액시온의 질량과 질량이 변환된 주파수를 알지 못한다는 점이다. 이론에서 예측한 넓은 주파수 영역에서 라디오 주파수를 맞추듯 조금씩 탐색해야 한다.

● 자체 장비 개발해 액시온 탐색

액시온에 대한 이론적 모델로 ‘DFSZ’와 ‘KSVZ’가 있다. ‘DFSZ 액시온’ 모델에서 예측한 액시온은 KSVZ에서 제시한 것보다 다른 입자와의 상호작용이 작아 실험에서 탐지하기 더 어렵지만 기존 우주론의 한계를 극복한 ‘대통일 모델(GUT)’의 근거를 확보할 수 있다.

이런 이유로 IBS 연구단은 ‘DFSZ 액시온’ 탐색에 초점을 맞춰 장비를 개발하고 특정 범위에서 액시온의 존재 여부를 확인하는 데 성공했다. 연구 결과는 12일(현지 시간) 국제학술지 ‘피지컬 리뷰 X’에 공개됐다.

액시온 검출 확률은 자기장이 클수록 높아진다. 연구팀은 초전도체로 지구자기장 세기의 24만 배에 달하는 12테슬라(T)의 자석을 구현했다. 연구팀은 개발한 장비를 활용해 1.025~1.185기가헤르츠(GHz) 주파수 범위에서 질량이 4.24~4.91µeV(마이크로전자볼트)인 액시온을 세계 최고 감도로 탐색하는 데 성공했다. 전자볼트(eV)는 주로 입자물리학에서 사용되는 매우 작은 에너지·질량 단위다. 멈춰 있는 전자의 질량이 약 511킬로전자볼트(keV)로 알려졌다.

정우현 IBS 연구단 연구위원은 “DFSZ 액시온을 탐색할 수 있는 연구팀은 전 세계에서 두 곳뿐”이라며 “1GHz 이상 주파수에서 고감도로 액시온 탐색에 성공한 건 현재까지 IBS 연구팀이 유일하다”고 설명했다.

● 고주파수 영역에서도 최고 수준 성과

연구단은 고주파수 영역에서도 최고 수준의 연구성과를 냈다. KSVZ 이론에 따른 최근 연구들은 액시온의 질량이 20~30µeV, 주파수로는 4.8~7.25GHz 영역에 있을 것으로 예측한다. 연구단은 기존 실험보다 더 높은 고주파에 주목했다.

고주파 신호를 탐색하려면 주파수를 증폭하는 공진기의 부피를 줄여야 한다. 부피가 줄면 데이터를 얻는 데 시간이 오래 걸린다. 연구팀은 원통형 공진기를 피자 조각처럼 나눈 ‘다중방 공진기’를 고안했다. 실험 결과 액시온이 질량 21.86~22.00µeV 범위에서 존재하지 않는다는 사실이 확인됐다. 신뢰도는 90% 수준으로 해당 범위에서는 현재까지 가장 민감도가 높은 결과다. 연구결과는 지난달 31일(현지 시간) ‘피지컬 리뷰 레터스’에 게재됐다.

윤성우 IBS 연구단 연구위원은 “액시온 탐색은 건초더미에서 바늘을 찾는 일과 비슷하다”며 “차세대 액시온 탐색 실험의 방향성을 제시하는 연구”라고 밝혔다.

<참고 자료>
– doi.org/10.1103/PhysRevX.14.031023
– doi.org/10.1103/PhysRevLett.133.051802

Loading

17 8월 2024

[사회과학] [박진영의 사회심리학] ‘나’를 이해하는 사람과의 관계는 ‘나의 일부’가 된다

[사회과학] [박진영의 사회심리학] ‘나’를 이해하는 사람과의 관계는 ‘나의 일부’가 된다

[박진영의 사회심리학] ‘나’를 이해하는 사람과의 관계는 ‘나의 일부’가 된다

입력
게티이미지뱅크 제공

게티이미지뱅크 제공

외로움의 실제 모습은 우리가 상상하는 것과는 꽤 다르다. 예를 들어 친구가 많고 항상 사람들에게 둘러싸여 있는 사람이 외롭지 않을 것 같지만 실제로 관계의 ‘양’은 외로움과 큰 상관이 없다.

이보다는 관계의 ‘질’이 더 중요해서 한 두 명일지라도 내가 믿고 의지할 수 있는 사람이 있는지 또 나를 잘 이해해주는 사람이 있는지 여부에 따라 외로움을 느끼는 정도가 크게 달라진다. 외로움을 ‘사회적 배고픔’이라고 보는 시선에 따르면 적어도 우리가 존재론적인 수준에서 갈구하는 관계란 서로 깊이 ‘이해하는 관계’라는 것이다.

최근 애밀리 오거 캐나다 맥길대 교수의 연구에 따르면 서로 이해하는 관계는 우리의 외로움을 충족하는 것에서 더 나아가 내가 나를 정의할 때 사용하는 요소 ‘나의 일부’가 된다고 한다.

연구자들은 참가자들에게 가상의 연인 제인과 마이크의 이야기를 들려준다. 한 그룹의 사람들에게는 마이크가 제인에게 항상 따뜻하고 상냥한 모습을 보이는 것은 아니지만 제인의 목표들과 깊은 두려움들을 잘 이해하고 있다는 이야기를 해주고 (높은 이해, 낮은 따뜻함), 다른 그룹의 사람들에게는 마이크가 제인의 목표와 두려움들을 잘 이해하지는 못하지만 항상 따뜻하고 상냥한 모습을 보인다는 이야기를 해주었다 (낮은 이해, 높은 따뜻함). 그런 뒤 제인에게 마이크와의 관계가 얼마나 중요한 것 같냐고 물었다.

그 결과 마이크가 항상 따뜻하지는 않아도 제인을 정말 잘 알고 이해하고 있다는 이야기를 들은 그룹의 사람들이 반대로 마이크가 항상 따뜻하지만 제인을 잘 모르고 있다는 이야기를 들은 그룹의 사람들보다 마이크와의 관계가 제인에게 매우 소중하고 중요할 것이라고 평가했다. 물론 친밀한 관계라면 따뜻함과 이해가 모두 있어야겠지만 굳이 하나를 꼽으라고 한다면 이해라는 것이다.

또 다른 연구에서는 실제 연인 및 친구들을 대상으로 연인 또는 친구가 자신을 다른 사람들보다 잘 이해하고 있거나 잘 못 이해하고 있다고 여기게 만들고 해당 관계가 자신이라는 사람을 얼마나 잘 말해주는지에 대해 물었다. 그 결과 친구나 연인이 자기 자신이 진정으로 어떤 사람인지 잘 알고 있다고 여긴 사람들이 그렇지 않은 사람들에 비해 관계를 자신을 정의하는 중요한 요소로 생각하는 경향을 보였다.

생각해보면 영혼의 동반자 같은 친구나 연인의 특징이란 성격이나 자라온 배경이 같다는 것보다도 다른 점이 많지만 대화가 잘 되고 웃음코드가 비슷하다는 사소한 요소들이었던 것 같다. 어쩌면 대화가 잘 되고 코드가 비슷하다는 것이 상호 이해의 전제 조건이어서 그런 것일지도 모르겠다.

지나온 곳은 다르더라도 바라보는 곳이 같고 생각이나 감정은 달라도 대화가 잘 돼서 얼마든지 다른 경험을 함께 공유할 수 있고 내가 재미있어 하는 것을 이 사람도 재미있어 하겠다고 생각할 수 있는 그런 사람들이 나의 이해자인 것은 아닐까.

친밀한 관계를 유지하는 데 무엇보다 이해가 중요하다는 것은 어느 정도 위안이 되기도 한다. 어떤 관계든지 항상 감정적으로 뜨겁고 좋을 수만은 없기 때문이다. 하지만 이해는 좋을 때도 나쁠 때도 상대방을 향해 한 쪽 귀를 열고 있는 한 얼마든지 쌓을 수 있기 때문이다. 결국 모든 관계는 오랜 친구로 수렴한다는 것이 이런 현상을 말하는 것일 수도 있겠다.

어찌되었든 친구이든 연인이든 누군가가 나의 세상을 정의할 수 있고 반대로 내가 타인의 세상을 정의할 수 있다는 것은 멋진 일이다.

Auger, E., Thai, S., Birnie-Porter, C., & Lydon, J. E. (in press). On creating deeper relationship bonds: Felt understanding enhances relationship identification. Personality and Social Psychology Bulletin. Advance online publication. https://doi.org/10.1177/01461672241233419

※필자소개
박진영. 《나, 지금 이대로 괜찮은 사람》, 《나를 사랑하지 않는 나에게》를 썼다. 삶에 도움이 되는 심리학 연구를 알기 쉽고 공감 가도록 풀어낸 책을 통해 독자와 꾸준히 소통하고 있다. 온라인에서 ‘지뇽뇽’이라는 필명으로 활동하고 있다. 현재 미국 듀크대에서 사회심리학 박사 과정을 밟고 있다

Loading

13 8월 2024

[인공지능 기술] AI 기반 물리 정보 신경망을 이용한 시뮬레이션

[인공지능 기술] AI 기반 물리 정보 신경망을 이용한 시뮬레이션

AI 기반 물리 정보 신경망을

이용한 시뮬레이션

AI 기반 물리 정보 신경망을 이용한 시뮬레이션

이번 글에서는 시뮬레이션에서 최근 화두가 되고 있는 물리 정보 신경망(Physics-Informed Neural Network, 이하 PINN)에 대해서 다루어 보겠습니다. 여기서 시뮬레이션이라는 것은 유체역학, 전자기학 등 공학 문제를 슈퍼컴퓨터를 이용한 수학적인 방법으로 푸는 것을 말합니다. 자동차 형상, 휴대폰 열설계, 반도체 소자 시뮬레이션 등이 있습니다.

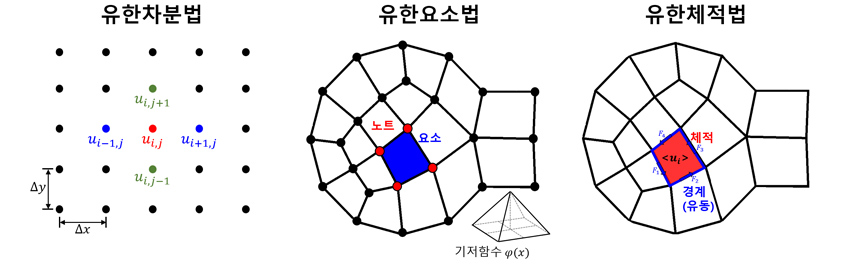
전통적으로 시뮬레이션은 유한차분법(Finite Difference Method), 유한요소법(Finite Element Method), 그리고 유한체적법(Finite Volume Method)이라고 하는 전체 도메인을 작은 요소로 나누어 근사적인 해를 구하는 수치해석적인 방법을 사용하여 시뮬레이션을 하였으며 이 과정에서 엄청난 양의 계산을 위해 슈퍼컴퓨터를 사용하였습니다.

하지만 최근 AI의 발전으로 인해 시뮬레이션 분야에도 AI를 접목시킨 물리 정보 신경망이라는 방법이 연구되기 시작하였습니다. 이 방법은 Inverse 문제와 Ill-posed 문제 등 전통적인 수치해석 기법의 한계를 극복하기 위해 대두되었습니다.

전통적인 수치해석 방법

통상적으로 전통적인 수치해석 방법이라 함은 유한차분법, 유한요소법, 그리고 유한체적법이라고 할 수 있습니다. 이 세 가지 방법은 모두 도메인을 잘게 요소(Element)로 나누어 각 요소에서 수치해석적인 방법을 적용하여 계산합니다. 이렇게 각 요소에서 계산한 값을 모아서 시뮬레이션을 수행합니다.

유한차분법

  • Ui,j+1
  • Ui-1,j / Ui,j / Ui+1,j
  • △y / Ui,j-1
  • △x

유한요소법

  • 노트
  • 요소
  • 기저함수 ∮(x)

유한체적법

  • 체적
  • ⁢Ui >
  • 경계(유동)

[그림 1] 유한차분법, 유한요소법, 유한체적법의 차이

유한차분법의 경우 함숫값의 차이를 이용한 미분계수를 근사하여 편미분 방정식을 푸는 방법입니다. 전방(forward), 후방(backward), 중앙(central) 차분법 등 세 가지로 나눌 수 있으며 테일러 급수 전개를 통해 유도합니다. 직사각격자에 적합하고 알고리즘이 직관적이어서 사용하기 쉽고 병렬계산에 적합하여 학술적인 연구나 간단한 시뮬레이션을 할 경우에 효과적입니다. 선형 문제뿐만 아니라 비선형 문제에도 쉽게 적용 가능하며 특히 유체역학 시뮬레이션에 많이 사용됩니다.

유한요소법의 경우 풀고자 하는 편미분방정식을 적분형으로 표현한 뒤 최종적으로 Ax=b 형태의 선형시스템으로 변환하여 근사해를 구하는 방법입니다. 주로 고체역학이나 전자기학 시뮬레이션 등에 사용되며 GPU 가속 효과가 가장 크고 불규칙한 물체 시뮬레이션에 적합합니다. 유한차분법에 비해 해의 연속성을 유지할 수 있기 때문에 물리적으로 타당한 해를 얻을 가능성이 높습니다.

유한체적법의 경우 보존 법칙을 만족하는 문제를 푸는데 적합하기 때문에 주로 유체역학 시뮬레이션에 사용됩니다. 유한체적의 면을 지나는 유동의 양을 기준으로 유도되며 시뮬레이션 형상에 대해 유연하게 계산을 적용할 수 있습니다. 유한차분법과 마찬가지로 불규칙한 물체를 시뮬레이션하는 데 적합합니다.

물리 정보 신경망의 특징

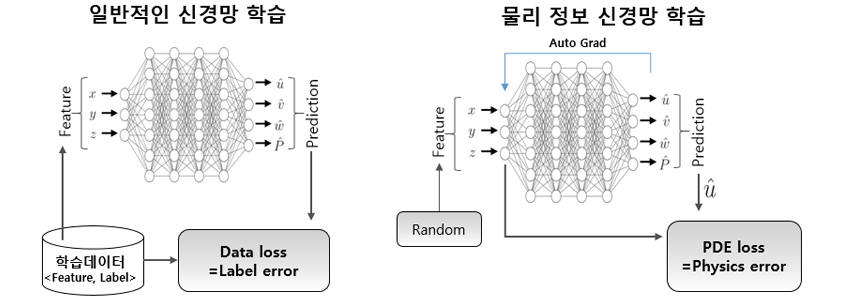
일반적인 신경망이 물리적 법칙을 고려하지 않고 데이터에 전적으로 의존하는 반면, 물리 정보 신경망은 지배방정식(물리방정식)을 만족하도록 식에 내제되어 있는 물리 정보를 신경망에 도입하는 방법입니다.

일반적인 신경망 학습

  • -> Feature
  • x, y, z ->
  • -> u, v, w, p
  • Prediction ->
  • ⁢ – 학습데이터(feature, label) ->
  • Data loss=label error ⁢ –

물리 정보 신경망 학습

  • -> Feature
  • x, y, z ->
  • Auto Grad
  • -> u, v, w, p
  • Prediction -> (u)
  • ⁢ – Random
  • PDE loss=Physics error ⁢ –

[그림 2] 일반적인 신경망과 물리 정보 신경망의 학습 방법

일반적인 신경망은 학습 데이터만을 사용하여 학습하며 손실 함수는 원본 데이터와 학습 모델에서 예측한 데이터에서의 레이블의 불일치 정도를 최소화하도록 학습하는 반면, 물리 정보 신경망은 물리 방정식 자체를 손실 함수에 사용하여 샘플링한 데이터가 물리 법칙을 만족하도록 학습을 진행합니다.

전통적인 시뮬레이션 방법은 도메인을 작은 요소로 나누어 각각에 대해서 계산합니다. 이 과정에서 도메인을 작은 요소로 나누는 Meshing 기법을 사용하지만 물리 정보 신경망을 사용하면 데이터를 단지 샘플링만 하기 때문에 도메인을 작은 요소로 나누는 등 추가적인 계산이 필요 없어지게 되는 장점이 있습니다. 실제 시뮬레이션은 학습(Train)을 진행한 후 추론(Inference)을 통하여 진행하게 됩니다. 이 과정에서 물리적인 법칙을 만족하는 신경망을 찾았기 때문에 물리 법칙을 만족하는 시뮬레이션이 가능하게 됩니다. 학습에 비해 추론하는 시간은 매우 작기 때문에 시뮬레이션하려는 도메인에 대해 한 번 학습을 진행하면 추론을 통한 반복 시뮬레이션을 매우 빠른 시간에 할 수 있다는 장점이 있습니다.

이러한 장점에도 불구하고 현재 물리 정보 신경망은 학습의 수렴성 문제, 전통적인 시뮬레이션 방법에 비하면 아직은 높지 않은 정확도 등의 단점이 존재하여 최근에는 전통적인 시뮬레이션 방법과 물리 정보 신경망을 이용한 방법을 합친 하이브리드 시뮬레이션에 대한 연구가 시작되고 있습니다.

하이브리드 시뮬레이션

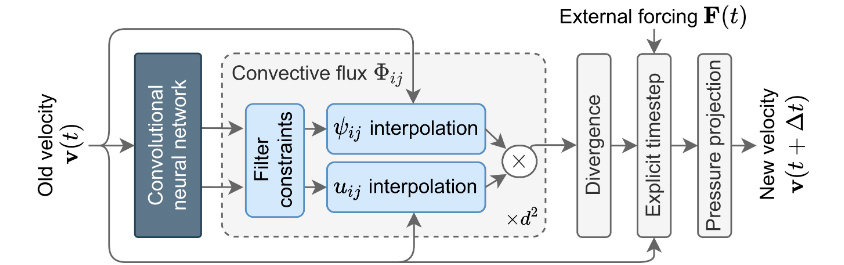
하이브리드 시뮬레이션이란 전통적인 시뮬레이션과 물리 정보 신경망을 이용한 시뮬레이션을 혼합한 방법입니다. 혼합하는 방법에 따라 크게 두 가지 방법이 존재하며 먼저 전통적인 시뮬레이션 방법에 계산시간이 큰 부분을 신경망으로 대체하는 방법에 대해 살펴보겠습니다.

  • old velocity v(t)
  • convolutional neural network ->

convective flux ∮ij / ×d2

  • filter constraints ->uij interpolation / uij interpolation ->
  • x ->

External forcing F(t) ->

  • divergence ->
  • explict timestep ->
  • pressure projection ->
  • New velocity v(t + △t)

[그림 3] 시간이 많이 걸리는 계산을 물리 정보 신경망으로 대체[1]

전통적인 방법이 물리 정보 신경망에 비해 정확도가 높기 때문에 전체적인 프레임워크는 전통적인 수치해석 방법으로 진행하나 시간이 많이 걸리는 계산을 신경망으로 대체하였습니다. 유체해석을 위한 Navier-Stokes 방정식을 푸는 것으로, 단일 Time Step에 대한 흐름도를 보여준 것으로 Convective Flow 계산 시 기존 Standard Numerical Solver를 Convolutional Neural Network을 사용하여 대체하였습니다. 이렇게 하였을 때 전통적인 방법에 비해 상당한 정도의 속도 향상을 이루었다고 합니다.

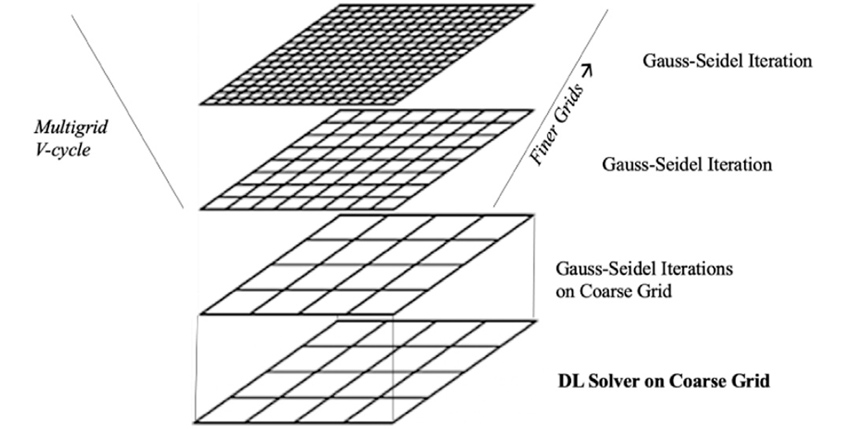
다른 한 가지 방법으로는 물리 정보 신경망의 빠른 시뮬레이션 속도를 이용하여 근사치까지 신경망으로 계산한 후 더 정확한 계산을 위해 전통적인 수치해석 방법을 사용하는 것입니다.

  • Multogrid V-cycle
  • Finer Grids->

DL Solver on Coarse Grid

  • Gauss-Seidel Iteration / Gauss-Seidel Iteration / Gauss-Seidel Iteration on Coarse Grid

[그림 4] 물리 정보 신경망으로 계산 시간을 줄인 후 전통적인 방법으로 정확도를 보정[2]

도메인의 Mesh를 크게 하여 물리 정보 신경망(Deep Learning Solver 사용)으로 시뮬레이션하여 대략적인 값을 얻은 후 더 정확한 계산을 위해 Gauss-Seidel(Standard Solver)을 사용하는 방법으로 전통적인 수치해석 기반 시뮬레이션에 비해 큰 속도 향상을 얻을 수 있습니다.

결론

최근 화두가 되고 있는 AI 기법을 도입한 물리 정보 신경망에 대해 알아보았습니다. AI의 발전에 따라 시뮬레이션 분야에서도 AI가 도입됨은 어찌 보면 당연한 처사입니다. 또한 AI를 구동할 수 있는 GPU와 같은 가속기의 발전에 따라 물리 정보 신경망은 계속해서 발전할 것으로 예상되며 빠른 시뮬레이션 속도로 인한 실시간 시뮬레이션이 가능하기 때문에 Digital Twin 등 응용 분야가 많은 것이 예상됩니다.

References
[1] Machine learning–accelerated computational fluid dynamics, D Kochkova, JA Smitha, A Alieva, Q Wanga, MP Brenner, and S Hoyera, Proceedings of the National Academy of Sciences, 2021
[2] The Old and the New: Can Physics-Informed Deep-Learning Replace Traditional Linear Solvers?, S Markidis, Frontiers in Big Data, 2021

[출처] https://www.samsungsds.com/kr/insights/physics_informed_neural_network.html

문기효
문기효 인공지능/애널리틱스 전문가

삼성SDS 고성능컴퓨팅연구Lab

슈퍼컴퓨터를 이용한 수치해석 분야를 연구하여 박사학위를 취득하였습니다. LLM 추론 및 HPC 시뮬레이션 가속을 연구하고 있으며 양자 컴퓨팅 등 미래 컴퓨팅 기술에 관심이 많습니다.

Loading

12 8월 2024

[알아봅시다] 인터넷 커뮤니티 ‘짤방’, 전력 낭비 주범 될까

[알아봅시다] 인터넷 커뮤니티 ‘짤방’, 전력 낭비 주범 될까

인터넷 커뮤니티 ‘짤방’, 전력 낭비 주범 될까

입력
온라인에서 이뤄지는 다양한 콘텐츠 생성 활동을 표현한 이미지. 게티이미지뱅크

온라인에서 이뤄지는 다양한 콘텐츠 생성 활동을 표현한 이미지. 게티이미지뱅크

디지털 기기에서 한 번 쓰고 다시는 사용하지 않는 ‘정크(쓰레기) 데이터’를 저장하는 데 많은 전력 에너지가 소모되고 있다는 지적이 나왔다. 온라인 커뮤니티 이용이 활발해지면서 개인이 생성하는 사소한 게시글들이 방대한 저장공간을 차지하게 됐다는 것이다.

전문가들은 이같은 정크 데이터를 저장하기 위해 낭비되는 전력이 당장 걱정할 수준은 아니라고 말하면서도 장기적인 탄소 배출 저감을 위해 쓸모없는 데이터는 곧바로 삭제하는 습관을 가질 것을 권고했다.

12일 영국 가디언에 따르면 에너지회사 내셔널그리드는 2030년까지 디지털 데이터를 저장하기 위한 데이터 저장소가 영국 전체 전력소비량의 6%를 차지할 것이란 분석을 최근 내놨다.

기후 위기 전문가들은 앞으로 디지털 데이터 저장소가 기후 위기를 위협하는 요인 중 하나로 주목받을 것이라 전망했다. 더 이상 사용되지 않는 정크 데이터가 기후에 미치는 영향을 조사해온 이안 호지킨슨 영국 러프버러대 교수는 “디지털 데이터는 굉장히 복합한 방식으로 환경에 영향을 미친다”고 말했다.

호지킨슨 교수에 따르면 기업에서 사용되는 데이터의 68%는 다시는 사용되지 않는다. 개인의 데이터 또한 이와 비슷한 수준으로 생성된 이후 다시는 쓰이지 않은 채 잠들어 있는 것으로 추정됐다.

그는 “개인 사용자들이 만드는 이미지, 인스타그램 게시물 등 모든 디지털 데이터를 온라인 상에 보관하기 위해선 에너지가 필요하다”며 “사소한 데이터라도 생성과 보관 과정에서 일정한 탄소가 배출되는 것”이라고 설명했다.

앞선 연구에 따르면 일반적인 업무용 이메일을 1개 발송하는 데는 4g의 탄소가 배출된다. 인터넷 커뮤니티에 글을 올리거나 재밌는 이미지를 저장하기 위해 스마트폰을 전기로 충전하는 행위 등이 모두 탄소 배출로 이어질 수 있다는 것이다. 개인이 생성하는 디지털 데이터 양이 쌓이면 상당한 수준의 에너지 소모 요인이 될 수 있다고 전문가들은 꼬집었다.

호지킨슨 교수는 “하나의 온라인 커뮤니티 게시글이 기후에 급격한 영향을 미치진 않겠지만 이러한 디지털 데이터 생성과 보관 양상은 에너지 소비 측면에서 눈여겨 볼 필요가 있다”고 말했다.

그는 이어 “데이터가 더 많이 저장될수록 저장 시스템을 사용하기 위해 더 많은 비용을 지불해야 한다”며 한번 소비된 후에 아무도 열람하지 않는 휘발성 데이터를 관리할 필요성을 제기했다.

Loading