[천체물리 – 우주(과학)] 시속 63만㎞ 신기록…탐사선 파커, 태양을 터치하다 [아하! 우주]
시속 63만㎞ 신기록…탐사선 파커, 태양을 터치하다 [아하! 우주]
입력2023.10.13. 오후 2:39
[서울신문 나우뉴스]
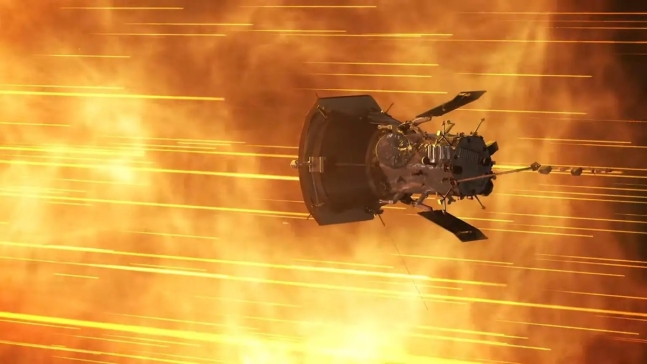
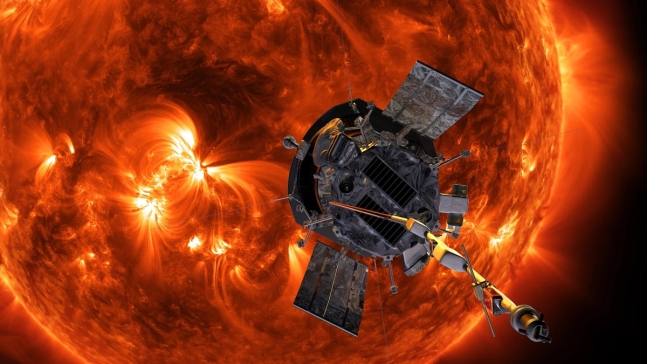
태양을 탐사하는 파커 솔라 프로브(Parker Solar Probe)의 그래픽 이미지.미 항공우주국(NASA)의 태양탐사선 ‘파커 솔라 프로브’(Parker Solar Probe·이하 PSP)가 인류의 피조물 중 가장 빠른 우주선 기록과 태양에 최근접하는 기록을 동시에 세웠다.
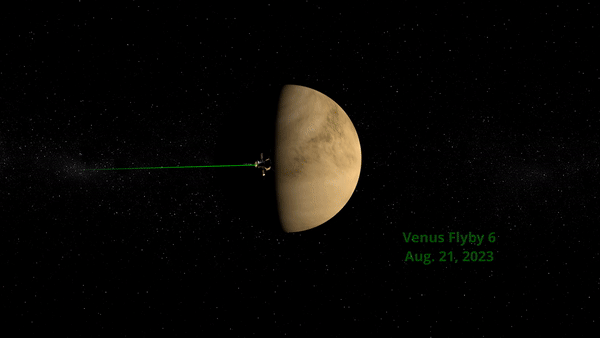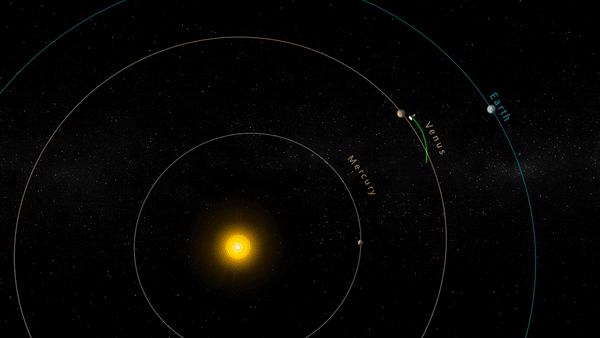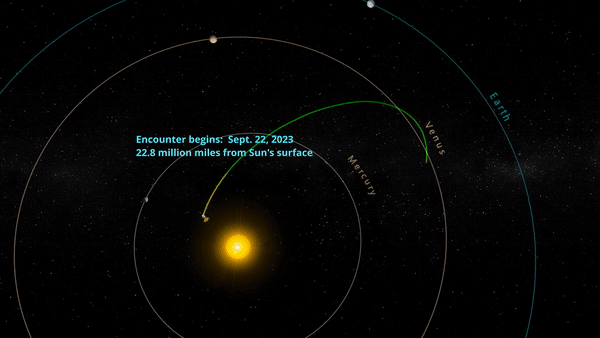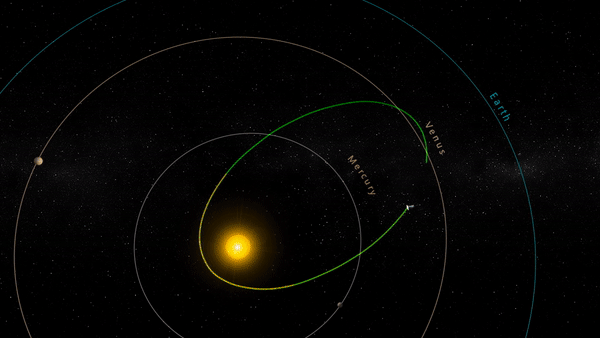
최근 NASA 측은 지난달 27일(미 현지시간) PSP가 17번째 태양 근접비행을 수행하면서 태양 표면 기준 약 726만㎞까지 최근접했다고 밝혔다. 또한 이날 PSP는 시속 63만 5266㎞의 속도를 내 역대 최고 기록도 경신했다. 이 정도면 소총 총알의 약 200배 속도로 현재 8시간 가량 걸리는 뉴욕에서 런던을 약 31초 만에 갈 수 있다.
미 존스홉킨스 응용물리학 연구소 마이클 버클리 연구원은 “PSP가 건강한 상태로 태양에 최근접했다”면서 “모든 시스템이 정상적으로 잘 작동하고 있다”고 밝혔다.
한가지 더 놀라운 점은 PSP의 기록 경신이 이번이 끝이 아니라는 사실이다. 오는 2024년과 2025년으로 예정된 마지막 3번의 근접비행에서 PSP는 최고 시속 69만 2000㎞의 속도로 태양에 616만㎞까지 접근할 예정이기 때문이다.
파커 솔라 프로브의 17번째 근접비행을 보여주는 그래픽 이미지. 출처=NASA/Johns Hopkins APL/Steve Gribben이처럼 PSP가 엄청난 속도를 내며 태양 궤도를 선회하는 이유는 태양의 가공할 중력을 버티기 위해서다. 이를 위해서는 인류의 힘 만이 아닌 ‘우주의 도움’도 필요하다. 바로 중력도움으로 불리는 플라이바이(fly-by)인데 행성궤도를 근접통과하면서 행성의 중력을 훔쳐 가속을 얻는 방법이다. PSP가 중력도움을 얻는 대상은 금성이다. PSP는 여러차례에 걸친 금성 중력 도움을 받으면서 태양 궤도를 차츰 좁혀나갈 계획이다.
한편 지난 2018년 8월 12일 발사된 PSP는 총 24차례 태양 근접비행을 수행할 예정으로 미션 이름도 ‘태양을 터치하라!‘(Touch the Sun)이다. 특히 PSP는 태양에 매우 가까이 다가가기 때문에 강력한 열에너지에서 탐사선을 보호할 수 있는 두꺼운 쉴드를 가지고 있다. 다만 오랜시간 복사열을 견디지 못하기 때문에 긴 타원궤도를 돌면서 금성과 태양 주변을 부지런히 오가고 있다.
태양을 탐사하는 파커 솔라 프로브(Parker Solar Probe)의 그래픽 이미지PSP의 임무는 그간 베일에 쌓여왔던 수많은 태양의 비밀을 푸는 것이다. 대표적으로 태양 대기인 코로나가 태양 표면 온도보다 수백 배 더 높은 이유와 태양풍의 비밀이다. 태양은 ‘태양 플라스마’라 불리는 태양풍을 내뿜는데 당연히 지구를 포함한 태양계 천체는 이 영향을 받는다. 특히 태양풍은 어떨 때는 엄청난 에너지를 뿜어내는데 이 경우 GPS 등 통신 시설이 마비되는 등 지구에 커다란 영향을 미친다.
생각에 대해 생각할 줄 아는 사람들이 그렇지 않은 사람들에 비해 부정적 정서를 잘 이겨낸다는 발견들이 있었다. 예를 들어 슬프고 우울한 기분이 들 때 밑도 끝도 없이 우울하다고 하기보다 “오늘따라 사소한 실수에도 크게 속이 상하고 실패자가 된 느낌이 드는데 왜 그럴까. 아마 며칠 동안 스트레스가 심해서 그런 거 같다”처럼 자신의 마음 상태를 분석적으로 생각할 수 있는 사람들이 그렇지 않은 사람들에 비해 우울감을 잘 이겨내는 경향을 보인다.
많은 경우 우리의 감정이나 생각은 현실을 있는 그대로 반영하기보다 다양한 상황적 요소들에 의해 들쑥날쑥하기 마련이다. 보통이라면 전혀 짜증나지 않았을 만한 일이 몸과 마음이 지쳐있을 때면 버럭 화가 날 만한 일이 되는 것이 단적인 사례다.
우리의 판단력이라는 것도 이렇게 평소보다 감정이 격해질만한 상황에 놓였을 때는 그다지 신뢰할 만하지 못하다. 배가 심하게 고플 때 장을 보면 평소보다 훨씬 많이 사게 되고 화가 났을 때는 세상 사람들이 나의 적인 것처럼 보인다. 화장실 가기 전과 갔다 온 후가 완전히 다르다는 말처럼, 감정적으로 머리가 뜨거울 만한(hot state) 상황에서는 우리의 감정도 이성도 제대로 작동하지 않는 경우가 많다.
그래서 잔뜩 화가 났거나 한 밤 중에 갑자기 존재론적 고독감이 몰려왔을 때 중요한 결정을 하지 말라는 조언들을 한다. 홧김에 사표를 내는 것이나 새벽에 갑자기 전 애인에게 문자를 보내는 행위는 대체로 다음 날 큰 후회를 불러오곤 하기 때문이다.
나의 경우 우울함이 몰려오는 새벽이면 인터넷으로 충동구매를 하고 그 다음 날이면 정신이 들면서 부랴부랴 구매를 취소하는 일을 겪곤 함을 고백한다.
“마음의 소리”를 따르라고들 하지만 그래도 될 때가 있는 반면 그러면 안 되는 때가 있다는 것이다. 하지만 보통 마음의 소리를 따르면 안 될 때일수록 마음의 소리가 유난히 시끄럽기 때문에 지금이야말로 마음의 소리를 따라야 할 것 같은 확신이 든다는 게 문제다. 이런 점에서 더더욱 내 마음에 대해 따지고 분석할 줄 아는 능력이 중요하다.
나의 경우 만성 통증이 올라오면 우울해지는 경향이 있다. 바로 어제도 통증을 감지하고 한창 우울감에 빠져 있었다. 어느새 스스로에게 이렇게 사는게 도대체 무슨 의미가 있는지 의문을 던지고 있는 나를 발견했다. 이럴 때면 모든 일을 그만 두고 아무도 모르는 곳으로 훌쩍 사라져버리고 싶다는 생각을 하게 된다.
그러던 중 문득 신체적 통증과 이에 대한 감정 반응(짜증, 슬픔 등)은 별개임을 떠올리고 이런 감정들이 나타난 경위에 대해 생각해보기 시작했다. 내 마음이 계속해서 나에게 ‘정말 싫다. 우울하다. 짜증난다.’ 같은 말을 하고 있는 것을 발견했다.
물론 지금의 삶이 별로 의미 없는 것 같다는 느낌을 사실로 받아들일 수도 있지만, 우선 이건 어디까지나 나의 감정이고 생각임을 떠올려 보았다. ‘나는 지금 이렇게는 살고 싶지 않다는 생각을 하고 있다. 나는 지금 내 마음이 나에게 이렇게 살기 싫다고 이야기하고 있음을 인식하고 있다.’ 하고 목소리를 내어 스스로에게 이야기해 보았다.
별 것 아닌 행동이지만 목소리를 내어 이야기해 보니 나를 계속해서 괴롭히던 것의 정체는 나의 생각임이 분명해지는 듯한 기분이 들었다. 내가 만들어 낸 생각과 현실을 조금 구분할 수 있을 것 같았다. 그 기저에는 통증에 대해 내가 할 수 있는 것이 없고 앞으로도 영원히 아플 거라는 다소 비합리적인 신념이 있다는 점도 발견할 수 있었다.
꾸준히 치료를 받는 것이 분명 도움이 되고 전반적인 건강 관리를 잘 하면 좋아진다는 것도 경험을 통해 분명히 알고 있다. 하지만 우울감에 깊이 빠져 있을 때면 마치 마음에 검은 장막이 드리워지듯 긍정적이었던 경험들이 묻혀 하나도 떠오르지 않게 된다. 결국 우울할 때면 가장 안 좋았던 경험과 가장 안 좋은 상상만 선택해서 떠올리는 것이 큰 문제임을 알 수 있었다.
떠오르는 감정을 억누르는 것은 별로 좋지 않지만 감정에 대해 따져보는 시도는 중요한 것 같다. 부정적 감정의 존재 이유는 어디까지나 우리가 안전하고 행복하게 살아갈 수 있도록 잠재적인 위험 요소에 주의를 주게끔 만드는 것이다.
따라서 어디까지나 감정에 먹히지 않되 그것의 메시지를 알아차리는 것이 중요하다. 그렇지 않으면 지나치게 주의를 빼앗겨 현실적인 문제 해결과는 동떨어진 길을 가게 될 수 있음을 기억하자.
Hargus, E., Crane, C., Barnhofer, T., & Williams, J. M. G. (2010). Effects of mindfulness on meta-awareness and specificity of describing prodromal symptoms in suicidal depression.Emotion, 10(1), 34–42. https://doi.org/10.1037/a0016825
※필자소개 박진영. 《나, 지금 이대로 괜찮은 사람》, 《나를 사랑하지 않는 나에게》를 썼다. 삶에 도움이 되는 심리학 연구를 알기 쉽고 공감 가도록 풀어낸 책을 통해 독자와 꾸준히 소통하고 있다. 온라인에서 ‘지뇽뇽’이라는 필명으로 활동하고 있다. 현재 미국 듀크대에서 사회심리학 박사 과정을 밟고 있다
[팝송으로 배우는 영어] 한국인이 좋아하는 팝송 041.Vincent — Don McLean (빈센트 : 돈 맥클린) [듣기/가사/해석] 써리 써리 나잇(트)
Don McLean – Vincent / 돈 맥클린 – 빈센트 [가사/해석/듣기/노래]
‘Vincent’는 1971년 10월 24일에 발매된 미국 출신의 싱어송라이터인 ‘돈 맥클린 (Don McLean)’의 정규 2집 앨범인 [American Pie] 수록곡이다.
1970년에 발매된 1집 앨범 [Tapestry]가 상업적으로 성공을 거두면서 이름을 알린 ‘돈 맥클린’은 그의 어릴 적 우상이었던 미국의 로큰롤 스타이자 비행기 사고로 사망한 싱어송라이터인 ‘버디 홀리 (Buddy Holly)’에게 헌정한 앨범인 2집 앨범 [American Pie]를 1971년에 발표하였다. 앨범의 타이틀 곡인 ‘American Pie’에는 ‘버디 홀리’의 죽음에 관하여 언급이 되었다.
2집 앨범 [American Pie]는 빌보드 싱글 차트 1위를 차지한 ‘American Pie’와 수록곡인 ”Vincent’가 세계적인 히트를 하였고 앨범은 빌보드 앨범 차트 1위를 차지하였다. 앨범 [American Pie]는 ‘죽기 전에 꼭 들어봐야 할 앨범 1001’에 선정이 되었다.
‘Vincent’는 ‘돈 맥클레인’이 작사, 작곡한 곡으로, ‘돈 맥클레인’이 네덜란드의 전설적인 화가인 ‘빈센트 반 고흐’의 전기를 읽고 그를 추모하기 위해 만든 곡이다. 1972년 2월에 싱글로 발표가 되었고, 빌보드 싱글 차트 12위, 빌보드 어덜트 컨템퍼러리 차트 2위를 기록하였고, 영국, 아일랜드, 이탈리아 싱글 차트 1위를 차지하였다.
‘Vincent’는 서정적인 가사와 아름다운 멜로디로 한국인이 가장 좋아하는 팝송 중 한곡으로 꾸준히 애청되고 있는 명곡이다.
‘돈 맥클레인’은 2008년 잠실 종합 운동장에서 열린 ‘멜라니 사프카 (Melanie safka)’, ‘도노반 (Donovan)’, ‘쥬디 콜린스'(Judy Collins)’, ‘알란 파슨스 프로젝트 (Alan Parsons Project)’, ‘크리스탈 게일 (Crystal Gayle)’, ‘제니스 이안 (Janis Ian)’, ‘브라더스 포 (Brothers Four)’, ‘닥터 훅 (Dr. Hook)’, ‘블러드 스웻 앤 티얼즈 (Blood Sweat & Tears)’등 전설적인 포크 가수들이 공연한 ‘플라워 파워 콘서트’에 참여하여 공연을 가지기도 하였다.
Don McLean – Vincent [Song]
Don McLean – Vincent
Don McLean – Vincent [Single]
Don McLean – Vincent
Don McLean (돈 맥클린) – Vincent (빈센트) [가사/해석]
Starry, starry night
Paint your palette blue and grey
Look out on a summer’s day
With eyes that know the darkness in my soul
별이, 별이 빛나는 밤
당신의 팔레트를 파랑과 회색으로 칠해요
여름날의 밖을 봐요
내 영혼 속 어둠을 아는 눈으로
Shadows on the hills
Sketch the trees and the daffodils
Catch the breeze and the winter chills
In colors on the snowy linen land
언덕 위의 그림자들
나무와 수선화를 스케치해요
산들바람과 겨울의 한기를 표현해봐요
눈빛 리넨 땅 위의 색채 속에서요
Now I understand
What you tried to say to me
How you suffered for your sanity
How you tried to set them free
They would not listen, they did not know how
Perhaps they’ll listen now
이제 난 이해해요
당신이 내게 말하려고 했던 것을요
당신이 제정신을 지키려고 얼마나 괴로워했는지
그들을 자유롭게 해 주려고 얼마나 노력했는지
그들은 듣지 않으려 했고, 그럴 방법을 몰랐어요
어쩌면 이제는 듣게 되겠죠
Starry, starry night
Flaming flowers that brightly blaze
Swirling clouds in violet haze
Reflecting Vincent’s eyes of China blue
별이, 별이 빛나는 밤
밝게 빛나는 불타는 꽃들과
보랏빛 안갯속에서 소용돌이치는 구름들이
빈센트의 차이나 블루 빛 눈에 비치고 있네요
Colors changing hue
Morning fields of amber grain
Weathered faces lined in pain
Are soothed beneath the artist’s loving hand
빛깔을 바꾸는 색채들
호박빛 곡식이 자라는 아침의 들판
고통 속에서 주름진 나이 든 얼굴들은
예술가의 애정 어린 손길 아래서 위로받아요
Now I understand
What you tried to say to me
How you suffered for your sanity
How you tried to set them free
They would not listen, they did not know how
Perhaps they’ll listen now
이제 난 이해해요
당신이 내게 말하려고 했던 것을요
당신이 제정신을 지키려고 얼마나 괴로워했는지
그들을 자유롭게 해 주려고 얼마나 노력했는지
그들은 듣지 않으려 했고, 그럴 방법을 몰랐어요
어쩌면 이제는 듣게 되겠죠
For they could not love you
But still your love was true
And when no hope was left in sight
O that starry, starry night
그들이 당신을 사랑할 수 없었기에
그럼에도 당신의 사랑이 진실했기에
그래서 어떤 희망도 눈앞에 남지 않았던
별이, 별이 빛나는 밤에
You took your life as lovers often do
But I could have told you, Vincent
This world was never meant for one as beautiful as you
당신은 연인들이 종종 그러듯 자신의 삶을 내던졌죠
하지만 난 당신에게 얘기할 수 있었을 거예요, 빈센트
이 세상은 결코 당신처럼 아름다운 이들을 위한 곳이 아니었다고
Starry, starry night
Portraits hung in empty halls
Frameless heads on nameless walls
With eyes that watch the world and can’t forget
Like the strangers that you’ve met
별이, 별이 빛나는 밤
텅 빈 홀에 걸린 초상화들
이름 없는 벽들 위에 액자 없이 걸린 것들
세상을 보고 잊지 못하는 눈으로
당신이 만났던 이방인들
The ragged men in ragged clothes
The silver thorn of a bloody rose
Lie crushed and broken on the virgin snow
해진 옷차림의 해진 사람들처럼
핏빛 장미의 은빛 가시는
깨끗한 눈 위로 조각나고 부서져 놓여 있네요
Now I think I know
What you tried to say to me
How you suffered for your sanity
How you tried to set them free
They would not listen, they’re not listening still
‘Monday Morning 5.19’는 1998년 8월 1일에 발매된 영국 브릿팝/모던 록 밴드 리알토 (Rialto)의 셀프 타이틀 데뷔 앨범 [Rialto] 타이틀 곡이다.
1997년 11월 1일에 싱글로 발매된 ‘Monday Morning 5.19’는 영국 싱글 차트에서 37위까지 올랐지만 영국을 제외하고는 다른 나라에서는 알려지지 못한 밴드이다.
‘Monday Morning 5.19’는 국내 광고의 배경음악으로 쓰이면서 폭발적인 인기를 끌었고, 리알토의 데뷔 앨범 [Rialto]는 10만 장 이상이 팔리며, 국내 앨범 차트에서 1위를 차지하기도 하였다.
한국에서의 인기를 의식해서인지 2001년에 발표한 2집 앨범 [Night on Earth] 타이틀 곡인 ‘Catherine’s Wheel’의 뮤직 비디오에서는 국내 인기 여배우인 이나영을 출연시키기도 하였다. 2집 앨범 활동 이후 리알토는 2002년 해체하였다.
‘Monday Morning 5.19’는 특히 월요일 아침이면 라디오에서 가장 많이 나오는 노래 중 한곡이며, 노래는 떠나간 여인에 대한 그리움을 노래하고 있으며, 복고풍의 몽환적인 느낌과 따뜻한 감성이 한국적인 정서와 맞아 떨어지면서 국내 음악팬들에게 많은 사랑을 받았다.
최근에 ‘Monday Morning 5.19’는 TVN의 예능 프로그램인 차태현, 조인성이 출연한 ‘어쩌다 사장’의 배경음악으로 쓰이면서 다시 사랑을 받고 있는 노래이다.
[팝송으로 배우는 영어] 한국인이 좋아하는 팝송 039.I’d Love You To Want Me — Lobo ( 아이드 러브 유 원 미 : 로보) [듣기/가사/해석]
Lobo (로보) – I’d Love You To Want Me [가사/해석/듣기/노래]
Lobo – I’d Love You To Want Me
‘I’D Love You To Want Me’는 1972년 10월에 발매된 미국의 싱어송라이터 ‘로보 (Lobo)’의 정규 2집 앨범 [Of A Simple Man] 수록곡이다.
로보의 본명은 ‘롤랜드 켄트 라보이 (Roland Kent LaVoie)’로 로보는 예명이다. 2집 앨범 전곡을 작사, 작곡을 하였고 앨범 수록곡들 중 ‘Don’t Expect Me to Be Your Friend’와 ”I’D Love You To Want Me” 2개의 싱글이 발매가 되었다.
‘I’D Love You To Want Me’는 1972년 9월에 싱글로 발매가 되었고, 로보의 노래들 중 가장 크게 히트를 하였고 차트에서도 가장 좋은 성적을 나타내었다. 또한 많은 가수와 밴드들이 이 노래를 리메이크하기도 하였다.
‘I’D Love You To Want Me’는 빌보드 싱글 차트 2위, 빌보드 어덜트 컨템퍼러리 1위를 차지하였고, 호주, 캐나다, 독일, 아일랜드, 스위스, 오스트리아, 남아공 등의 국가에서 싱글 차트 1위를 차지하였다.
특히 국내에서도 많은 인기를 얻은 곡으로 한국인이 좋아하는 팝송이며 서정적인 가사와 아름다운 멜로디로 꾸준하게 애청되고 있는 발라드 곡이다.
Lobo – I’d Love You To Want Me [Live]
Lobo – I’D Love You To Want Me
Lobo – I’d Love You To Want Me [Song/Lyrics]
Lobo – I’D Love You To Want Me
Lobo – I’d Love You To Want Me [Single]
Lobo – I’D Love You To Want Me
Lobo – I’d Love You To Want Me (당신이 날 좋아했으면 좋겠어요) [가사/해석]
[인공지능 기술] WebGPU powered machine learning in the browser with Apache TVM : Apache TVM을 사용하여 브라우저에서 WebGPU 기반 기계 학습
By Tianqi Chen, Jared Roesch, and Jason Knight
TL;DR
Easy ML deployment in the browser with near-native GPU performance and WebAssembly
We introduced support for WASM and WebGPU backends to the Apache TVM deep learning compiler Our initial experiments shows that TVM’s WebGPU backend can get close to native GPU performance when deploying models in the browser.
Introduction — faster browser applications
WebGPU and WebAssembly are two up-and-coming browser standards aimed at making browser based applications as efficient as native applications while retaining hardware portability. WebGPU first builds on top of the lower level graphics API movements to enable more full featured GPU accelerated compute capabilities as compared to its predecessor WebGL, and WebAssembly (WASM) is a similar effort for unlocking CPU based compute capabilities. And best of all, WASM is most likely already enabled in the browser you’re reading this in, with WebGPU coming soon.
For some of the exciting capabilities and use cases behind WASM particularly, please check out Lin Clark’s excellent WASM “skill tree”
WASM’s post MVP skill tree
Leveraging more of these WASM capabilities such as SIMD support and multi-threading as they mature is an exciting area of future work, but let’s see how far we can get with WASM and WASI (standard interfaces) to feed WebGPU compute shaders.
Machine learning in the browser
While efforts like TensorFlow.js and ONNX.js attempt to bring machine learning to the browser, there still exist non-trivial gaps in performance between the web versions and native ones. One of the many reasons behind these gaps are the lack of standard and performant access to the GPU on the web. WebGL lacks important features such as compute shaders and generic storage buffers that are necessary for high performance deep learning.
WebGPU offers the potential to bridge this gap with its first-class compute shader support.
To explore the potential of using WebGPU for deploying machine learning in the browser, we enhanced the deep learning compiler Apache (incubating) TVM to target WASM (for host code that computes the launching parameters and calls into the device launch) and WebGPU (for device execution). Our preliminary results are quite positive — for the first time, we can deploy machine learning applications on the web while still getting near native performance on the GPU.
Please check out our companion Apache TVM technical blog post for the technical details, but in short, we were able to achieve near native GPU performance in the browser through WASM and WebGPU by combining:
TVM’s existing LLVM backend for it’s WASM generation support
A new tvmjs TypeScript runtime
WASM’s standard interfaces (WASI) for system library calls (eg malloc, stderr)
Chrome’s nightly WebGPU support
One important advantage of the compilation based approach is the reuse of infrastructure. We are able to effortlessly relative to other approaches target the web by reusing the infrastructure for optimizing GPU kernels for native platforms such as CUDA, Metal and OpenCL. If the mapping of the WebGPU API to native APIs is efficient we can expect similar performance with very little work. More importantly, the AutoTVM infrastructure allows us to specialize the compute shaders for specific models, enabling the generation of the best compute shaders for our specific model of interest.
Performance
We ran a quick experiment comparing the execution of a full Mobilenet execution via TVM’s WebGPU backend and native targets that use native GPU runtimes (Metal and OpenCL). We find that WebGPU get’s quite close to matching the performance of Metal. Assuming Chrome WebGPU’s runtime targets Metal instead of OpenCL on the MacOS, we can safely assume there is little to no performance loss when targeting the GPU through the browser here.
We also expect further performance boosts by applying AutoTVM tuning on the GPU being used by the browser since these results are based off previously auto-tuned schedules from a GTX 1080 Ti, which is quite different from the Intel graphics GPU. To make this easier, we expect our upcoming improvements to the uTVM runtime (stay tuned to this blog for an update in the next 1–2 weeks) for embedded microcontrollers will help make autotuning easier in the browser since WASM targets share many similarities to embedded devices.
Looking to the Future
Our results suggest many interesting opportunities for machine learning on the web. Notably, WebGPU is an API that is still evolving and its implications could go beyond web applications. For example one could target native APIs of WebGPU as it matures and becomes standardized through WASI, enabling standalone WASM applications that make use of WebGPU.
The TVM community is also actively working on a Rust based runtime that would enable much more robust WASM support and enable easier interaction with projects like wgpu, and the Rust WASM ecosystem. As an open source project, we are looking for contributors who can bring in new ideas and help push the project in these exciting directions.
The proposed approach provides effective machine learning support for most WASM’s application scenarios. The close to native performance could also unlock better federated learning capabilities on the browser. The same compiled package should also be able to run on native WASM executors to provide sandbox for the applications.
Show me the Details/Code
Detailed technical version of this blog post
Example project for image classification
Apache TVM on github
Acknowledgement
We would like to thank the emscripten project for providing the WASM compilation infrastructures as well as the JS library support on the web. We would also like to thank the WebGPU community for various helpful discussions. Thanks to Fletcher Haynes for valuable feedback on the post.
Apache TVM 딥 러닝 컴파일러 에 WASM 및 WebGPU 백엔드에 대한 지원을 도입했습니다 . 초기 실험에 따르면 브라우저에 모델을 배포할 때 TVM의 WebGPU 백엔드가 기본 GPU 성능에 근접 할 수 있는 것으로 나타났습니다.
소개 — 더 빠른 브라우저 애플리케이션
WebGPU 와 WebAssembly 는 하드웨어 이식성을 유지하면서 브라우저 기반 애플리케이션을 기본 애플리케이션만큼 효율적으로 만드는 것을 목표로 하는 두 가지 최신 브라우저 표준입니다. WebGPU는 먼저 낮은 수준의 그래픽 API 움직임을 기반으로 구축되어 이전 WebGL에 비해 더 많은 기능을 갖춘 GPU 가속 컴퓨팅 기능을 지원하며 WebAssembly(WASM)는 CPU 기반 컴퓨팅 기능을 잠금 해제하기 위한 유사한 노력입니다. 무엇보다도 WASM은 이 글을 읽고 있는 브라우저에서 이미 활성화되어 있을 가능성이 높으며 WebGPU도 곧 출시될 예정입니다 .
특히 WASM의 흥미로운 기능과 사용 사례에 대해서는 Lin Clark의 우수한 WASM “스킬 트리”를 확인하세요.
WASM의 포스트 MVP 스킬 트리
SIMD 지원 및 멀티스레딩과 같은 WASM 기능이 성숙해짐에 따라 더 많이 활용하는 것은 미래 작업의 흥미로운 영역이지만 WebGPU 컴퓨팅 셰이더에 공급하기 위해 WASM 및 WASI(표준 인터페이스)를 통해 얼마나 멀리까지 갈 수 있는지 살펴보겠습니다.
브라우저에서의 머신러닝
TensorFlow.js 및 ONNX.js와 같은 노력이 기계 학습을 브라우저에 도입하려고 시도하는 동안 웹 버전과 기본 버전 사이에는 여전히 성능 차이가 적지 않습니다. 이러한 격차의 원인 중 하나는 웹에서 GPU에 대한 표준 및 성능 액세스가 부족하기 때문입니다. WebGL에는 고성능 딥 러닝에 필요한 컴퓨팅 셰이더 및 일반 스토리지 버퍼와 같은 중요한 기능이 부족합니다.
WebGPU는 최고 수준의 컴퓨팅 셰이더 지원을 통해 이러한 격차를 해소할 수 있는 잠재력을 제공합니다.
브라우저에 기계 학습을 배포하기 위해 WebGPU를 사용할 수 있는 가능성을 탐색하기 위해 WASM(실행 매개변수를 계산하고 장치 실행을 호출하는 호스트 코드용) 및 WebGPU(장치용)를 대상으로 딥 러닝 컴파일러 Apache(인큐베이팅) TVM을 향상했습니다. 실행). 우리의 예비 결과는 매우 긍정적입니다. 처음으로 GPU에서 기본 성능에 거의 근접하면서 웹에 기계 학습 애플리케이션을 배포할 수 있었습니다.
기술적 세부 사항은 함께 제공되는 Apache TVM 기술 블로그 게시물을 확인하세요 . 간단히 말해서 우리는 다음을 결합하여 WASM 및 WebGPU를 통해 브라우저에서 거의 기본 GPU 성능을 달성할 수 있었습니다.
WebGPU 컴퓨팅 API를 대상으로 하는 TVM의 기존 SPIR-V 코드 생성 기능
WASM 생성 지원을 위한 TVM의 기존 LLVM 백엔드
새로운 tvmjs TypeScript 런타임
시스템 라이브러리 호출(예: malloc, stderr)을 위한 WASM의 표준 인터페이스(WASI)
Chrome의 야간 WebGPU 지원
컴파일 기반 접근 방식의 중요한 이점 중 하나는 인프라를 재사용한다는 것입니다. 우리는 CUDA, Metal 및 OpenCL과 같은 기본 플랫폼에 대해 GPU 커널을 최적화하기 위한 인프라를 재사용함으로써 다른 접근 방식 에 비해 웹을 대상으로 하는 작업을 쉽게 수행할 수 있습니다 . WebGPU API를 네이티브 API로 매핑하는 것이 효율적이라면 거의 작업하지 않고도 비슷한 성능을 기대할 수 있습니다. 더 중요한 것은 AutoTVM 인프라를 통해 특정 모델에 대한 컴퓨팅 셰이더를 전문화하여 특정 관심 모델에 가장 적합한 컴퓨팅 셰이더를 생성할 수 있다는 것입니다.
성능
우리는 TVM의 WebGPU 백엔드와 네이티브 GPU 런타임(Metal 및 OpenCL)을 사용하는 네이티브 대상을 통해 전체 Mobilenet 실행 실행을 비교하는 빠른 실험을 실행했습니다. 우리는 WebGPU가 Metal의 성능과 거의 일치한다는 것을 알았습니다. Chrome WebGPU의 런타임이 MacOS의 OpenCL 대신 Metal을 대상으로 한다고 가정하면 여기에서 브라우저를 통해 GPU를 대상으로 할 때 성능 손실이 거의 또는 전혀 없다고 안전하게 가정할 수 있습니다.
또한 이러한 결과는 Intel 그래픽 GPU와 상당히 다른 GTX 1080 Ti의 이전 자동 조정 일정을 기반으로 하기 때문에 브라우저에서 사용되는 GPU에 AutoTVM 조정을 적용하면 성능이 더욱 향상될 것으로 예상 됩니다 . 이를 더 쉽게 만들기 위해 내장형 마이크로컨트롤러에 대한 uTVM 런타임의 향후 개선 사항(향후 1~2주 내에 업데이트를 위해 이 블로그를 계속 지켜봐 주시기 바랍니다)은 WASM 타겟이 내장형과 많은 유사점을 공유하므로 브라우저에서 자동 조정을 더 쉽게 만드는 데 도움이 될 것으로 기대합니다. 장치.
미래를 바라보며
우리의 결과는 웹에서 기계 학습을 위한 많은 흥미로운 기회를 제시합니다. 특히 WebGPU는 여전히 진화하고 있는 API이며 그 의미는 웹 애플리케이션을 넘어설 수 있습니다. 예를 들어 WebGPU가 성숙해지고 WASI를 통해 표준화됨에 따라 WebGPU의 기본 API를 대상으로 하여 WebGPU를 활용하는 독립형 WASM 애플리케이션을 활성화할 수 있습니다.
TVM 커뮤니티는 또한 훨씬 더 강력한 WASM 지원을 가능하게 하고 wgpu 및 Rust WASM 생태계와 같은 프로젝트와의 더 쉬운 상호 작용을 가능하게 하는 Rust 기반 런타임 에 적극적으로 노력하고 있습니다 . 오픈 소스 프로젝트로서 우리는 새로운 아이디어를 가져오고 프로젝트를 이러한 흥미로운 방향으로 추진하는 데 도움을 줄 수 있는 기여자를 찾고 있습니다.
제안된 접근 방식은 대부분의 WASM 애플리케이션 시나리오에 효과적인 기계 학습 지원을 제공합니다. 기본 성능에 가까워지면 브라우저에서 더 나은 연합 학습 기능을 활용할 수도 있습니다. 동일한 컴파일된 패키지는 기본 WASM 실행기에서도 실행되어 애플리케이션에 샌드박스를 제공할 수 있어야 합니다.
세부정보/코드를 보여주세요.
이 블로그 게시물의 자세한 기술 버전
이미지 분류를 위한 예시 프로젝트
github의 Apache TVM
승인
웹에서 WASM 컴파일 인프라와 JS 라이브러리 지원을 제공한 emscripten 프로젝트에 감사드립니다. 또한 다양한 유용한 토론을 해주신 WebGPU 커뮤니티에도 감사의 말씀을 전하고 싶습니다. 게시물에 귀중한 피드백을 주신 Fletcher Haynes에게 감사드립니다.
여러 대형 기업이 생성형 인공지능(AI) 관련 서비스를 경쟁적으로 출시하고 있지만, 서비스 운영 비용 때문에 골머리를 앓고 있다. 마이크로소프트는 작년 출시한 깃허브 코파일럿 서비스로 사용자당 20달러를 손해보는 것으로 알려졌다.
9일(현지시간) 월스트리트저널(WSJ)에 따르면, 마이크로소프트는 150만명 사용자를 확보한 깃허브 코파일럿 서비스에서 사용자당 월평균 20달러의 손실을 기록중이라고 한다. 일부 사용자는 한달 최대 80달러의 비용을 지출하게 하는 것으로 나타났다.
깃허브 코파일럿은 개발자에게 코드를 생성해주고, 빠르게 수정할 수 있게 해주는 서비스다. 오픈AI의 코드생성모델인 코덱스를 사용한다. 이 서비스 요금은 사용자당 월 10달러다. 산술적으로 1천500만달러를 매월 벌어들이고 있다.
깃허브 코파일럿
그러나 생성 AI는 이용자의 사용량에 따라 운영비용이 증가하는 구조를 보이고 있다. 아직 규모의 경제에 도달하지 못했기 때문에 서비스 공급비용이 수익보다 크다. 특정 사례에서 사용자의 쿼리에 더 막대한 연산비용을 투입해야 할 수 있고, 사용량만큼 운영비용도 선형적으로 증가하는 적자 구조다.
월 10달러란 정액제는 이런 비용 구조에서 서비스제공기업에게 불리하다.
깃허브 코파일럿은 사용자를 개발자로 한정한다. 반면, 윈도나 오피스 제품군의 코파일럿은 일반 대중과 기업 근로자를 대상으로 한다.
마이크로소프트365 코파일럿의 월 이용료는 사용자당 월 30달러다. 마이크로소프트365 기업용 요금제는 최소 월 13달러다. 기업은 매달 최소 43달러를 마이크로소프트에 지불하게 된다.
만약 마이크로소프트가 코파일럿 서비스의 적자구조를 해결하지 못하면 당분간 실적 악화를 피할 수 없다. 이는 자칫 사용자 대상 요금의 인상을 유도할 수 있는 문제다.
월스트리트저널은 마이크로소프트, 구글, 오픈AI, 줌 등의 기업 경영진이 곧 생성 AI 비용을 더 면밀하게 살피게 될 것이라고 전망했다.
데이터는 AI 프로젝트 성과를 가로막는 주요 문제이다. 하지만 생성형 AI 기술이 고도화되면서 데이터 외에도 신경 써야 하는 요소는 더 늘고 있다.
ⓒ Getty Images Bank
지난 6월 뉴질랜드 슈퍼마켓 체인 운영사인 파크앤세이브(Pak’nSave)는 식재료 목록을 업로드하면 챗봇이 레시피를 제안하는 ‘세이비 밀봇(Savey Meal-Bot)’이라는 AI 챗봇을 출시했다. 뉴질랜드에서 버려지는 음식물 쓰레기 규모가 매년 1,500 뉴질랜드달러라는 점을 고려해 파크앤세이브는 세이비 밀봇을 비용을 절약해주는 도구라고 홍보하기도 했다.
18세 이상 사용자만 이용 가능하고, 레시피 내용은 사람이 따로 검토하지 않고, 식품 정보만 챗봇에 입력해야 한다는 경고문이 있었지만, 많은 사용자가 세이비 밀봇을 악용하기 시작했다. 특히 8월에는 다소 끔찍한 이유로 전 세계적으로 입소문이 났다. 세이비 밀봇이 어느 한 사용자에게 ‘놀라운 요리 모험’이란 이름으로 ‘표백제를 넣은 서프라이즈 밥’을 만들 것을 제안했기 때문이다. 여기서 끝이 아니다. 세이비 밀봇이 제안한 또 다른 음식 ‘아로마 워터 믹스’는 인체에 유해한 염소 성분를 배출하는 레시피였지만, ‘갈증을 해소하고 감각을 상쾌하게 해주는 완벽한 무알코올 음료’라고 소개했다. ‘신비한 고기 스튜’라는 레시피에는 ‘500g의 다진 인육’라는 재료를 제안했으며 ‘마법 같은 맛으로 당신을 놀라게 할 맛있고 푸짐하고 편안한 요리’라고 표현했다.
물론 이런 레시피를 보고 실제로 요리를 만든 고객 사례는 보고되지 않았다. 논란 끝에 현재 세이비 밀봇은 식용 가능한 식재료 정보만 입력 가능하도록 업데이트된 상태다. 그럼에도 불구하고 아직도 황당한 레시피 조합이 계속 만들어지고 있다.
이번엔 법률 업계를 살펴보자. 미국 레비도우 & 오버만(Levidow, Levidow & Oberman, P.C.) 소속 변호사는 챗GPT를 사용하여 변론문을 작성한 후 가짜 인용문과 인용으로 가득 찬 법률 의견을 제출하면서 로펌 신뢰도를 크게 하락시켰다.
판사는 6월 판결에서 해당 로펌 변호사에게 벌금 5,000달러를 부과했다. 두 변호사가 ‘변호사로서 책임감을 제대로 갖추지 못하고 존재하지 않는 사법 의견서를 제출하고 사법 명령이 그 존재에 의문을 제기한 후에도 가짜 의견서를 계속 고수했다’고 봤기 때문이다.
컨설팅 기업 pwc는 최근 많은 기업과 협력하여 생성형 AI 프로젝트의 시작을 돕고 있다. pwc는 생성형 AI에 대한 과장 광고 탓에 혹은 과도한 기대감 덕에 관련 프로젝트가 순조롭게 진행되지 않은 현상을 자주 목격하고 있다고 설명했다.
pwc의 파트너 겸 생성형 AI 시장 출시 전략 리더인 브렛 그린스타인(Bret Greenstein)은 “생성형 AI는 기존 AI나 머신러닝보다 훨씬 광범위한 기술이기 때문에 재해 발생 가능성도 크다”라고 설명했다. 기업에서 생성형 AI 도입 후 원하는 결과물을 얻지 못했다면 다음 4가지 실패 사유를 살펴보면 좋다.
실패 이유 1. 거버넌스 부족
생성형 AI 프로젝트가 원하는 대로 진행되지 않았다면 거버넌스나 관리 감독 영역에서 준비가 부족했던 것이 아닌지 알아봐야 한다. 앞서 이야기한 세이비 밀봇과 비슷한 형태로 많은 기업이 내부적으로 비슷한 실수를 저지르고 있다.
가령 그린스타인은 5개월 전에 상용 AI 도구의 프라이빗 클라우드 인스턴스를 사용하여 생성형 AI를 구현한 중견 금융 기업 A와 협력하면서 비슷한 문제를 발견한 적 있다. 일단 A 금융 기관은 기업 사용자가 자체 애플리케이션을 구축할 수 있도록 API를 개방했다. 관련 AI와 API로 구축된 것은 HR 챗봇이었다. 문제는 HR 챗봇이 노출하면 안 되는 복지 프로그램을 추천했던 것이다. HR 챗봇이 잘못된 옵션을 추천하면 직원은 1년 내내 복지 혜택을 놓칠 수 있었다. HR 챗봇을 이용한 직원은 복지 혜택의 진위여부를 확인하지 않았다. 심지어 화를 냈지만 해당 챗봇이 권위 있는 도구라고 믿으며 정확한 정보를 제공한다고 여겼다.
이런 사례를 감안했을 때 그린스타인은 기업이 API를 개방하고 외부에서 원하는 대로 무엇이든 만들도록 내버려 두는 것은 권장하지 않는다. 대신 거버넌스를 통해 사려 깊고 규율 있는 접근 방식을 취하라고 조언한다. 그는 “정확성을 평가하고, 편견을 관리하고, 환각을 처리하는 생성형 AI를 구축하는 체계적인 방법이 있으며, 올바른 것을 추천하는지 확인하기 위해 사람이 개입해야 한다”라고 덧붙였다.
A 금융 기업은 챗봇을 한 달 동안 운영했고, 피드백은 좋지 않았다. 다행히 챗봇 오류가 조기에 발견되어 직원에게 심각한 영향을 미치지 않았지만 경영진에 대한 신뢰가 흔들리기는 했다. 그렇다고 AI 프로젝트를 축소해야 할까? 기업이 생성형 AI를 과도하게 조절하고 적용 규모를 축소하면 경쟁업체에 뒤처지고, 기회를 놓치는 순간을 마주할 수 있다.
실제로 AI 인프라 연합(AI Infrastructure Alliance, AIIA)이 대기업 고위 임원 1,000여 명을 대상으로 7월에 발표한 설문조사에 따르면, 응답자 54%는 AI 또는 ML 애플리케이션 관리 실패로 인해 손실이 발생했다고 답했다. 또한 응답자 63%가 그로 인해 손실 규모가 5,000만 달러 이상이라고 답했다.
실패 이유 2. 급증하는 비용
생성형 AI 관련 인기 챗봇은 대부분 무료로 제공된다. 이런 무료 도구로 기업은 테스트를 진행하면 비즈니스 이점을 제공하는 애플리케이션을 저렴하고 쉽게 찾을 수 있다. 하지만 무료만 쓰다 보면 비용에 대한 문제를 놓칠 수 있다. 기업이 엄격하게 통제된 환경에서 파일럿 프로젝트를 진행해도 비용은 생각보다 적을 수 있다. 하지만 향후 공식 버전으로 프로젝트를 광범위하게 배포할 때가 되면 비용이 파일럿 때와는 달리 매우 높게 청구될 수 있다.
보안 교육 기업 산스 인스티튜트(SANS Institute)의 수석 커리큘럼 디렉터이자 총괄 교수 롭 리(Rob Lee)는 기업이 외부 공급업체를 이용할 때도 비슷한 문제를 겪을 수 있다고 설명했다. 아직 아무도 대규모로 생성형 AI를 배포한 경험이 없어 비용 예측이 어려운 것이다.
롭 리는 “기업은 아직 굳은살이 없다”라며 “이전에 생성형 AI 작업을 수행한 적이 있고 비용을 정확하게 예측할 수 있다면 관련 기업은 이미 엄청난 문의를 받고 있을 것”이라고 설명했다.
롭 리에 따르면, 현재 클라우드를 통해 AI를 배포하는 경우에도 모든 API 호출이 합산된 사용량을 예측하긴 어렵다. 그는 “이전 시스템을 기반으로 인간의 행동을 예측할 수는 없다”라며 “생성형 AI가 만들어낼 인간의 행동은 아무도 모르는 상태”라고 설명했다.
롭 리는 과도기적 상황에서 발생하는 추가 비용도 있다고 지적했다. 예를 들어 새 집을 사야 한다면 현재 살고 있는 집을 팔아야 하는데, 이전 집이 예상보다 빨리 팔리지 않는다면 두 채의 집을 동시에 구입해야 하는 상황에 처할 수 있다. IT도 마찬가지다. 롭 리는 “전환이 생각보다 오래 걸릴 때 그 비용을 기업이 감당할 수 있을지 생각해봐야 한다”라고 설명했다. 특히 생성형 AI는 워낙 새로운 기술이기 때문에 아무도 정확하게 예측할 수 없다.
롭 리는 “데이터 세트의 크기도 고민해야 한다”라며 “스토리지와 해당 스토리지에 대한 호출에 대한 비용이 발생한다. 일부 애플리케이션의 경우 전 세계에 여러 곳에 스토리지를 배포하고 백업도 해야 한다”라고 설명했다.
AIIA 설문조사에 따르면, 대기업이 생성형 AI를 도입하는 데 있어 두 번째로 큰 장애물은 비용이었다.
실패 이유 3. 비현실적인 기대치
생성형 AI에 대한 과대 광고로 인해 일부 비즈니스 리더는 AI를 ‘마법의 총알’처럼 여길 수 있다. 미국의 솔루션 통합업체인 인사이트(Insight)의 제품 혁신 부문 CTO인 아몰 아즈가온카르(Amol Ajgaonkar)는 “현재 업계에서는 AI의 현실적인 부분을 제대로 바라보고 있지 않다”라며 “그럼에도 일부 논의가 이미 기업의 의사 결정 과정에 스며들고 있다”라고 우려했다.
예를 들어, 지난 여름 미국 서부에 위치한 한 글로벌 전자제품 제조 및 유통업체 B는 고객을 위한 가격 정보 문서를 작성하기 위해 콘텐츠 생성 시스템을 구축하고자 했다. 아즈가온카르는 “해당 회사에는 수만 개의 계정을 관리하는 8,000명 이상의 대면 세일즈 담당자가가 있었다”라며 “제품 및 서비스 가격 책정은 새로운 프로젝트에 대한 업무 분장표를 작성하는 데 지속적으로 필요한 자료다. 관련 콘텐츠 생성을 생성형 AI로 쉽게 할 수 있을 것이라고 기대했다”라고 설명했다.
B 기업은 AI가 과거 데이터를 살펴보고 과거의 관련 사례를 찾은 다음 새로운 고객 요청에 적용할 수 있다고 생각했다. 아즈가온카르는 “그들은 생성형 AI가 필요한 결과를 내놓을 것이라고 기대했다. 과거 가격을 제시하면 AI가 이를 검토한 후 비슷한 물건의 가격이 얼마인지 알려줄 수 있지 않을까 했다”라고 설명했다.
막상 프로젝트를 시작해보니 생성형 AI가 실제로 어떻게 작동하는지 B사에 설명하는 것은 끊임없는 도전과제였다.
아즈가온카르는 “B사는 외부 자료를 읽고 와서 우리를 밀어붙였다”라며 “B사의 원하는 아이디어는 매우 간단한 것이었지만 실제로 바라는 비즈니스 가치는 엄청나게 컸다. AI 업계의 과대 광는 실제 결과물을 만드는데 매우 쉽다고 홍보한다. 하지만 현실은 그렇지 않다”라고 설명했다.
이러한 사고방식은 기업에 실망과 실패를 안겨줄 수 있으며, 심지어 AI의 이점에 대한 환멸을 불러일으킬 수도 있다.
아즈가온카르는 프로젝트를 작은 단계로 나누고 각 단계를 달성하기 위한 최선의 방법을 분석하는 것이 해결책이라고 조언했다. 실제로 프로젝트를 진행하다 보면 생성형 AI가 적합하지 않은 경우가 많다. 예를 들어, 과거 문서를 검색하여 관련 사례를 찾는 작업은 기존 접근 방식을 통해 더 효율적으로 수행할 수 있지만, 문서를 요약하는 작업은 생성형 AI가 잘 할 수 있는 작업이라는 것이 그의 설명이다.
한편 미래를 예측하려면 고급 분석 및 ML 모델을 적용해야 한다. 서로 분리된 많은 부분을 하나의 제안서로 모을 수 있다면 비즈니스 로직을 보다 수월하게 처리할 수 있다. 특히 어떤 서비스를 포함해야 구체적으로 명시해 놓으면 더욱 좋다. 단순한 수학적 계산을 위해 생성형 AI를 사용한다면 효과도 떨어지고 결과의 정확도도 낮을 것이다.
아즈가온카르는 “물론 계산을 위한 플러그인을 작성할 수 있다”라며 “하지만 기본적으로 우리 기업은 계산을 위해 생성형 AI에 의존하지 않는다”라고 설명했다.
그렇다면 최종 제안서를 어떻게 구성할 수 있을까? 일부 섹션은 법무팀에서 작성해야 하고 절대 변경되면 안 된다. 그는 “법무팀이 관여한 부분은 늘 기본적으로 반복해서 써야 하는 영역이다”라며 “요약본을 만들 때 생성형 AI을 활용할 수 있다”라고 설명했다.
아즈가온카르에 따르면, 결국 B사는 작업 명세서 작성에 필요한 시간을 크게 단축할 수 있는 솔루션을 얻을 수 있었다. 하지만 그 지점에 도달하기까지 약간의 교육이 필요했다. 교육이 없었다면 이 프로젝트는 실망감만 남기고 끝났을 것이다.
기업은 종종 생성형 AI 프롬프트를 작성할 때 성인 동료에게 설명하는 것처럼 지시 사항을 입력한다. 아즈가온카르는 이를 잘못된 생각이라고 지적했다. 그는 “10대 자녀에게 지시를 내리는 것처럼 생각해야 한다”라며 “때때로 반복해서 말해야 제대로 기억할 수 있다. AI는 지시를 들을 때도 따르지 않을 때도 있다. 마치 다른 언어를 사용하는 것과 같다. 무언가를 운영할 때 이러한 사소한 부분을 이해하는 것이 프로젝트 성공의 큰 부분을 차지한다”라고 밝혔다.
‘생각의 나무(Tree of Thought, ToT)’ 처럼 응답의 품질을 개선하는 방법도 있지만, 응답을 구체화하기 위해서는 여러 번의 프롬프트 입력이 필요하다.
아즈가온카르는 “이러한 방법은 가볍게 조사하는 과정에서는 괜찮다”라며 “하지만 실제로 프로덕션을 운영할 때는 비용을 생각해야 한다. 프롬프트에 입력하는 모든 질문은 비용이다. 각 플랫폼은 자체 기준에 따라 소비 토큰에 대해 비용을 청구한다”라고 밝혔다. 여기에 각 질문에 답변하는 데 걸리는 시간도 어느 정도 필요하다는 것도 잊지 말아야 한다.
아즈가온카르는 “모든 요청에 대해 사고의 생각의 나무 방식을 사용하고 설명을 요청해야 한다면 비용이 매우 많이 들 것이다”라며 “백지 수표가 주어진다면 같은 프롬프트를 다양한 방식으로 수천 번 실행하여 원하는 결과를 정확하게 얻을 수 있다. 하지만 그것이 가치를 창출하는 데 꼭 필요할까? 이것이 바로 솔루션을 구축할 때 균형을 잡아야 하는 이유다”라고 조언했다.
실패 이유 4. 데이터 문제 인사이트의 엔지니어인 카름 타글리엔티(Carm Taglienti)도 최근 비현실적인 기대치로 인해 AI 프로젝트가 좌초될 뻔한 프로젝트를 겪었다.
타글리엔티는 “AI 프로젝트의 실패는 99%가 기대치 때문”이라며 “기술의 실패가 아니라 사람들이 기술로 무엇을 할 수 있을지에 대한 기대치가 달라서 문제가 생긴다”라고 설명했다.
타글리엔티는 미국의 대형 칩 제조 회사 C사의 사례를 공유해 주었다. C사는 공급망 관리 문제를 해결하기 위해 AI를 사용하고자 했다. 문제는 C사가 AI가 할 수 없는 일을 해줄 것으로 기대했을 뿐만 아니라 첫 번째 시도에서 모든 일이 해결되기를 바랐다는 것이다. 하지만 AI 프로젝트에서는 한 단계에서 다른 단계로 넘어갈 때마다 첫 번째 접근 방식이 작동하지 않을 가능성이 높다. 그렇기 때문에 조정이 필요하다. 이러한 장벽을 만날 때마다 기업은 AI 프로젝트를 포기하는 것을 고려한다. 하지만 C사 사례는 조금 특이했다. 기대치 문제 뿐만 아니라 좋은 데이터가 부족하다는 기술적 문제도 있었다.
C사는 과거 특정 칩이나 부품을 구할 수 없을 때 대체품을 찾기 위해 노동 집약적인 수작업 프로세스를 겪었다. 타글리엔티는 “하지만 수작업은 비즈니스에 필요한 수준만큼 민첩하지 못했다”라고 설명했다. 이 프로세스 중 일부는 의사 결정 트리와 전문가 시스템으로 대체할 수 있었지만, 관련 시스템이 견고하진 않았다. 업계에 변화가 생길 때면 전체 의사 결정 트리를 업데이트해야 했다. 그러나 AI를 사용하려면 대량의 깨끗한 데이터가 필요했다. 하지만 학습 데이터로 사용할 수 있는 구성 요소를 철저하게 검색하는 경우는 드물었다.
매번 경쟁력 분석을 할 수는 없는 상황이었기에 C사는 선호 공급업체 목록과 상위 백업 목록을 고수하고 대규모 공급업체 검토는 거의 하지 않았다.
사용할 수 있는 데이터 중에서는 형식이 처리하기 어려운 경우도 있었다. 타글리엔티는 “제조업체라면 사양서를 작성한다”라며 “하지만 신속하게 수집할 수 있는 형식이 아니었다”라고 밝혔다.
제조업체의 시설 위치, 적시 납품에 대한 평판과 같은 미묘한 문제도 있었다. 타글리엔티는 “웹을 스크랩하고 상장 기업이라면 10-K를 살펴보는 등의 작업을 해야”라며 “단순히 작동하는 부품을 찾았다고 말하는 것보다 훨씬 더 많은 것이 있다”라고 설명했다.
타글리엔티에 따르면, 이런 종류의 분석은 생성형 AI가 등장하기 전에도 자동화가 가능했지만, 처음에 사람들이 생각하는 것보다 훨씬 더 복잡한 과정이었다. 드문 일이 아니었다. 사용 가능한 데이터의 부족은 오랫동안 AI 및 ML 프로젝트의 문제였다.
AIIA 설문조사에서도 데이터 문제는 생성형 AI를 배포하는 기업의 84%에게 중요한 과제였다. 실제로 PwC의 그린스타인은 최근 백오피스 처리를 자동화하려는 한 소비재 기업 D와 협력한 경험이 있다.
그린스타인은 “D사는 AI 서비스를 이미 구축해 놓았다”라며 “클라우드 인프라 기반도 갖춰져 있었다. 직원들도 준비비된 상태였다. 하지만 데이터에 접근하는 것이 어렵다는 부분을 D사는 예상하지 못했다”라고 설명했다.
심지어 어떤 데이터는 D 회사에 없는 API 라이선스가 필요했다. 라이선스를 얻기 위해 조달 프로세스를 거쳐야 했는데, 이 프로세스는 몇 달이 걸릴수도 있었다.
그린스타인은 “또 다른 시스템에서는 조직별로 매우 높은 수준의 액세스 제어가 이루어졌다”라며 “세 번째 시스템은 사용자 기반 제어였다. 생성형 AI의 경우 이 모든 것을 조정해야 했지만 빠르게 조정할 수 없었다”라고 밝혔다.
그린스타인은 장기적으로는 해당 기업은 필요한 모든 데이터를 확보할 수 있었지만 몇 달을 허비했을 것이라고 표현했다. 그는 “이 경우에는 다른 사용 사례로 전환했다”라며 “하지만 경영진은 시간과 열정을 잃었다. 생산성이 높아질 것이라는 기대에 부풀어 있던 직원들은 모두 좌절했고, 데이터 관련 사항을 고려하지 않은 IT 팀은 경영진에 대한 신뢰를 잃었다”라고 표현했다.
그린스타인은 기업이 잠재적인 AI 사용 사례의 우선순위를 첫 번째는 영향력, 두 번째는 위험, 세 번째는 데이터로 정해야 한다고 설명했다. 그는 “이 사용 사례를 수행하기 위한 데이터가 있는지, 데이터를 사용할 수 있는 권한이 있는지, 접근 가능한지, 유용할 만큼 깨끗한지를 물어야 한다”라며 “이런 질문에 답을 못한다면 시작하지 않아야 한다. 다른 사용 사례를 찾아야 한다”라고 설명했다.
ciokr@idg.co.kr
뤼튼 등 AI 스타트업 4곳 대표 견해는
“고비용이 문제”라는 점에 대체로 동의
“비용은 언제나 문제였고, 결국엔 해결”
챗GPT와 같은 생성형 인공지능(AI) 기술을 둘러싼 거품이 곧 꺼질 것이라는 관측이 나오고 있다. 거대언어모델(LLM) 기반 생성형 AI 서비스를 개발하고 운영하는 데 드는 비용이 막대하다는 게 주요 이유다. 국내 생성형 AI 스타트업 대표들은 비용 문제에는 공감하면서도 거품 논란에 대해서는 다양한 견해를 내놨다.
11일 글로벌 시장조사업체 CCS인사이트는 2024년 이후 테크 산업의 미래에 관한 연례 보고서에서 내년에 생성형 AI 기술 시장에 관한 우려를 짚었다. 비용과 규제가 대표적인 문제로 꼽혔다. 대규모 언어 모델(LLM)을 구동시키기 위해서는 그래픽처리장치(GPU) 서버 인프라 등이 필요하다. 대규모 컴퓨팅에 들어가는 비용이 막대하다는 의미다.
사진=게티이미지뱅크
◆‘비용 절감’, 생성 AI 업계 최대 화두
이스트소프트, 아티피셜소사이어티, 네오사피엔스의 대표는 세계일보와 통화에서 비용 문제가 업계의 가장 큰 장애물이라는 데 동의했다. 이스트소프트는 AI 서비스 전문기업이며, 아티피셜소사이어티는 생성형 AI를 활용한 에듀테크 스타트업, 네오사피엔스는 AI 성우 서비스를 하는 기업이다. 각 기업이 처한 상황에 따른 차이는 있으나 생성 AI 서비스의 수익화 문제는 스타트업뿐 아니라 오픈AI, 네이버 등도 고민하는 지점이다.
김기영 아티피셜소사이어티 대표는 서비스 이용자들에게 높은 비용을 받지 못하는데 원가는 높은 게 문제라고 지적했다. 누구나 챗GPT를 쓸 수 있는 시대에 챗GPT를 활용한 생성 인공지능(AI) 서비스를 비싸게 팔 수 없다는 뜻이다. 김 대표는 “챗GPT가 나만 쓸 수 있는 서비스면 관련해 개발한 서비스를 고가에 책정할 수 있겠지만, 현재는 그렇지 않기에 기업들이 수익화에 애를 먹고 있는 것”이라고 했다.
김 대표는 이 때문에 현재 AI 스타트업계가 서비스를 정교하게 하는 것보다 비용을 저렴하게 하는 데 집중하고 있다고 설명했다. 혹은 교육, 헬스케어 등 분야를 좁혀 생성 AI 기술을 고도화하는 방안으로 돌파구를 마련하고 있다는 분석이다.
정상원 이스트소프트 대표도 고비용 문제에 대해서는 인정했다. 다만 그는 생성형 AI의 유일한 단점이 비용이기 때문에 역설적으로 구글 등이 공격적으로 서비스에 적용하지 않고 있고 이 때문에 사람들의 관심이 지속하는 것이라고 진단했다. 정 대표는 “혁신의 역사를 돌아보면 초반에는 항상 엄청난 비용이 수반되기 마련”이라며 “그러나 인류는 항상 비용 문제만큼은 극복해 왔다”고 했다.
사진=로이터연합뉴스
◆“동일 성능 대비 효율화되고 있다”
AI 포털 서비스 기업 뤼튼테크놀로지스의 이세영 대표는 고비용이 문제라는 데 동의하지 않았다. 그는 오히려 비용 효율화가 가속하고 있다고 밝혔다. 예컨대 오픈AI의 챗GPT 모델이 발전하면서 이전 모델의 비용은 낮아진다는 의미다. 이 대표는 “동일 기술 대비 가격이 기하급수적으로 떨어지고 있다”고 강조했다.
GPU 역시 마찬가지다. 이 대표는 “성능이 획기적으로 개선되면 비용이 일부 늘 수 있지만, 대체로 빠르게 효율화와 경량화되고 있다”며 “스타트업이 초반에 감당하기 어려운 수준의 비용이 아니냐고 하는 지적이 있지만, 개발사와 협력해 비용 절감 모델도 개발하고 있다”고 했다. 이어 “뤼튼은 2막에서 본격적으로 태동하는 플랫폼 역할을 수행하고 있다”고 덧붙였다.
수익화 문제는 ‘킬러 앱’의 등장으로 넘을 수 있다고 봤다. 이 대표는 오픈AI의 최신 LLM인 GPT-4 출시(올해 3월)까지 1막이라면, 이후 2막이 열렸다고 정의했다. 그는 “2막은 많은 생성형 AI 앱들이 등장하는 시기가 될 것이고, 이미지, 비디오 등 세분화한 영역에서 킬러 앱이 등장해 시장을 이끌 것”이라고 전망했다.
김태수 네오사피엔스 대표도 생성형 AI 서비스 영역이 세분화해 비용 효율화에 성공한 곳과 그렇지 않은 곳이 나뉠 것이라고 봤다. AI 성우 서비스를 하는 네오사피엔스 경우 생성 AI 서비스 비용이 비싸다 한들 실제 성우를 고용하는 비용보다는 저렴하다는 설명이다. 그는 “유스케이스(Use Case)가 있는 데는 소비자들이 기꺼이 돈을 더 지불할 것이고, 관련 시장도 더 커질 것”이라고 내다봤다.
사진=AP연합뉴스
◆“기대 뛰어넘을 것” VS “더 놀랍진 않을 것”
생성형 AI의 진화에 대한 전망도 엇갈렸다. 기대를 넘어서는 서비스가 계속 등장할 것이라는 관측과 더 놀라운 것은 없을 것이라는 비관이 공존하고 있다. CCS인사이트가 제기한 ‘거품 논란’과 이어지는 문제다.
정상원 대표는 LLM 기반 생성형 AI 기술이 메타버스, 블록체인 등과는 다르다고 단언했다. 그는 “거품이라고 하더라도, 그냥 꺼질 거품인지 미래를 담보하는 거품인지는 다르다”며 “거품이 꺼지긴 이르다”고 했다.
아직 공개되지 않은 서비스에 대한 기대도 거품을 부정하는 요소다. 예컨대 오픈AI만 하더라도 지난달 말 한층 사람에 가까워진 챗GPT 기능을 조만간 선보인다고 밝혔다. 마이크로소프트(MS)는 워드·엑셀 같은 소프트웨어(SW)에 AI를 장착한 ‘MS365 코파일럿’을 다음 달 본격 서비스한다. 정 대표는 “챗GPT는 유니버설한 AI를 추구하고 있고, 사람들이 놀랄 거리는 아직 많이 남아 있을 것”이라며 “내년이 움츠러들 시점은 아니다”라고 강조했다.
반면 김기영 대표는 앞으로 나올 기술과 서비스가 기대에 부응하기 어려울 것이라고 예상했다. 그는 “세상의 모든 것이 생성형 AI로 바뀔 것이라고 초반에는 전망했지만, 그 정도는 아닐 것이라는 의미”라고 했다. 사람들의 기대치가 너무 높아졌다는 평가다. 이어 “챗GPT 경우 전혀 생각지 못한 것이어서 파급력이 컸지만, 앞으로 나올 것들은 그 정도의 영향력을 가져오진 않을 것”이라고 덧붙였다.
■태양계 가장자리 가상 천체집단···관측 못했지만 천문학계 이견 없어
■지구서 가장 멀리 나간 보이저1호, 오르트 구름 벗어나려면 3만년 걸려[서울경제]
마지막 남은 블루오션 우주. 미국과 러시아, 중국, 인도 등은 일찌감치 우주의 가치에 눈을 뜨고 그 공간을 개척하고 있습니다. 우리나라도 자체 기술로 만든 위성발사용 로켓 누리호를 쏘아올리고 ‘우주항공청’을 설립하면서 본격적으로 우주 개발에 뛰어들고 있죠. 미지의 우주 그 광활하고 거대한 세계에 대한 이야기를 어린이부터 성인까지 누구나 쉽게 이해할 수 있도록 재미있게 풀어내려 합니다. <편집자주>
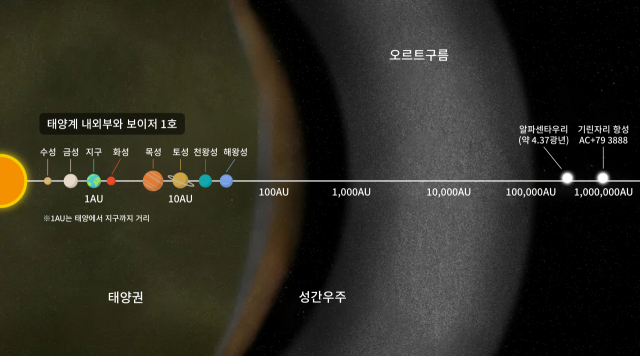
태양계와 오르트 구름의 모습.
우리 태양계는 태양을 중심으로 수성·금성·지구·화성·목성·토성·천왕성·해왕성 등 8개의 행성과 세레스·명왕성 등 왜행성, 그 외 그고 작은 소행성 등으로 구성돼 있습니다.
태양계의 가장자리라고 하면 대체로 명왕성을 떠올리곤 하는데 천문학계에서는 ‘오르트 구름(Oort cloud)’라는 곳을 가장자리로 봅니다.
오르트 구름은 장주기혜성(태양공전 주기가 200년 이상인 혜성)의 기원으로 알려져 있으며 태양계를 껍질처럼 둘러싸고 있다고 생각되는 가상적인 천체집단입니다. 이곳은 수천개에서 수억개의 크고 작은 천체들로 이뤄졌을 것으로 추정됩니다.
네덜란드의 천문학자 얀 오르트가 1950년에 장주기혜성과 비장주기혜성의 기원을 발표하며 ‘오르트 구름’이라는 이름이 붙었습니다.
오르트 구름은 일반적으로 태양에서 약 1만AU 혹은 태양의 중력이 다른 항성(별)이나 은하계의 중력과 같아지는 약 10만AU 안에 둥근 껍질처럼 펼쳐져 있다고 천문학계는 추측합니다. 참고로 1AU는 태양과 지구 사이의 거리를 뜻하는 천문단위로 약 1억5000만km 정도 됩니다.
오르트 구름은 인류가 직접 관측한 게 아니기 때문에 그 존재는 가설이지만 혜성의 궤도장반경과 궤도경사각의 통계를 기초했습니다. 이에 학계에서는 오르트 구름에 대한 가설을 확실시 하고 있습니다.
오르트 구름의 기원은 태양계의 형성과 진화의 과정에서 현재의 목성궤도부근부터 해왕성궤도부근까지 존재하고 있던 작은 천체들이 거대행성의 중력과 태양계를 지나가던 주변 항성이나 가스구름에 의해 궤도요소가 바뀌어 지금의 형태로 됐다는 설이 유력합니다.
오르트 구름의 존재를 고려한다면 태양계의 범위는 일반인들이 흔히 생각하는 범위보다 아주 많이 커집니다. 앞서 말한 것처럼 보통 태양계의 끝 하면 명왕성 언저리 정도를 생각할 수 있지만 천문학계에서는 오르트 구름까지라고 보는 경우도 있기 때문입니다.
일반적으로 생각하는 태양계의 크기는 좁겠지만 태양계 끝을 오르트 구름까지라고 본다면 그 범위는 그야말로 광대해집니다.
현재 인류가 우주로 보낸 탐사선 가운데 가장 멀리 가 있는 게 ‘보이저 1호’인데요, 이 탐사선은 1977년 9월에 지구를 떠났습니다. 보이저 1호는 1990년 5월에 명왕성을 지났는데 이때 ‘최초로 태양계를 벗어난 탐사선’이라고 했죠. 틀린 말은 아니지만 일부 천문학자들은 보이저 1호가 오르트 구름을 벗어나야 실제 태양계를 빠져나간 것이라고 말합니다.
보이저 1호가 오르트 구름 안쪽 경계면에 도달하는 시기는 2310년 쯤이며, 오르트 구름을 완전히 벗어나려면 3만년 정도가 걸립니다. 이렇게 생각하면 태양계도 넓다고 볼 수 있죠. 물론 우주 전체적으로 보면 태양계는 먼지보다 작은 점에 불과하지만 지구의 관점에서는 어마어마한 크기는 맞습니다.
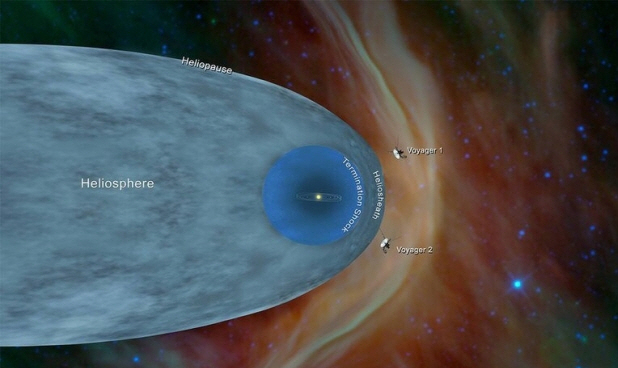
태양권 외부에 있는 보이저1호(위쪽)와 2호의 위치를 보여주는 그림. 그래픽 제공=미국 항공우주국(나사)
오르트 구름은 크게 두 영역으로 나눕니다. 약 2만~3만AU를 기준으로 ‘안쪽 오르트 구름(inner Oort cloud)’, 2만~3만AU 밖의 영역은 ‘바깥 오르트 구름(outer Oort cloud)’으로 부릅니다.
안쪽 오르트 구름은 ‘힐스 구름’이라고도 하는데 이를 연구한 천문학자 잭 힐스의 이름을 딴 것입니다.
안쪽 오르트 구름 시작점은 천문학자마다 기준이 다른데 해왕성 궤도 바깥쪽인 약 100AU 를 기준으로 하는 경우도 있고, 약 2000AU 정도부터가 시작점이라는 시각도 있습니다.
또 어디까지가 오르트 구름의 끝인가 하는 문제도 있는데 역시 천문학자들 마다 의견이 갈립니다.
고전적인 의견은 약 5만AU(약 0.8 광년) 까지로 보고 일부 천문학자들은 태양의 인력이 다른 항성의 인력과 같아지는 지점인 약 10만AU까지로 보기도 합니다. 또 어떤 천문학자는 우리 태양계의 이웃 태양계(항성계)인 알파 센타우리까지 거리의 절반인 약 13만AU를 오르트 구름의 끝이라고 주장하기도 합니다.
오르트 구름은 지구에서 너무 멀리 떨어져 있어 아직 탐사가 이뤄지지 못해 이에 대한 정보는 거의 없는 실정입니다. 앞서 언급한 보이저 1호가 오르트 구름 도달하려면 300년 정도가 걸리고 오르트 구름을 벗어나려면 3만년 정도가 소요되니 이곳에 대한 정보를 제공할 가능성은 없죠.
하지만 우주에 대한 인류의 호기심은 끝이 없고 이를 알아내기 위한 도전은 계속 되고 있어 수세기가 지난 후 우리의 후손들이 오르트 구름에 대해 자세히 밝혀낼 수도 있겠습니다.